Главная
» Домены
»
Как создать автоматизированного агента для обработки счетов-фактур с использованием искусственного интеллекта с открытым исходным кодом
Как создать автоматизированного агента для обработки счетов-фактур с использованием искусственного интеллекта с открытым исходным кодом
Автоматизированный агент для обработки счетов-фактур не обязательно должен начинаться как крупная автономная система искусственного интеллекта. Для первой полезной версии представьте себе агента как управляемый программный рабочий процесс, который получает счет-фактуру, вызывает нужный документ и инструменты ИИ, проверяет результат, решает, нужно ли его проверять человеку, и только после этого сохраняет или экспортирует утвержденные данные.
В финансовой сфере это различие имеет значение. Языковая модель может помочь преобразовать неструктурированные поля счетов-фактур в структурированные, но она не должна быть единственным критерием для определения действительности или безопасности счета-фактуры для проведения. Удобный для начинающих дизайн этого руководства обеспечивает вероятностный подход к извлечению данных и детерминированный подход к важным бухгалтерским проверкам.
В итоге у вас будет локальный прототип, который принимает счета-фактуры в формате PDF или изображений, извлекает такие поля, как поставщик, номер счета-фактуры, даты, валюта, итоги и позиции, проверяет эти поля на соответствие правилам, направляет сомнительные документы на проверку, сохраняет журнал аудита и предоставляет доступ к процессу через API.
Что нужно понять, прежде чем начать?
Стоит знать четыре термина:
Оптическое распознавание символов (OCR) преобразует текст, видимый на изображении или скане, в машиночитаемый текст.
Анализ документов сохраняет больше структурных элементов, чем обычное оптическое распознавание текста (OCR), таких как порядок чтения, таблицы, заголовки и области разметки.
LLM (большая языковая модель) может преобразовывать переменный текст счета-фактуры в согласованную структуру JSON.
«Человек-участник» означает, что система останавливается и просит человека проверить случаи, не прошедшие проверку, вместо того, чтобы делать вид, что каждый результат верен.
По состоянию на сентябрь 2026 года несколько активно поддерживаемых проектов с открытым исходным кодом охватывают эти уровни. Docling поддерживает PDF, изображения, офисные документы и другие форматы документов; PaddleOCR предоставляет конвейеры распознавания текста и понимания документов и распространяется под лицензией Apache 2.0; а проект Tesseract описывает свою текущую линейку 5.x как движок распознавания текста с открытым исходным кодом в официальном руководстве Tesseract .
Для локального вывода модели документация сервера llama.cpp описывает совместимые с OpenAI конечные точки и вывод в формате JSON с ограничениями по схеме. Это делает его полезным для сервиса извлечения данных, поскольку вы можете запросить у локально размещенной модели возврат определенного объекта, а не неограниченного текста.
Важно помнить об одном нюансе лицензирования: открытый исходный код механизма вывода не означает автоматически, что все веса модели также будут иметь открытый исходный код. Проверьте лицензию для конкретной контрольной точки модели, которую вы используете, особенно если речь идёт о коммерческом применении.
Какой стек технологий следует использовать новичку?
Слой
Практичный выбор
Почему это здесь?
Преобразование документа
Доклин
Преобразует PDF-файлы и изображения в структурированное представление документа и текстовый файл, пригодный для экспорта.
резервный вариант OCR
PaddleOCR или Tesseract
Полезно, когда счет-фактура представляет собой скан или требует распознавания текста с помощью OCR (оптического распознавания символов).
Локальное извлечение ИИ
llama.cpp + подходящая модель инструкций
Преобразует переменный текст счета-фактуры в стабильную JSON-схему, сохраняя при этом локальность вывода.
Проверка схемы
Пидантик
Проверяет данные Python на соответствие заявленным типам полей и ограничениям.
API
FastAPI
Принимает к загрузке счета-фактуры и возвращает результаты обработки.
Хранилище
SQLite для прототипа; PostgreSQL для общего сервиса.
Сохраняет нормализованные данные, статус проверки, идентификатор исходного файла и события аудита.
Оркестровка
Сначала чистый Python; LangGraph (по желанию) позже.
Детерминированная функция упрощает отладку. Добавьте структуру агента с сохранением состояния, когда ветвление и проверка человеком станут более сложными.
В официальной документации Pydantic поясняется, что модели наследуются от BaseModel, проверяют входящие данные и могут генерировать JSON Schema через model_json_schema(). См. раздел «Проверка моделей Pydantic» . Если вам позже потребуется устойчивое ветвление с сохранением состояния, в справочнике LangGraph описана поддержка длительно работающих агентов с сохранением состояния, персистентности и рабочих процессов с участием человека.
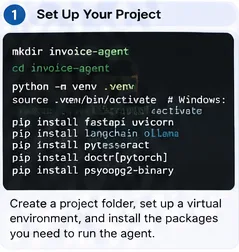
Шаг 1: Создайте проект и определите узкую первоначальную цель.
Не начинайте с «автоматизации учета кредиторской задолженности». Начните с одного класса документов и одного выходного договора. Хороший минимально жизнеспособный продукт (MVP) должен включать: счета-фактуры поставщиков на английском языке, ввод в формате PDF или изображения, одно юридическое лицо, одну валюту и отсутствие автоматического выполнения платежей.
Установите свой OCR-движок отдельно, если он вам нужен. В текущем руководстве по установке Docling используется [укажите путь к файлу] pip install docling; в текущей документации по установке PaddleOCR базовый пакет OCR отличается от дополнительных групп зависимостей, таких как анализ документов и извлечение информации. Используйте руководство по установке Docling или руководство по установке PaddleOCR 3.x, а не копируйте старый список зависимостей.
Шаг 1: Сначала создайте небольшой изолированный проект на Python. Выберите для первого типа счета-фактуры и схемы вывода достаточно узкий формат, чтобы провести тщательное тестирование.
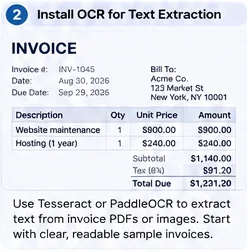
Шаг 2: Преобразование счетов-фактур в текстовый формат и создание макета.
В цифровых PDF-файлах уже может содержаться пригодный для использования текст. Отсканированные PDF-файлы и фотографии требуют распознавания текста (OCR). Ваш парсер должен скрывать это различие от остальной части конвейера: на более поздних этапах следует получать нормализованный текст документа, а также любую полезную информацию о макете или таблицах.
Минимальный вариант преобразования в Docle выглядит следующим образом:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
В официальном руководстве Docling по быстрому запуску используется тот же шаблон «преобразование-затем-экспорт». Для коллекций, интенсивно использующих OCR, протестируйте PaddleOCR или Tesseract на собственных сканах. В документации проекта PaddleOCR рекомендуется использовать более новое семейство PP-StructureV3 для анализа документов, а Tesseract можно вызывать из командной строки или API для распознавания текста в печатных изданиях.
Шаг 2: Начните с читаемых образцов счетов-фактур, содержащих поля, которые вы планируете извлечь, а более сложные сканирования добавляйте только после того, как заработает базовый конвейер обработки данных.
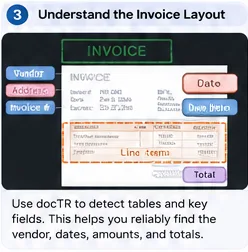
Шаг 3: Определите, какие именно данные агенту разрешено предоставлять.
Схема извлечения данных — это соглашение между ИИ и бухгалтерской логикой. Избегайте гигантской схемы «все, что может появиться в счете-фактуре». Начните с полей, которые можно проверить.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"В данном контексте это полезно, поскольку неожиданные поля LLM не должны незаметно становиться частью вашей бухгалтерской записи. Также обратите внимание, что проверка Pydantic подтверждает структуру и типы; она не доказывает , что извлеченный поставщик или сумма соответствуют изображению счета-фактуры.
Шаг 3: Определите целевые поля в соответствии с потребностями бизнеса, затем используйте информацию о структуре и таблице, чтобы сохранить исходные данные этих полей.
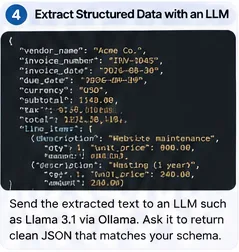
Шаг 4: Используйте локальную модель для преобразования текста документа в структурированный JSON.
Запустите подходящую модель инструкций за HTTP-сервером llama.cpp. Точный размер модели зависит от вашего оборудования и сложности счетов-фактур. Не следует предполагать, что большая модель автоматически лучше; оцените точность полей, задержку и потребление памяти на собственном наборе счетов-фактур.
В настоящее время llama.cpp поддерживает JSON-ответы с ограничениями по схеме. Вы можете получить эту схему из Pydantic и отправить её вместе с запросом на извлечение:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
Генерация с учетом ограничений схемы помогает обеспечить корректную структуру, но не гарантирует семантическую истинность. В совершенно корректном JSON-объекте все еще может содержаться неверная сумма. Именно поэтому следующий шаг является обязательным.
Шаг 4: Запросите у локальной модели строго структурированный объект, а не произвольный текст, чтобы последующие этапы проверки получали предсказуемые поля.
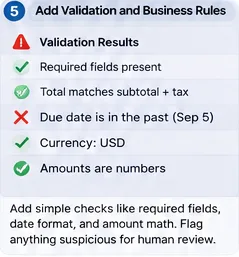
Шаг 5: Добавьте детерминированные бухгалтерские проверки и правила анализа.
Не следует спрашивать у студента магистратуры: «Вы уверены в своей модели?» и доверять ответу. Самостоятельно заявленная уверенность в модели не является калиброванным контролем. Разработайте проверки, которые можно будет пересчитать на основе извлеченных данных и ваших систем.
К полезным первым правилам относятся:
Обязательные поля присутствуют;
Номер счета-фактуры еще не зарегистрирован для этого же поставщика;
Данная торговая марка или организация допускает использование определенной валюты;
Суммы по отдельным позициям приблизительно совпадают с промежуточной суммой;
Итого плюс налог приблизительно равно общей сумме;
Дата выставления счета и срок оплаты являются правдоподобными;
Поставщик либо уже зарегистрирован в вашей базе данных поставщиков, либо направлен на подключение;
Ссылки на заказы на покупку совпадают, когда требуется сопоставление заказов на покупку.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Все неудачные проверки следует направлять в очередь проверки. На первом этапе развертывания целесообразно направлять все счета на проверку, пока вы оцениваете качество извлечения данных. Пороговые значения автоматизации должны определяться на основе данных, собранных по вашим собственным помеченным счетам, а не на основе общего процента, скопированного из другой системы.
Шаг 5: Рассматривайте арифметические операции, обнаружение дубликатов, сопоставление с поставщиками и правила работы с датами как детерминированные элементы управления; направляйте исключения конкретному лицу.
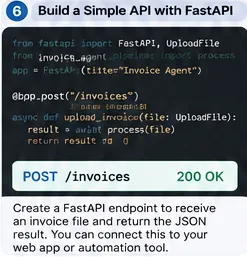
Шаг 6: Оберните процессор в небольшой API.
API позволяет форме загрузки, почтовому обработчику, отслеживанию общих папок или интеграции с бухгалтерской системой вызывать одну и ту же функцию обработки. В официальном руководстве FastAPI по загрузке файлов рекомендуется UploadFileиспользовать для загружаемых файлов файл очереди, что лучше подходит, чем загрузка больших файлов целиком в память.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
См. текущую документацию FastAPI по файлам запросов для получения информации о поддерживаемых шаблонах загрузки. В производственной среде также необходимо обеспечить соблюдение ограничений на размер файлов, сканирование на наличие вредоносных программ (где это необходимо), аутентификацию вызывающих сторон, идентификаторов запросов и безопасную очистку временных файлов.
Шаг 6: После запуска локального конвейера откройте одну конечную точку обработки, чтобы несколько входных каналов могли повторно использовать один и тот же путь проверки.
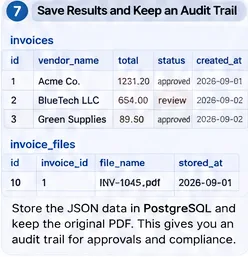
Шаг 7: Сохраните исходные данные, нормализованный результат и события аудита.
Никогда не храните только итоговый JSON. Сохраняйте достаточно данных, чтобы восстановить произошедшее: идентификатор исходного файла, хеш, версия парсера, идентификатор модели, версия запроса, извлеченный JSON, результаты проверки, решение по проверке, временные метки и пользователь или служба, утвердившая изменение.
В простом прототипе можно использовать SQLite. Многопользовательский сервис может использовать PostgreSQL с ограничениями уникальности и внешних ключей. Текущая документация PostgreSQL описывает ограничения таблиц , которые полезны для защиты ключей и связей независимо от конвейера обработки данных ИИ.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
Хэш источника предоставляет второй способ обнаружения случайной повторной отправки. Установите более строгие права доступа к файлам, чем к общим журналам приложений, поскольку счета-фактуры часто содержат адреса, банковские реквизиты, налоговые идентификаторы и другие конфиденциальные данные.
Шаг 7: Сохраните как нормализованные данные счетов-фактур, так и метаданные исходного файла, чтобы подтверждения, дубликаты и последующие исправления оставались подлежащими аудиту.
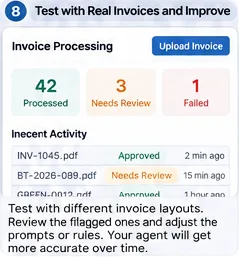
Шаг 8: Перед автоматизацией последующих действий проведите тестирование на реальных вариантах счетов-фактур.
Прототип, работающий с пятью чистыми PDF-файлами, не готов к использованию в производстве. Создайте размеченный набор данных для оценки, который будет отражать фактически получаемые вами входные данные: разные поставщики, сканированные файлы, повернутые страницы, мелкий шрифт, многостраничные счета-фактуры, скидки, отрицательные строки, налоги, стоимость доставки, несколько валют, отсутствующие заказы на покупку и дублирующиеся заявки.
Отслеживайте показатели на уровне отдельных полей. «Точность счета-фактуры» может скрывать тот факт, что название поставщика легко определить, в то время как количество позиций в счете-фактуре — ненадежный показатель. Как минимум, измеряйте:
Точное совпадение номера счета-фактуры, валюты и дат;
Допуски по числовым значениям для промежуточной суммы, налога и общей суммы;
Точность и полнота построчных показателей, если построчные показатели имеют значение для последующих этапов обработки;
Процентное количество материалов, переданных на проверку человеком;
ложный показатель автоматического одобрения;
Задержка обработки и частота сбоев;
Точность обнаружения дубликатов.
Сохраняйте ошибки в виде тестовых случаев. Каждый раз, когда вы исправляете правило парсера, подсказку, схему или модель, повторно запускайте весь набор оценочных тестов. Это предотвратит незаметное нарушение структуры, созданной одним поставщиком, со стороны другого.
Шаг 8: Прежде чем разрешить агенту автоматизировать последующие бухгалтерские операции, оцените очередь проверки и количество случаев ошибок по типовым счетам-фактурам.
Как агент должен решить, что произойдет дальше?
Не следует явно указывать конечный автомат. «Агентом» на начальном этапе может быть обычная функция Python:
Это уже похоже на работу агента, поскольку он координирует инструменты и выбирает ветку. Вам не нужен LLM для выбора каждого следующего шага. Добавьте LangGraph или другую систему оркестрации, когда вам потребуется сохранение многоэтапных проверок, повторных попыток, асинхронных обратных вызовов или несколько специализированных инструментов, порядок выполнения которых меняется в зависимости от случая.
Каких ошибок следует избегать новичкам?
Превратить магистра права в орган бухгалтерского контроля
Модель должна извлекать и нормализовать данные; код и данные доверенной системы должны быть проверены. Арифметические операции, проверка на дубликаты, статус поставщика, сопоставление заказов на покупку и ограничения на утверждение должны выполняться в рамках детерминированной логики.
Удаление исходного документа после извлечения
Сохраните оригинал счета-фактуры или ссылку на него. Рецензентам нужны доказательства, и вам необходим способ воспроизведения ошибок после обновления модели или парсера.
Использование одного запроса без указания версии.
Сохраняйте версию запроса и идентификатор модели для каждого обработанного счета-фактуры. В противном случае вы не сможете объяснить, почему два счета-фактуры, обработанные с разницей в несколько месяцев, вели себя по-разному.
Автоматическая публикация всех результатов, соответствующих условиям схемы.
Проверка достоверности JSON не означает проверку достоверности счета-фактуры. Начните с проверки человеком, а затем автоматизируйте только случаи с низким уровнем риска после того, как ваша оценка покажет приемлемую эффективность.
Игнорирование лицензий на модель и данные.
Библиотеки и веса моделей могут иметь разные лицензии. PaddleOCR и Tesseract используют лицензии с открытым исходным кодом, в то время как лицензия модели, запускаемой через llama.cpp, зависит от конкретной контрольной точки. Перед развертыванием обязательно уточните это.
Разработка пользовательского интерфейса перед подтверждением качества извлечения данных.
Даже идеально отполированная панель мониторинга не сможет компенсировать неверные данные. Сначала протестируйте разбор документов, извлечение схемы и проверку; интерфейс для проверки добавьте после того, как поймете, что именно нужно видеть рецензентам.
Когда следует использовать только оптическое распознавание текста (OCR), модели макета или LLM?
Подход
Наилучший вариант
Основное ограничение
OCR + правила
Небольшое количество высокостабильных шаблонов поставщиков.
Правила становятся негибкими по мере изменения планировки.
модель структуры документа
Таблицы, формы и поля, где положение имеет значение.
Может потребоваться специализированное обучение или постобработка данных.
OCR/анализатор документов + локальный LLM
Множество форматов счетов-фактур с общей целевой схемой.
Необходимо установить ограничения и провести проверку; вывод результатов требует больших вычислительных затрат.
Модель визуального языка
Сложные документы, в которых текст и визуальное оформление тесно взаимосвязаны.
Более высокие требования к аппаратному обеспечению и дополнительная сложность оценки.
В текущей документации Hugging Face по LayoutLMv3 описывается модель искусственного интеллекта для работы с документами, которая объединяет текстовую и визуальную информацию о структуре. Документация PaddleOCR по PP-StructureV3 также фокусируется на структуре, таблицах и анализе структурированных документов. Это варианты, когда простого текста плюс LLM недостаточно.
Какой путь от прототипа до серийного производства является наиболее разумным?
Внедряйте поэтапно. Во-первых, запустите локальное приложение на папке с помеченными счетами-фактурами. Во-вторых, добавьте API и постоянное хранилище. В-третьих, внедрите очередь для проверки вручную. В-четвертых, интегрируйте поиск только для чтения, например, по основным данным поставщиков или заказам на покупку. В-пятых, разрешите контролируемый экспорт в промежуточную область бухгалтерского учета. Только после того, как мониторинг подтвердит эффективность мер контроля, следует рассматривать автоматическое проведение операций для четко определенных случаев с низким уровнем риска.
На каждом этапе необходимо сохранять три вещи: доказательства (оригинальный документ и извлеченный источник), детерминизм (бизнес-правила, которые можно повторно запустить) и прослеживаемость (какой парсер, модель, запрос и рецензент создали окончательный результат).
Итоговый контрольный список
Программа для анализа счетов-фактур работает как с исходными PDF-файлами, так и с отсканированными копиями, которые вы получаете.
Результаты извлечения данных ограничены версионированной схемой Pydantic.
Модель не имеет права выдумывать пропущенные значения.
Итоговые суммы, даты, наличие дубликатов, идентификационные данные поставщика и правила оформления заказов на покупку проверяются вне системы LLM.
Неправильные правила приводят к проверке человеком, а не к молчаливому исправлению.
В лог записываются исходный документ, хеш источника, модель, версия запроса и результат проверки.
API ограничивает тип и размер файлов и требует аутентификации перед использованием в производственной среде.
Ваш тестовый набор содержит реальные варианты компоновки и граничные случаи.
Лицензии на модели и библиотеки проверены на соответствие вашим требованиям.
Списания в рамках последующего бухгалтерского учета вводятся постепенно и остаются подлежащими аудиту.
Если эти механизмы контроля внедрены, у вас есть не просто демонстрационная версия OCR: у вас есть основа для надежного агента обработки счетов-фактур. Компоненты с открытым исходным кодом могут меняться со временем, но архитектура остается устойчивой — анализ доказательств, извлечение информации в схему, проверка с помощью кода, передача информации о неясностях специалистам и запись каждого решения.