Главная
» Домены
»
Как создать пользовательские GPT-таблицы, которые не забывают свои файлы знаний.
Как создать пользовательские GPT-таблицы, которые не забывают свои файлы знаний.
Текущий статус, проверено 13 сентября 2026 г.: OpenAI сообщает, что личные учетные записи ChatGPT, включая Free, Go, Plus и Pro, не могут создавать или публиковать новые GPT. Существующие GPT по-прежнему можно использовать и, при наличии такой возможности, редактировать. В рабочих пространствах Business, Enterprise и Edu создание зависит от настроек рабочего пространства и разрешений. OpenAI также сообщает, что пользовательские рабочие процессы GPT переносятся в плагины, миграция запланирована на 17 сентября 2026 г., а вывод из эксплуатации затронутых GPT Enterprise запланирован на 11 декабря 2026 г. Если вы читаете это позже, перед созданием нового рабочего процесса проверьте последний статус в документации OpenAI по созданию и редактированию GPT .
Пользовательская таблица GPT, которая, кажется, «забывает» файл знаний, обычно не теряет этот файл. В разделе часто задаваемых вопросов OpenAI о загрузке файлов говорится, что файлы, загруженные в виде таблиц GPT, сохраняются до тех пор, пока пользовательская таблица GPT не будет удалена. Более распространенная проблема — это поиск: модель не обязательно полностью считывает каждый загруженный файл для каждого вопроса. Она извлекает материал, который кажется релевантным заданию, поэтому качество исходного кода, структура файла, инструкции и тестирование — все это влияет на то, будет ли показан правильный фрагмент.
Также следует различать «знания» и «память». В документации ChatGPT от OpenAI говорится, что GPT не используют сохраненную память, персональные пользовательские инструкции или предыдущие беседы; каждая беседа начинается заново. Таким образом, загруженные знания представляют собой настроенный справочный источник, а не память беседы, которая накапливается из предыдущих чатов.
Как должен выглядеть надежный результат
Цель состоит не в том, чтобы заставить GPT упоминать файл на каждом шагу. Цель состоит в том, чтобы ответы, зависящие от источника, были последовательно основаны на правильном материале, в то время как ответы на вопросы без подтверждения должным образом должным образом должным образом опровергаться, а не давать уверенные предположения.
Качественный сигнал
Как выглядит «хорошо»
Когда следует менять настройки?
Правильность
Ответ соответствует исходному файлу, содержащему информацию по проверяемому вопросу.
Если ответ неверный, несмотря на наличие факта, упростите источник или сузьте формулировку вопроса.
Заземление
GPT может указать имя вспомогательного файла или раздела по запросу.
Если ответ основан на общих знаниях, следует усилить указания на приоритетность источника и провести повторное тестирование.
Воздержание
Если в файлах нет ответа, GPT четко об этом указывает.
Если вводится новая политика, цена, дата или процедура, добавьте явное правило, исключающее догадки.
Последовательность
Эквивалентные формулировки дают в целом непротиворечивые ответы.
Если небольшие изменения в формулировках приводят к существенным отклонениям, уменьшите двусмысленность как в файлах, так и в инструкциях.
Обновление целостности
После пересмотра исходного текста те же оценочные вопросы отражают новое содержание.
Если старые ответы по-прежнему сохраняются, убедитесь, что обновленный файл прикреплен, сохраните файл GPT и повторно запустите тесты.
Восемь шагов для повышения надежности использования файлов знаний.
1. Убедитесь, что ваша учетная запись или рабочее пространство по-прежнему могут создавать или редактировать GPT-файлы.
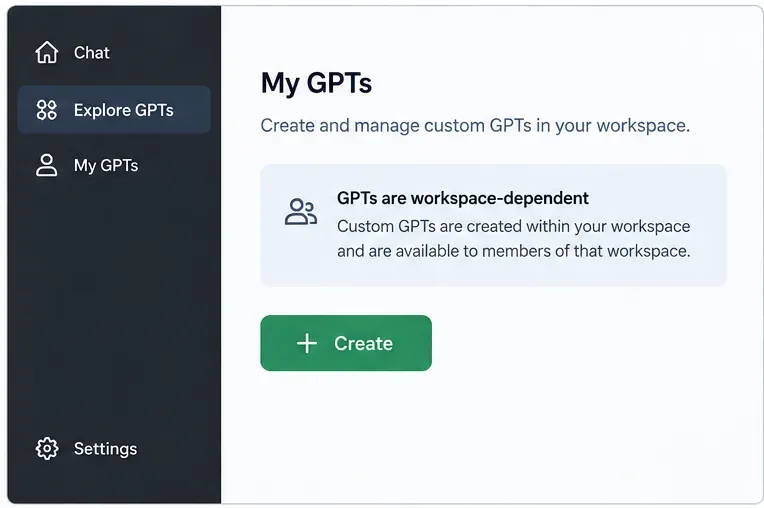
Начнем с проверки соответствия требованиям, поскольку отсутствие кнопки «Создать» теперь может быть ожидаемым поведением, а не проблемой браузера. В текущих рекомендациях OpenAI по GPT в ChatGPT указано, что создание новых GPT недоступно для личных учетных записей. Управляемые рабочие пространства по-прежнему могут предоставлять возможность создания GPT на основе политики администратора и прав доступа к ролям. Если у вас уже есть существующая GPT, проверьте, доступна ли ее редактирование для вашей учетной записи.
В соответствующих управляемых рабочих пространствах начните с области GPT; доступность зависит от прав доступа к рабочему пространству.
Не тратьте время на устранение неполадок с поиском знаний, пока не убедитесь, что работаете в поддерживаемом редакторе. Если ваша организация уже переходит на плагины, рассматривайте оставшийся пользовательский GPT как потенциальный объект для миграции, а не как новую долгосрочную зависимость.
2. Разделяйте инструкции по поведению и знания.
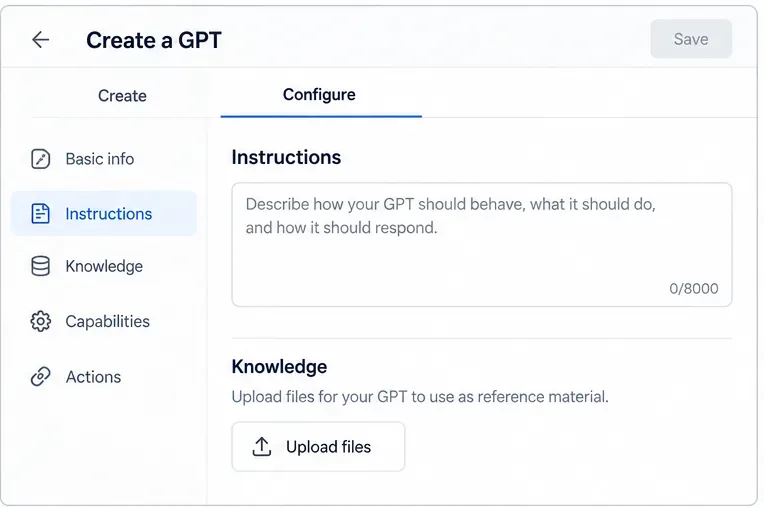
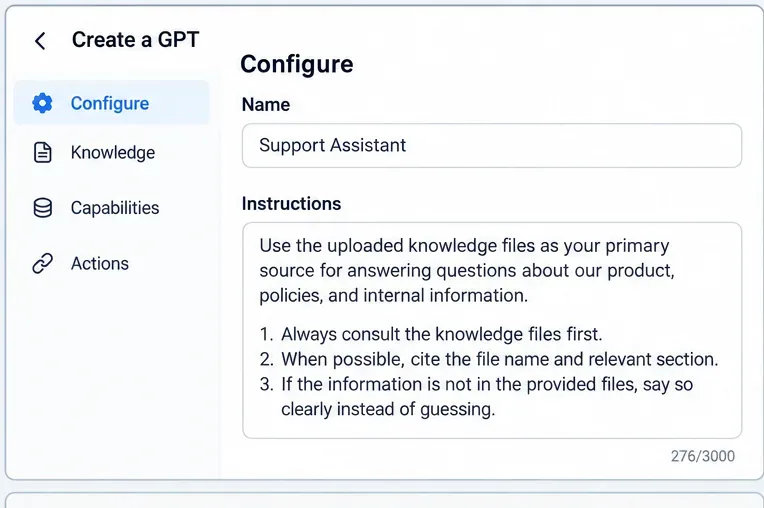
Поле «Инструкции» содержит правила, касающиеся тона, порядка принятия решений, формата цитирования, поведения при эскалации и того, что должен делать GPT, когда источник молчит. Поле «Знания» предназначено для справочных материалов: руководств, документации по продукту, политик, часто задаваемых вопросов, спецификаций или внутренних руководств. OpenAI настоятельно рекомендует такое разделение, поскольку знания лучше всего работают как исходный материал, а инструкции определяют поведение.
Правила поведения следует хранить в разделе «Инструкции», а справочные материалы — в разделе «Знания».
Это различие важно для надежности. Предложение типа «Никогда не указывайте цену, срок действия которой истек» должно быть в разделе «Инструкции». Сама таблица цен должна быть в разделе «Знания». Смешивание правил в большом справочном PDF-файле затрудняет контроль и тестирование поведения.
3. Подготовьте файлы для поиска, а не только для чтения человеком.
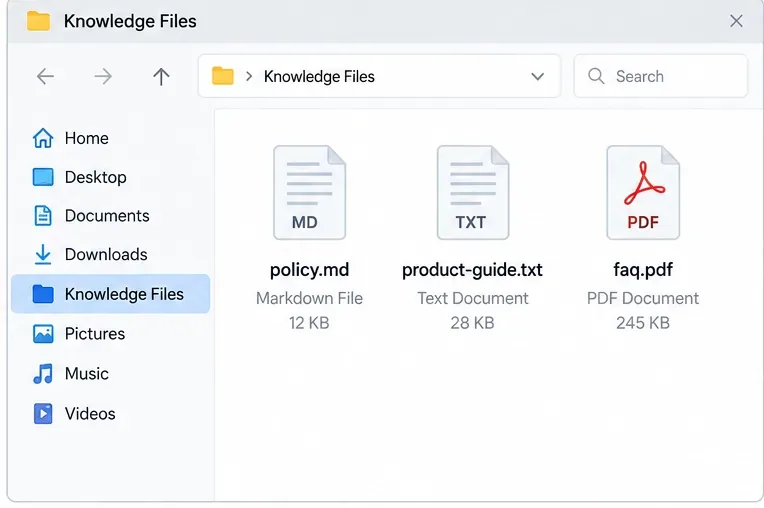
Предпочтительнее использовать понятные текстовые файлы с описательными заголовками, короткими разделами, стабильной терминологией и однозначными датами версий. Красиво оформленная брошюра может оказаться менее информативной, чем простой файл Markdown или текстовый файл, если важная информация разбросана по колонкам, выноскам, скриншотам или декоративным элементам оформления.
Текстовые файлы с понятными именами и простой структурой легче и надежнее извлекать.
Это особенно важно для PDF-файлов. В разделе часто задаваемых вопросов OpenAI по визуальному поиску в PDF-файлах говорится, что PDF-файлы, загруженные в качестве базы знаний GPT, обрабатываются с поиском только текста. Другими словами, диаграмма, схема или снимок экрана внутри PDF-файла не должны быть единственным местом, где находится важное правило. Добавьте текстовое пояснение или текстовый файл-спутник.
Также удалите устаревшие дубликаты. Если в одном файле указан срок возврата 14 дней, а в другом — 30 дней, при поиске можно обнаружить любой из этих вариантов. Названия файлов, такие как returns-policy-2026-09.md , и видимый текст «дата вступления в силу» упрощают аудит версионирования.
4. Загрузите небольшой, связный набор знаний и проверьте его.
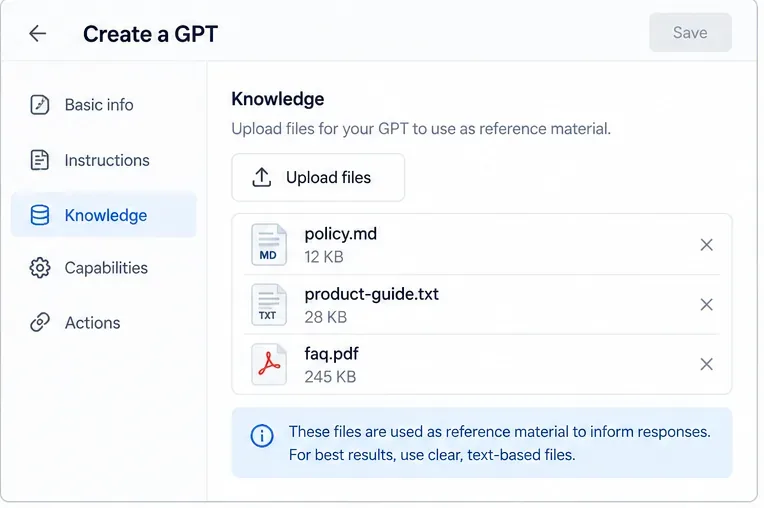
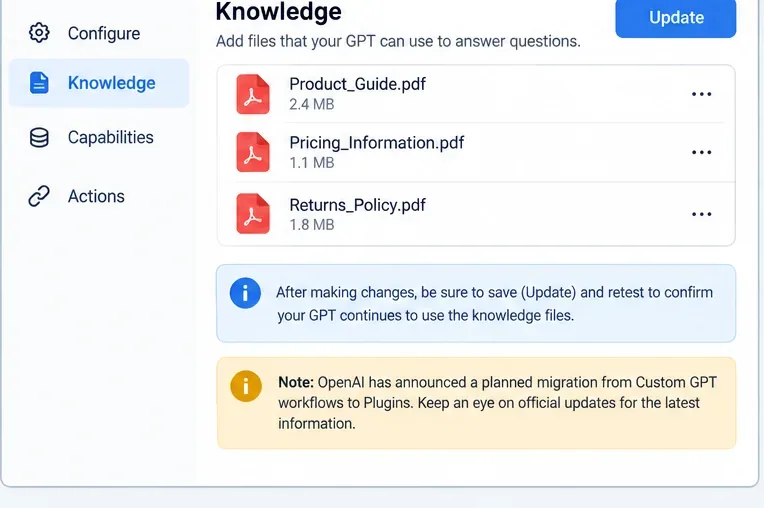
Загружайте только те файлы, которые действительно необходимы GPT. В рекомендациях OpenAI по работе с корпоративными файлами отмечается, что меньшее количество, но более целенаправленных документов, как правило, повышает точность поиска по файлам. После загрузки убедитесь, что каждый ожидаемый файл присутствует в списке базы знаний, прежде чем продолжить.
Загрузите эталонный набор файлов, затем убедитесь, что все ожидаемые файлы присутствуют, прежде чем приступать к тестированию.
В настоящее время существует несоответствие в документации относительно количества файлов. В руководстве по редактору GPT указано, что к GPT можно прикрепить до 20 файлов, в то время как в разделе часто задаваемых вопросов о загрузке файлов говорится о возможности прикрепить до 10 файлов к одному GPT за весь срок его существования. В обоих документах указан жесткий лимит в 512 МБ на файл, а в разделе часто задаваемых вопросов о загрузке файлов указано ограничение в 2 миллиона токенов для текстовых и документных файлов. Поскольку официальные страницы расходятся во мнениях относительно количества файлов, не следует разрабатывать критически важный рабочий процесс, ориентируясь на большее число, не проверив текущую версию редактора и документацию для вашей учетной записи.
5. Добавить инструкции, ориентированные на поиск информации.
Не следует полагаться на расплывчатые инструкции, такие как «Используйте загруженные файлы». Укажите, что должно происходить, когда вопрос относится к области, подкрепленной знаниями. Практический пример: сначала обратитесь к загруженным знаниям; отдавайте им предпочтение перед общими знаниями о моделях для фактов, специфичных для вашей компании; укажите вспомогательный файл или раздел, если это возможно; и укажите, что информация недоступна, если файлы не подтверждают ответ.
Инструкции, ориентированные на поиск информации, должны определять приоритет источника, порядок цитирования и резервный вариант, исключающий догадки.
В рекомендациях OpenAI по устранению неполадок предлагается использовать более узкие подсказки, которые напрямую ссылаются на прикрепленные документы, когда знания используются неэффективно. Также рекомендуется хранить правила и поведение рабочего процесса в инструкциях, а не скрывать их в загруженных файлах. См. раздел « Устранение неполадок с GPT» .
Избегайте противоречивых инструкций. «Всегда отвечайте пользователю» противоречит «Никогда не отвечайте, если файл этого не подтверждает». Замените это противоречие явным запасным вариантом, например: «Если файлы знаний не содержат требуемого факта, укажите, что предоставленные источники не подтверждают ответ, и предложите утвержденный следующий шаг».
6. Выполните проверку заземления в режиме предварительного просмотра.
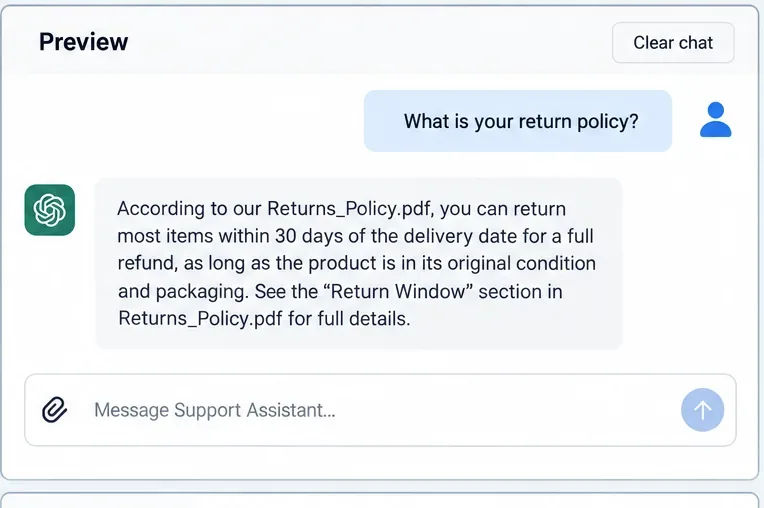
Проверяйте вопросы, правильные ответы на которые наверняка есть в файлах. Не проверяйте только самое простое предложение с первой страницы. Включайте вопросы, требующие поиска информации в разных разделах, распознавания альтернативных формулировок и различения схожих правил.
Положительный результат теста означает правильный ответ и указывает на соответствующий файл или раздел.
Для каждого теста запишите ожидаемый ответ, ожидаемый исходный файл и то, цитировал ли GPT этот источник или идентифицировал его по запросу. В рекомендациях OpenAI Academy по использованию GPT рекомендуется создать оценочный набор примерно из 10-15 репрезентативных вопросов с правильными ответами. Этого достаточно, чтобы выявить повторяющиеся ошибки, не превращая каждое редактирование в крупный тестовый проект.
Оценивайте результат по тому, насколько он обоснован, а не просто по тому, насколько он звучит связно. Отполированный ответ с неверной позицией — это провал. Более короткий ответ, точно ссылающийся на регулирующий документ, обычно дает лучший результат.
7. Проведите отрицательные тесты и переформулируйте тесты.
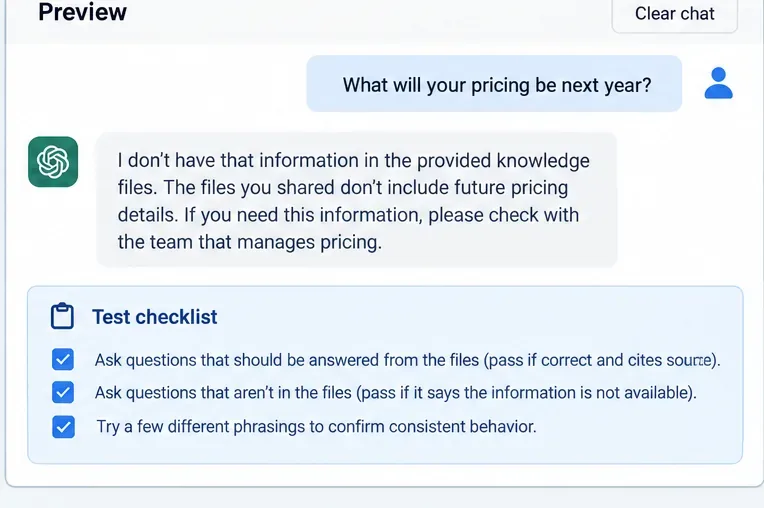
Надежный помощник по работе с информацией должен знать, чего он не знает. Задавайте вопросы, которые намеренно отсутствуют в файлах: будущая цена, невыпущенная функция, политика для страны, не охваченной руководством, или дата, выходящая за рамки документа. Желаемый результат — это четкое ограничение, а не правдоподобное изобретение.
Отрицательные результаты тестов имеют значение: GPT должен признавать, когда ответ отсутствует в файлах, и сохранять согласованность при перефразировании.
Затем переформулируйте несколько положительных и отрицательных вопросов разными способами. Если вопрос «Каков срок возврата средств?» работает, а вопрос «Сколько времени у меня есть на отправку товара обратно?» не работает, проблема может заключаться в объеме предоставленной информации, а не в недостатке знаний. Улучшите заголовки, терминологию или инструкции, прежде чем добавлять новые файлы.
8. Обновления версий, повторное тестирование и понимание того, когда статические знания — неподходящий инструмент.
При каждом изменении исходного кода удаляйте устаревшую версию, подключайте текущую, сохраняйте или обновляйте GPT и повторно запускайте тот же набор оценочных тестов. Ведение небольшого журнала изменений вне GPT поможет определить, вызвана ли регрессия новыми инструкциями, заменой исходного кода или изменением платформы.
После изменения исходных файлов или инструкций сохраните обновление и повторно запустите тот же набор оценочных тестов.
Статические знания имеют свои ограничения. Если источник постоянно меняется, доступ должен соответствовать правам доступа каждого пользователя, или же помощнику необходимы актуальные оперативные данные, многократная загрузка файлов становится ненадежной. Приложения OpenAI с синхронизированной документацией описывают индексированные связанные источники, которые остаются актуальными, соблюдая при этом права доступа к источнику. OpenAI также направляет пользовательские рабочие процессы GPT на использование плагинов, поэтому часто меняющаяся база знаний является более подходящим кандидатом для связанной или мигрированной архитектуры, чем растущий объем статических файлов.
Как диагностировать GPT-файл, который по-прежнему «забывает» файл?
Если известный факт упущен, сначала докажите, что он действительно присутствует в прикрепленном актуальном файле. Затем задайте более узкий вопрос, указав документ или тему. Если узкий вопрос работает, улучшите подсказки для поиска, упростив заголовки, разделив слишком общий документ или удалив конкурирующие версии. Если узкий вопрос по-прежнему не помогает, преобразуйте важный материал в более чистый текст и повторите попытку.
Не следует сразу же исправлять каждую ошибку, добавляя новые инструкции. Избыточное количество или противоречащие друг другу правила могут сделать поведение менее предсказуемым. Аналогично, не добавляйте новые файлы, пока не убедитесь, что существующий набор правилен. Необходимым показателем качества является повторяемость: один и тот же небольшой набор оценочных тестов должен проходить проверку после каждого изменения, особенно в отношении вопросов, связанных с политикой, правовыми аспектами, ценообразованием или операционной деятельностью, сопряженных с высоким риском.
Практический предел: можно улучшить поиск, но не гарантировать его.
Ни один запрос не может заставить генеративную модель с абсолютной уверенностью обращаться к каждому файлу знаний при каждом ответе. Поэтому надежная пользовательская GPT-модель — это продуманный рабочий процесс, а не одноразовая загрузка: сфокусированные исходные файлы, явные инструкции по приоритету источников, определенное поведение воздержания и повторяемая оценка. Если эти параметры по-прежнему не обеспечивают необходимую точность или актуальность, измените архитектуру, а не продолжайте настраивать ту же статическую конфигурацию.
Для соответствующих GPT-файлов этот процесс может существенно уменьшить проблему «файл был забыт». Однако для новых проектов, начатых в конце 2026 года, при принятии долгосрочного решения следует также учитывать объявленный OpenAI переход от пользовательских GPT-процессов к плагинам и доступность связанных источников знаний.