如何阻止 CrewAI 代理執行冗餘任務:實用去重指南

透過修復任務所有權、依賴關係、委託、重試、流程觸發器、狀態持久性、快取和冪等性,防止 CrewAI 代理重複工作。
在許多工作負載中,將 LLM API 帳單減少 50% 是可行的,但這並非普遍保證。結果取決於您的支出來源:未緩存的輸入 token、已緩存的輸入 token、輸出 token、推理 token、工具呼叫或重試。當長篇或重複的輸入佔帳單的顯著比例時,提示詞壓縮的效果最佳。因此,實際目標並非「讓每個提示詞長度減半」,而是「移除不會改變答案的 token,保留會改變答案的 token,並在真實流量上驗證節省效果」。
本指南採用四個實施步驟:測量基準、移除冗餘輸入、組織提示詞以促進緩存重用,以及在 API 支援的情況下,將冗長的輸出指令移至結構化控制中。範例僅供說明,並非基準測試聲明。供應商定價和緩存行為會隨時間變化,因此在進行生產環境估算前,請先驗證當前費率。
從您模型的計費公式開始。對於簡單的文本工作負載,總請求成本約等於未緩存輸入加上已緩存輸入加上輸出的成本。某些模型或功能會增加其他計費類別。OpenAI 當前的 API 回應會暴露輸入和輸出 token 使用量,包括緩存 token 的詳細資訊,且其模型頁面會發布輸入、已緩存輸入和輸出的單獨費率。
| 說明性工作負載 | 輸入 Token | 輸出 Token | 相對結果 |
|---|---|---|---|
| 基準請求 | 10,000 | 1,000 | 基準成本的 100% |
| 僅將輸入減半 | 5,000 | 1,000 | 當輸出保持不變時,總節省少於 50% |
| 輸入和輸出均減半 | 5,000 | 500 | 當費率不變時,基於 token 的成本約降低 50% |
作為具體的當前範例,官方 GPT-5.6 Sol 模型頁面在 2026 年 9 月 11 日列出的費率為:每百萬輸入 token 4 美元,每百萬已緩存輸入 token 0.40 美元,每百萬輸出 token 20 美元。按照這些費率,一個 10,000 輸入/1,000 輸出的請求成本約為 0.06 美元(不含其他費用)。僅將輸入減少到 5,000 個 token 會使該範例降至約 0.04 美元,減少 33%。將輸入和輸出均減半會使其降至約 0.03 美元,減少 50%。這些價格可能會變動,因此請將此算術視為一種方法,而非永久報價。請參閱 官方 GPT-5.6 Sol 模型頁面 以獲取當前定價。
| 技術 | 最佳適用場景 | 主要風險 | 需測量的項目 |
|---|---|---|---|
| Token 審計 | 任何生產工作負載 | 優化錯誤的組件 | 輸入、已緩存輸入、輸出、重試、每個成功任務的成本 |
| 冗餘移除 | 長系統提示詞、重複政策、冗長範例 | 刪除實際上重要的約束條件 | 任務成功率和指令遵循的一致性 |
| 緩存友好佈局 | 共享穩定指令或上下文的重複請求 | 因動態文本出現過早導致緩存重用率低 | 緩存 token 比率和延遲 |
| 結構化輸出控制 | JSON 提取、分類、固定回應格式 | 架構對任務而言過於僵化 | 輸出 token、解析失敗、重試 |
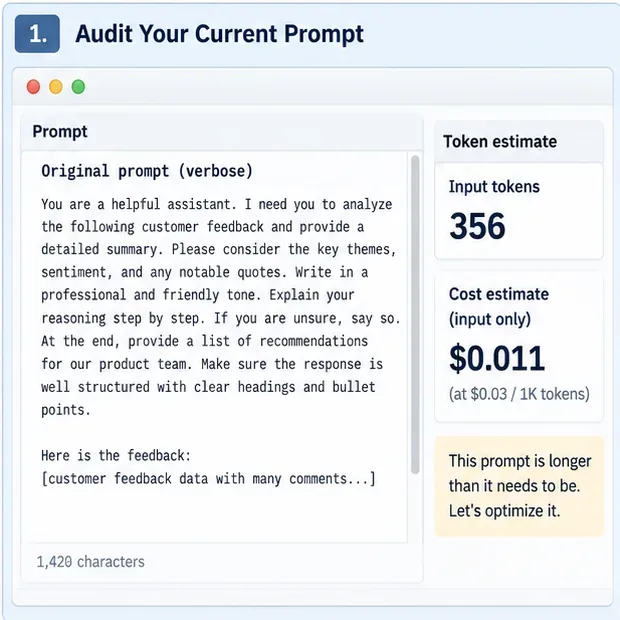
圖說:一個說明性的 token 審計介面記錄了原始提示詞大小和壓縮前的樣本成本估計;這些數字並非當前的供應商定價。
收集生產請求的代表性樣本,而不是優化一個手動挑選的提示詞。至少記錄輸入 token、可用的已緩存輸入 token、輸出 token、模型名稱、延遲、重試次數,以及最終答案是否通過您的業務品質檢查。如果您的供應商提供輸入 token 計數端點,在需要確定性預算時,請在發送請求前使用它。OpenAI 目前在其 官方 API 參考文件 中記錄了 Responses 輸入 token 計數端點。
計算每個成功任務的成本,而不仅仅是每個 API 呼叫的成本。導致更多重試的壓縮提示詞即使每個請求更短,也可能更昂貴。同時按任務類型對基準進行分段:摘要、提取、RAG 問答、代理工具使用和長對話通常具有不同的 token 分佈。

圖說:一個說明性的前後對比提示詞在移除重複措辭和不必要的流程指令的同時,保留了相同的請求輸出。
最安全的第一次壓縮通過是語義去重。刪除重複的角色描述、重複的約束條件、禮貌性填充詞、對明顯格式的解释,以及多次教授相同模式的範例。將重疊的規則合併為單一指令。優先使用一句精確的句子,而不是幾句重述相同要求的句子。
You are a helpful assistant who is an expert in product analysis.
I need you to analyze the following customer feedback and provide
a detailed summary. Please identify the key themes, overall sentiment,
notable quotes, and recommendations for our product team. Make sure
your response is professional, clear, concise, and well structured.
Analyze the customer feedback.
Return: key themes, overall sentiment, notable quotes, and product recommendations.
Be concise and factual.
不要僅僅因為例外情況、政策邊界、領域定義、工具安全規則或證據要求很長就將其壓縮掉。這些通常是高價值的 token。一個有用的測試是問:「如果我刪除這句話,可接受的輸出會改變嗎?」如果是,請保留它,除非 API 控制或架構可以更可靠地強制執行相同的行為。
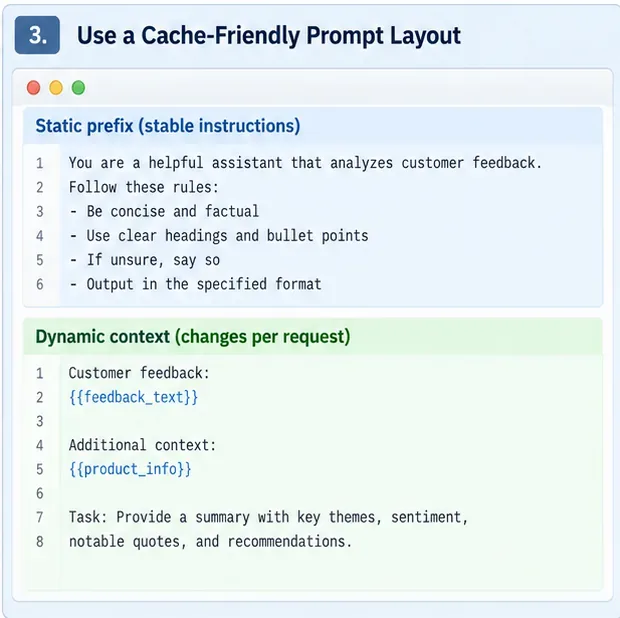
圖說:一個說明性的提示詞佈局將穩定指令放置在可重用的前綴中,並在後面附加請求特定的上下文。
提示詞緩存不會減少原始 token 數量,但可以減少按正常輸入費率計費的金額並降低提示詞處理延遲。這使得提示詞佈局成為成本優化的一部分。將系統指令、共享範例、工具指南和其他穩定內容分組在一起。將請求特定的事實、檢索到的段落、用戶數據和當前問題放在後面。
OpenAI 的模型指南明確建議將靜態內容放在前面,動態內容放在後面,以改善提示詞緩存重用,且其回應使用對象暴露緩存 token 資訊以供測量。請參閱 官方模型指南 和 Responses API 參考文件。
避免在否則可重用的前綴內更改無害的空格、範例順序、時間戳、隨機 ID 或每用戶文本,除非供應商的緩存語義表明這些更改是安全的。從 API 回應中測量緩存命中,而不是假設提示詞正在被重用。
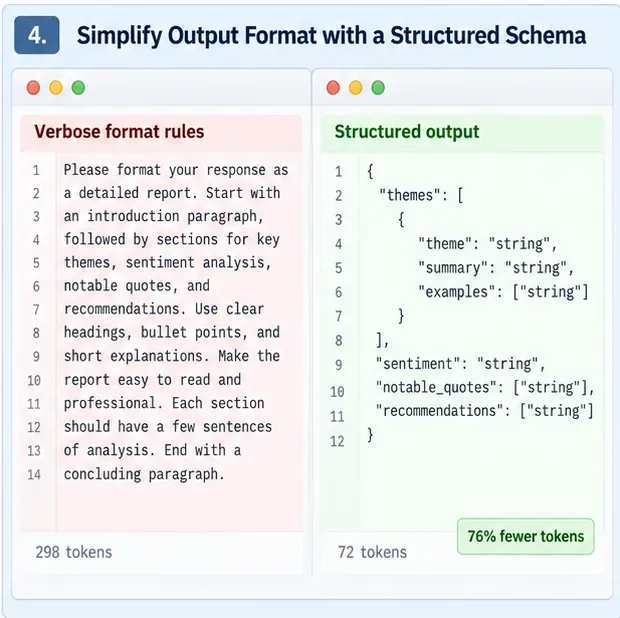
圖說:一個說明性的結構化輸出視圖顯示架構如何取代許多重複描述相同回應形狀的散文行。
提取和分類提示詞經常浪費 token 用自然語言描述 JSON 欄位、允許值、嵌套、順序和驗證規則。當 API 支援結構化輸出或類型化工具參數時,盡可能將該契約移至結構化介面中,並讓自然語言指令專注於意義。
當前的 OpenAI 指南特別建議在可能的情況下從提示詞中移除輸出架構定義,並改用結構化輸出(Structured Outputs)。這可以減少提示詞文本,也可以減少格式錯誤輸出的重試。確切機制因供應商而異,因此在未檢查該供應商文件的情況下,不要將 OpenAI 特定的請求格式複製到另一個 API。
在四個基本步驟穩定後,更大的節省通常來自減少上下文而不是潤飾句子措辭。在 RAG 系統中,檢索更少但更相關的段落,對近乎相同的塊進行去重,並避免附加無法影響答案的文件。對於長對話,保留持久事實和未解決的決策,但摘要或刪除不再影響當前任務的輪次。對於代理系統,當您的架構安全允許時,僅暴露與當前階段相關的工具和工具描述。
學習型提示詞壓縮器是超長上下文的另一個選項。Microsoft 的開源 LLMLingua 專案 實現了 token 級提示詞壓縮。原始的 LLMLingua 論文 報告在其評估設定中,壓縮率高達 20 倍,且基準測試退化有限。LongLLMLingua 針對長上下文任務,而 LLMLingua-2 使用任務無關的學習壓縮器。這些是研究結果,並非保證相同比率能在您的數據上保留品質。在部署激進壓縮之前,請對您自己的任務、語言、模型和提示詞類型進行基準測試。
在相同的代表性請求上運行 A/B 評估。基準和壓縮版本應使用相同的模型、推理設定、工具、檢索輸入和成功標準。盡可能一次更改一種壓縮技術,以便識別導致回歸的原因。
| 指標 | 為什麼重要 | 建議解釋 |
|---|---|---|
| 輸入 token 減少 | 顯示原始提示詞縮小 | 有用,但單獨來看不足夠 |
| 緩存 token 比率 | 顯示穩定前綴是否被重用 | 當品質不變時,越高通常越好 |
| 輸出 token 減少 | 可以實質改變總成本 | 驗證簡潔輸出仍能完成任務 |
| 每個成功任務的成本 | 包括重試和失敗 | 這是主要的業務指標 |
| 任務成功率 / 準確率 | 檢測資訊遺失 | 在測試前設定可接受的非劣效閾值 |
| p50 和 p95 延遲 | 顯示真實用戶影響 | 壓縮預處理可能會抵消推理節省 |
不要因為提示詞短了 50% 就宣稱勝利。更強的接受條件是:壓縮配置在保持預定義的品質、延遲和可靠性容差範圍內的同時,將測量成本降低大約您的目標金額。
當下一次減少刪除正確決策所需的事實、增加幻覺、導致工具呼叫錯誤、削弱政策合規性,或增加重試次數以至於抵消節省時,請停止或退縮。如果您運行單獨的模型來壓縮每個提示詞,壓縮也可能增加延遲。一項 2026 年關於真實世界推理環境中提示詞壓縮的研究 發現,在有利於提示詞長度和硬體機制之外,預處理開銷可能會抵消推理增益,這是另一個測量端到端性能而非僅測量 token 數量的原因。
對於小提示詞,手動清理和緩存友好組織通常比添加專用壓縮模型更容易證明其合理性。對於大型 RAG 負載或多文件工作流,上下文選擇和學習壓縮變得更有吸引力,因為可移除的 token 量大得多。
對於某些冗長、上下文密集的工作負載,降低 50% 是一個合理的工程目標,但應將其視為需要驗證的結果,而非預設期望。最可靠的路徑是先測量,移除語義冗餘文本,最大化安全緩存重用,使用結構化控制縮短輸出契約,然後使用檢索剪枝、摘要或經過測試的提示詞壓縮器攻擊剩餘的最大上下文塊。如果每個成功任務的最終成本下降,而品質保持在您的接受範圍內,則壓縮正在起作用。如果品質或重試惡化,請恢復遺失的資訊並優化請求的另一部分。
透過修復任務所有權、依賴關係、委託、重試、流程觸發器、狀態持久性、快取和冪等性,防止 CrewAI 代理重複工作。
Compare HubSpot Free CRM and Zoho CRM Free for solo real estate agents, including contact limits, pipelines, email, automation, mobile tools, and upgrade tradeoffs.
在 Windows 11 上使用 LM Studio 本地執行 DeepSeek。了解適合一般 PC 的模型、如何下載與載入、驗證離線使用,以及解決常見問題。
透過四種實用的提示詞壓縮技術、緩存友好的佈局、結構化輸出以及保留品質的評估計畫,來降低 LLM API 成本。
使用自託管的 n8n 和 Claude 建立可免費託管的 AI 內容再利用流程,包含結構化輸出、審核閘門以及現實的 API 成本指南。
將 Ollama 連接至 Obsidian 以實現本地 AI 聊天與感知資料庫的 PKM。學習設定、品質檢查、本地嵌入、隱私限制,以及何時更換模型。
使用 AI 代理、網路搜尋、有證據支持的變更偵測、GitHub Actions 排程以及人工審核,建立每週競爭對手監控工作流程。
學習如何使用 Claude 系統提示詞,為一致的技術文件設定清晰的語氣、受眾、格式、不確定性及風格界線。
透過針對資料攝取、檢索、存取控制、提示邊界、工具權限、輸出驗證及紅隊測試的實用控制措施,保護本地 RAG 系統免受提示注入攻擊。
Outlook 能收信但無法寄信?按實用順序診斷寄件匣、離線模式、密碼、SMTP 設定、帳戶限制、設定檔及增益集。