如何阻止 CrewAI 代理執行冗餘任務:實用去重指南

透過修復任務所有權、依賴關係、委託、重試、流程觸發器、狀態持久性、快取和冪等性,防止 CrewAI 代理重複工作。
是的,您可以在 Windows 11 上使用 LM Studio 完全離線執行 DeepSeek,但您需要先進行一次線上設定。安裝 LM Studio,下載相容的 DeepSeek 模型和必要的執行環境,載入模型一次,然後您就可以斷開網路連線。LM Studio 的官方離線文件指出,與已下載的模型聊天、與本地文件聊天以及運行其本地伺服器都不需要網路存取。
對於典型的 Windows 11 PC,最實用的起點並非目前最大的 DeepSeek 模型。較小的 GGUF 模型,例如 DeepSeek-R1-0528-Qwen3-8B,在本地運行要容易得多。LM Studio 於 2025 年 5 月發布了對該 8B 蒸餾模型的支持,並表示它在 LM Studio 0.3.16 或更新版本中以 GGUF 格式運作。相比之下,LM Studio 於 2026 年 8 月針對 DeepSeek V4 Flash 的指南指出,本地使用需要約 156GB 的系統記憶體。這使得 V4 Flash 成為大多數消費級 Windows 機器的糟糕選擇,儘管它更新且功能更強大。
本指南於 2026 年 9 月 11 日進行檢查。LM Studio 的更新日誌列出了日期為 2026 年 9 月 9 日的 0.4.24 版本。由於 LM Studio 的介面不斷演變,按鈕在不同版本之間可能會略有移動,但核心工作流程——下載模型、載入模型、本地聊天,以及選擇性地暴露 localhost API——仍由 LM Studio 記錄在案。
LM Studio 目前同時支援 x64 Windows PC 和基於 ARM 的 Windows 系統。對於 x64,CPU 必須支援 AVX2。LM Studio 建議至少 16GB RAM 和至少 4GB 專用 VRAM。這些是應用程式層級的建議,並非保證每個模型都能容納。模型大小、量化、上下文長度和 GPU 卸載都會影響記憶體使用量。
| 您擁有的硬體 | 實用建議 | 原因 |
|---|---|---|
| 16GB RAM,中等 GPU 或整合圖形 | 從 4-bit GGUF 變體的 8B 或更小的 DeepSeek 蒸餾模型開始 | 它在保持模型佔用空間相對可控的同時,保留了有用的推理能力。 |
| 更多 RAM 和更強大的 GPU | 僅在檢查 LM Studio 的裝置適配估計後,才嘗試更大的蒸餾變體 | 較大的模型可能會提高品質,但會消耗大量記憶體,且速度可能慢得多。 |
| 普通遊戲 PC 或筆記型電腦 | 不要從 DeepSeek V4 Flash 開始 | LM Studio 表示本地 V4 Flash 模型至少需要 156GB 的系統記憶體。 |
LM Studio 的模型下載文件解釋說,量化構建以犧牲一些保真度為代價,換取更小的檔案和更低的記憶體壓力。其一般建議是,當您的硬體可以處理時,選擇 4-bit 或更高選項。如果您不確定,4-bit GGUF 版本是一個明智的首次測試。
官方參考:LM Studio 系統需求、LM Studio 模型下載指南,以及 LM Studio 更新日誌。
從 官方 LM Studio 下載頁面 下載目前的穩定版 Windows 建置。使用與您的 Windows 架構相符的安裝程式。在 x64 PC 上,請確保您的處理器支援 AVX2,以免日後在排除模型載入錯誤時遇到問題。
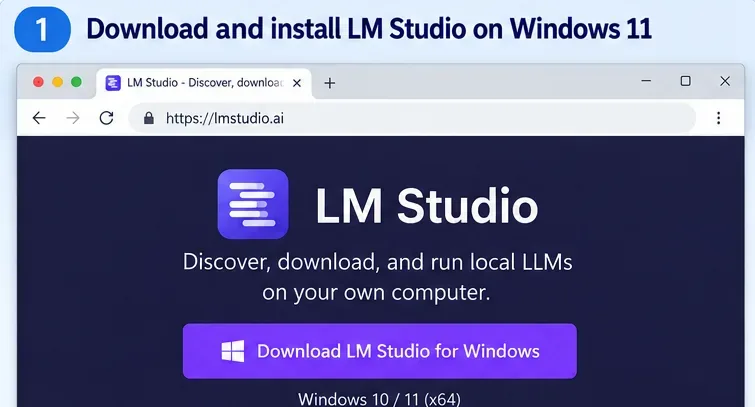
在仍有網路連線時啟動 LM Studio。這很重要,因為應用程式可能需要下載或更新 LM Runtime。LM Studio 將執行環境描述為打包的推論引擎,例如其基於 llama.cpp 的 GGUF 模型執行環境。執行環境下載需要連線,即使之後推論可以離線工作。
開啟 LM Studio 中的 Discover 區域並搜尋 DeepSeek。LM Studio 可以透過關鍵字、user/model 識別碼,甚至完整的 Hugging Face URL 來搜尋支援的 Hugging Face 模型。
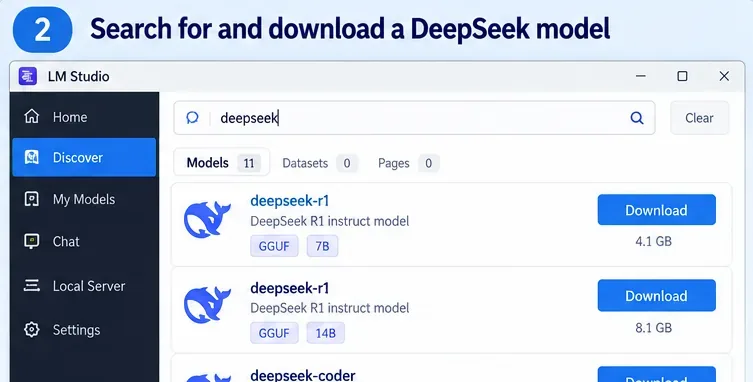
對於遵循本指南的大多數人,請從 DeepSeek-R1-0528-Qwen3-8B 開始。LM Studio 表示,這個蒸餾的 8B 模型支援推理和工具使用,以 GGUF 格式提供,並且可以使用比旗艦 DeepSeek 模型少得多的記憶體運行。LM Studio 的 Windows 指南仍建議應用程式整體使用 16GB RAM,因此不要將特定模型的低記憶體聲明視為舒適的整體系統目標。
DeepSeek 還發布了較早的 R1 蒸餾變體,參數分別為 1.5B、7B、8B、14B、32B 和 70B。這些讓您在速度和記憶體使用與能力之間進行權衡。請參閱 官方 DeepSeek-R1 儲存庫 以獲取模型系列和授權詳細資訊,以及 LM Studio 的 DeepSeek-R1-0528 本地運行說明 以獲取 8B 選項。
如果您因為 DeepSeek V4 Flash 較新而心動,請先檢查硬體需求。LM Studio 的 官方 V4 Flash 文章 指出,284B 混合專家模型(Mixture-of-Experts)本地使用至少需要 156GB 的系統記憶體。它在高記憶體工作站上是可行的,而不是普通的 Windows 筆記型電腦。
下載完成後,前往您的已下載模型或從 Chat 開啟模型載入器。選擇 DeepSeek 模型並載入它。LM Studio 解釋說,載入模型會為模型權重和相關的執行環境狀態分配記憶體。
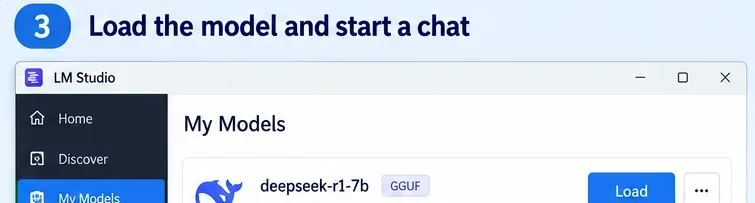
對於您的首次運行,請保持載入設定保守。非常大的上下文視窗可能會消耗大量額外記憶體,因此沒有理由立即最大化上下文。以適中的上下文載入模型,驗證其是否正常運作,僅在工作負載需要時才擴展。
如果 LM Studio 報告模型不適合,最可靠的修復方法通常是選擇較小的模型或更緊湊的量化。關閉記憶體密集型應用程式可能有幫助,但它不會改變基本的模型佔用空間。
這是區分「本地模型」與僅僅「使用桌面客戶端」的關鍵步驟。一旦模型及其執行環境安裝完成,請關閉 Wi-Fi 並斷開乙太網路連線。然後開始新的聊天並發送一個簡單的提示,例如:
用五個要點解釋 RAM 和 VRAM 的區別。如果模型在 PC 沒有網路連線時回應,則推論是本地的。LM Studio 聲明,一旦 LLM 位於您的機器上,它就可以完全離線運行,並且輸入到本地 LLM 聊天中的文字不會離開您的裝置。其離線文件還指出,本地文件處理和 RAG 保留在機器上。

有一個重要的界限:搜尋模型、下載新模型、下載執行環境和檢查應用程式更新需要網路存取。如果您後來添加雲端模型、遠端 MCP 伺服器、網路工具或其他網路整合,這些功能也可能需要連線。離線隱私聲明適用於本地工作流程,而不適用於您隨後故意連接的服務。
LM Studio 在其 官方離線運作指南 中記錄了這些界限。
如果您希望另一個 Windows 應用程式、腳本、IDE 擴充功能或內部工具呼叫您的本地 DeepSeek 模型,LM Studio 可以運行本地伺服器。目前的開發者文件表示,您可以從 Developer 頁面啟動它,或使用:
lms server start預設情況下,伺服器可在 http://localhost:1234 取得。LM Studio 提供原生 REST 端點和 OpenAI 相容端點。只要模型和執行環境已經在本地,伺服器本身就可以離線運作。然而,如果您將伺服器暴露於 localhost 之外,請先審查驗證和網路存取設定。
請參閱 官方 LM Studio REST API 快速入門 以獲取當前的端點和驗證詳細資訊。
| 問題 | 可能原因 | 該怎麼辦 |
|---|---|---|
| 模型無法載入 | RAM/VRAM 不足、上下文過大或不支援的 CPU/執行環境 | 嘗試較小的 DeepSeek 模型、較小的量化或較低的上下文長度。在 x64 Windows 上,確認 AVX2 支援。 |
| LM Studio 線上運作正常,但斷線後不行 | 模型或必要的執行環境未完全下載 | 重新連線一次,完成所有模型/執行環境下載,成功載入模型,然後重複離線測試。 |
| 生成速度非常慢 | 模型對於可用的 GPU 加速來說太大,嚴重依賴 CPU/系統記憶體 | 選擇較小的模型或量化。如果延遲使工作流程不切實際,較大的模型沒有用處。 |
| 離線時找不到模型 | Discover 搜尋需要網路存取 | 在離線前下載模型,或透過其他受控流程取得模型檔案並側載(sideload)。 |
| 您預期 V4 Flash 能在普通筆記型電腦上運行 | 其本地記憶體需求屬於工作站級別 | 除非您的機器擁有約 156GB 或更多的系統記憶體,否則請改用 R1 蒸餾模型。 |
當您需要私密的本地推論、下載模型後可預測的成本、無需 API 金鑰的實驗,或用於開發的 localhost API 時,使用 LM Studio 離線運行 DeepSeek 是一個很好的選擇。當您的機器必須在沒有網路存取的情況下繼續工作時,這也很有用。
當您需要最強可用的 DeepSeek 模型但只有消費級硬體、需要極高吞吐量,或您的工作負載依賴即時網路資訊時,這是一個較弱的選擇。除非您故意連接外部工具或資料來源,否則本地模型只知道其權重和您提供的上下文中的內容。
在 Windows 11 上離線運行 DeepSeek 的最簡單方法是將 LM Studio 與真正適合您硬體的小型 GGUF DeepSeek 模型搭配使用。對於普通 PC,R1 蒸餾 8B 級別模型是比 DeepSeek V4 Flash 更現實的起點。在線上完成下載,載入模型,斷開網路,並驗證新的聊天仍然回應。一旦這運作正常,您就擁有了一個真正的本地 DeepSeek 設定,而不是雲端 API 的桌面包裝器。
透過修復任務所有權、依賴關係、委託、重試、流程觸發器、狀態持久性、快取和冪等性,防止 CrewAI 代理重複工作。
Compare HubSpot Free CRM and Zoho CRM Free for solo real estate agents, including contact limits, pipelines, email, automation, mobile tools, and upgrade tradeoffs.
在 Windows 11 上使用 LM Studio 本地執行 DeepSeek。了解適合一般 PC 的模型、如何下載與載入、驗證離線使用,以及解決常見問題。
透過四種實用的提示詞壓縮技術、緩存友好的佈局、結構化輸出以及保留品質的評估計畫,來降低 LLM API 成本。
使用自託管的 n8n 和 Claude 建立可免費託管的 AI 內容再利用流程,包含結構化輸出、審核閘門以及現實的 API 成本指南。
將 Ollama 連接至 Obsidian 以實現本地 AI 聊天與感知資料庫的 PKM。學習設定、品質檢查、本地嵌入、隱私限制,以及何時更換模型。
使用 AI 代理、網路搜尋、有證據支持的變更偵測、GitHub Actions 排程以及人工審核,建立每週競爭對手監控工作流程。
學習如何使用 Claude 系統提示詞,為一致的技術文件設定清晰的語氣、受眾、格式、不確定性及風格界線。
透過針對資料攝取、檢索、存取控制、提示邊界、工具權限、輸出驗證及紅隊測試的實用控制措施,保護本地 RAG 系統免受提示注入攻擊。
Outlook 能收信但無法寄信?按實用順序診斷寄件匣、離線模式、密碼、SMTP 設定、帳戶限制、設定檔及增益集。