如何阻止 CrewAI 代理執行冗餘任務:實用去重指南

透過修復任務所有權、依賴關係、委託、重試、流程觸發器、狀態持久性、快取和冪等性,防止 CrewAI 代理重複工作。
當 CrewAI 代理執行相同的任務兩次時,通常並非由單一的「重複任務」設定導致。重複執行可能源自於任務描述重疊、層級委派、重試行為、多個流程觸發器、重複的團隊啟動,或未受冪等性金鑰保護的副作用工具。
本實用參考資料已於 2026 年 9 月 13 日對照 CrewAI 官方文件進行核對。目前文件版本為 CrewAI v1.15.14。最重要的區別在於:防止單次運行中出現冗餘推理與防止相同業務操作在多次運行中重複發生是不同的。 CrewAI 提供任務上下文、條件任務、回調、流程狀態、持久化和工具緩存,但您仍然需要為只需執行一次的工作設計明確的跳過條件。
| 症狀 | 可能原因 | 首先嘗試的解決方法 |
|---|---|---|
| 兩位研究者研究同一課題 | 角色或任務描述重疊 | 給每個任務指定一個負責人,並將先前的輸出結果傳遞給該負責人。context |
| 一位經理要求完成另一位代理人已經完成的工作。 | 層級授權加上職責不明確 | 明確經理指示、代理人角色和工具所有權 |
| 驗證失敗後,同一任務會多次執行。 | 護欄重試 | guardrail_max_retries檢查並減少調試過程中出現的護欄錯誤 |
| 代理人反覆調用同一個工具 | 迭代預算過高、停止條件過弱或工具呼叫重試次數過多 | 降低max_iter預期輸出,收緊預期輸出,並檢查步驟日誌 |
| Flow 方法會多次觸發 | 多種@start()方法或多個上游事件 | 使用單一入口點、路由器、狀態標誌,或and_在適當情況下使用。 |
| 重新啟動後,電子郵件/付款/API 變更發生了兩次。 | 無交叉運行冪等性守衛 | 在持久化或外部事務儲存中使用確定性操作鍵 |
| 您已啟用內存,但任務仍然重新運行 | 記憶體提供的是上下文資訊;它不是調度器等級的重複資料刪除器。 | 明確記錄已完成的工作,而不是依賴回憶。 |
| 您啟用了緩存,但整個任務重新運行。 | CrewAI快取已記錄工具執行結果 | 新增任務級跳過邏輯或冪等性存儲 |
官方參考資料:CrewAI Tasks、CrewAI Agents和CrewAI Flows。
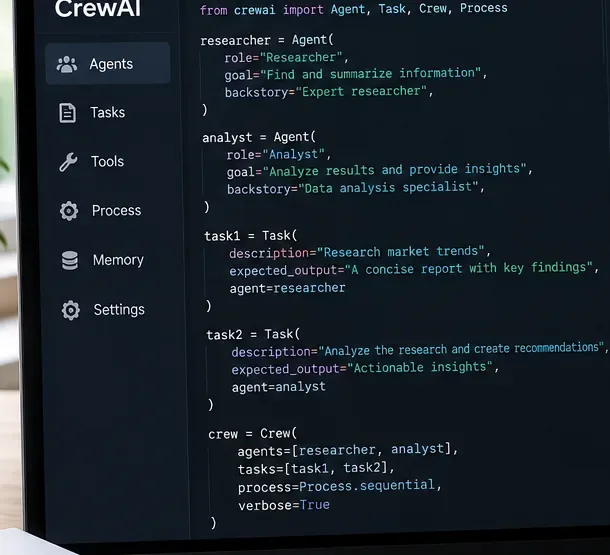
最簡單的防重複規則也是最有效的:每個有意義的工作單元都應該只有一個任務負責人。在 CrewAI 的順序流程中,任務會依照聲明順序運作。此context屬性允許後續任務使用先前任務的輸出,而無需獨立地重新獲取相同的資訊。
一種常見的反模式在概念上是這樣的:
research_task: "Research the customer and summarize findings"
analysis_task: "Research the customer, analyze findings, and recommend actions"
writer_task:   "Review the customer, research missing details, and write the report"
這三項任務都包含搜尋權限,因此重複搜尋是可以預見的。建議選擇更精簡的搜尋鏈:
from crewai import Agent, Crew, Process, Task

research_task = Task(
    description="Research the customer once and return verified facts and sources.",
    expected_output="Structured research notes with sources.",
    agent=researcher,
)

analysis_task = Task(
    description="Analyze only the research provided in context. Do not perform new research.",
    expected_output="Prioritized findings and recommendations.",
    agent=analyst,
    context=[research_task],
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
)
CrewAI 目前的任務文件明確支援任務依賴關係context,其順序流程會依照列出的順序執行任務。請參閱官方的任務依賴關係文件和流程文件。
context而不是告訴後來的代理人「如果需要的話進行調查」。如果某個任務只在先前的結果不完整時才需要,不要讓智能體隨意決定是否重複該工作。 CrewAI 提供了一個ConditionalTask方法,該方法的條件接收先前任務的輸出,並在條件為假時跳過執行。
官方範例使用了一個條件來檢查是否回傳了足夠的事件記錄;如果資料已足夠,則跳過額外獲取任務。請參閱CrewAI 條件任務。
from typing import List
from pydantic import BaseModel
from crewai import Agent, Crew, Task
from crewai.tasks.conditional_task import ConditionalTask
from crewai.tasks.task_output import TaskOutput

class ResearchOutput(BaseModel):
    sources: List[str]
    summary: str

def needs_more_sources(output: TaskOutput) -> bool:
    return len(output.pydantic.sources) < 5

research = Task(
    description="Find up to five authoritative sources about the topic.",
    expected_output="A structured research result.",
    agent=researcher,
    output_pydantic=ResearchOutput,
)

enrich = ConditionalTask(
    description="Find only the missing sources needed to reach five total.",
    expected_output="Additional authoritative sources only.",
    condition=needs_more_sources,
    agent=researcher,
)
這種模式比提示代理「避免重複工作」更有效,因為跳過決策是確定性的 Python 邏輯,而不是其他語言模型判斷。
CrewAI 同時支援順序式和層級式流程。在層級式團隊中,經理負責分配任務、委派工作、驗證成果並判斷任務完成情況是否令人滿意。這種彈性在需要動態分配工作時非常有用,但也意味著責任劃分不如順序式團隊那麼明確。
CrewAI 的代理文件目前指出,allow_delegation預設值為「否」False。除非代理確實需要將工作指派給其他代理,否則請對專家保持此預設值。在層級流程中,管理者本身負責任務委派。請參閱層級流程指南。
對於一個發出重複呼叫的呼叫群組來說,一個安全的起點是:
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once and return it in structured form.",
    backstory="You gather evidence; you do not write the final report.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
)

writer = Agent(
    role="Writer",
    goal="Write from supplied context without doing fresh research.",
    backstory="You synthesize existing evidence into a final answer.",
    allow_delegation=False,
    max_iter=6,
)然後,僅在能夠產生可衡量的收益時才重新啟用委託。如果不需要層級式編排,Process.sequential則更容易調試,因為任務順序和所有權都很明確。
某些重複性工作屬於預期的重試行為。 CrewAI 任務防護機制可以驗證輸出,並在驗證失敗時向代理程式發送回饋。目前任務文件指出,guardrail_max_retries預設值為 3,如果防護機制失敗,任務將重試最多 3 次。
代理也會暴露max_retry_limit執行錯誤以及max_iter在產生最佳答案之前代理的最大迭代次數。目前代理文件列出的預設值為max_iter20,預設錯誤重試次數限制為 2。
這些機制解決的是不同的問題:
| 環境 | 它的限制 | 為什麼它看起來會顯得多餘 |
|---|---|---|
guardrail_max_retries | 任務輸出驗證失敗後重試 | 故意重複執行相同任務,並設定安全回饋。 |
max_retry_limit | 執行錯誤後的重試 | 失敗的嘗試可能會重複工具呼叫。 |
max_iter | 智能體推理/工具迭代 | 不確定的代理在完成之前可能會進行多次類似的工具呼叫。 |
調試期間,暫時降低這些限制。如果重複操作消失,請檢查任務驗證失敗的原因,或代理為何認為需要再次迭代工具。不要在生產環境中簡單地將所有重試值都設為零;對於暫時性故障,重試可能是合適的。
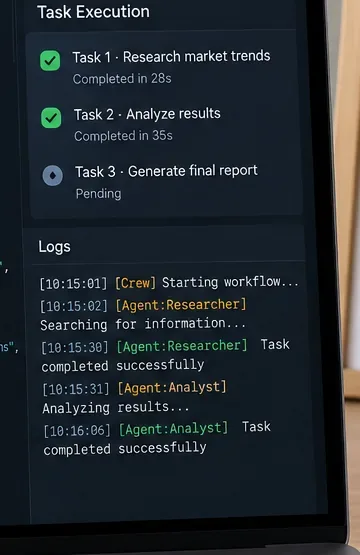
CrewAI 提供了多個可觀測性介面。在船員級別,目前的文件包括verbose` <conservability_hook>`、 step_callback`<conservability_hook> ` task_callback、`<conservability_hook> output_log_file`、`<conservability_hook>` 和追蹤控制。代理也支援 `<conservability_hook>` step_callback。這些介面有助於回答以下四個問題:
首次診斷執行時,請啟用詳細輸出和 JSON 日誌檔案:
crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
    verbose=True,
    output_log_file="logs/crew-run.json",
)如果您需要結構化計數器或自訂遙測數據,可以新增回調函數。請參閱CrewAI 的船員屬性文件。
流程引入了另一種重複。 CrewAI 目前的流程文件指出,所有已滿足的@start()方法都會在流程開始或復原時執行。如果您定義了多個無條件啟動,並且其中兩個最終啟動了同一個船員,那麼重複存在於您的流程圖中,而不是船員內部。
同樣,監聽器可以在任何or_上游方法發出輸出時運作。 CrewAI 的範例顯示,監聽器會在每次上游發出輸出時觸發一次。當下游操作需要等待多個先決條件全部完成後,或當只有一個分支需要執行時,可以使用監聽器。and_@router()
在新增第二個入口點之前@start(),請先確認它是否真的代表一個獨立的入口點。如果不是,請使用一個啟動方法和明確監聽器。
這是最重要的生產模式,當任務執行外部副作用時,例如發送電子郵件、對付款方式收費、建立 CRM 記錄、發布訊息或開始工作。
CrewAI Flows 支援結構化狀態和@persist裝飾器。持久化機制允許流程在重新啟動後恢復狀態。但是,僅靠持久化狀態本身並不能決定是否應該跳過某個業務操作。您需要儲存自己的確定性操作鍵,並在執行副作用之前檢查該鍵。
from hashlib import sha256
import json
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class JobState(BaseModel):
    completed_keys: list[str] = []
    report: str = ""

def operation_key(customer_id: str, period: str) -> str:
    payload = {"customer_id": customer_id, "period": period}
    raw = json.dumps(payload, sort_keys=True).encode()
    return sha256(raw).hexdigest()

@persist
class ReportFlow(Flow[JobState]):

    @start()
    def run_report(self):
        key = operation_key("customer-123", "2026-09")

        if key in self.state.completed_keys:
            return self.state.report

        result = reporting_crew.kickoff(
            inputs={"customer_id": "customer-123", "period": "2026-09"}
        )

        self.state.report = result.raw
        self.state.completed_keys.append(key)
        return self.state.report
CrewAI 文件@persist可以儲存跨重新啟動的 Flow 狀態,並在使用相同的狀態 ID 復原時重新載入最新快照。請參閱CrewAI Flow 持久化文件。
重要生產環境注意事項:上述範例適用於一般工作流程去重,但不足以應對涉及財務或法律的關鍵副作用。外部操作成功後,但在完成鍵持久化之前,進程可能會崩潰。為了實現類似「精確一次」的嚴格行為,請使用外部事務儲存或目標 API 本身的冪等鍵,並盡可能以原子方式記錄操作。
CrewAI 代理程式和船員會公開緩存cache,官方文件將其描述為快取工具執行結果。目前的代理文件顯示快取預設啟用,效能指南建議在重複使用工具時保持啟用狀態。
當代理程式多次執行相同的高成本搜尋或確定性工具呼叫時,這種方法很有幫助。但這並不意味著呼叫crew.kickoff()兩次會自動跳過團隊成員的任務。該任務仍屬於執行圖。
對於重複讀取操作,使用快取。對於重複寫入操作,使用冪等鍵。
| 手術 | 優先保護 |
|---|---|
| 搜尋同一文檔 | 工具快取 |
| 在不同任務中重複使用先前的知識 | 記憶或任務情境 |
| 如果資料已足夠,則可跳過可選任務。 | ConditionalTask |
| 防止流程分支錯誤觸發 | 路由器、狀態條件and_或圖表重新設計 |
| 防止重試/重啟後重複的外部寫入 | 持久冪等鍵或外部事務存儲 |
CrewAI 的統一記憶系統會在任務執行後儲存事實,並在任務執行前調用相關上下文。現有文件指出,啟用 CrewAI 記憶功能後,系統會從任務輸出中提取離散事實,並將相關記憶注入後續的任務提示中。
這可以減少不必要的重複發現,尤其是在撰稿人需要了解研究人員已發現的內容時。但記憶體是檢索上下文,而不是跳過標誌。除非您的團隊或流程邏輯另有決定,否則明確安排的任務仍會運作。
使用記憶體來表示「我們已經知道什麼?」 使用狀態或條件任務來表示「是否應該執行此操作?」 請參閱CrewAI 記憶體。
自然語言輸出難以用於確定性的工作流程控制。 CrewAI 任務可以透過 `get_pydantic_output` 和 `get_jsonoutput` 傳回 Pydantic 或 JSON 輸出output_pydantic。output_json結構化的結果使得判斷是否需要進行資訊增強、審核、升級或其他任務變得簡單明了。
例如,返回:
{
  "status": "complete",
  "sources_found": 7,
  "missing_fields": [],
  "needs_review": false
}
然後根據字段進行路由,而不是讓其他代理解讀一段文字。這通常可以減少重複工作和提示歧義。
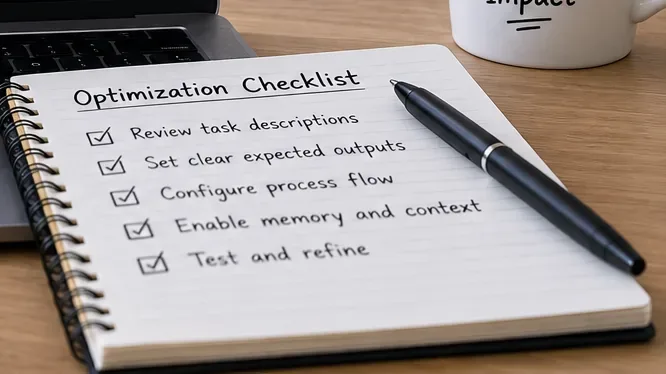
對於典型的研究報告流程,一開始要採取保守的做法:
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once.",
    backstory="Owns external research.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
    cache=True,
)

analyst = Agent(
    role="Analyst",
    goal="Analyze supplied evidence only.",
    backstory="Does not repeat research.",
    allow_delegation=False,
    max_iter=6,
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
    verbose=True,
    cache=True,
    output_log_file="logs/run.json",
)
只有當需求需要時才增加複雜性:
Task在船員任務清單中是否列出了兩次?context某種方式消耗掉較早的任務?ConditionalTask?”allow_delegation在不需要此功能的代理程式上啟用了此功能?max_iter足夠大,以至於一個任務可以執行許多類似的工具呼叫?@start()方法或or_監聽器是否正在向同一下游團隊發送訊息?kickoff()代表的是有意發起的新運行,還是意外的重複呼叫?停止冗餘的 CrewAI 工作主要是一個編排問題。明確任務所有權,使用鍊式調用context,有條件地跳過已完成的工作,保持委託範圍狹窄,了解何時有意重試,並在更改提示之前跟踪執行情況。對於流程和生產環境的副作用,可以更進一步:持久化一個確定性的完成鍵,或使用外部冪等機制。
有效的思考模型很簡單:上下文防止重複發現,條件防止不必要的任務,快取防止工具重複計算,冪等性防止重複產生副作用。它們解決的是相關問題,但不能互換。
透過修復任務所有權、依賴關係、委託、重試、流程觸發器、狀態持久性、快取和冪等性,防止 CrewAI 代理重複工作。
Compare HubSpot Free CRM and Zoho CRM Free for solo real estate agents, including contact limits, pipelines, email, automation, mobile tools, and upgrade tradeoffs.
在 Windows 11 上使用 LM Studio 本地執行 DeepSeek。了解適合一般 PC 的模型、如何下載與載入、驗證離線使用,以及解決常見問題。
透過四種實用的提示詞壓縮技術、緩存友好的佈局、結構化輸出以及保留品質的評估計畫,來降低 LLM API 成本。
使用自託管的 n8n 和 Claude 建立可免費託管的 AI 內容再利用流程,包含結構化輸出、審核閘門以及現實的 API 成本指南。
將 Ollama 連接至 Obsidian 以實現本地 AI 聊天與感知資料庫的 PKM。學習設定、品質檢查、本地嵌入、隱私限制,以及何時更換模型。
使用 AI 代理、網路搜尋、有證據支持的變更偵測、GitHub Actions 排程以及人工審核,建立每週競爭對手監控工作流程。
學習如何使用 Claude 系統提示詞,為一致的技術文件設定清晰的語氣、受眾、格式、不確定性及風格界線。
透過針對資料攝取、檢索、存取控制、提示邊界、工具權限、輸出驗證及紅隊測試的實用控制措施,保護本地 RAG 系統免受提示注入攻擊。
Outlook 能收信但無法寄信?按實用順序診斷寄件匣、離線模式、密碼、SMTP 設定、帳戶限制、設定檔及增益集。