Startseite
» Domänen
»
Optimale VRAM-Einstellungen für die lokale Ausführung von Llama 3 auf Mittelklasse-Laptops
Optimale VRAM-Einstellungen für die lokale Ausführung von Llama 3 auf Mittelklasse-Laptops
Beim Betrieb des ursprünglichen Meta Llama 3 8B-Modells auf einem Mittelklasse-Laptop geht es weniger darum, die optimale Einstellung zu finden, sondern vielmehr darum, genügend Speicherreserven zu schaffen, damit das Modell stabil läuft und gleichzeitig eine gute Ausgabequalität erhalten bleibt. Für die meisten Laptops mit 4 bis 8 GB dediziertem VRAM empfiehlt sich als Ausgangspunkt eine 4-Bit-GGUF-Quantisierung, ein Kontextfenster von 2K bis 4K, jeweils nur eine aktive Generation und so viel GPU-Auslastung, wie der Rechner ohne VRAM-Auslastung verkraften kann.
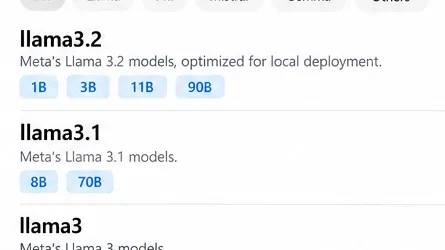
Dieser Artikel behandelt speziell das ursprüngliche Llama 3 8B, das im April 2024 veröffentlicht wurde. Metas aktueller Modellindex unterscheidet es weiterhin von Llama 3.1, 3.2 und späteren Versionen. Die ursprünglichen Llama 3 8B- und 70B-Modelle wurden mit einer Kontextlänge von 8K trainiert, während Llama 3.1 und spätere Mitglieder der Familie andere Grenzwerte verwenden. Metas ursprüngliches Llama 3 GitHub-Repository wurde im März 2026 archiviert und verweist Entwickler nun auf das konsolidierte Meta-Llama-Modell-Repository . Die ursprünglichen Spezifikationen sind auch in der offiziellen Meta Llama 3 8B Instruct-Modellkarte dokumentiert .
Das ursprüngliche Llama 3 ist eine eigenständige Modellfamilie, die sich von Llama 3.1 und Llama 3.2 unterscheidet. Die folgenden Einstellungen beziehen sich auf das ursprüngliche 8B-Modell mit seiner 8K-Kontextbegrenzung.
Die besten Basiseinstellungen für 4–8 GB VRAM
Für eine praxisnahe Ausgangsbasis vor der Feinabstimmung verwenden Sie am besten die Llama 3 8B-Anweisung in Q4_K_M GGUF . Setzen Sie den Kontext auf 4.096 Tokens, beschränken Sie die Anzahl paralleler Anfragen auf eins, aktivieren Sie Flash Attention oder lassen Sie es auf automatisch eingestellt. Überlassen Sie die Wahl der maximalen GPU-Auslastung der Laufzeitumgebung, solange noch VRAM-Spielraum vorhanden ist. Bei einer 4-GB-GPU reduzieren Sie den Kontext auf 2.048 Tokens und rechnen Sie mit einer teilweisen CPU-Auslastung.
Dedizierter VRAM
Empfohlene Quantisierung
Ausgangskontext
Chargen- / Mikro-Chargen-
GPU-Auslastung
So sehen gute Ergebnisse aus
4 GB
Q4_K_M mit teilweiser Entlastung; Q3_K_M nur falls erforderlich
2.048
128 / 64–128
Auto oder teilweise
Kein Speichermangel, Betriebssystem reagiert weiterhin, akzeptable Generierungsgeschwindigkeit
6 GB
Q4_K_M
4.096
256 / 128–256
Automatisch; vollständige Entlastung, falls es passt
Die meisten oder alle Ebenen auf der GPU ohne VRAM-Auslastung
8 GB
Q5_K_M für Qualität oder Q4_K_M für mehr Kontextspielraum
4.096; anschließend 8.192 Tests
512 / 256
Automatik oder Vollautomatik
Zunächst ein stabiler 4K-Kontext; 8K nur, wenn der Speicherplatz ausreichend bleibt.
Dies sind Ausgangspunkte, keine Garantien. Laptop-GPUs reservieren oft einen Teil des VRAM für das Display, und Kühlung, Treiber-Backend, Arbeitsspeicher und die genaue GGUF-Konfiguration beeinflussen, wie viel Speicher tatsächlich verfügbar ist. Eine Konfiguration, die auf einer 8-GB-GPU funktioniert, kann auf einem anderen Laptop mit 8 GB VRAM dennoch fehlschlagen, wenn die Grafikprozessoren oder die Desktop-Auslastung mehr Speicher benötigen.
Warum Q4_K_M in der Regel der beste Ausgangspunkt für niedrigen VRAM ist
Quantisierung bedeutet, Modellgewichte mit geringerer Genauigkeit zu speichern, sodass das Modell weniger Speicherplatz benötigt. Dadurch wird der Speicherbedarf reduziert, jedoch kann eine aggressive Quantisierung die Ergebnisqualität beeinträchtigen. Die aktuellen Referenzdaten des Quantisierers in llama.cpp für Llama-3-8B ermöglichen einen hilfreichen Vergleich: Q3_K_M liegt bei etwa 3,74 G mit einem größeren Anstieg der Perplexität, Q4_K_M bei etwa 4,58 G mit einem geringeren Anstieg und Q5_K_M bei etwa 5,33 G mit einem weiteren, geringeren Anstieg. Sie können diese Werte direkt im Quellcode des Quantisierers in llama.cpp einsehen .
Quant
llama.cpp Referenzgröße für Llama-3-8B
Referenz-Δ-Perplexität
Optimale Nutzung
Q3_K_M
Ungefähr 3,74 G
+0,6569
Sehr beengter Speicher, sodass Q4_K_M nicht problemlos ausgeführt werden kann.
Q4_K_M
Ungefähr 4,58 G
+0,1754
Optimale allgemeine Balance für Laptops mit 4–6 GB VRAM
Q5_K_M
Ungefähr 5,33 G
+0,0569
Die beste Wahl für Qualität bei 8 GB VRAM, wenn noch genügend Spielraum vorhanden ist.
Perplexität ist nicht dasselbe wie die vom Benutzer wahrgenommene Qualität. Daher sollten diese Werte nicht als universelle Rangfolge für jede Aufgabe verwendet werden. Sie eignen sich am besten zur Auswahl einer sinnvollen Reihenfolge für Experimente. Wenn Q4_K_M Ihre Anforderungen gut erfüllt, ist es möglicherweise nicht sinnvoll, auf Q3 zurückzugreifen, nur um das Modell vollständig in den VRAM zu integrieren. Durch teilweises Auslagern der GPU können die Gewichtungen des Q4-Modells erhalten bleiben, während gleichzeitig ein Teil der Arbeit in den Arbeitsspeicher verlagert wird.
Die aktuelle Dokumentation von LM Studio erklärt ebenfalls, dass 4-Bit-Varianten ein sinnvoller Standard sind, sofern das System diese unterstützt. Siehe die offizielle LM Studio-Modell-Downloadanleitung . Die offizielle Llama-3-Bibliothek von Ollama gibt derzeit für das ursprüngliche 8B-Paket eine Größe von ca. 4,7 GB mit einem 8K-Kontextfenster an, was erneut verdeutlicht, dass allein die Modelldatei bereits mehr als 4 GB VRAM benötigt. Siehe die offizielle Ollama-Llama-3-Bibliotheksseite .
Kontextlänge: Verringern Sie sie, bevor Sie die Modellqualität beeinträchtigen.
Die Kontextlänge gibt an, wie viele Tokens das Modell in seiner aktiven Eingabeaufforderung und im Gesprächsverlauf berücksichtigen kann. Ein größerer Kontext benötigt mehr KV-Cache-Speicher. Bei Laptops mit wenig VRAM ist die Reduzierung des Kontexts eine der sichersten Einstellungen, da sie die gespeicherten Modellgewichte nicht verändert.
Beginnen Sie mit 2.048 Token bei 4 GB VRAM und 4.096 Token bei 6–8 GB VRAM. Erhöhen Sie die Anzahl erst auf 8.192, nachdem Sie die Stabilität der 4K-Konfiguration bestätigt haben. Die ursprüngliche Llama-3-Grafikkarte begrenzt ihren trainierten Kontext auf 8.000 Token. Daher wird die ursprüngliche Llama 3 durch die Verwendung einer deutlich höheren Anzahl nicht zu einem Modell für lange Kontexte. Benötigen Sie Zehntausende von Token, verwenden Sie ein Modell, das speziell für diesen Kontext trainiert wurde, beispielsweise eine spätere Version der Llama-Familie.
Die aktuelle Kontextdokumentation von Ollama weist ausdrücklich darauf hin, dass eine Erhöhung der Kontextgröße den Speicherbedarf steigert. Ab 2026 verwendet Ollama standardmäßig für Systeme mit weniger als 24 GiB VRAM eine 4K-Kontextgröße. Daher ist 4K ein sinnvoller Maximalwert für allgemeine Anwendungen, der zunächst auf einem Laptop getestet werden sollte, bevor höhere Werte angestrebt werden. Weitere Informationen finden Sie in der offiziellen Dokumentation zur Kontextgröße von Ollama .
GPU-Entlastung: Maximieren Sie sie, aber lassen Sie Spielraum.
Die GPU-Auslagerung steuert, wie viele Modellebenen auf der GPU anstatt auf der CPU gespeichert und berechnet werden. Mehr GPU-basierte Ebenen verbessern in der Regel die Generierungsgeschwindigkeit, jedoch ist die Auslastung des VRAM bis auf die letzten Megabytes problematisch, da die Laufzeitumgebung zusätzlich KV-Cache, Rechenpuffer und Backend-Speicherzuweisungen benötigt.
In der aktuellen Version von llama.cpp akzeptiert die Kommandozeile die --n-gpu-layers autoOption `--selection`, daher ist die automatische Auswahl ein guter erster Versuch. Falls das Laden fehlschlägt, reduzieren Sie zunächst den Kontext. Sollte das Problem weiterhin bestehen, reduzieren Sie die Anzahl der Ebenen auf der GPU, anstatt sofort auf eine deutlich niedrigere Quantisierung umzuschalten. Die aktuellen Kommandozeilenoptionen sind in der offiziellen llama.cpp-CLI-Referenz dokumentiert .
Ein konservativer Marktstart des Llama 3 8B im vierten Quartal (Q4_K_M) sieht folgendermaßen aus:
llama-cli -m Meta-Llama-3-8B-Instruct-Q4_K_M.gguf -c 4096 -b 256 -ub 128 -ngl auto -fa auto
Der genaue GGUF-Dateiname kann variieren. Testen Sie es -c 2048 -b 128 -ub 64zunächst auf einer 4-GB-GPU. Ziel ist es nicht, jeden Wert zu maximieren, sondern eine stabile Basislinie zu etablieren und dann schrittweise Kontext hinzuzufügen oder Ressourcen auszulagern.
Batchgröße: Reduzieren Sie diese, wenn das sofortige Laden Spitzenwerte verursacht.
Die logische Batchgröße steuert, wie viele Eingabeaufforderungs-Tokens gleichzeitig verarbeitet werden können. Ein größerer Batch kann die Eingabeaufforderung beschleunigen, aber auch den temporären Speicherbedarf erhöhen. Der Mikro-Batch--batch-size ist der physische Datenblock, der für die Ausführung verwendet wird. Aktuell stellt llama.cpp diese als `<Prompt> ` und `<Mikro-Batch> ` bereit --ubatch-size.
Lädt das Modell zwar erfolgreich, stürzt aber beim Einfügen einer längeren Eingabeaufforderung ab, verringern Sie die Batchgröße, bevor Sie die Quantisierung ändern. Ein logischer Batch von 256 mit einem Mikro-Batch von 128 ist ein sinnvoller Mittelweg für 6 GB VRAM. Bei 4 GB ist 128/64 konservativer. Bei 8 GB lohnt es sich, 512/256 zu testen. Kleinere Batches können die Eingabeaufforderungsverarbeitung verlangsamen, haben aber in der Regel weniger Auswirkungen auf die kontinuierliche Token-für-Token-Generierung.
Flash Attention und KV-Cache: nützlich, aber testen Sie Ihr Backend.
Flash Attention ist ein optimierter Aufmerksamkeitspfad, der den Speicherverbrauch reduzieren und die Geschwindigkeit auf unterstützten Backends verbessern kann. Die aktuelle llama.cpp-Datei bietet einen automatischen Modus, und die aktuelle Lade-API von LM Studio dokumentiert Flash Attention als Option, die den Speicherverbrauch senken und die Generierungsgeschwindigkeit der auf llama.cpp basierenden Engine verbessern kann. Siehe die Dokumentation der LM Studio-Modelllade-API .
Bei einem Laptop der Mittelklasse empfiehlt es sich, Flash Attention zunächst auf „Automatisch“ zu belassen. Sollte es zu einem Absturz im Backend oder zu Instabilitäten des Grafiktreibers kommen, testen Sie die gleiche Eingabeaufforderung zunächst mit deaktiviertem Flash Attention, bevor Sie mehrere andere Einstellungen gleichzeitig ändern. Dadurch lässt sich die eigentliche Ursache leichter ermitteln.
llama.cpp unterstützt auch quantisierte KV-Cache-Typen wie Q8_0. Die Quantisierung des KV-Caches kann den Speicherverbrauch reduzieren, ist aber ein fortgeschrittener Optimierungsschritt. Ändern Sie zunächst die Kontextlänge und die Batchgröße, da diese Anpassungen leichter nachzuvollziehen sind und die KV-Präzision nicht verändern. Falls Sie später den zusätzlichen Speicherplatz für 8K-Kontext benötigen, testen Sie einen Q8-KV-Cache mit Ihrem eigenen Prompt-Set, bevor Sie ihn dauerhaft einsetzen.
Verwenden Sie eine parallele Anfrage auf einem Laptop
Parallelverarbeitung wird leicht übersehen. Mehrere parallele Generationen benötigen separate aktive Kontextkapazitäten und können eine ansonsten stabile Konfiguration an die Speichergrenze bringen. Bei einem Einzelbenutzer-Laptop sollte die Parallelität während der Optimierung auf eins beschränkt bleiben. In den offiziellen FAQ von Ollama wird darauf hingewiesen, dass der benötigte Speicher mit der Anzahl paralleler Anfragen und der Kontextgröße skaliert. Außerdem ollama pswird angezeigt, ob ein Modell auf der GPU, der CPU oder auf beiden verteilt ist. Siehe die offiziellen FAQ von Ollama .
Wie man beurteilt, ob die Einstellungen tatsächlich gut sind
Eine Konfiguration ist nur dann sinnvoll, wenn sie konsistent akzeptable Ergebnisse liefert, nicht nur, wenn das Modell geladen wird. Verwenden Sie bei jeder Einstellungsänderung denselben kleinen Evaluierungsdatensatz. Fünf bis zehn Aufgaben genügen für einen praktischen Laptop-Test: eine sachliche Erklärung, eine Zusammenfassungsaufgabe, eine strukturierte Extraktionsaufgabe, eine Kodierungsaufgabe und ein mehrstufiges Gespräch, dessen Länge Ihrer üblichen Kontextdauer entspricht.
Speicherstabilität: Das Modell sollte wiederholt ohne Speichermangel geladen werden können, und der Desktop sollte auch bei längeren Eingabeaufforderungen reaktionsfähig bleiben.
Generierungsgeschwindigkeit: Messen Sie die Token pro Sekunde nach der Verarbeitung der Eingabeaufforderung. Vergleichen Sie dieselbe Eingabeaufforderung, nicht unterschiedliche Konversationen.
Prompt-Verarbeitungsgeschwindigkeit: Wenn die Verarbeitung langer Eingaben zu lange dauert, versuchen Sie, die Batchgröße nur dann zu erhöhen, wenn noch VRAM-Spielraum vorhanden ist.
Im Anschluss daran ist zu prüfen, ob das Modell nach der Änderung der Quantisierung weiterhin die angeforderten Formate, Einschränkungen und mehrstufigen Anweisungen einhält.
Verhalten bei längeren Kontextphasen: Platzieren Sie eine Information am Anfang einer längeren Eingabeaufforderung und fragen Sie am Ende danach. Falls das Modell trotz verfügbarem Kontext versagt, liegt das Problem möglicherweise eher an der Modellqualität oder der Eingabeaufforderung als am Gedächtnis.
Für reproduzierbare Vergleiche sollten Temperatur und Abtasteinstellungen konstant gehalten werden. Die Temperatur hat nur geringen Einfluss auf die VRAM-Optimierung, aber eine gleichzeitige Änderung kann die Ergebnisse aus Gründen, die nicht mit den Speichereinstellungen zusammenhängen, verbessern oder verschlechtern.
Wann sollte man den Ansatz ändern?
Wenn das Modell nicht geladen wird
Reduzieren Sie den Kontext auf 2K, schließen Sie grafikintensive Anwendungen, verwenden Sie Q4_K_M und aktivieren Sie die teilweise GPU-Auslagerung. Falls Q4_K_M weiterhin zu starkem Swapping führt, kann Q3_K_M sinnvoll sein. Gehen Sie nicht davon aus, dass ein 3,7-GB-Modell problemlos in 4 GB VRAM passt; die Laufzeitumgebung benötigt mehr Speicher als die Gewichtsdatei.
Wenn es lädt, aber lange Eingabeaufforderungen abstürzen
Reduzieren Sie Kontext und Batchgröße, bevor Sie die Modellquantisierung ändern. Lange Eingabeaufforderungen erhöhen die KV-Cache-Nutzung, während große Batches kurzzeitige Allokationsspitzen verursachen können.
Wenn es stabil, aber zu langsam ist
Erhöhen Sie die GPU-Auslastung, bis Sie sich dem verfügbaren VRAM annähern, ihn aber nicht vollständig ausschöpfen. Wenn das System bereits stark CPU-lastig ist, weil das Modell nicht passt, kann eine niedrigere Quantisierung die Geschwindigkeit erhöhen, selbst wenn dadurch die Qualität etwas leidet. Testen Sie, bevor Sie sich entscheiden.
Wenn die Antworten merklich schlechter sind
Wechseln Sie von Q3_K_M zurück zu Q4_K_M oder, falls Ihre 8-GB-GPU genügend Speicherkapazität bietet, von Q4_K_M zu Q5_K_M. Stellen Sie außerdem sicher, dass Sie die Variante „Anweisung“ und die korrekte Chatvorlage verwenden. Das Reduzieren des Kontextes beeinträchtigt die Qualität der Argumentation nicht zwangsläufig, es sei denn, die Abfrage benötigt die entfernten Informationen tatsächlich.
LM Studio und die entsprechenden Ollama-Produkte
Wenn Sie eine grafische Benutzeroberfläche bevorzugen, stellt LM Studio die Kontextlänge und die GPU-Auslastung direkt dar und kann den Speicherbedarf vor dem Laden abschätzen. Die aktuelle Befehlszeilenschnittstelle unterstützt auch einen Testlauf.
lms load --estimate-only <model-key> --context-length 4096 --gpu auto
Der Schätzer berücksichtigt die Kontextlänge und die GPU-Auslastung und eignet sich daher gut, um 2K mit 4K vor dem Commit zu vergleichen. Siehe die offizielle Dokumentation zum Laden von lms .
Für Ollama bleibt der offizielle ursprüngliche Befehl für Llama 3 bestehen:
ollama run llama3
Verwenden Sie diese ollama psFunktion, um zu prüfen, ob das Modell vollständig auf der GPU oder im CPU-Speicher ausgeführt wird. Falls ein 4K-Kontext eine 4-GB-GPU zu stark belastet, reduzieren Sie die Anzahl num_ctxfür diese Sitzung auf 2048. Die offizielle Dokumentation von Ollama beschreibt sowohl die Kontextkonfiguration als auch die Meldung der Prozessoraufteilung.
Empfohlene Endprofile
Bei 4 GB VRAM: Verwenden Sie Llama 3 8B Instruct Q4_K_M, 2K Kontext, eine Anfrage, 128/64 Batch und Mikro-Batch, Flash Attention auf automatisch und partielle GPU-Auslagerung. Wählen Sie Q3_K_M erst, nachdem Sie bestätigt haben, dass Q4_K_M mit Ihrem verfügbaren RAM zu langsam oder instabil ist.
Bei 6 GB VRAM: Verwenden Sie Q4_K_M, 4K-Kontext, eine Anfrage, Batch-Einstellungen 256/128 oder 256/256 und automatische GPU-Auslagerung. Dieses Profil bietet in der Regel mehr Spielraum als der Versuch, Q5_K_M auf einer nahezu voll ausgelasteten Grafikkarte zu erzwingen.
Bei 8 GB VRAM: Beginnen Sie mit Q5_K_M im 4K-Kontext, wenn höchste Antwortgenauigkeit entscheidend ist. Benötigen Sie den vollen 8K-Kontext, bietet Q4_K_M möglicherweise den besseren Kompromiss, da es mehr Platz für den KV-Cache und die Laufzeitpuffer lässt. Bestätigen Sie dies mit demselben Eingabeaufforderungssatz, bevor Sie sich entscheiden.
Grenzen dieses Ratschlags
Diese Empfehlungen setzen einen Laptop mit 4–8 GB dediziertem Grafikspeicher und ausreichend Arbeitsspeicher voraus, um eine teilweise Auslagerung zu ermöglichen. Integrierte GPUs und Apple Silicon verwenden gemeinsam genutzten oder einheitlichen Speicher, weshalb eine dedizierte VRAM-Tabelle hier nicht ohne Weiteres anwendbar ist. Treiberversionen, CUDA/Vulkan/ROCm-Backends, Leistungsaufnahme des Laptops und Kühlung können die Leistung ebenfalls erheblich beeinflussen.
Das ursprüngliche Llama 3-Modell mit 70 GB VRAM ist für diese Laptop-Klasse kein realistisches Ziel mit geringem VRAM, wenn es auf hohe Interaktionsgeschwindigkeit ankommt; die aktuelle Llama-Variante bietet rund 40 GB VRAM vor Abzug des Laufzeit-Overheads. Für Systeme der Mittelklasse ist das Modell mit 8 GB VRAM der geeignete Ausgangspunkt.
Die zuverlässigste Optimierungsstrategie ist daher einfach: Verwenden Sie nach Möglichkeit ein Q4_K_M- oder besseres Modell, reduzieren Sie den Kontext, bevor Sie die Gewichtungsqualität verringern, halten Sie die Parallelität bei eins und erhöhen Sie die GPU-Auslastung nur, solange der Speicherverbrauch stabil bleibt. Eine Einstellung ist dann optimal, wenn sie auch bei der längsten realen Abfrage noch Ergebnisse liefert, die Sie tatsächlich verwenden würden.