Startseite
» Domänen
»
Wie man die Renderzeit in ComfyUI für einen SDXL-Workflow reduziert
Wie man die Renderzeit in ComfyUI für einen SDXL-Workflow reduziert
Die schnellste Methode zur Reduzierung der Renderzeit in einem ComfyUI SDXL-Workflow besteht in der Regel darin, den Umfang der Diffusionsberechnungen zu verringern, bevor die Low-Level-Startflags geändert werden: Testen Sie mit einer sinnvollen SDXL-Auflösung, halten Sie die Batchgröße während der Optimierung bei 1, verwenden Sie weniger Sampling-Schritte, solange die Qualität noch ausreicht, und umgehen Sie vorübergehend ressourcenintensive Zusatzfunktionen wie Refiner, ControlNet-Verzweigungen, Upscaling-Passes oder Präprozessoren. Erst danach sollten Sie VRAM, Aufmerksamkeit, Vorschau und Cache-Verhalten optimieren.
Diese Reihenfolge ist wichtig, da Startflags einen Workflow nicht kompensieren können, der die GPU unnötig überlastet. Die aktuelle ComfyUI-Dokumentation empfiehlt außerdem, bei langsamer Generierung zunächst die Auflösung oder Batchgröße zu reduzieren und anschließend Speicher- und Aufmerksamkeitsoptimierungen nach Bedarf anzuwenden. Die folgenden Hinweise wurden am 13. September 2026 anhand der aktuellen ComfyUI- und PyTorch-Dokumentation überprüft.
Warum SDXL-Workflows in ComfyUI langsam werden
Ein SDXL-Rendering kann an verschiedenen Stellen Zeit in Anspruch nehmen: Laden oder Verschieben von Modellgewichten, CLIP-Textkodierung, wiederholtes Entrauschen innerhalb von KSampler, ControlNet oder andere Konditionierungsschritte, VAE-Dekodierung, Upscaling und jegliche zweite Durchlauf- oder Verfeinerungsstufe. Bei knappem VRAM können zusätzliche CPU-zu-GPU-Übertragungen die Latenz weiter erhöhen.
Das bedeutet, dass zwei Nutzer mit derselben GPU sehr unterschiedliche Renderzeiten haben können. Ein einfacher Text-zu-Bild-Graph mit 1024 Klassen ist nicht vergleichbar mit einem Workflow, der einen Refiner, zwei ControlNets, einen hochauflösenden zweiten Durchgang und einen großen Batch hinzufügt. Ziel ist es, den rechenintensiven Teil des Graphen zu identifizieren und diesen anschließend zu entfernen oder zu optimieren, ohne die gewünschte Ausgabequalität zu beeinträchtigen.
1. Messen Sie einen sauberen Ausgangswert, bevor Sie irgendetwas ändern.
Verwenden Sie eine feste Eingabeaufforderung, einen festen Startwert, eine Batchgröße von 1 und dieselbe Ausgabeauflösung. Führen Sie den Workflow mindestens zweimal aus. Der erste Durchlauf kann das Laden von Prüfpunkten, die Kompilierung, Festplattenzugriffe oder Modellübertragungen umfassen; ein späterer Durchlauf liefert ein besseres Maß für die Generierungsgeschwindigkeit im stationären Zustand.
Prüfen Sie außerdem, ob die GPU tatsächlich ausgelastet ist. Bei NVIDIA-Systemen nvidia-smikönnen Sie die VRAM-Nutzung und die GPU-Auslastung anzeigen lassen. Bleibt die GPU-Auslastung niedrig, obwohl das System ständig Daten verschiebt oder Modelle lädt, liegt der Flaschenhals möglicherweise eher im Speicher oder in der E/A als im Sampler selbst.
Überprüfen Sie das Verhalten von GPU und VRAM, bevor Sie ComfyUI optimieren. Die hier angezeigten Werte dienen lediglich als Beispiellayout und sind kein Benchmark-Ziel.
2. Beginnen Sie mit dem kleinsten SDXL-Diagramm, das das gewünschte Ergebnis liefert.
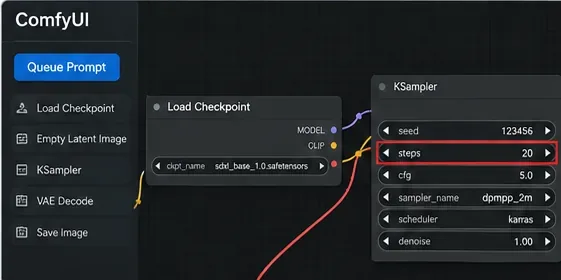
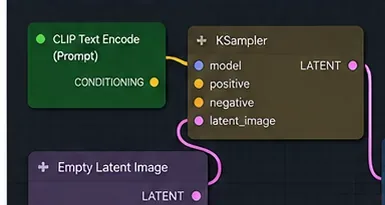
Bevor Sie einen komplexen Workflow optimieren, vergleichen Sie ihn mit einem minimalen Pfad: Checkpoint-Laden, Eingabeaufforderungs-Konditionierung, ein leeres latentes Bild, KSampler, VAE-Dekodierung und Speichern des Bildes. Die offiziellen Beispiele von ComfyUI zeigen, dass der SDXL-Basis-Checkpoint wie ein regulärer Checkpoint verwendet werden kann. Wenn dieser einfache Ablauf schnell ist, Ihr Produktionsablauf aber langsam, sind die zusätzlichen Verzweigungen die Ursache.
Deaktivieren Sie beim Erstellen des Entwurfs vorübergehend Komponenten, die für die aktuelle Entscheidung nicht unbedingt erforderlich sind. Beispiele hierfür sind ein Refiner, ein zweiter Upscaling-Durchlauf, Bildvorprozessoren, mehrere ControlNets oder optionale Stilzweige. Aktivieren Sie diese Komponenten einzeln wieder, sobald das Basisbild akzeptabel ist.
Ein kleines SDXL-Diagramm eignet sich am besten als Ausgangsbasis. Fügen Sie rechenintensive Zweige erst dann hinzu, wenn Sie wissen, wie viel Zeit jeder einzelne benötigt.
3. Reduzieren Sie die Anzahl der KSampler-Schritte, bevor Sie exotische Geschwindigkeitseinstellungen ausprobieren.
Die Anzahl der Sampling-Schritte ist einer der wichtigsten Stellschrauben, da jeder zusätzliche Entrauschungsschritt zusätzlichen Aufwand bedeutet. Reduziert man die Anzahl der Schritte von einem höheren Wert auf einen niedrigeren, verkürzt sich die Sampling-Phase des Renderings. Die Gesamtzeit sinkt jedoch nicht im gleichen Maße, da das Laden des Modells, die Prompt-Codierung, die VAE-Decodierung und andere Knoten weiterhin Zeit benötigen.
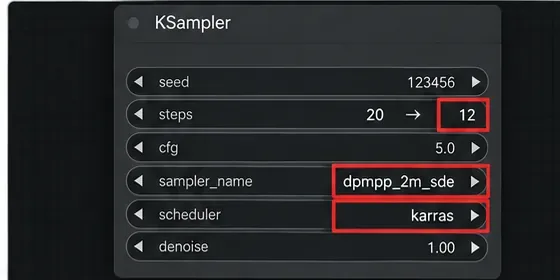
Übernehmen Sie keine allgemein gültige „optimale“ Schrittzahl von jemand anderem. Die richtige Anzahl hängt vom Checkpoint, Sampler, Scheduler, Prompt, CFG und dem Qualitätsziel ab. Eine praktische Methode ist, den Startwert beizubehalten und schrittweise zu testen – beispielsweise mit Ihrer aktuellen Einstellung, dann mit einer moderaten Reduzierung und anschließend mit einer weiteren Reduzierung. Brechen Sie ab, sobald Texturen, Anatomie, Typografie oder die Genauigkeit des Prompts sich so stark verschlechtern, dass Sie dies akzeptieren.
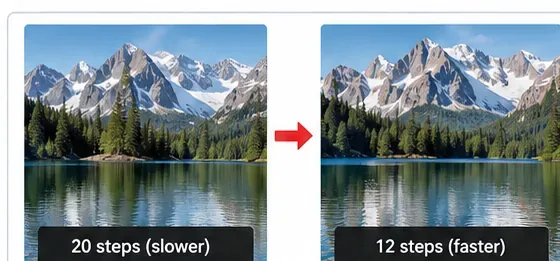
Durch die Reduzierung der KSampler-Schritte kann die Entrauschungszeit verkürzt werden. Die angegebenen Werte dienen nur zur Veranschaulichung; überprüfen Sie die Qualität mit Ihrem eigenen Prüfpunkt und einem festgelegten Startwert.
4. Testauflösung und Chargengröße unter Kontrolle halten
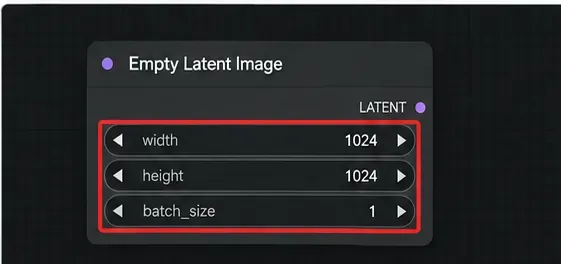
Für SDXL empfehlen die offiziellen SDXL-Beispiele von ComfyUI eine Auflösung von 1024×1024 oder andere Seitenverhältnisse mit annähernd gleicher Pixelanzahl, wie beispielsweise 896×1152 oder 1536×640, um ein optimales Verhalten des Basismodells zu gewährleisten. Eine deutlich höhere Pixelanzahl erhöht die Größe des latenten Speichers und damit den Rechen- und Speicherbedarf.
Bei der Optimierung von Eingabeaufforderungen und Arbeitsabläufen sollte der Wert batch_sizeauf 1 belassen werden, es sei denn, Durchsatztests sind explizit erforderlich. Ein Batch von vier Bildern fordert die Pipeline auf, vier Bilder in einem Durchlauf zu erzeugen. Dies kann den Durchsatz in manchen Konfigurationen verbessern, ist aber nicht der richtige Weg, um die Zeit bis zum ersten Bild zu minimieren, und erhöht den Speicherbedarf.
Falls Ihr Endergebnis eine höhere Auflösung als die normale Basisauflösung von SDXL haben muss, sollten Sie die Kompositionstests vom finalen hochauflösenden Durchgang trennen. Optimieren Sie zunächst Prompt, Seed, Konditionierung und Komposition und investieren Sie anschließend in die aufwendige Hochskalierung oder den zweiten Durchgang nur bei ausgewählten Kandidaten.
Eine latente Sequenz mit 1024 Klassen und einer Batchgröße von 1 ist eine sinnvolle SDXL-Tuning-Baseline vor Läufen mit höherer Auflösung oder mehreren Bildern.
5. Vergleichen Sie Sampler und Scheduler, anstatt anzunehmen, dass einer immer der schnellste ist.
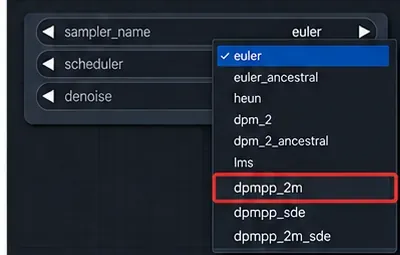
ComfyUI bietet in KSampler verschiedene Sampler- und Scheduler-Optionen. Unterschiedliche Kombinationen können in unterschiedlicher Schrittanzahl eine akzeptable Qualität erreichen. Daher sollte „am schnellsten“ bedeuten, die gewünschte Qualität am schnellsten zu erreichen , und nicht nur den kürzesten Einzeldurchlauf.
Verwenden Sie beim Vergleich denselben Checkpoint, dieselbe Eingabeaufforderung, denselben Seed, dieselbe Auflösung und dieselbe CFG. Ändern Sie lediglich den Sampler oder Scheduler und vergleichen Sie anschließend Renderzeit und sichtbare Qualität. Benötigt eine Kombination deutlich weniger Schritte für Ihren Checkpoint und erhält dabei das gewünschte Ergebnis, ist dies ein echter Geschwindigkeitsvorteil. Sind jedoch zusätzliche Schritte zur Detailwiederherstellung erforderlich, kann der scheinbare Vorteil verschwinden.
Ändern Sie jeweils eine Sampler-Variable und vergleichen Sie die Ergebnisse bei einem festen Startwert. Gehen Sie nicht davon aus, dass ein Sampler für jeden SDXL-Prüfpunkt oder jedes Qualitätsziel schneller ist.
6. Entfernen Sie redundante Graphoperationen und nutzen Sie das Ausführungsmodell von ComfyUI zu Ihrem Vorteil.
ComfyUI ist so konzipiert, dass nur die benötigten Teile des Ablaufdiagramms ausgeführt werden. Laut Projektdokumentation können unveränderte Abschnitte zwischen den Ausführungen wiederverwendet werden, und das aktuelle Backend bietet konfigurierbares Zwischenspeichern von Knotenergebnissen. Dies ist hilfreich, wenn Sie lediglich einen nachgelagerten Wert ändern, anstatt den gesamten Workflow neu zu erstellen.
Halten Sie Ladeknoten und rechenintensive Upstream-Prozesse nach Möglichkeit stabil. Wenn Sie ständig Checkpoints wechseln, große Images wiederholt skalieren oder Upstream-Knoten invalidieren, geht der Vorteil zwischengespeicherter Daten verloren.
ComfyUI bietet außerdem eine dokumentierte Funktion zur partiellen Ausführung , mit der nur der für einen ausgewählten Ausgabeknoten benötigte Teil eines Workflows ausgeführt werden kann. Verwenden Sie diese Funktion, wenn Sie einen nachgelagerten Zweig testen und nicht alle Ausgaben in einem großen Graphen neu generieren müssen.
Ein übersichtliches Diagramm macht Engpässe leichter erkennbar. Nutzen Sie Caching und partielle Ausführung, damit unveränderte vorgelagerte Arbeit nicht unnötig wiederholt wird.
7. Vorschau, Caching, VRAM-Modus und Aufmerksamkeit erst dann optimieren, wenn die Grafik effizient ist.
Die aktuellen ComfyUI-Befehlszeilenoptionen bieten verschiedene Leistungssteuerungsmöglichkeiten. Ihre Auswirkungen hängen von der Hardware und dem verfügbaren Speicher ab; daher sollten sie eher als Benchmark-Kandidaten denn als obligatorische Einstellungen betrachtet werden.
Einstellung
Wenn es helfen kann
Hauptkompromisse
--preview-method none
Wenn die Sampler-Vorschau aktiviert ist und Sie sich nur für das Endergebnis interessieren
Sie verlieren die Live-Vorschau. Die aktuelle CLI verwendet standardmäßig keine Vorschau.
--highvram
Wenn Sie über genügend VRAM verfügen und das wiederholte Entladen/Laden von Modellen Zeit kostet.
Speichert Modelle im GPU-Speicher und kann bei kleineren Grafikkarten zu Speichermangel führen.
--lowvram
Wenn der Workflow ansonsten nicht in den VRAM passt
Dies ist in erster Linie ein Speichersparmodus, kein Geschwindigkeitsmodus; CPU-Auslastung oder Datenübertragungen können die Latenz erhöhen.
--use-pytorch-cross-attention
Es lohnt sich, Benchmarks auf modernen PyTorch/GPU-Kombinationen durchzuführen.
Kombinieren Sie sich gegenseitig ausschließende Aufmerksamkeitsmodus-Flags nicht unbedacht.
--use-flash-attention
Es lohnt sich, dies zu testen, wenn Ihre Hardware-/Softwarekonfiguration den optimierten Pfad unterstützt.
Verfügbarkeit und Nutzen hängen von den unterstützten Eingaben und Kernels ab.
--cache-classicoder--cache-lru N
Wiederholte Arbeitsabläufe, bei denen zusätzlicher Cache-Speicher akzeptabel ist
Kann mehr RAM/VRAM verwenden.
--cache-none
Nur dann, wenn die Reduzierung des Cache-Speichers wichtiger ist als die Geschwindigkeit.
Laut der eigenen CLI von ComfyUI wird jeder Knoten bei jedem Durchlauf ausgeführt, was sich in der Regel negativ auf die Renderzeit auswirkt.
Die aktuelle CLI bietet auch asynchrones Weight Offloading, das laut Hilfetext auf NVIDIA-Grafikkarten standardmäßig aktiviert ist. Das bedeutet, dass das Hinzufügen weiterer Flags nicht automatisch eine Optimierung darstellt; überprüfen Sie daher zuerst Ihren aktuellen Startbefehl und die Protokolle.
PyTorchs skalierte Dot-Product-Attention kann automatisch optimierte CUDA-Implementierungen wie FlashAttention oder speichereffiziente Attention auswählen, sofern Eingaben und Hardware dies zulassen. Daher können moderne Attention-Pfade relevant sein, der genaue Nutzen hängt jedoch von der Hardware ab. Vermeiden Sie es, einen allgemeinen Prozentsatz anzugeben, als ob dieser für Ihren SDXL-Workflow gelten würde.
8. Stellen Sie sicher, dass das Verhalten von Warteschlangen und Stapelverarbeitung Ihrem Ziel entspricht.
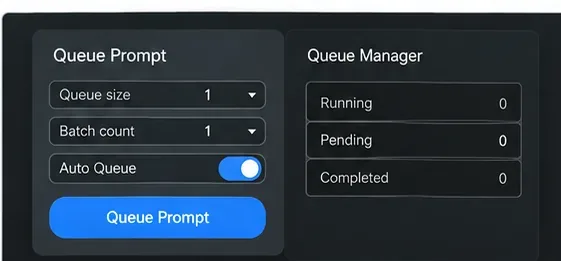
Wenn Ihnen ein schneller Feedback-Zyklus wichtig ist, sollten Sie beim Optimieren jeweils nur ein Bild in die Warteschlange stellen. Große Warteschlangenanzahlen und Batches sind hilfreich, wenn Sie die Einstellungen bereits kennen und einen hohen Durchsatz erzielen möchten; sie beschleunigen jedoch nicht das Eintreffen des ersten Bildes.
Sobald der Workflow finalisiert ist, können Sie den Durchsatz separat messen. Zu diesem Zeitpunkt kann ein größerer Batch sinnvoll sein, sofern der VRAM dies zulässt und die Gesamtzahl der Bilder pro Minute wichtiger ist als die Latenz pro Bild.
Verwenden Sie für die interaktive Optimierung ein einzelnes Bild in der Warteschlange und eine Batchgröße von 1; testen Sie größere Batches später, wenn der Durchsatz das Ziel ist.
Woran man erkennt, ob die Optimierung tatsächlich funktioniert hat
Ein schnellerer Durchlauf ist nur dann sinnvoll, wenn das Bild weiterhin Ihren Anforderungen entspricht. Vergleichen Sie vorher und nachher mit demselben Ausgangsmaterial und derselben Vorgabe. Überprüfen Sie zuerst die Bereiche, die bei zu aggressiven Einstellungen Probleme bereiten: kleine Schrift, Hände und Gesichter, sich wiederholende Muster, feine Materialien, Kantendetails und die Einhaltung vorgabenspezifischer Attribute.
Erfassen Sie für jeden Test mindestens diese vier Punkte: Gesamtausführungszeit, Anzahl der Sampling-Schritte, Auflösung und ob ein Modell geladen wurde. Dauert der erste Durchlauf 30 Sekunden und der zweite 12 Sekunden, wird ein Sampler-Wechsel nicht automatisch gutgeschrieben – der erste Durchlauf hat möglicherweise lediglich die Kosten für das Laden des Checkpoints abgedeckt.
Verwenden Sie Vergleichsmessungen mit festem Startwert, um zu entscheiden, ob eine geringere Schrittzahl akzeptabel ist. Die abgebildeten Beschriftungen veranschaulichen die Methode und stellen keine Benchmark-Ergebnisse dar.
Eine praktische Optimierungsordnung
Führen Sie einen Testlauf durch, um den Testlauf zu starten. Halten Sie Seed, Prompt, Auflösung und Batch konstant.
Entfernen Sie unnötige Verzweigungen. Testen Sie den SDXL-Basispfad ohne Refiner, ControlNet, Upscale oder optionale Präprozessoren.
Reduzieren Sie die Arbeitsschritte. Finden Sie die geringste Anzahl an Schritten, die dennoch Ihren Qualitätsansprüchen genügt.
Halten Sie die Auflösung im Rahmen. Optimieren Sie die Auflösung im Bereich des 1024-Pixel-Budgets der SDXL-Klasse, bevor Sie die hochauflösende Endbearbeitung vornehmen.
Die Batchgröße sollte während der Iteration auf 1 gehalten werden. Der Durchsatz sollte erst optimiert werden, nachdem der Workflow stabil ist.
Vergleichen Sie die verschiedenen Probenahme- und Planungsoptionen. Beurteilen Sie die Geschwindigkeit bei gleichwertiger, akzeptabler Qualität.
Nutzen Sie Caching und partielle Ausführung. Vermeiden Sie die erneute Ausführung unveränderter Upstream-Workflows.
Anschließend die Benchmark-Startflags. Testen Sie Vorschau, VRAM, Cache und Aufmerksamkeitsänderungen jeweils einzeln.
Wann Sie Ihre Strategie ändern sollten, anstatt die Optimierung zu intensivieren
Dauert ein SDXL-Workflow nach diesen Änderungen immer noch zu lange, überprüfen Sie die tatsächliche Funktionsweise des Jobs. Ein Produktionsgraph mit mehreren ControlNets, Refiner und Upscale kann von Natur aus rechenintensiv sein. In diesem Fall haben Sie drei Möglichkeiten: die längere Renderzeit für die finalen Bilder in Kauf nehmen, einen einfacheren Entwurfs-Workflow für Iterationen verwenden oder die Arbeitslast auf schnellere Hardware verlagern.
Wenn ständig der VRAM ausgeht, ist das Erzwingen eines „schnelleren“ GPU-basierten Modus die falsche Lösung. Eine stabile Ausführung im Standard-Speichermanagement oder mit weniger VRAM ist besser als wiederholte Speicherfehler. Speichersparende Einstellungen können die Renderzeit verlängern, aber ein langsamer, aber erfolgreicher Renderprozess ist immer noch besser als ein schneller Absturz.