Startseite
» Domänen
»
So generieren Sie automatisch SEO-Meta-Titel und -Beschreibungen mit Local Ollama
So generieren Sie automatisch SEO-Meta-Titel und -Beschreibungen mit Local Ollama
Sie haben 300 Produkt-, Dokumentations- oder Blogseiten, die Sie veröffentlichen möchten, aber die Metadatenspalte ist noch leer. Titel und Meta-Beschreibungen manuell zu schreiben, ist zeitaufwendig; ein einheitliches Muster auf der gesamten Website zu kopieren, führt zu immer gleichen Ergebnissen; und die Abfrage eines lokalen Sprachmodells nach einem „SEO-Titel“ liefert oft zusätzliche Kommentare, erfundene Behauptungen oder inkonsistente Formatierung.
Ein besserer Ansatz ist es, die Metadatengenerierung als kleine Datenpipeline zu behandeln: Dem Modell werden nur seitenbezogene Informationen bereitgestellt, eine strukturierte Ausgabe wird gefordert, diese wird im Code validiert und anschließend werden Ausnahmen vor der Veröffentlichung geprüft. Ollama eignet sich gut für diesen Workflow, da die lokale API nach http://localhost:11434/apider Installation verfügbar ist und Ollama strukturierte Ausgaben im JSON-Schema unterstützt. Die hier erwähnte Dokumentation zu Ollama und Google Search wurde am 13. September 2026 geprüft.
Die meisten Fehler entstehen durch den Workflow rund um das Modell und nicht durch eine einzelne „schlechte Eingabeaufforderung“. Häufige Ursachen sind zu wenig Seiteninhalt, das Zulassen von Freitextantworten des Modells, die Anwendung derselben Keyword-Formel auf jede URL und die Veröffentlichung der Ausgabe ohne Duplikatsprüfung auf Website-Ebene.
Es herrscht außerdem ein hartnäckiges Missverständnis bezüglich Zeichenbegrenzungen. Google gibt an, dass es keine feste Längenbegrenzung für Seitenelemente <title>oder Meta-Beschreibungen gibt; Titellinks und Snippets werden je nach Bedarf, in der Regel entsprechend der Bildschirmbreite, gekürzt. Google kann auch einen anderen Titellink oder Snippet aus dem Seiteninhalt generieren, wenn das System eine andere Darstellung als sinnvoller erachtet. Weitere Informationen finden Sie in Googles offiziellen Richtlinien für Titellinks , Snippets und Meta-Beschreibungen .
Das bedeutet, dass ein Skript redaktionelle Längenbeschränkungen zur Gewährleistung der Einheitlichkeit festlegen kann, diese Zahlen aber nicht als Google-Vorgaben kennzeichnen sollte. Im folgenden Beispiel sind 65 Zeichen für den Titel und 165 Zeichen für die Beschreibung lediglich interne Richtlinien. Passen Sie diese an Ihr CMS, Ihre Marke, Ihre Lokalisierungsanforderungen und Ihren Prüfprozess an.
Schritt 1: Installieren Sie Ollama und überprüfen Sie, ob die lokale API funktioniert.
Die offizielle Schnellstartanleitung von Ollama listet die Unterstützung für macOS, Windows und Linux auf. Nach der Installation laden Sie ein lokales Modell herunter. Da Ollama gemma3in seiner aktuellen Dokumentation häufig API-Beispiele verwendet, eignet es sich gut als neutrales Beispiel für dieses Tutorial.
ollama pull gemma3
Testen Sie anschließend den lokalen Endpunkt:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
Die Ollama-API-Dokumentation gibt an, dass die lokale API unter [Adresse einfügen] erreichbar ist http://localhost:11434/api. Ollama gibt außerdem an, dass für den lokalen Zugriff auf diese Adresse keine Authentifizierung erforderlich ist. Falls Ihr lokaler Dienst nicht ausgeführt wird, ollama servelautet der dokumentierte CLI-Befehl zum Starten [Befehl einfügen]. Vermeiden Sie den Austausch eines -cloudModells, wenn Sie tatsächlich lokale Inferenz durchführen möchten.
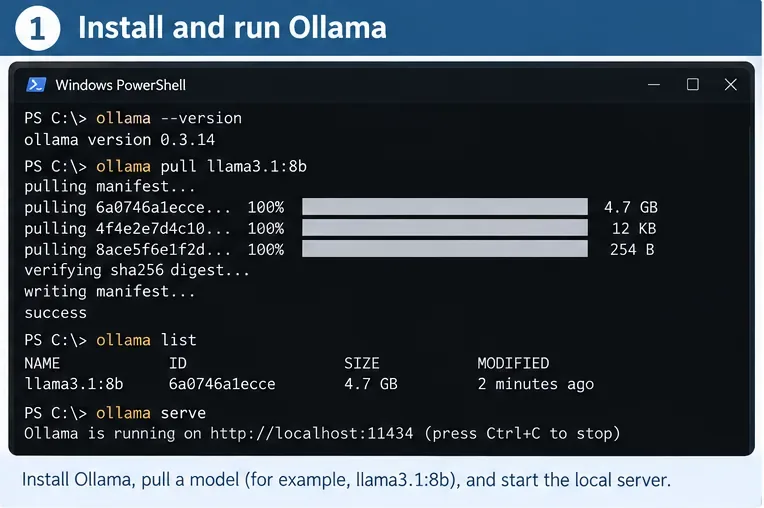
Ein Terminal-Workflow für die Einrichtungsphase: Ollama überprüfen, ein lokales Modell abrufen, bestätigen, dass es in der Liste der lokalen Modelle erscheint, und sicherstellen, dass der Dienst auf localhost verfügbar ist. Die angegebenen Modellnamen und Längenangaben sind Beispielwerte für den Workflow und stellen keine SEO-Anforderungen dar.
Wählen Sie ein Modell, das zu Ihrer Hardware passt.
Dieser Artikel erhebt bewusst nicht den Anspruch, dass ein bestimmtes Modell universell das beste für SEO-Metadaten ist. Die Verfügbarkeit von Modellen und die Kompatibilität mit der Hardware ändern sich im Laufe der Zeit, und größere Modelle benötigen mehr Arbeitsspeicher und reagieren in der Regel langsamer. Beginnen Sie mit einem Modell, das auf Ihrem Rechner problemlos läuft, erstellen Sie einen kleinen Testdatensatz und vergleichen Sie anschließend die inhaltliche Richtigkeit, die Einzigartigkeit, die Latenz und die Konsistenz, bevor Sie Tausende von Seiten verarbeiten.
Schritt 2: Strukturierte Ausgabe erzwingen anstatt Fließtext zu analysieren
Freitext ist für die Automatisierung ungeeignet. Eine Antwort wie „Hier sind drei großartige Optionen…“ zwingt Ihr Programm, den Beginn des eigentlichen Titels zu erraten. Die Dokumentation von Ollama zu strukturierten Ausgaben unterstützt die Übergabe eines JSON-Schemas im entsprechenden formatFeld. Sie empfiehlt außerdem die Verwendung wiederverwendbarer Schemas mit Pydantic in Python und weist darauf hin, dass eine niedrige Temperatur, beispielsweise 100 °C 0, die Deterministik verbessern kann.
Installieren Sie die beiden in diesem Beispiel verwendeten Python-Pakete:
python -m pip install -U ollama pydantic
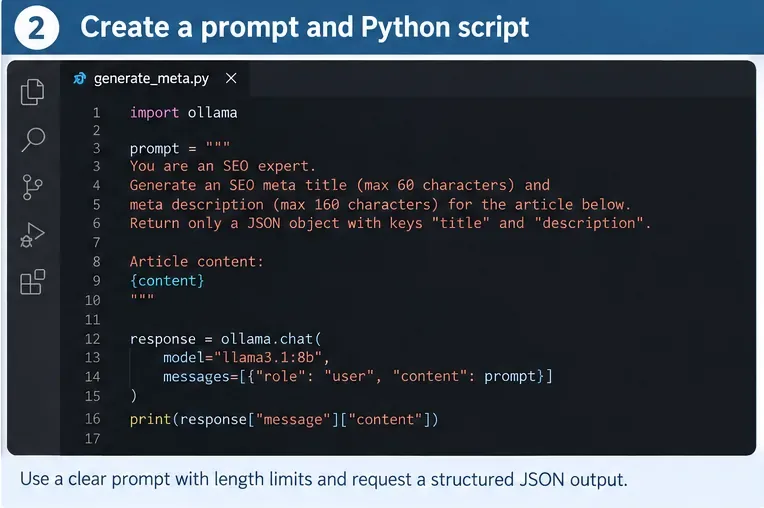
Dann erstellen Sie generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
Der Generator sollte die Seitenbelege, die Ausgabefelder und die redaktionellen Einschränkungen explizit angeben. Im Produktivbetrieb ist die JSON-Schema-strukturierte Ausgabe von Ollama und die anwendungsseitige Validierung der alleinigen Verwendung von Eingabeaufforderungen vorzuziehen.
Warum die Aufgabenstellung den aktuellen Titel und H1 enthält
<title>Google gibt an, dass sein Titel-Link-System den Haupttitel der Seite, Überschriften wie „H1“, „H2“, markanten Text, Ankertext und weitere Signale berücksichtigt <h1>. og:titleIhr lokaler Generator muss Googles System nicht exakt nachbilden, aber die Angabe des Quelltitels, der H1-Überschrift, der URL und eines repräsentativen Textkörpers trägt dazu bei, dass die vorgeschlagenen Metadaten mit dem übereinstimmen, was Leser tatsächlich auf der Seite sehen.
Verwenden Sie keine themenfremden Keyword-Listen und lassen Sie das Modell diese nicht automatisch einfügen. Google empfiehlt ausdrücklich aussagekräftige, prägnante Titel und warnt vor Keyword-Stuffing und wiederholten Standardtexten. Für Beschreibungen ist laut Google die seitenbezogene programmatische Generierung für große, datenbankgestützte Websites geeignet, sofern die Beschreibungen präzise, verständlich und vielfältig sind.
Schritt 3: Führen Sie eine Seite aus und validieren Sie diese, bevor Sie sie skalieren.
Führe das Skript aus:
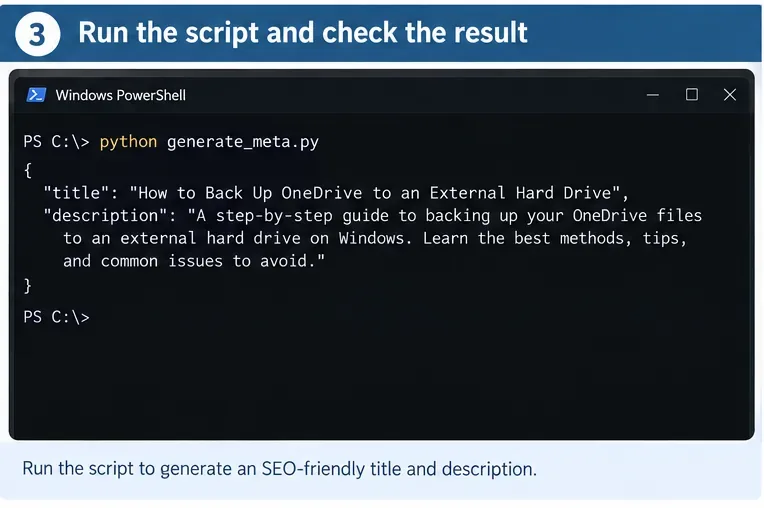
python generate_meta.py
Ein erfolgreiches Ergebnis sollte ein JSON-Objekt sein, das von Pydantic validiert werden kann. Noch wichtiger ist jedoch, dass ein menschlicher Prüfer es mit der Quellseite vergleichen und vier Fragen schnell beantworten können sollte:
Beschreibt der Titel diese konkrete Seite oder die Website im Allgemeinen?
Vermeidet die Beschreibung Angaben wie Behauptungen, Daten, Preise oder Merkmale, die im Quelltext nicht enthalten sind?
Wären diese Metadaten auch ohne den Seiteninhalt noch sinnvoll?
Unterscheiden sie sich von Metadaten, die bereits auf benachbarten Seiten verwendet werden?
Testen Sie zunächst eine repräsentative Seite und prüfen Sie das strukturierte Ergebnis, bevor Sie einen Batch-Job starten. Eine auswertbare JSON-Antwort ist erforderlich, die inhaltliche Richtigkeit und die Relevanz der Seite müssen jedoch noch validiert werden.
Fügen Sie Wiederholungsversuche für redaktionelle Fehler hinzu, nicht nur für API-Fehler.
Ein Schema kann Datentypen und -längen einschränken, aber es kann nicht garantieren, dass ein Satz wahrheitsgemäß oder ausreichend präzise ist. Implementieren Sie Wiederholungslogiken basierend auf messbaren Prüfungen. Weisen Sie beispielsweise leere Felder, doppelte Titel, unzulässige Standardtexte oder Beschreibungen, die den Titel nahezu wortwörtlich wiederholen, zurück. Enthält die Seite regulierte oder sensible Aussagen, ist eine manuelle Überprüfung ratsam, anstatt das Vertrauen durch Automatisierung zu zerstören.
Halten Sie die Wiederholungsaufforderungen kurz und prägnant. Anstatt alles mit „Verbessern“ neu zu generieren, beschreiben Sie dem Modell den Fehler: „Der vorgeschlagene Titel ist ein Duplikat einer anderen Seite. Schreiben Sie ihn neu und verwenden Sie dabei das eindeutige Thema in der H1-Überschrift. Achten Sie darauf, dass alle Aussagen auf den bereitgestellten Inhalten basieren.“ Dadurch lassen sich Fehler leichter nachverfolgen.
Schritt 4: Stapelverarbeitung der Seiten zu CSV-Dateien für Überprüfung und Veröffentlichung
Sobald der einseitige Test zuverlässig ist, speichern Sie Ihre Eingaben in einer CSV-Datei mit Spalten wie „<head>“ url, source_title„ h1<head>“, „<text>“ und content„<text>“. Das Feld „<text>“ sollte bereinigten Seitentext enthalten, keine Navigationsmenüs, Cookie-Hinweise oder Tausende von irrelevanten Fußzeilenlinks.
Fügen Sie diese Batch-Logik unterhalb der Generatorfunktion ein oder platzieren Sie sie in einem separaten Skript:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Die generierte CSV-Datei kann in Excel, LibreOffice, einem Datenbankimport-Tool oder Ihrem CMS-Workflow geöffnet werden. Überschreiben Sie beim ersten Durchlauf nicht automatisch die vorhandenen Metadaten. Behalten Sie den ursprünglichen Titel und die Beschreibung neben dem generierten Vorschlag bei, damit die Gutachter diese vergleichen und ein Zurücksetzen problemlos möglich ist.
Eine Tabellenkalkulations-Prüfwarteschlange erleichtert die Überprüfung der Massengenerierung: Die Quellseitenkennung, der generierte Titel, die generierte Beschreibung, die Längen und die QA-Kennzeichen bleiben vor der Veröffentlichung der Änderungen erhalten.
Machen Sie die Batch-Pipeline sicherer
Überprüfen
Was zu kennzeichnen ist
Warum es wichtig ist
Schema-Validierung
Fehlende oder ungültige Felder
Verhindert, dass fehlerhafte Ausgaben in das CMS gelangen.
Prüfung auf doppelte Titel
Gleicher normalisierter Titel auf zwei URLs
Hilft dabei, die Seiten unterscheidbar zu halten.
Sprachprüfung
Die Metadatensprache unterscheidet sich von der Seitensprache.
Google empfiehlt, die primäre Sprache und das Schriftsystem der Seite anzupassen.
Beweisprüfung
Angaben zu Zahlen, Preisen, Daten, Marken oder Garantien fehlen in der Quelle.
Verringert die Anzahl der Fälle von Halluzinationen.
Standardprüfung
Lange, sich wiederholende, seitenweite Phrasen
Google rät von der Wiederholung standardisierter Titel ab.
Überprüfung der redaktionellen Länge
Außerhalb Ihres gewählten Hausbereichs
Sorgt für eine einheitliche CMS-Ausgabe; dies ist keine Zeichenbegrenzungsregel von Google.
Menschliche Überprüfung
Strategische, sensible, stark frequentierte oder mehrdeutige Seiten
Die Automatisierung sollte Ausnahmen aufdecken, nicht verbergen.
Häufige Probleme, von der einfachsten bis zur schwierigsten Lösung
Die API-Verbindung schlägt fehl.
Prüfen Sie zunächst, ob Ollama ausgeführt wird und http://localhost:11434erreichbar ist. Laut der offiziellen Dokumentation zur Authentifizierunghttps://ollama.com/api ist für die lokale API keine Authentifizierung erforderlich. Falls Ihr Skript versehentlich auf einen anderen gehosteten Endpunkt verweist , ist dies ein separater Endpunkt, der eine Authentifizierung erfordert.
Die Antwort enthält Fließtext um das JSON herum.
Verwenden Sie das Schema, format=SeoMeta.model_json_schema()anstatt JSON nur in natürlicher Sprache anzufordern. Strukturierte Ausgaben sind die richtige Steuerungsebene für eine Produktionspipeline.
Die Titel klingen alle gleich
Fügen Sie seitenbezogenen H1-Text und aussagekräftigen Fließtext hinzu, entfernen Sie störende Elemente der globalen Navigation und fordern Sie explizit eine seitenbezogene Beschreibung an. Führen Sie anschließend eine seitenübergreifende Duplikat- und Ähnlichkeitsprüfung durch. Wiederholungen sind oft eher ein Problem der Eingabedaten als des Datenmodells.
Das Modell erfindet Merkmale oder Statistiken
Beschränken Sie die Eingabe auf den maßgeblichen Seitentext und verschärfen Sie die Grundregel: Keine faktischen Aussagen, die über den bereitgestellten Inhalt hinausgehen. Vergleichen Sie bei wichtigen Seiten die generierten Aussagen vor der Freigabe mit den strukturierten Quelltextfeldern. Ist der Quelltext selbst mehrdeutig, lassen Sie die Zeile von einem Mitarbeiter prüfen, anstatt das Modell wiederholt raten zu lassen.
Das Modell ist für Tausende von Seiten zu langsam.
Vor einer Architekturänderung sollten Sie messen. Protokollieren Sie die Generierungszeit pro Seite, die Eingabegröße, den Modellnamen und die Fehlerrate. Entfernen Sie irrelevanten Fließtext, verarbeiten Sie stabile Seitenabschnitte und testen Sie ein kleineres lokales Modell, falls die Qualität weiterhin akzeptabel ist. Das schnellste Modell ist nutzlos, wenn seine Metadaten mehr Prüfaufwand verursachen als es einspart.
Optional: Verwendung einer bestehenden OpenAI-Integration
Wenn Sie bereits Code für einen OpenAI-kompatiblen Client geschrieben haben, dokumentiert Ollama die teilweise OpenAI-API-Kompatibilität unter [ http://localhost:11434/v1/Link einfügen]. Dies kann den Migrationsaufwand reduzieren. Für ein neues, nur lokal nutzbares Metadaten-Tool ist der native Ollama-Python-Client einfacher und stellt Beispiele für strukturierte Ausgaben direkt in der Ollama-Dokumentation bereit.
Wie man das fertige System selbst überprüft
Bevor Sie die Automatisierung als abgeschlossen betrachten, erstellen Sie ein Testset mit verschiedenen Inhaltstypen: einen kurzen Artikel, eine ausführliche Anleitung, eine Produktseite, eine Kategorieseite, eine Seite mit Zahlen und eine Seite in jeder unterstützten Sprache. Führen Sie dasselbe Modell und dieselbe Eingabeaufforderung für alle Inhaltstypen aus und überprüfen Sie anschließend die folgende Checkliste.
Der lokale Endpunkt ist localhostund das ausgewählte Modell ist ein lokales Modell, kein Cloud-getaggtes Modell.
Jede Antwort wird anhand des Schemas validiert, ohne dass eine manuelle JSON-Bereinigung erforderlich ist.
Kein generierter Titel ist in den Rezensionen doppelt vorhanden.
Alle Faktenbehauptungen sind im bereitgestellten Seiteninhalt enthalten.
Die Metadaten verwenden dieselbe primäre Sprache und dasselbe Schriftsystem wie die Seite.
Der Titel ist beschreibend und prägnant und verzichtet auf wiederholte Schlüsselwörter.
Die Beschreibung fasst die jeweilige Seite zusammen, nicht die Website als Ganzes.
Ihre internen Längenbeschränkungen sind als redaktionelle Richtlinien und nicht als Google-Anforderungen zu verstehen.
Die alten Metadaten, der generierte Vorschlag, die QA-Flags, der Modellname und die Prompt-Version werden zur Überprüfung und zum Rollback gespeichert.
Ein Prüfer weiß, welche Kennzeichnungen vor der Veröffentlichung einer manuellen Genehmigung bedürfen.
Denken Sie schließlich daran, was Automatisierung leisten kann und was nicht. Eine gute <title>Meta-Beschreibung liefert Suchmaschinen zwar nützliche Informationen über die Seite, Google kann aber auch Titellinks und Snippets aus anderen Seiteninhalten generieren. Ziel ist es daher nicht, ein bestimmtes Suchergebnis zu erzwingen. Vielmehr geht es darum, präzise, aussagekräftige und nützliche Metadaten in großem Umfang zu erstellen und gleichzeitig genügend Validierung und Überprüfung zu gewährleisten, um Fehler zu erkennen, bevor sie in die Produktion gelangen.