Startseite
» Domänen
»
Wie man den Fehler „Kontextfenster überschritten“ bei der Analyse langer Dokumente behebt, ohne wichtige Erkenntnisse zu verlieren
Wie man den Fehler „Kontextfenster überschritten“ bei der Analyse langer Dokumente behebt, ohne wichtige Erkenntnisse zu verlieren
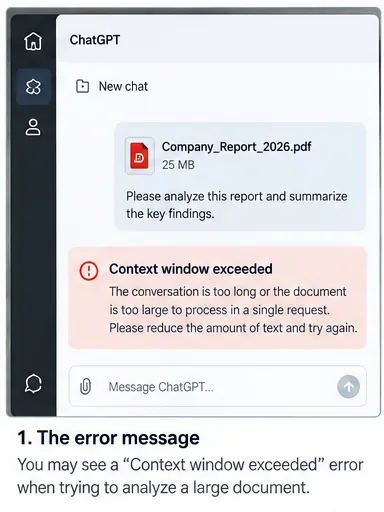
Sie laden einen umfangreichen Bericht hoch, bitten um eine detaillierte Analyse und erhalten statt einer Antwort eine Meldung wie „Kontextfenster überschritten“, „Maximale Kontextlänge überschritten“ oder eine andere Warnung, dass die Anfrage zu groß ist. Besonders ärgerlich ist, dass die Datei möglicherweise erfolgreich hochgeladen wurde und dasselbe Dokument bei einer spezifischeren Fragestellung sogar funktioniert hätte.
Der Grund ist einfach, aber leicht zu übersehen: Upload-Limit und Kontextfenster eines Modells sind nicht dasselbe. Ein Modell muss das Material, das es aktiv analysiert, in ein begrenztes Token-Budget einpassen. Dieses Budget kann Anweisungen, Gesprächsverlauf, aus Dateien extrahierten Text, Werkzeugdefinitionen, abgerufene Passagen, Argumentations-Tokens und Platz für die Antwort umfassen. Ein Dokument kann daher zwar hochgeladen werden dürfen, aber dennoch zu groß sein, um es in einem Durchgang zu analysieren.
Die beste Lösung besteht meist darin, nicht immer wieder dieselbe riesige Eingabeaufforderung zu verwenden. Beginnen Sie mit den am wenigsten einschneidenden Änderungen und gehen Sie erst dann zu Chunking, Retrieval oder einem Workflow mit größerem Kontext über, wenn der einfachere Ansatz weiterhin fehlschlägt.
Zunächst sollte bestätigt werden, dass es sich bei dem Fehler tatsächlich um ein Kontextfensterproblem handelt.
Bevor Sie das Dokument ändern, unterscheiden Sie zwischen einem Kontextfehler und einer Upload- oder Speicherbegrenzung. Laut den aktuellen Richtlinien von OpenAI zum Datei-Upload gilt für Dateien, die in ChatGPT oder eine GPT hochgeladen werden, eine feste Dateigröße von 512 MB, während Text- und Dokumentdateien auf 2 Millionen Token pro Datei begrenzt sind. Dies sind Upload-Beschränkungen und keine Garantie dafür, dass der gesamte Text sofort in den aktiven Kontext eines Modells eingefügt wird.
Die FAQ zu Datei-Uploads von OpenAI sind die maßgebliche Quelle für die Überprüfung der aktuellen Upload-Limits. Die genauen Limits variieren je nach Produkt, Tarif, Modell und Anbieter. Gehen Sie daher nicht davon aus, dass eine aus einem älteren Artikel übernommene Zahl noch gültig ist.
Was Sie sehen
Wahrscheinlicher Engpass
Der beste erste Schritt
Die Datei wird vor Beginn der Analyse abgelehnt.
Dateigröße, Dateityp, Speicherplatz oder Upload-Kontingent
Prüfen Sie die aktuellen Upload-Regeln.
Die Datei wird hochgeladen, aber eine lange Eingabeaufforderung schlägt mit einem Kontextfehler fehl.
Die aktive Anfrage überschreitet das Kontextbudget des Modells.
Verkürzen Sie die Anfrage und reduzieren Sie den aktiven Kontext.
Die Antwort umfasst die ersten Seiten, lässt aber spätere Abschnitte aus.
Nicht das gesamte Material wurde direkt in den Kontext eingeordnet, oder relevante Passagen wurden beim Abruf übersehen.
Stellen Sie präzisere Fragen oder teilen Sie die Fragen in Abschnitte auf.
Ein Gespräch, das anfangs funktionierte, scheitert nach vielen Wendungen.
Der angesammelte Chatverlauf verbraucht Kontext.
Eröffnen Sie einen neuen Analysethread mit einer kompakten Übergabezusammenfassung.
Ein Kontextfensterfehler kann nach erfolgreichem Dokumentenupload auftreten, da die aktive Anfrage noch in das Token-Budget des Modells passen muss.
Schritt 1: Messen Sie das Dokument, bevor Sie es ändern.
Seitenzahl und Megabytes liefern nützliche Anhaltspunkte, doch für den Textkontext sind Tokens entscheidend. Die Tokenisierung hängt von Sprache, Formatierung, Zeichensetzung und der Kodierung des verwendeten Modells ab. Daher kann ein 100-seitiges technisches Handbuch eine ganz andere Anzahl an Tokens benötigen als eine 100-seitige Präsentation.
Die Richtlinien von OpenAI zur Token-Zählung empfehlen, das Kontextfenster des Zielmodells zu überprüfen und Platz für Ausgaben sowie, bei Modellen mit Schlussfolgerungslogik, für Schlussfolgerungstoken einzuplanen. Sie weisen außerdem darauf hin, dass Nachrichtenstruktur, Tools, Dateien, Bilder und Schemata zusätzliche Token über den gezählten Klartext hinaus erzeugen können.
Zur schnellen Sichtung sollten Sie die Seitenzahl der Datei, die ungefähre Wortzahl, die Anzahl der Hauptabschnitte und das Vorhandensein von Anhängen, sich wiederholenden juristischen Formulierungen, Rohprotokollen, Transkripten, Tabellen oder Verweisen, die Sie für die Aufgabe eigentlich nicht benötigen, notieren.
Prüfen Sie vor der Fehlerbehebung den Umfang des Dokuments. Dateigröße und Seitenzahl sind nur Näherungswerte; die Token-Nutzung ist der relevantere Grenzwert für die Textanalyse.
Schritt 2: Reduzieren Sie die laufende Konversation, bevor Sie die Datei bearbeiten.
Ist das Dokument nicht übermäßig groß, kann es kostengünstiger sein, den angesammelten Kontext zu entfernen, anstatt die Datei aufzuteilen. Starten Sie einen neuen Chat oder eine neue Anfrage und geben Sie nur die relevanten Anweisungen weiter. Ersetzen Sie einen langen Dialog durch eine kurze Übergabe, z. B.: „Analysieren Sie den beigefügten Bericht hinsichtlich Umsatztreibern, wesentlichen Risiken und Managementempfehlungen. Nennen Sie fünf Ergebnisse mit Seiten- oder Abschnittsangaben.“
Entfernen Sie außerdem wiederholte Hintergrundinformationen, nicht mehr benötigte Beispiele, doppelt eingefügten Text und frühere Entwürfe. Wenn Sie einen API-Workflow verwenden, zählen Sie die gesamte Anfrage und nicht nur das Dokument. Eine Anfrage, die gerade so passt, lässt wenig Spielraum für die Antwort und kann bei wachsenden Anweisungen oder Tool-Schemas unvorhersehbar fehlschlagen.
Erfolgszeichen: Dieselbe Datei funktioniert in einem neuen Thread mit fokussierter Eingabeaufforderung. In diesem Fall lag das Problem zumindest teilweise im angesammelten Kontext und nicht im Dokument selbst.
Schritt 3: Die Fragestellung und die gewünschte Ausgabe eingrenzen.
„Analysieren Sie alles in diesem 400-seitigen Dokument und verfassen Sie einen umfassenden Bericht“ – diese Anweisung zwingt das System, viele Themen gleichzeitig zu berücksichtigen. Stellen Sie stattdessen jeweils nur eine Frage. Fragen Sie beispielsweise zuerst nach den Hauptrisiken des Dokuments, dann nach den finanziellen Annahmen und schließlich nach Widersprüchen zwischen den Aussagen des Managements und den zugrundeliegenden Daten.
Halten Sie das Antwortformat begrenzt. Eine Anfrage nach einem 20-seitigen Bericht beansprucht deutlich mehr Budget als eine Anfrage nach einer 10-zeiligen Beweistabelle. Sie können die endgültige Antwort jederzeit erweitern, nachdem die Beweise gesammelt wurden.
Eine hilfreiche, zielgerichtete Aufgabenstellung lautet: „Identifizieren Sie anhand dieses Dokuments bis zu acht Aussagen, die für die Kundenabwanderung relevant sind. Geben Sie für jede Aussage die entsprechende Abschnitts- oder Seitenzahl, eine kurze Erläuterung (ein Satz) und etwaige Einschränkungen an. Falls das Dokument nicht genügend Belege enthält, weisen Sie bitte darauf hin.“
Wann man zur nächsten Frage übergehen sollte: Wenn eine gezielte Frage immer noch denselben Fehler erzeugt oder wenn Sie eine zuverlässige Abdeckung des gesamten Dokuments anstatt eines einzelnen Themas benötigen, teilen Sie die Quelle auf.
Schritt 4: Teilen Sie das Dokument nach Inhalt auf, nicht nur nach gleicher Seitenzahl.
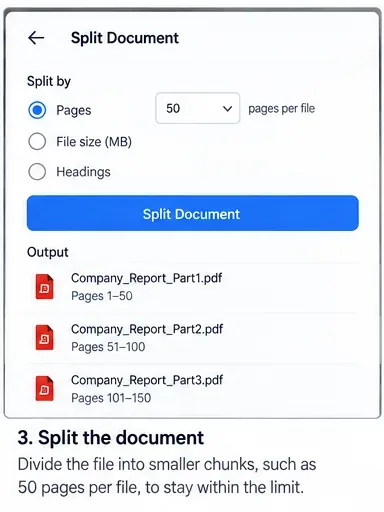
Die Aufteilung in Abschnitte ist die zuverlässigste Methode, um sehr lange Dokumente zu bearbeiten. Teilen Sie die Datei an natürlichen Grenzen wie Kapiteln, Berichtsabschnitten, Verträgen, Anhängen, Datumsbereichen oder Sprecherwechseln auf. Logische Abschnitte erhalten den Kontext besser als willkürliche Trennlinien alle 50 Seiten.
Wenn ein Abschnitt stark vom vorherigen abhängt, fügen Sie eine kurze Überleitung oder eine kurze Überleitungsnotiz ein, die den vorhergehenden Abschnitt beschreibt. Benennen Sie die Abschnitte eindeutig, z. B. „Abschnitt 1“, „Abschnitt 2“ 01_Executive_Summary.pdfund 02_Financial_Results.pdf„Abschnitt 3 03_Risk_Factors.pdf“. Behalten Sie nach Möglichkeit die ursprünglichen Seitenzahlen bei, damit die endgültige Zusammenfassung nachvollziehbar ist.
Teilen Sie einen sehr langen Quelltext in logische, klar benannte Abschnitte auf. Behalten Sie die ursprünglichen Seiten- oder Abschnittsverweise bei, damit die spätere Synthese mit dem Quelltext abgeglichen werden kann.
Schritt 5: Analysieren Sie jeden Abschnitt mit demselben Evidenzschema.
Bitten Sie nicht einfach um eine freie Zusammenfassung jedes Abschnitts. Verwenden Sie für jeden Abschnitt dieselbe Struktur, damit die Ergebnisse zusammengeführt werden können, ohne dass wichtige Unterschiede verloren gehen. Ein praktisches Schema könnte Abschnittsname, Hauptergebnisse, Belege, Seiten- oder Überschriftenverweis, Unklarheiten und offene Fragen enthalten.
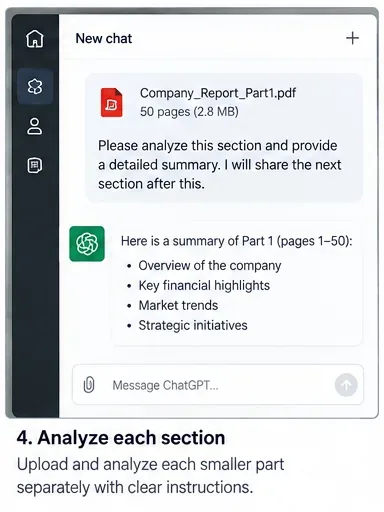
Beispiel: „Analysieren Sie nur Teil 3. Geben Sie Folgendes an: (1) maximal fünf wesentliche Feststellungen, (2) die Belege für jede Feststellung, (3) die ursprüngliche Seiten- oder Abschnittsangabe, (4) alle vom Autor genannten Einschränkungen und (5) Fragen, die in einem anderen Abschnitt zu klären sind. Schließen Sie nicht auf Tatsachen, die nicht in diesem Teil enthalten sind.“
Dieser Ansatz erleichtert auch die Qualitätsbeurteilung. Enthält eine Chunk-Zusammenfassung Ansprüche ohne Quelladressen, sollte dieser Chunk vor dem Fortfahren korrigiert werden, anstatt darauf zu hoffen, dass die abschließende Synthese das Problem behebt.
Analysieren Sie jeweils einen Abschnitt mit einem festen Ausgabeformat, sodass jedes Teilergebnis später kombiniert und auf den Ursprung zurückgeführt werden kann.
Schritt 6: Erstellen Sie eine Zusammenfassung der Zusammenfassungen, anstatt jeden vollständigen Datenblock neu zu laden.
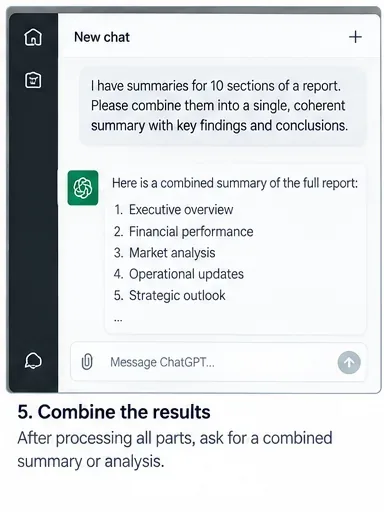
Sobald die Teile analysiert sind, erstellen Sie aus den Chunk-Ausgaben ein kompaktes Beweispaket und synthetisieren Sie dieses. Senden Sie nicht automatisch jeden ursprünglichen Chunk plus jede Zusammenfassung in einer einzigen finalen Anfrage zurück; dies kann dasselbe Kontextproblem erneut verursachen.
Die Syntheseaufforderung sollte dem Modell mitteilen, dass Unstimmigkeiten und Lücken erhalten bleiben sollen. Zum Beispiel: „Fügen Sie diese Abschnittsanalysen zu einem Bericht zusammen. Fassen Sie doppelte Ergebnisse zusammen, behalten Sie widersprüchliche Belege als separate Punkte bei, behalten Sie alle Quellenangaben bei und kennzeichnen Sie alle Fragen, die sich nicht anhand der Zusammenfassungen beantworten lassen.“
Diese hierarchische Methode eignet sich besonders für Bücher, behördliche Dokumente, Aktenveröffentlichungen, umfangreiche Interviewprotokolle und Recherchen mit mehreren Dokumenten. Ihre größte Einschränkung ist die Informationskomprimierung: Details, die bei der Zusammenfassung eines Datenblocks ausgelassen werden, können nicht später wieder auftauchen. Deshalb sind das Beweisschema und die Quellenangaben so wichtig.
Fassen Sie die Analysen kompakter Abschnitte zusammen, anstatt den gesamten Quelltext neu zu laden. Behalten Sie Zitate, Meinungsverschiedenheiten und offene Fragen während der Synthese bei.
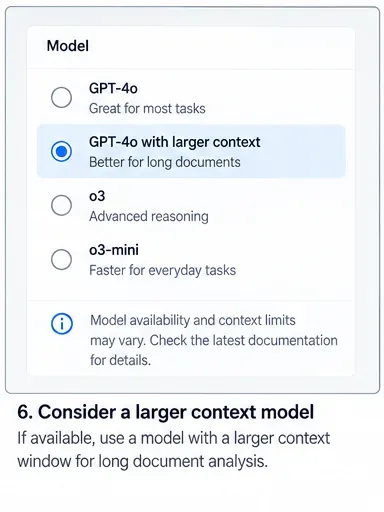
Schritt 7: Ziehen Sie ein Modell mit größerem Kontext in Betracht, betrachten Sie es aber nicht als vollständige Lösung.
Ein Modell mit einem größeren Kontextfenster kann die Notwendigkeit einer aggressiven Datensegmentierung reduzieren. Die aktuelle Modelldokumentation von OpenAI listet Kontextfenster- und maximale Ausgabegrenzen für API-Modelle auf; diese Werte können sich mit Modellaktualisierungen ändern.
Die Größe des Überschriftenkontexts eines Modells entspricht jedoch nicht unbedingt der Menge einer hochgeladenen Datei, die ein Produkt direkt in die Eingabeaufforderung einfügt. Die unternehmensspezifischen Dateirichtlinien von OpenAI beschreiben derzeit ein separates Verfahren zum „Context Stuffing“ hochgeladener Textdokumente: Bis zu 110.000 Tokens aus hochgeladenen Dokumenten können direkt in den Kontext eingefügt werden, wobei zusätzliches Material über einen privaten Suchindex verfügbar ist. OpenAI weist ausdrücklich darauf hin, dass dieses Verhalten aktiv weiterentwickelt wird und Änderungen unterliegen kann. Siehe „ Optimierung von Datei-Uploads in ChatGPT Enterprise“ .
Die praktische Lehre daraus ist, ein Modell mit größerem Kontext zu wählen, wenn es den Arbeitsablauf wesentlich vereinfacht, aber dennoch zu prüfen, ob die relevanten Abschnitte tatsächlich berücksichtigt werden. Ein größerer Kontext ersetzt nicht die Notwendigkeit einer guten Abgrenzung, von Quellenangaben oder einer Überprüfung.
Ein Modell mit größerem Kontext kann hilfreich sein, aber überprüfen Sie die Grenzen für das genaue Modell und die Produktoberfläche, die Sie verwenden, anstatt sich auf eine generische Zahl zu verlassen.
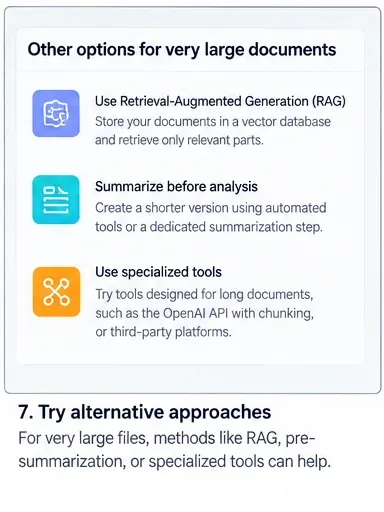
Schritt 8: Bei sehr großen Korpora von „Alles einfügen“ auf „Abruf“ umstellen
Wenn die Aufgabe Hunderte oder Tausende von Seiten umfasst, ist die Informationssuche in der Regel eine bessere Architektur als der Versuch, den gesamten Korpus in eine einzige Suchanfrage einzufügen. Informationssysteme indizieren die Quelle, suchen nach Passagen, die für die aktuelle Frage relevant sind, und stellen nur diese Passagen in den aktiven Kontext.
Die Dokumentation zur Dateisuche von OpenAI beschreibt ein gehostetes Tool zur Suche hochgeladener Dateien in Vektordatenbanken. Die Suche eignet sich besonders gut für gezielte Anfragen wie „Welche Abschnitte definieren die Kündigung aus praktischen Gründen?“ oder „Wo im Bericht wird die Konzentration in der Lieferkette thematisiert?“
Die Suche ist weniger zuverlässig, wenn die Aufgabe tatsächlich die gleichzeitige Kenntnis jeder einzelnen Passage erfordert, beispielsweise um zu beweisen, dass ein bestimmtes Thema nie vorkommt, jede Tabellenzelle in einer riesigen Sammlung zu vergleichen oder eine vollständige zeilenweise Transformation durchzuführen. In solchen Fällen sollten Sie zusätzlich zur Suche systematische Stapelverarbeitung oder codebasierte Vorverarbeitung einsetzen.
Bei Korpora, die nach der Segmentierung immer noch zu groß sind, kann die Abfrage nur die relevantesten Passagen in den aktiven Kontext für jede Frage einbringen.
Entwickler, die die OpenAI Responses API verwenden, haben eine zusätzliche Option. Die API-Referenz beschreibt eine truncationEinstellung: Mit disabledder dokumentierten Standardeinstellung schlägt eine Anfrage fehl, die den Kontextbereich des Modells überschreiten würde; mit der Option autokönnen frühere Konversationselemente verworfen werden, um die Anfrage passend zu machen. Siehe die Responses API-Referenz .
Automatische Kürzung kann zwar einen schwerwiegenden Fehler verhindern, verändert aber die dem Modell zur Verfügung stehenden Informationen. Bei der Dokumentenanalyse kann das stillschweigende Verwerfen von frühem Kontext sogar schädlicher sein als eine Fehlermeldung. Verwenden Sie diese Funktion nur, wenn Ihre Anwendung so konzipiert ist, dass ältere Gesprächselemente entbehrlich sind oder bereits an anderer Stelle zusammengefasst wurden.
So überprüfen Sie, ob die Reparatur tatsächlich funktioniert hat
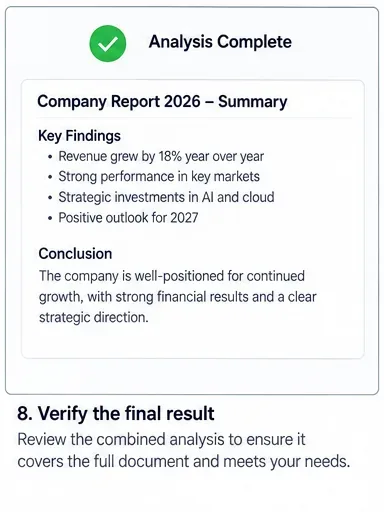
Ein erfolgreicher Antrag allein genügt nicht. Ziel ist eine fundierte Analyse, die alle relevanten Aspekte abdeckt, ohne Beweismaterial unbemerkt zu verlieren. Überprüfen Sie das Ergebnis, bevor Sie das Problem als gelöst betrachten.
Abdeckungsprüfung: Stellen Sie sicher, dass jedes erforderliche Kapitel, jeder Datumsbereich oder jede Quelldatei im Analyseplan oder in der endgültigen Nachweistabelle enthalten ist.
Rückverfolgbarkeitsprüfung: Stichproben Sie wichtige Aussagen und überprüfen Sie deren Seiten-, Abschnitts- oder Dateiverweise anhand der Originalquelle.
Grenzprüfung: Überprüfen Sie die Ergebnisse in der Nähe der Chunk-Grenzen, um sicherzustellen, dass ein Konzept nicht zwischen den Teilen aufgeteilt oder widerlegt wurde.
Negativkontrolle: Stellen Sie eine Frage, deren Antwort bekanntermaßen nicht vorliegt. Ein guter Arbeitsablauf sollte das Fehlen von Beweisen bestätigen, anstatt sie zu erfinden.
Reproduzierbarkeitsprüfung: Stellen Sie einige repräsentative Fragen erneut. Große Veränderungen in den zitierten Belegen können auf eine schwache Erinnerungsleistung oder eine zu weit gefasste Fragestellung hindeuten.
Budgetprüfung: Wenn Sie eine API verwenden, überprüfen Sie die tatsächliche Verwendung von Eingabe- und Ausgabetoken, anstatt sich nur auf grobe Schätzungen der Wortanzahl zu verlassen.
Der letzte Schritt ist die Verifizierung: Überprüfen Sie Abdeckung, Quellreferenzen, Chunk-Grenzen und nicht unterstützte Behauptungen, bevor Sie der kombinierten Analyse vertrauen.
Was man nicht tun sollte
Senden Sie nicht wiederholt dieselbe, übergroße Anfrage und erwarten Sie ein anderes Token-Limit. Löschen Sie während der Chunking-Phase keine Quellcode-Referenzen. Gehen Sie nicht davon aus, dass die Akzeptanz einer Datei bedeutet, dass jede Seite im Kontext aktiv ist. Und beheben Sie den Fehler nicht, indem Sie die Antwort so stark kürzen, dass die Analyse die Aufgabe nicht mehr erfüllen kann.
Vermeiden Sie es außerdem, die automatische Kürzung als unsichtbare Magie zu betrachten. Wenn das System ältere Elemente verwirft, kann die Anfrage zwar erfolgreich sein, jedoch gehen dabei wichtige Anweisungen oder Beweise verloren. Bei Analysen mit hohem Risiko ist die explizite Segmentierung und der Abruf von Daten in der Regel leichter nachvollziehbar.
Eine praktische Entscheidungsregel
Wenn ein neuer Thread und eine präzisere Fragestellung zielführend sind, halten Sie den Workflow einfach. Erfordert die Aufgabe die umfassende Analyse eines langen Dokuments, teilen Sie es in logische Abschnitte auf und erstellen Sie strukturierte Chunk-Analysen. Bei wiederholten Abfragen einer sehr großen Dokumentensammlung empfiehlt sich die Retrieval-Funktion. Falls Sie die API kontrollieren und dennoch an die Grenzen stoßen, messen Sie die Tokenanzahl, reservieren Sie Speicherplatz, wählen Sie ein geeignetes Modell und legen Sie das Abschneideverhalten explizit im Design fest.
Das beste Ergebnis ist nicht dasjenige, das den meisten Text in eine einzige Anfrage packt. Es ist dasjenige, das die erforderlichen Nachweise enthält, die Nachvollziehbarkeit gewährleistet und deutlich macht, wann Informationen nicht verfügbar waren.