Startseite
» Domänen
»
Wie man eine private lokale KI-Wissensdatenbank für persönliche Dokumente einrichtet
Wie man eine private lokale KI-Wissensdatenbank für persönliche Dokumente einrichtet
Die einfachste praktische Lösung: Führen Sie das Sprachmodell, das Einbettungsmodell, den Dokumentenindex und die Chat-Oberfläche auf Ihrem eigenen Computer aus. Ein unkomplizierter Stack besteht aus Ollama für die lokale Modellbereitstellung und dem selbstgehosteten AnythingLLM für die Dokumentenerfassung, die Retrieval-Augmented Generation (RAG) und den Chat. Halten Sie die Vektordatenbank lokal, verwenden Sie persistenten Speicher, vermeiden Sie Cloud-Modellanbieter und testen Sie, ob die Antworten tatsächlich auf Ihren Dateien basieren.
Beispiel: Stellen Sie sich in diesem Leitfaden vor, Jordan organisiert eine private Sammlung mit Haushaltsanleitungen, Versicherungsdokumenten (PDFs), Besprechungsnotizen, einem Ratgeber zu persönlichen Finanzen und einigen Projektberichten. Jordan ist eine fiktive Person. Die unten beschriebenen Dateien, Fragen, Antworten und Ergebnisse dienen lediglich der Veranschaulichung des Arbeitsablaufs und stellen weder Testergebnisse noch eine Erfahrungsberichte dar.
Diese Anleitung verwendet eine vierstufige Einrichtung, um die Datenschutzgrenzen transparent zu halten. Sie eignet sich für Einzelpersonen oder kleine, vertrauenswürdige Haushalte, die lokale Dokumentensuche und Fragebeantwortung wünschen. Benötigen Sie unternehmensweite Identitätskontrollen, Verfügbarkeit auf mehreren Knoten, zentrale Überwachung oder regulatorische Garantien, sollten Sie dies als Ausgangspunkt für Ihre Architektur und nicht als vollständige Compliance-Lösung betrachten.
Was eine „private lokale KI-Wissensdatenbank“ tatsächlich bedeutet
Eine lokale Wissensdatenbank ist nicht dasselbe wie das Trainieren eines Modells mit Ihren Dokumenten. In einem typischen RAG-Workflow extrahiert das System Text aus Ihren Dateien, teilt ihn in Abschnitte auf, wandelt diese Abschnitte in numerische Einbettungen um, speichert sie in einer Vektordatenbank, ruft für jede Frage die relevanten Abschnitte ab und sendet nur diese als Kontext an das Sprachmodell.
Die aktuelle Dokumentation von AnythingLLM beschreibt sowohl Workflows für angehängte als auch für eingebettete Dokumente. Angehängte Dokumente können, sofern das Kontextfenster dies zulässt, den gesamten Text in einen Chat einfügen, während RAG kleinere, relevante Abschnitte aus eingebetteten Dokumenten extrahiert. Die zugehörige Dokumentation zur lokalen LanceDB gibt zudem an, dass die standardmäßige, in der Instanz verwendete LanceDB Dokumenttexte und Einbettungen innerhalb der AnythingLLM-Anwendung speichert. Siehe die Dokumentation zum AnythingLLM-Dokument-Workflow und die AnythingLLM-LanceDB-Dokumentation .
Komponente
Rolle im lokalen Stack
Datenschutzfreundliche Auswahl
Ollama
Führt das Chat-Modell und optional ein Einbettungsmodell auf Ihrem Rechner aus.
Verwenden Sie ein lokales Modell, keinen Cloud-basierten Modellendpunkt.
AnythingLLM
Bietet Benutzeroberfläche, Dokumentenverwaltung, Chunking, RAG-Struktur und Arbeitsbereichsorganisation
Führen Sie es lokal aus und behalten Sie das Speicherverzeichnis bei.
Einbettungsmodell
Wandelt Dokumentfragmente und Suchanfragen in Vektoren für die semantische Suche um.
Verwenden Sie einen lokalen Einbetter, wenn Dokumente nicht an einen externen Dienst gesendet werden dürfen.
LanceDB
Speichert Vektoren, die zum Auffinden relevanter Passagen verwendet werden
Behalten Sie die standardmäßige lokale Instanz bei, es sei denn, Sie benötigen absichtlich eine Remote-Datenbank.
Originaldateien und Sicherungskopien
Bleiben Sie die maßgebliche Quelle
Schützen Sie sie mit normalen Betriebssystem-Zugriffskontrollen, Verschlüsselung und Datensicherungen.
Bevor Sie beginnen: Legen Sie die Privatsphäre-Grenze fest.
Die entscheidende Frage lautet nicht „Ist die Anwendung lokal?“, sondern „Welche Komponenten können Dokumenttext oder Eingabeaufforderungen vom Rechner senden?“ Eine lokale Benutzeroberfläche kann weiterhin so konfiguriert werden, dass sie ein Cloud-basiertes LLM, eine Cloud-basierte Einbettungs-API, eine Websuche oder Remote-Tools aufruft. Bei einer privaten Umgebung sollten LLM, Einbettungs-API und Vektordatenbank lokal gespeichert werden, es sei denn, Sie haben die Datenweitergabe durch einen externen Anbieter bewusst akzeptiert.
AnythingLLM dokumentiert anonyme Telemetriedaten und bietet eine Möglichkeit, diese zu deaktivieren. Die Datenschutzdokumentation unterscheidet außerdem zwischen dem Entfernen eines Dokuments aus einem Arbeitsbereich und dem vollständigen Löschen aus der Dokumentenbibliothek. Um ein Dokument in AnythingLLM endgültig zu löschen, empfiehlt die aktuelle Dokumentation, es aus „ Eigene Dokumente“ zu entfernen . Dadurch werden der analysierte Quellcode, zwischengespeicherte Einbettungen und Arbeitsbereichsverweise gelöscht. Lesen Sie die Datenschutz- und Datenverarbeitungsdokumentation von AnythingLLM, bevor Sie sensible Daten hinzufügen.
Sie benötigen außerdem ausreichend Arbeitsspeicher für Ihr gewähltes lokales Modell. Es gibt keine allgemeingültige optimale Modellgröße, da die nutzbare Geschwindigkeit von CPU, GPU, RAM bzw. VRAM, Quantisierung, Kontextlänge und der Anzahl der abgerufenen Dokumente abhängt. Beginnen Sie mit einem Modell, das gut passt, anstatt das größte Modell zu wählen, das Ihr System gerade noch laden kann.
Schritt 1: Ollama installieren und lokale Chat- und Einbettungsmodelle vorbereiten
Installieren Sie Ollama gemäß der aktuellen Anleitung für Ihr Betriebssystem. Ollama ist für macOS, Windows und Linux verfügbar und die lokale API wird standardmäßig über Port 11434 bereitgestellt. Die offizielle Ollama-Schnellstartanleitung ist die beste Quelle für aktuelle Installationshinweise und die Befehlssyntax.
Nach der Installation wählen Sie ein Chatmodell, das zu Ihrer Hardware passt. Das genaue Modell ist hier bewusst nicht festgelegt, da sich der Modellkatalog ändert und die Hardwareanforderungen variieren. Ein typischer Befehl sieht folgendermaßen aus:
ollama pull <chat-model-name>
Für RAG benötigen Sie außerdem ein Einbettungsmodell. Die aktuelle Dokumentation von Ollama zu Einbettungen (Stand: September 2026) listet Modelle wie beispielsweise embeddinggemma, qwen3-embeddingund all-minilmals empfohlene Einbettungsoptionen auf. Die vollständige Liste finden Sie in der Ollama-Dokumentation zu Einbettungen . Zum Beispiel:
ollama pull embeddinggemma
Verwenden Sie kein normales Chat-Modell als Einbettungsmodell, nur weil es in einer Modellauswahl angezeigt wird. Die aktuelle Dokumentation des Ollama-Einbetters von AnythingLLM warnt ausdrücklich davor, dass Ollama sowohl Chat-Modelle als auch Einbettungsmodelle in derselben Liste anzeigen kann. Verwenden Sie für die Dokumentenindizierung ein tatsächliches Einbettungsmodell. Weitere Informationen finden Sie in der AnythingLLM-Dokumentation zur Einrichtung des Ollama-Einbetters .
Beispielhafter Terminalablauf zum Abrufen eines lokalen Modells mit Ollama. Die in diesem Beispiel angezeigte Versionsnummer ist keine Empfehlung für die aktuelle Version; überprüfen Sie die installierte Version anhand der offiziellen Ollama-Dokumentation.
Für Jordans fiktives Szenario ist das Ziel in dieser Phase einfach: Sowohl die Generierung als auch die Einbettung sollten möglich sein, ohne die Haushaltsdokumente an eine entfernte API zu senden.
Schritt 2: AnythingLLM lokal mit persistentem Speicher ausführen und mit Ollama verbinden.
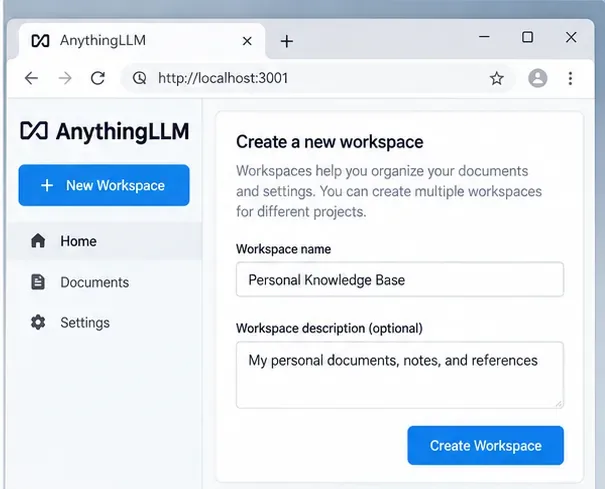
AnythingLLM bietet Desktop- und Self-Hosting-Optionen. Diese Anleitung verwendet Docker, da die Speichergrenzen klar definiert und die Datensicherung einfach ist. Die aktuelle lokale Docker-Dokumentation weist darauf hin, das Image herunterzuladen und betont, dass persistenter Speicher erforderlich ist, da sonst Anwendungsdaten beim Neuerstellen des Containers verloren gehen können. Die Webanwendung ist unter [URL einfügen] verfügbar http://localhost:3001. Verwenden Sie die offizielle lokale Docker-Anleitung von AnythingLLM, anstatt einen veralteten Befehl aus einem Forum zu kopieren.
docker pull mintplexlabs/anythingllm:latest
Beim Ausführen des Containers muss der Speicher von AnythingLLM gesichert werden, indem ein Hostverzeichnis eingebunden wird /app/server/storage. Die Dokumentation des Herstellers weist ausdrücklich auf die Notwendigkeit einer persistenten Einbindung hin. Dieses Speicherverzeichnis sollte sich auf einer Festplatte befinden, die in Ihrem Backup-Plan berücksichtigt ist.
Konfigurieren Sie anschließend den LLM-Provider als Ollama. Wenn AnythingLLM direkt auf dem Host ausgeführt wird, lautet die dokumentierte Standardadresse von Ollama: [Adresse einfügen http://127.0.0.1:11434]. Läuft AnythingLLM in einem Docker-Container, während Ollama auf dem Host ausgeführt wird, verwenden Sie nicht localhostdie Adresse innerhalb des Containers. Die Docker-Netzwerkdokumentation von AnythingLLM empfiehlt die Verwendung von [Adresse einfügen] http://host.docker.internal:11434auf unterstützten Desktop-Plattformen; unter Linux ist 172.17.0.1dieses Host-Verbindungsmuster dokumentiert. Weitere Informationen finden Sie im AnythingLLM-Hinweis zur lokalen Netzwerkverbindung und in der Ollama-LLM-Konfiguration .
Wählen Sie in den Einstellungen Ollama sowohl als LLM-Anbieter als auch, falls gewünscht, als Einbettungsanbieter aus. Wählen Sie das Chat-Modell für die Generierung und das Einbettungsmodell für die Indizierung. Durch die Trennung dieser Rollen vermeiden Sie einen häufigen Konfigurationsfehler.
AnythingLLM in selbstgehosteter Form läuft laut Dokumentation unter localhost:3001. Ein dedizierter Arbeitsbereich gibt einer Dokumentensammlung einen klaren Zweck und hält nicht verwandtes Material aus dem Abrufpool fern.
Jordan erstellt einen Arbeitsbereich namens „Persönliche Wissensdatenbank“ und vermeidet die Anbindung von Cloud-Modellanbietern. Dadurch lässt sich die beabsichtigte Grenze später leicht überprüfen: lokale Benutzeroberfläche, lokales LLM, lokale Einbettungen, lokale Vektoren.
Schritt 3: Dokumente hinzufügen, RAG-Format oder Volltext-Anhang auswählen und die Übernahme überprüfen
Laden Sie nicht gleich Ihr gesamtes Laufwerk hoch. Beginnen Sie mit einer kleinen, repräsentativen Auswahl an Dokumenten, deren Inhalt Sie gut kennen. So können Sie Extraktions- oder Abrufprobleme kontrolliert erkennen, bevor der Index wächst.
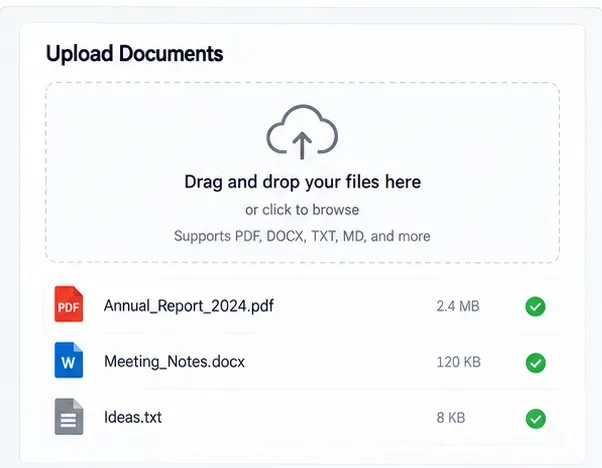
In Jordans Beispiel könnte ein erster sinnvoller Datensatz eine durchsuchbare PDF-Datei, eine DOCX-Datei und eine Klartext- oder Markdown-Notiz enthalten. Falls gescannte PDFs Bilder anstelle von auswählbarem Text enthalten, überprüfen Sie, ob der gewählte Dokumentenverarbeitungspfad den benötigten Text tatsächlich extrahiert. Eine Datei, die für Sie lesbar erscheint, kann dennoch eine leere oder fehlerhafte Textdarstellung für RAG erzeugen.
AnythingLLM unterstützt derzeit zwei grundlegende Dokumentverhaltensweisen:
Angehängte Dokumente: Nützlich, wenn der gesamte Text in das Kontextfenster des Modells passt und das Modell die vollständige Datei für diesen Thread sehen soll.
Eingebettete Dokumente mit RAG-Formatierung: nützlich für größere oder wiederverwendbare Sammlungen. Das System zerlegt den Inhalt in Abschnitte, bettet ihn ein und ruft die relevanten Teile für eine Frage ab.
Die aktuelle Dokumentation von AnythingLLM weist darauf hin, dass in einen Arbeitsbereich eingebettete Dokumente innerhalb dieses Arbeitsbereichs für alle Threads verfügbar sind. Das ist zwar praktisch, bedeutet aber auch, dass die Arbeitsbereichszugehörigkeit in Mehrbenutzerumgebungen Teil Ihres Datenschutzmodells ist. Trennen Sie daher persönliche Arbeitsbereiche von allen gemeinsam genutzten Arbeitsbereichen.
Beispielansicht für die Datenerfassung mit verschiedenen Dokumenttypen. Verwenden Sie zunächst einen kleinen, als funktionierend bekannten Batch und überprüfen Sie anschließend die Extraktion und Indizierung, bevor Sie ein großes Archiv hinzufügen.
Nach dem Einbetten wird eine Frage gestellt, deren Antwort nur in einer einzigen Datei vorkommt. Anschließend wird nach einem Detail gefragt, das in keiner Datei enthalten ist. Die erste Frage testet die Abruffähigkeit; die zweite testet, ob das Modell Unsicherheit zulässt, anstatt eine Antwort zu erfinden.
Was man optimieren sollte, wenn die Abrufleistung schwach ist
AnythingLLM bietet RAG-Steuerelemente auf Arbeitsbereichsebene, wie z. B. Suchpräferenzen, maximale Kontextausschnitte und Schwellenwerte für die Dokumentähnlichkeit. Die Dokumentation empfiehlt, mit den Arbeitsbereichseinstellungen zu beginnen, anstatt das Basismodell als Problem anzunehmen. Eine Erhöhung des abgerufenen Kontextes kann hilfreich sein, wenn die Antwort mehrere Abschnitte umfasst. Das Senden zu vieler Ausschnitte kann jedoch auch irrelevanten Text hinzufügen und die Kapazität des Kontextfensters erhöhen.
Wenn Sie die Einbettungsmodelle nach der Indizierung ändern, betten Sie die betroffenen Dokumente neu ein, damit die gespeicherten Vektoren und die Abfragevektoren aus demselben Einbettungsraum stammen. Das Mischen von Einbettungen aus verschiedenen Modellen ist keine sinnvolle Suchstrategie.
Schritt 4: Überprüfen Sie fundierte Antworten, gewährleisten Sie die Privatsphäre und sichern Sie die Wissensbasis.
Eine Wissensdatenbank ist nur dann nützlich, wenn man Fehler darin erkennen kann. Erstellen Sie eine kurze Bewertungsliste anhand von Fakten, die Sie direkt überprüfen können. Zum Beispiel:
Fragen Sie nach einem Datum, Betrag, Produktmodell oder einer Versicherungsklausel, die wortwörtlich in einem Dokument vorkommt.
Stellen Sie eine dokumentenübergreifende Frage, die Fakten aus zwei Dateien erfordert.
Stellen Sie eine absichtlich unbeantwortbare Frage und überprüfen Sie, ob die Antwort keine erfundene Quelle enthält.
Stellen Sie dieselbe Frage mit einer anderen Formulierung, um zu sehen, ob der Abruf stabil ist.
Öffnen Sie das Quelldokument und bestätigen Sie jede wichtige Aussage manuell.
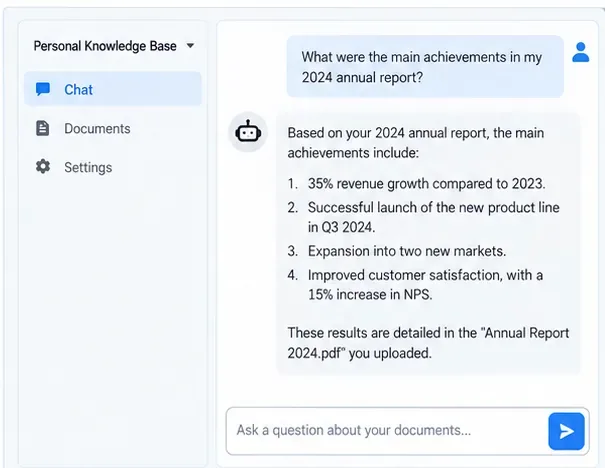
Eine hypothetische, dokumentenbasierte Antwort dient der Veranschaulichung des Verifizierungsschritts. Die gezeigten Daten sind fiktive Beispielinhalte; in einer realen Wissensdatenbank sollten wichtige Aussagen anhand der Originaldatei überprüft werden.
Für Jordan ist eine gute Annahmeregel nicht „Die Antwort klingt plausibel“, sondern „Die Antwort stimmt mit der Quelle überein, enthält den notwendigen Kontext und gilt als eindeutig falsch, wenn die Quelle die Information nicht enthält.“ Diese Regel ist besonders wichtig bei Steuern, Versicherungen, juristischen Dokumenten, Krankenakten oder finanziellen Entscheidungen.
Die Einrichtung sollte nach dem Funktionieren geheim bleiben.
Lokale Inferenz reduziert die Datenexposition, der Datenschutz hängt jedoch weiterhin von der Konfiguration ab. Nutzen Sie diese Kontrollmöglichkeiten als praktische Checkliste:
Halten Sie den AnythingLLM-Dienst an den lokalen Rechner oder ein vertrauenswürdiges privates Netzwerk gebunden, es sei denn, der Fernzugriff wird absichtlich gesichert.
Fügen Sie keine Cloud-LLM-, Cloud-Embedding-, Websuch-, Browser- oder Agentenintegrationen zu einem Arbeitsbereich hinzu, der sensible Daten enthält, es sei denn, Sie verstehen, welche Daten durch diese Integrationen übertragen werden.
Deaktivieren Sie die anonyme Telemetrie, wenn Ihre Datenschutzrichtlinie keinerlei Produkttelemetrie vorschreibt.
Nutzen Sie die Festplattenverschlüsselung und die Benutzerberechtigungen Ihres Betriebssystems. Eine lokale Vektordatenbank enthält weiterhin lesbare Daten, falls ein Angreifer Zugriff auf den Rechner erlangt.
Löschen Sie sensible Dateien aus der gesamten Dokumentenbibliothek, nicht nur aus einem Arbeitsbereich, wenn Sie eine vollständige Löschung innerhalb von AnythingLLM beabsichtigen.
Patchen Sie Ollama, AnythingLLM, Docker und das Host-Betriebssystem. „Offline“ sollte nicht „nie gewartet“ bedeuten.
Sichern Sie die Teile, die schwer nachzubilden sind.
Die Originaldokumente bleiben Ihre maßgebliche Datenquelle. Das AnythingLLM-Speicherverzeichnis enthält jedoch die Anwendungsdatenbank, die analysierten Dokumente, Vektordaten und Konfigurationen, die erforderlich sind, um nach einem Festplattenausfall eine vollständige Neuerstellung zu vermeiden. Sichern Sie sowohl den ursprünglichen Dokumentenordner als auch den persistenten Speicher von AnythingLLM. Wenn Sie Docker-Volumes anstelle eines eingebundenen Hostverzeichnisses verwenden, befolgen Sie die offizielle Docker- Dokumentation zur Volume-Sicherung und -Wiederherstellung .
Testen Sie die Wiederherstellung, nicht nur die Erstellung von Backups. Ein Backup ist erst dann gültig, wenn Sie es in einem anderen Verzeichnis oder auf einem anderen Rechner wiederherstellen, den lokalen Stack starten, den Arbeitsbereich öffnen und bekannte Daten korrekt abrufen können.
Wann diese Konfiguration gut passt – und wann nicht.
Diese Architektur eignet sich besonders gut, wenn Sie Ihre persönlichen Dokumente auf eigener Hardware speichern möchten, lokale Software bevorzugen und semantische Suche sowie natürlichsprachliche Antworten in einer überschaubaren Dokumentenbibliothek wünschen. Sie ist auch dann nützlich, wenn der Internetzugang unzuverlässig ist oder Sie nach dem Herunterladen der Modelle planbare lokale Kosten wünschen.
Weniger geeignet ist diese Lösung, wenn Ihr Computer kein adäquates lokales Modell ausführen kann, Sie nahtlosen Zugriff von vielen Geräten außerhalb Ihres Heimnetzwerks benötigen oder Funktionen wie Identitätsmanagement, Auditing, Legal Holds, zentrale Schlüsselverwaltung oder garantierten Support auf Unternehmensebene benötigen. In diesen Fällen ist eine verwaltete private Bereitstellung oder eine Enterprise-RAG-Plattform möglicherweise die bessere Wahl als eine Einzel-PC-Lösung.
Eine kompakte Checkliste für die Einrichtung
Installieren Sie Ollama und überprüfen Sie die lokale Modellinferenz.
Installieren Sie ein spezielles Einbettungsmodell, wie beispielsweise eines, das in der aktuellen Einbettungsdokumentation von Ollama aufgeführt ist.
AnythingLLM lokal mit persistentem Speicher ausführen.
Verbinden Sie AnythingLLM mit dem lokalen Ollama-Endpunkt unter Verwendung der korrekten Hostadresse für Ihre Bereitstellungsmethode.
Verwenden Sie eine lokale Vektordatenbank wie beispielsweise die standardmäßige LanceDB von AnythingLLM, wenn das Ziel der Abruf von Dokumenten ausschließlich lokal ist.
Erstellen Sie einen eng umrissenen Arbeitsbereich.
Beginnen Sie mit einigen bekannten Dokumenten und überprüfen Sie die Extraktion.
Verwenden Sie RAG für große, wiederverwendbare Sammlungen und die Volltextanhängigkeit nur dann, wenn das Dokument gut in den Modellkontext passt.
Prüfen Sie beantwortbare und unbeantwortbare Fragen, bevor Sie dem System vertrauen.
Deaktivieren Sie unnötige externe Integrationen und Telemetrie gemäß Ihren Datenschutzanforderungen.
Sichern Sie sowohl die Quelldokumente als auch den persistenten Anwendungsspeicher und testen Sie anschließend die Wiederherstellung.