Startseite
» Domänen
»
So beheben Sie den „API-Timeout-Fehler“ beim Ausführen von Multi-Agent-Workflows
So beheben Sie den „API-Timeout-Fehler“ beim Ausführen von Multi-Agent-Workflows
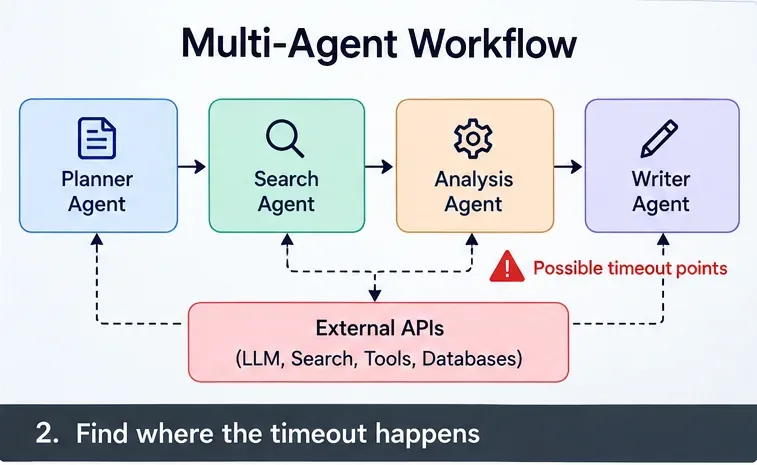
Ein „API-Timeout-Fehler“ in einem Multi-Agenten-Workflow lässt sich selten durch die Änderung einer einzelnen Zahl beheben. Ein Planer kann drei Agenten aufrufen, jeder Agent wiederum kann eine LLM-, Suchdienst-, Datenbank- oder Tool-API aufrufen, und jede Ebene kann ihr eigenes Timeout, ihre eigene Wiederholungsrichtlinie, ihren eigenen Verbindungspool und ihr eigenes Limit für gleichzeitige Aufrufe haben. Die praktische Lösung besteht darin, die Ebene zu identifizieren, bei der zuerst ein Timeout auftritt, und dann zwischen längeren Wartezeiten, weniger gleichzeitigen Aufrufen, intelligenteren Wiederholungsversuchen, einem kürzeren kritischen Pfad oder einem asynchronen Jobdesign zu wählen.
Der Kompromiss ist entscheidend: Ein erhöhtes Timeout ist zwar einfach zu handhaben, belegt aber länger Ressourcen; aggressive Wiederholungsversuche können Last und Kosten vervielfachen; eine geringere Parallelität verbessert die Stabilität, reduziert aber den Spitzendurchsatz; parallele Agenten verringern die Latenz nur dann, wenn die nachgelagerten Dienste die zusätzliche Lastverteilung aufnehmen können. Es gibt keine optimale Einstellung für jedes Multiagentensystem.
Welche Auszeit nimmst du eigentlich?
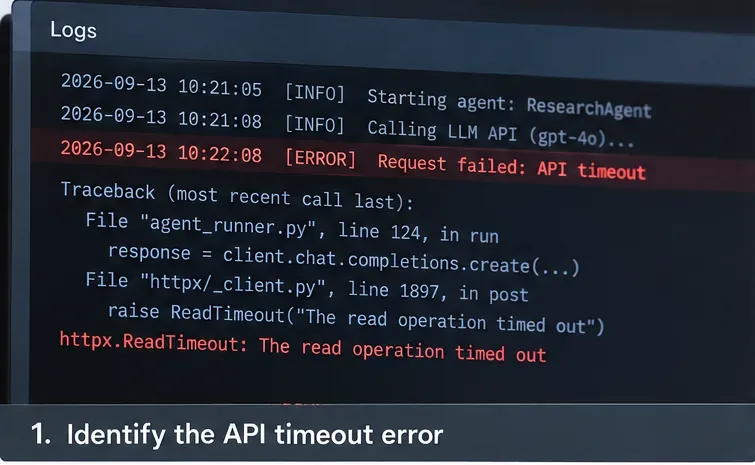
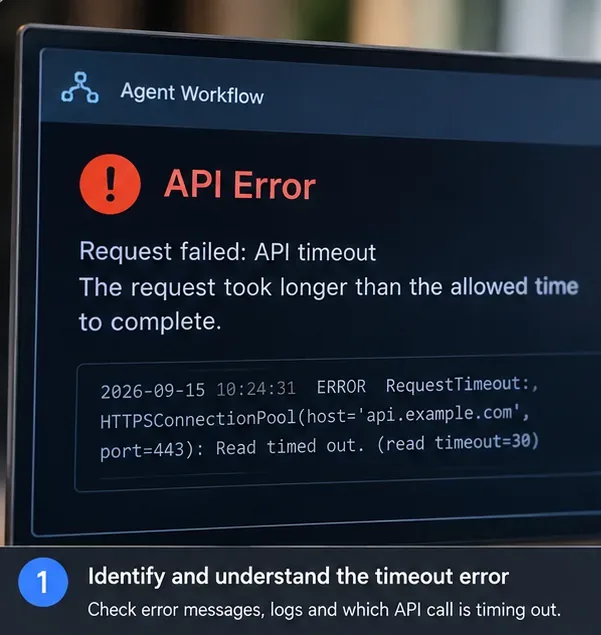
Beginnen Sie damit, den Fehler zu klassifizieren, anstatt jeden Timeout als dasselbe Ereignis zu behandeln. HTTP-Clients können beim Verbindungsaufbau, Lesen, Schreiben oder Warten auf eine Verbindung aus einem Pool einen Timeout auslösen. HTTPX dokumentiert beispielsweise vier verschiedene Timeout-Typen: Verbindungs-, Lese-, Schreib- und Pool-Timeout. Standardmäßig wird nach fünf Sekunden Netzwerk-Inaktivität ein Timeout ausgelöst, nicht unbedingt nach fünf Sekunden der gesamten Anfragedauer. Siehe die offizielle HTTPX-Timeout-Dokumentation .
Wenn Sie das OpenAI Python SDK verwenden, gibt die aktuelle offizielle README-Datei an, dass Anfragen standardmäßig ein Client-Timeout von 10 Minuten haben und Timeout-Fehler standardmäßig zweimal wiederholt werden. Das SDK wiederholt außerdem automatisch Verbindungsfehler sowie HTTP-408-, 409-, 429- und 5xx-Antworten mit einem kurzen exponentiellen Backoff. Dies sind SDK-Standardeinstellungen und keine Garantie dafür, dass jeder Proxy, Load Balancer, Gateway oder Orchestrator vor der Anfrage 10 Minuten wartet. Weitere Informationen finden Sie in der offiziellen README-Datei des OpenAI Python SDK .
Schritt 1: Erfassen Sie die genaue Ausnahme sowie den Agenten, den Endpunkt und die Transportschicht, bei denen ein Timeout aufgetreten ist, anstatt nur einen allgemeinen Workflow-Fehler zu protokollieren.
Welche Lösung sollten Sie wählen?
Option
Optimale Passform
Hauptvorteil
Hauptabwägung
Erhöhen Sie das Anfrage-Timeout
Gesunde, aber tatsächlich langsame Modell-/Tool-Aufrufe
Minimale Code- und Architekturänderungen
Worker und Verbindungen bleiben länger belegt; ein vorgelagertes Gateway kann die Anfrage möglicherweise zuerst ablehnen.
Stellt sich nach kurzzeitigen Ausfällen automatisch wieder her.
Kann Datenverkehr, Latenz und Kosten vervielfachen; unsicher für nicht-idempotente Aktionen, sofern nicht sorgfältig konzipiert.
Geringere Agentenkonkurrenz
429s, Pool-Timeouts, Downstream-Sättigung
Reduziert Lastspitzen und Warteschlangenkonflikte
Geringerer Spitzendurchsatz und mitunter längere Workflow-Abschlusszeit
Unabhängige Agenten parallelisieren
Sequenzielle Arbeitsabläufe mit unabhängigen Verzweigungen
Verkürzt den kritischen Pfad
Erhöht die Anzahl gleichzeitiger Anfragen und kann zu Raten- oder Verbindungsbegrenzungen führen.
Teilausgabe des Streams
Interaktive Benutzeroberfläche, bei der die Latenz des ersten Bytes entscheidend ist.
Die Nutzer sehen schneller Fortschritte.
Behebt nicht automatisch ein hartes Integrations-Timeout oder einen überlasteten nachgelagerten Dienst.
Arbeit in einen asynchronen Job/eine asynchrone Warteschlange verschieben
Arbeitsabläufe, die Dutzende von Sekunden oder Minuten dauern können.
Entkoppelt die Lebensdauer von HTTP-Anfragen von der Lebensdauer des Workflows.
Erfordert Jobstatus, Polling/Webhooks, Idempotenz, Persistenz und operative Überwachung.
Schritt 1: Ermitteln Sie die erste Ebene, die ihre Frist überschreitet.
Protokollieren Sie eine Korrelations-ID für den gesamten Workflow sowie eine Span- oder Child-ID für jeden Agenten- und Tool-Anruf. Erfassen Sie Startzeit, Endzeit, Endpunkt, Versuchsnummer, Ausnahmetyp, Antwortstatus (sofern verfügbar) und ob die Stornierung vom Anrufer oder vom nachgelagerten Dienst erfolgte.
Die entscheidende Frage ist: „Wer hat zuerst aufgehört zu warten?“ Wenn der LLM-Aufruf in 42 Sekunden abgeschlossen ist, ein API-Gateway aber nach 30 Sekunden aufgibt, ändert eine Erhöhung des LLM-Client-Timeouts von 60 auf 120 Sekunden nichts. Die aktuelle Dokumentation von Amazon für API-Gateway-HTTP-APIs gibt ein maximales Integrations-Timeout von 30 Sekunden an. Dies verdeutlicht, warum oft die kürzeste Frist in der Kette das Ergebnis bestimmt. Siehe Amazon API Gateway HTTP-API-Kontingente .
Schritt 2: Kartieren Sie den Anfragepfad und markieren Sie alle Stellen, die einen Aufruf beenden oder verzögern können: Orchestrator, Agent, Gateway, Modell-API, Such-API, Datenbank und Tool-Service.
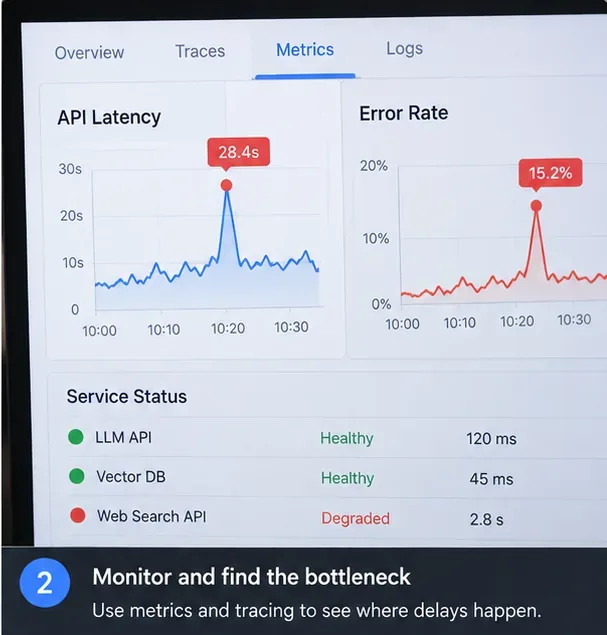
Schritt 2: Messen Sie den kritischen Pfad, nicht nur die durchschnittliche Latenz.
Die durchschnittliche Latenz kann niedrig erscheinen, während wenige langsame Aufrufe die meisten Workflow-Fehler verursachen. Erfassen Sie mindestens die Erfolgsrate pro Abhängigkeit sowie die Latenzwerte p50, p95 und p99. In der Fan-Out-Phase sollten Sie zusätzlich die Wartezeit in der Warteschlange und im Verbindungspool protokollieren, da eine „langsame API“ in Wirklichkeit ein überlasteter Client sein kann, der auf eine freie Verbindung wartet.
Anhand der Traces lassen sich drei praktische Fragen beantworten: Welche Abhängigkeit dominiert den kritischen Pfad? Laufen mehrere langsame Agenten sequenziell, obwohl sie gleichzeitig laufen könnten? Und stimmen die Spitzenwerte der Parallelität mit den Fehlern 429, Pool-Timeout oder 5xx überein?
Schritt 3: Vergleichen Sie Latenz, Fehler und Abhängigkeitsstatus miteinander; ein Timeout-Spitze, der mit einer beeinträchtigten Abhängigkeit zusammenfällt, deutet auf eine andere Lösung hin als eine systemweite Parallelitätsspitze.
Schritt 3: Erstellen Sie ein Timeout-Budget von außen nach innen
Legen Sie zunächst eine Frist für den gesamten Workflow fest und verkürzen Sie anschließend die internen Fristen, damit Fehler auf den unteren Ebenen frühzeitig erkannt werden und der Orchestrator sich erholen kann. Beispielsweise könnten bei einer nutzerseitigen Frist von 120 Sekunden 10 Sekunden für Orchestrierung und Antwortverarbeitung reserviert werden, sodass 110 Sekunden für die eigentliche Arbeit verbleiben. Ein einzelner Tool-Aufruf könnte 15 Sekunden erhalten, während ein Modellaufruf je nach beobachteter Latenz 45 oder 60 Sekunden erhalten könnte.
Diese Werte sollten nicht unreflektiert übernommen werden; sie dienen lediglich als Beispiel für eine Budgetierungsmethode und sind keine universellen Standardwerte. Wählen Sie Werte anhand Ihrer gemessenen Latenzverteilung und der Service-Level-Vereinbarung (SLO) Ihres Produkts. Die äußere Frist sollte ausreichend lang sein, um den inneren Aufruf, die zulässigen Wiederholungsversuche, die Wartezeiten und die Aufräumzeit zu berücksichtigen.
Python 3.11 und höher ermöglichen asyncio.timeout()das Festlegen einer Frist für asynchrone Aufgaben. Nach Ablauf der Frist wird die Aufgabe abgebrochen und der Kontextmanager gibt einen Timeout zurück TimeoutError. Weitere Informationen finden Sie in der offiziellen Python-Dokumentation zu asyncio-Timeouts .
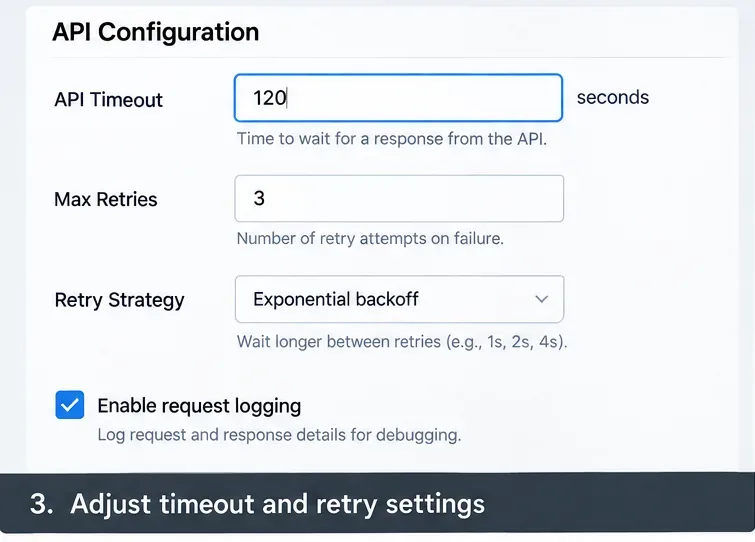
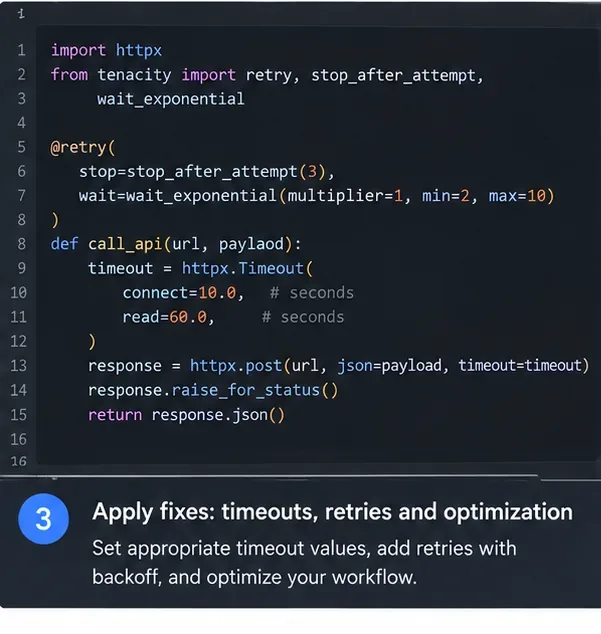
Schritt 4: Konfigurieren Sie Timeout- und Wiederholungswerte als koordiniertes Budget, anstatt jeden Wert unabhängig zu erhöhen.
Schritt 4: Begrenzen Sie die Anzahl gleichzeitiger Prozesse, bevor Sie die Anzahl der Wiederholungsversuche erhöhen.
Multiagentensysteme scheitern häufig, weil die Anzahl der Anfragen schneller ansteigt als erwartet. Wenn beispielsweise 20 Benutzeranfragen jeweils fünf Agenten starten und jeder Agent zwei Tools aufruft, kann das System bis zu 200 nachgelagerte Anfragen erzeugen, bevor Wiederholungsversuche unternommen werden. Werden Wiederholungsversuche zuerst durchgeführt, kann die Überlastung zu einer Flut von Wiederholungsversuchen führen.
Bei 429-Fehlern, Pool-Timeouts, steigender Wartezeit oder einer Sättigung einer nachgelagerten Abhängigkeit ist ein Parallelitätsbegrenzer oft der beste erste Schritt. Python asyncio.Semaphorebietet eine einfache, zählerbasierte Möglichkeit, die Anzahl der gleichzeitig in einen geschützten Abschnitt eintretenden Coroutinen zu begrenzen. Siehe die offizielle Python-Semaphor-Dokumentation .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
Dieser Kompromiss ist bewusst gewählt: Ein niedrigeres Limit schützt nachgelagerte Dienste, kann aber die Warteschlangenbildung innerhalb Ihrer Anwendung erhöhen. Optimieren Sie es anhand des Durchsatzes, der p95-Latenz, der Ratenbegrenzungen und der Kapazität des Verbindungspools, anstatt die höchste Zahl zu wählen, die Ihr System verarbeiten kann.
Schritt 5: Kombinieren Sie begrenzte Parallelität mit expliziten Transporteinstellungen, damit ein vollständiger Verbindungspool nicht als langsames Modell oder Werkzeug getarnt wird.
Schritt 5: Nur diejenigen fehlgeschlagenen Versuche wiederholen, die später wahrscheinlich erfolgreich sein werden.
Wiederholungsversuche sind sinnvoll bei vorübergehenden Verbindungsabbrüchen, Ratenbegrenzungen, bestimmten Serverfehlern und Anforderungszeitüberschreitungen, sofern die Wiederholung des Vorgangs sicher ist. Sie sind jedoch ein ungeeigneter Standard bei Validierungsfehlern, Authentifizierungsfehlern, Fehlern in deterministischen Tools oder Aktionen mit Nebenwirkungen ohne Idempotenzschutz.
Achten Sie auf die Multiplikation von Wiederholungsversuchen. Wenn ein SDK zwei Wiederholungsversuche unternimmt, bedeutet dies bis zu drei Versuche für einen logischen Aufruf. Wenn Ihre Agentenschicht den gesamten Aufruf ebenfalls zweimal wiederholt, erhöht sich das theoretische Maximum auf neun Versuche für diese eine logische Operation: drei äußere Versuche multipliziert mit drei SDK-Versuchen. Wenn der Orchestrator dann eine gesamte Stufe mit fünf Agenten wiederholt, kann das Anfragevolumen schnell ansteigen.
Zentralisieren Sie die Zuständigkeit für Wiederholungsversuche, wo immer möglich. Beachten Sie bei LLM-Aufrufen mit dem OpenAI Python SDK, dass das aktuelle SDK bestimmte Fehlerklassen standardmäßig bereits zweimal wiederholt. Fügen Sie einen äußeren Wiederholungsversuch nur dann hinzu, wenn ein konkreter Grund vorliegt und Sie das Gesamtbudget für Versuche begrenzen können. citeturn212133view0turn212133view1
Schritt 6: Klassifizieren Sie den Fehler, bevor Sie einen erneuten Versuch unternehmen; ein Lesetimeout kann einen begrenzten Wiederholungsversuch rechtfertigen, während dies bei einem permanenten Konfigurationsfehler in der Regel nicht der Fall ist.
Schritt 6: Verkürzen Sie den kritischen Pfad, ohne ein Fan-Out-Problem zu erzeugen
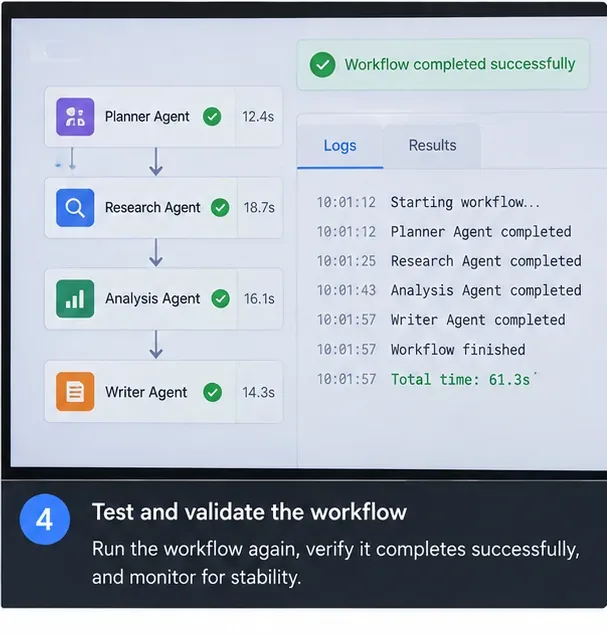
Wenn die Prozesse der Planung, Recherche, Bewertung und des Schreibens strikt nacheinander ablaufen, entspricht die Gesamtlatenz annähernd der Summe ihrer jeweiligen Dauer. Unabhängige Prozesse können jedoch mitunter parallel ausgeführt werden, wodurch sich die tatsächliche Latenzzeit eher auf den langsamsten Prozess als auf die Summe aller Prozesse reduziert.
Die TaskGroup in Python asyncio.TaskGroupbietet eine strukturierte Methode, um zusammengehörige Aufgaben parallel auszuführen. Die aktuelle Python-Dokumentation weist darauf hin, dass die TaskGroup auf die Aufgaben in der Gruppe wartet und die verbleibenden Aufgaben abbricht, wenn eine Aufgabe mit einer Ausnahme fehlschlägt, die nicht auf einen Abbruch zurückzuführen ist. Dies bietet ein sichereres Verhalten als die unstrukturierte Aufgabenerzeugung. Siehe die offizielle Python-Dokumentation zur TaskGroup .
Parallelisierung ist nicht kostenlos. Wenn derselbe Anbieter ein strenges Limit für Anfragen pro Minute oder gleichzeitige Anfragen vorschreibt, kann die gleichzeitige Ausführung von vier Agenten einen zwar langsamen, aber erfolgreichen Workflow in einen plötzlichen Anstieg von 429 Antworten verwandeln. Parallelisieren Sie nur wirklich unabhängige Arbeitsabläufe und behalten Sie die globale Begrenzung der Parallelität bei.
Schritt 7: Wann sollten Sie aufhören, synchrone HTTP-Anfragen zu verwenden?
Wenn normale Arbeitsabläufe regelmäßig die kürzeste Anfrage-Timeout-Zeit in Ihrem Netzwerkpfad überschreiten, ist der Wechsel zu einem asynchronen Jobmodell in der Regel eleganter als die kontinuierliche Verlängerung jedes Timeouts. Die initiale HTTP-Anfrage kann Eingaben validieren, einen dauerhaften Job erstellen und sofort eine Job-ID zurückgeben. Die Worker führen dann den Multi-Agenten-Graphen außerhalb des Anfragelebenszyklus aus, während der Client den Fortschritt per Polling, Server-Sent Events, WebSockets oder Webhook empfängt.
Streaming ist dann sinnvoll, wenn der Server frühzeitig aussagekräftige Ergebnisse senden kann. Das OpenAI Python SDK unterstützt beispielsweise Server-Sent-Event-Streaming für Responses-API-Aufrufe. Streaming verbessert die gefühlte Reaktionsfähigkeit und ermöglicht eine aktive Verbindung zur Datenproduktion, löst aber nicht automatisch das Problem der maximalen Anfragelebensdauer jedes Proxys. Weitere Informationen finden Sie in der offiziellen OpenAI-Referenz zu Streaming-Ereignissen .
Wählen Sie einen asynchronen Job, wenn Zuverlässigkeit wichtiger ist als unmittelbare Einfachheit: bei langen Rechercheaufgaben, Agenten-Workflows mit manueller Genehmigung, vielen Tool-Aufrufen, aufwändigen Operationen, die nicht wiederholt werden sollen, oder Workloads, die auch bei Verbindungsabbrüchen des Clients funktionieren müssen. Der Aufwand besteht in der zusätzlichen Zustandsverwaltung: Jobstatus, Prüfpunkte, Idempotenzschlüssel, Abbruch, Ergebnisspeicherung und Zuständigkeit für Wiederholungsversuche.
Schritt 7: Bei langen Arbeitsabläufen sollte der Abschluss der Agenten als dauerhafter Workflow-Status erfasst werden, anstatt sich darauf zu verlassen, dass eine Client-Verbindung so lange offen bleibt, bis alle Agenten fertig sind.
Schritt 8: Überprüfen Sie die Korrektur unter realistischer Last
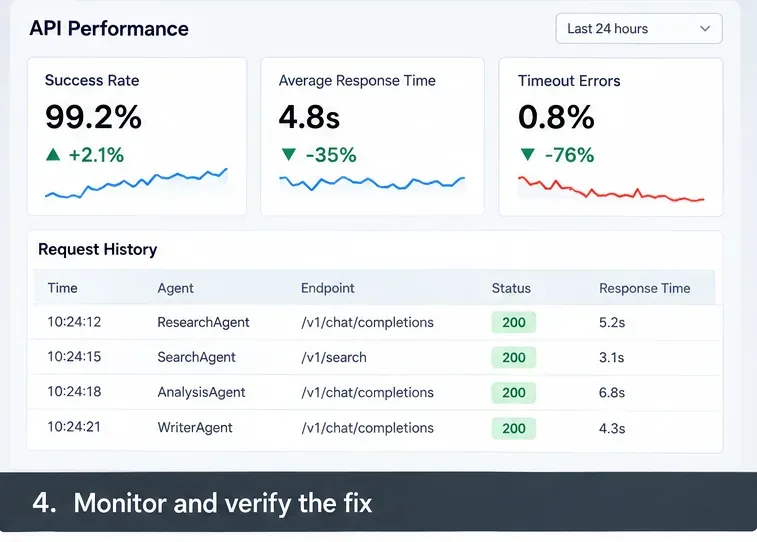
Eine erfolgreiche Fehlerbehebung ist nicht ausreichend. Testen Sie mit der in der Produktion erwarteten Parallelität und messen Sie Erfolgsrate, Timeout-Rate, Wiederholungsversuche pro logischer Aufgabe, Latenz (p95 und p99), Warteschlangenverzögerung, Wartezeit im Verbindungspool, Downstream-Fehlerraten (429/5xx) und Kosten pro abgeschlossenem Workflow.
Wenn Sie Agenten in Kubernetes ausführen, verwenden Sie Bereitschafts- und Lebendigkeitsprüfungen für unterschiedliche Zwecke. Kubernetes dokumentiert Bereitschaftsprüfungen als Mechanismus, der festlegt, ob ein Pod Datenverkehr empfangen soll, während Lebendigkeitsprüfungen bestimmen, wann ein Container neu gestartet werden soll. Die Dokumentation warnt ausdrücklich davor, dass schlecht implementierte Lebendigkeitsprüfungen unter Last zu kaskadierenden Fehlern führen können. Siehe die offizielle Kubernetes-Dokumentation zu Probes .
Bei vorübergehender Überlastung ist es oft sicherer, kurzzeitig nicht einsatzbereit zu sein, als gesunde, aber stark ausgelastete Mitarbeiter wiederholt zu schädigen. Ausfallzeiten sollten nur dann in Kauf genommen werden, wenn ein Neustart des Prozesses tatsächlich die richtige Maßnahme zur Wiederherstellung darstellt.
Schritt 8: Überprüfen Sie die Änderung anhand von produktionsnahen Datenverkehrs- und Latenzmetriken, nicht nur anhand eines einzelnen erfolgreichen Testlaufs.
Wie finden Sie heraus, welche Reparaturmethode für Ihr Fehlermuster die richtige ist?
Beobachtetes Muster
Die nützlichste erste Änderung
Was man zuerst nicht tun sollte
Die Anrufe enden kurz nach der Kundenfrist; die nachgelagerten Prozesse laufen reibungslos.
Erhöhen Sie das spezifische innere Timeout und passen Sie die Budgetierung der äußeren Frist an.
Erhöhung der Wiederholungsversuche
429-Fehler und Pool-Timeouts nehmen mit zunehmender Parallelität zu.
Verringere die Parallelität und füge Warteschlangen/Gegendruck hinzu
Starten Sie parallel weitere Agenten
Gelegentliche 408/5xx-Fehler oder Netzwerkausfälle
Verwenden Sie begrenzte exponentielle Backoff-Wiederholungsversuche für idempotente Operationen
Jede Ausnahme unbegrenzt wiederholen
Der Workflow dauert regelmäßig länger als die Gateway-Limits.
Verwenden Sie eine asynchrone Jobarchitektur oder ein unterstütztes Streaming-Design.
Erhöhen Sie immer nur das SDK-Timeout.
Eine langsame Abhängigkeit dominiert die p99-Latenz.
Optimieren, cachen, ersetzen oder isolieren Sie diese Abhängigkeit; erwägen Sie einen Ausweichplan.
Timeouts für nicht verwandte Agenten anpassen
Fehler treten erst nach dem Hinzufügen paralleler Agenten auf.
Die sinnvolle Parallelität soll beibehalten, aber ein globales Semaphor und anbieterspezifische Beschränkungen hinzugefügt werden.
Angenommen, parallel ist immer schneller
Eine praktische Produktionsgrundlage
Für eine typische Multi-Agenten-API ist eine robuste Basislösung, jedem Workflow eine Korrelations-ID zuzuweisen, jeden Agenten- und Tool-Aufruf zu verfolgen, eine End-to-End-Frist zu definieren, innerhalb dieser Frist kürzere Fristen pro Aufruf festzulegen, ein globales Parallelitätslimit pro Downstream-Provider durchzusetzen, Wiederholungsversuche begrenzt und idempotent zu halten und genügend Zustand zu speichern, um die Fortsetzung oder die Meldung einer teilweisen Fertigstellung zu ermöglichen.
Optimieren Sie das System anschließend anhand der Messwerte. Ist das System stabil, aber zu langsam, parallelisieren Sie gezielt unabhängige Arbeitsschritte. Ist es bei geringer Last schnell, versagt aber bei Spitzenlast, reduzieren Sie den Fan-Out und erhöhen Sie den Gegendruck. Dauern erfolgreiche Workflows naturgemäß länger als der synchrone Anfragepfad zulässt, wechseln Sie die Architektur, anstatt die Wartezeit jedes Proxys zu verlängern.