Startseite
» Domänen
»
Wie man benutzerdefinierte GPTs erstellt, die ihre Wissensdateien nicht vergessen
Wie man benutzerdefinierte GPTs erstellt, die ihre Wissensdateien nicht vergessen
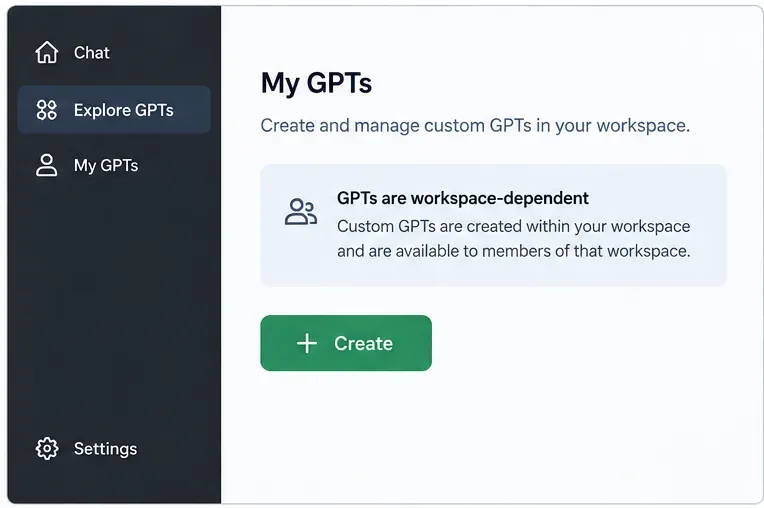
Aktueller Stand (Stand: 13. September 2026): Laut OpenAI können persönliche ChatGPT-Konten (Free, Go, Plus und Pro) keine neuen GPTs erstellen oder veröffentlichen. Bestehende GPTs können weiterhin verwendet und, sofern möglich, bearbeitet werden. In den Arbeitsbereichen Business, Enterprise und Edu hängt die Erstellung von den Arbeitsbereichseinstellungen und Berechtigungen ab. OpenAI gibt außerdem bekannt, dass benutzerdefinierte GPT-Workflows in Richtung Plugins migriert werden. Die Migration soll am 17. September 2026 abgeschlossen sein, die Abschaltung betroffener Enterprise-GPTs ist für den 11. Dezember 2026 geplant. Falls Sie dies später lesen, überprüfen Sie bitte den aktuellen Status in der OpenAI- Dokumentation zum Erstellen und Bearbeiten von GPTs, bevor Sie einen neuen Workflow erstellen.
Ein benutzerdefiniertes GPT, das eine Wissensdatei scheinbar „vergessen“ hat, hat die Datei in der Regel nicht verloren. Laut den FAQ zu Datei-Uploads von OpenAI bleiben als GPT-Wissen hochgeladene Dateien erhalten, bis das benutzerdefinierte GPT gelöscht wird. Das häufigere Problem ist der Abruf: Das Modell liest nicht unbedingt jede hochgeladene Datei vollständig für jede Frage. Es ruft Material ab, das für die Aufgabenstellung relevant erscheint. Daher beeinflussen Quellenqualität, Dateistruktur, Anweisungen und Tests, ob die richtige Passage angezeigt wird.
Außerdem sollte man „Wissen“ von „Gedächtnis“ unterscheiden. Die Dokumentation zu den GPTs in ChatGPT von OpenAI besagt, dass GPTs weder gespeicherte Informationen noch benutzerdefinierte Anweisungen oder vorherige Konversationen verwenden; jede Konversation beginnt von Neuem. Hochgeladenes Wissen ist daher eine konfigurierte Referenzquelle und kein Konversationsgedächtnis, das sich aus vorherigen Chats ansammelt.
So sollte ein zuverlässiges Ergebnis aussehen
Ziel ist es nicht, einen GPT dazu zu zwingen, bei jeder Frage eine Datei zu erwähnen. Vielmehr geht es darum, quellenbasierte Antworten stets auf dem richtigen Material zu gründen und unbegründete Fragen sicher zum Fehlschlagen zu bringen, anstatt eine sichere Vermutung zu erzeugen.
Qualitätssignal
Wie „gut“ aussieht
Wann sollte die Konfiguration geändert werden?
Richtigkeit
Die Antwort stimmt mit der maßgeblichen Datei zur geprüften Frage überein.
Wenn die Antwort trotz vorhandener Fakten falsch ist, vereinfachen Sie die Quelle oder präzisieren Sie die Aufgabenstellung.
Erdung
Die GPT kann auf Anfrage die zugehörige Datei oder den entsprechenden Abschnitt benennen.
Falls die Antwort auf Allgemeinwissen basiert, sollten die Anweisungen zur Quellenpriorität verstärkt und der Test wiederholt werden.
Enthaltung
Wenn die Dateien die Antwort nicht enthalten, gibt das GPT dies deutlich an.
Wenn es eine Richtlinie, einen Preis, ein Datum oder ein Verfahren erfindet, fügen Sie eine explizite Regel hinzu, die das Raten ausschließt.
Konsistenz
Äquivalente Formulierungen führen zu inhaltlich konsistenten Antworten.
Falls kleine Änderungen im Wortlaut größere Abweichungen verursachen, sollte die Mehrdeutigkeit sowohl in den Dateien als auch in den Anweisungen reduziert werden.
Aktualisierungsintegrität
Nach einer Überarbeitung des Quelltextes spiegeln die gleichen Bewertungsfragen den neuen Inhalt wider.
Falls die alten Ergebnisse weiterhin bestehen, überprüfen Sie, ob die aktualisierte Datei angehängt ist, speichern Sie die GPT-Datei und führen Sie die Tests erneut aus.
Acht Schritte für eine zuverlässigere Nutzung von Wissensdateien
1. Vergewissern Sie sich, dass Ihr Konto oder Arbeitsbereich weiterhin GPTs erstellen oder bearbeiten kann.
Prüfen Sie zunächst die Berechtigung, da ein fehlender „Erstellen“-Button möglicherweise ein erwartetes Verhalten und kein Browserproblem mehr ist. Laut den aktuellen Richtlinien von OpenAI für GPTs in ChatGPT ist die Erstellung neuer GPTs für persönliche Konten nicht möglich. Verwaltete Arbeitsbereiche können die GPT-Erstellung weiterhin basierend auf Administratorrichtlinien und Rollenberechtigungen ermöglichen. Wenn Sie bereits eine bestehende GPT besitzen, prüfen Sie, ob die Bearbeitung für Ihr Konto noch möglich ist.
In geeigneten verwalteten Arbeitsbereichen beginnen Sie im GPT-Bereich; die Verfügbarkeit hängt von den Arbeitsbereichsberechtigungen ab.
Verschwenden Sie keine Zeit mit der Fehlersuche bei der Wissensabfrage, bis Sie sicher sind, dass Sie mit einem unterstützten Editor arbeiten. Wenn Ihre Organisation bereits auf Plugins umstellt, betrachten Sie die verbleibenden benutzerdefinierten GPT-Dateien als Migrationskandidaten und nicht als neue langfristige Abhängigkeit.
2. Verhaltensanweisungen vom Wissen trennen.
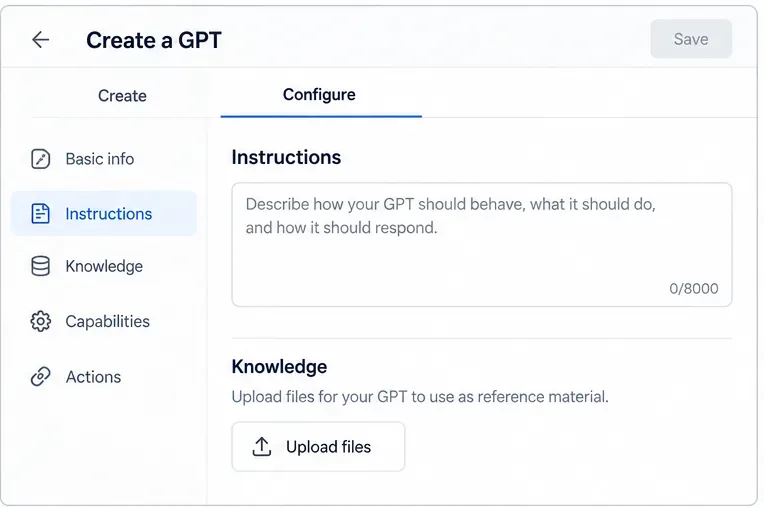
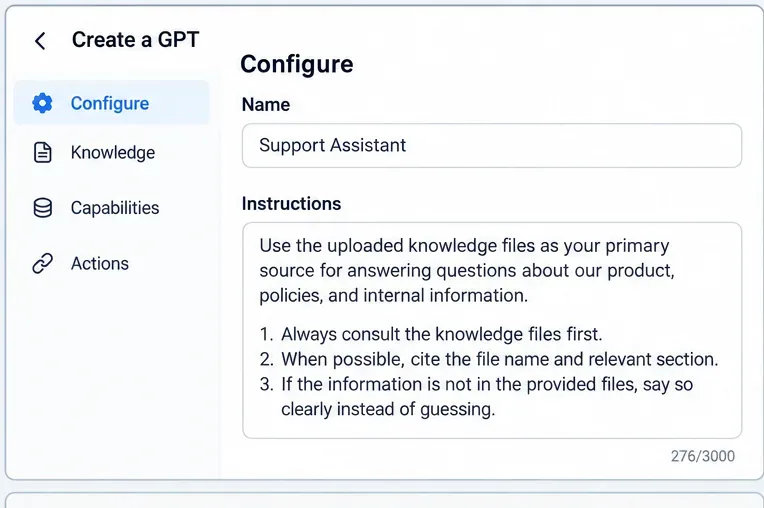
Verwenden Sie das Feld „Anweisungen“ für Regeln wie Tonfall, Entscheidungsreihenfolge, Zitationsformat, Eskalationsverhalten und das Vorgehen des GPT bei fehlenden Quellen. Verwenden Sie das Feld „Wissen“ für Referenzmaterialien wie Handbücher, Produktdokumentationen, Richtlinien, FAQs, Spezifikationen oder interne Leitfäden. OpenAI empfiehlt diese Trennung ausdrücklich, da Wissen am besten als Quellenmaterial geeignet ist, während Anweisungen das Verhalten definieren.
Verhaltensregeln finden sich in den Anweisungen, Referenzmaterialien im Wissensbereich.
Diese Unterscheidung ist für die Zuverlässigkeit wichtig. Ein Satz wie „Geben Sie niemals einen abgelaufenen Preis an“ gehört in die Anleitung. Die eigentliche Preistabelle gehört in den Wissensbereich. Regeln in einem umfangreichen Referenz-PDF zu vermischen, erschwert die Kontrolle und Überprüfung des Verhaltens.
3. Dateien für den Abruf vorbereiten, nicht nur für das menschliche Lesen.
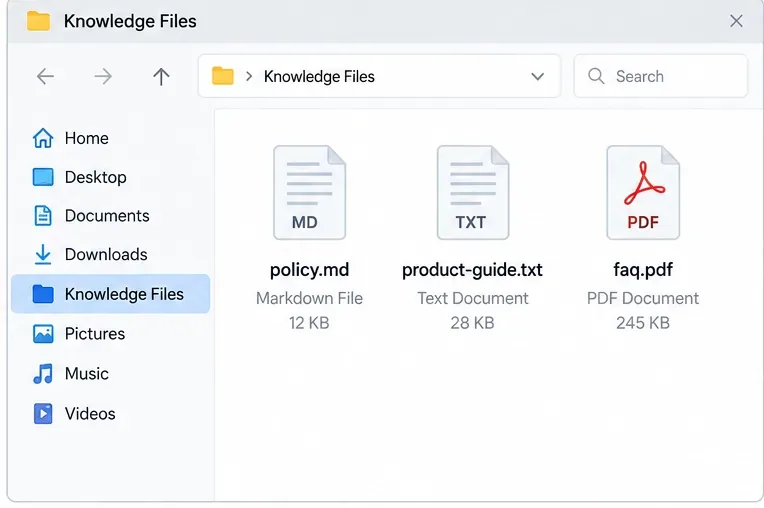
Bevorzugen Sie übersichtliche, textbasierte Dateien mit aussagekräftigen Überschriften, kurzen Abschnitten, einheitlicher Terminologie und eindeutigen Versionsdaten. Eine ansprechend gestaltete Broschüre kann weniger informativ sein als eine einfache Markdown- oder Textdatei, wenn die wichtigsten Informationen über Spalten, Hervorhebungen, Screenshots oder dekorative Layouts verstreut sind.
Textbasierte Dateien mit klaren Namen und einfacher Struktur lassen sich leichter und zuverlässiger abrufen.
Dies ist besonders wichtig für PDFs. Laut den FAQ von OpenAI zur visuellen Suche in PDFs werden als GPT-Wissen hochgeladene PDFs nur mit Textsuche verarbeitet. Das heißt, eine Tabelle, ein Diagramm oder ein Screenshot innerhalb der PDF-Datei sollte nicht die einzige Stelle sein, an der eine wichtige Regel existiert. Fügen Sie eine Texterklärung oder eine begleitende Textdatei hinzu.
Entfernen Sie außerdem veraltete Duplikate. Wenn in einer Datei eine Rückgabefrist von 14 Tagen und in einer anderen von 30 Tagen angegeben ist, kann die Abfrage beide Angaben anzeigen. Dateinamen wie „ returns-policy-2026-09.md “ und ein gut sichtbarer Hinweis auf das Gültigkeitsdatum erleichtern die Versionsprüfung.
4. Laden Sie einen kleinen, zusammenhängenden Wissensbestand hoch und überprüfen Sie ihn.
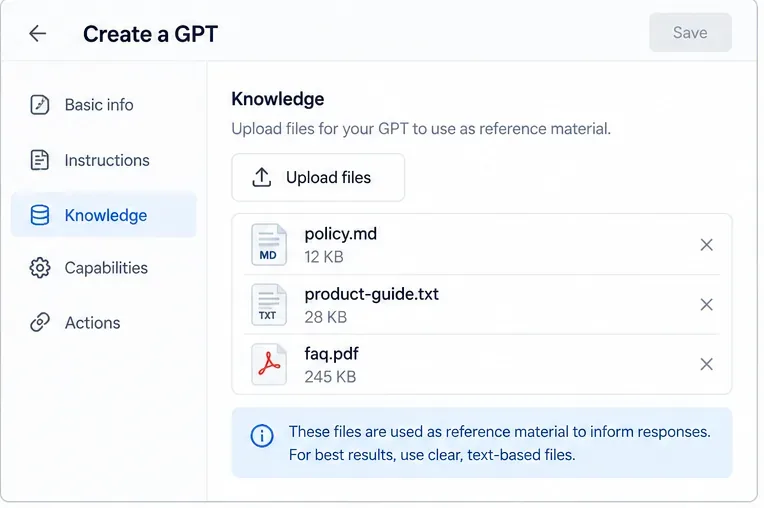
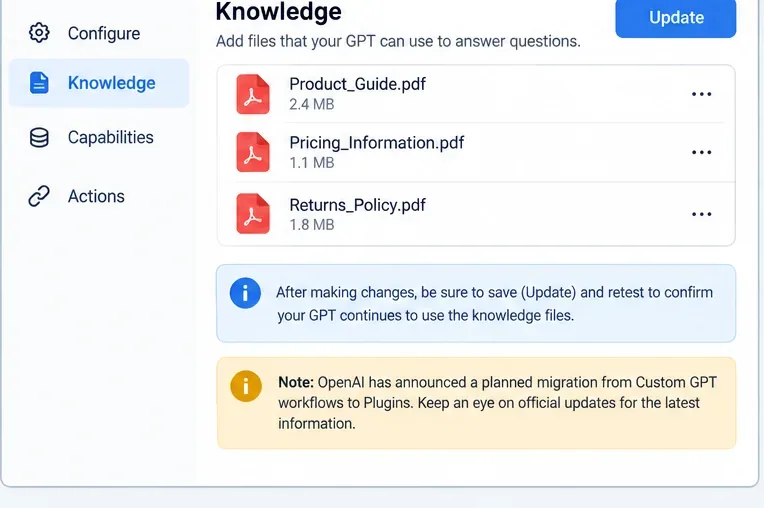
Laden Sie nur die Dateien hoch, die der GPT tatsächlich benötigt. OpenAI weist in seinen Richtlinien für Unternehmensdateien darauf hin, dass weniger, dafür aber zielgerichtetere Dokumente die Genauigkeit der dateibasierten Suche in der Regel verbessern. Überprüfen Sie nach dem Hochladen, ob alle erwarteten Dateien in der Wissensliste erscheinen, bevor Sie fortfahren.
Laden Sie den Referenzdatensatz hoch und überprüfen Sie anschließend, ob alle erwarteten Dateien vorhanden sind, bevor Sie mit dem Testen beginnen.
Aktuell besteht eine Inkonsistenz in der Dokumentation bezüglich der Dateianzahl. Laut Anleitung des GPT-Editors können bis zu 20 Dateien an eine GPT angehängt werden, während die FAQ zum Datei-Upload maximal 10 Dateien pro GPT für die gesamte Laufzeit dieser GPT angibt. Beide Dokumente nennen eine maximale Dateigröße von 512 MB, und die FAQ zum Datei-Upload gibt zusätzlich eine Obergrenze von 2 Millionen Token für Text- und Dokumentdateien an. Da die offiziellen Seiten hinsichtlich der Dateianzahl voneinander abweichen, sollten Sie kritische Workflows nicht auf der höheren Anzahl basieren lassen, ohne vorher den aktuellen Editor und die Dokumentation für Ihr Konto zu überprüfen.
5. Fügen Sie abruforientierte Anweisungen hinzu.
Verzichten Sie auf vage Anweisungen wie „Nutzen Sie die hochgeladenen Dateien“. Geben Sie an, wie vorzugehen ist, wenn eine Frage ein wissensbasiertes Fachgebiet betrifft. Ein praktisches Vorgehen ist: Konsultieren Sie zunächst das hochgeladene Wissen; ziehen Sie es bei unternehmensspezifischen Fakten dem allgemeinen Modellwissen vor; geben Sie nach Möglichkeit die entsprechende Datei oder den entsprechenden Abschnitt an; und weisen Sie darauf hin, dass die Informationen nicht verfügbar sind, wenn die Dateien keine Antwort liefern.
Abruforientierte Anweisungen sollten die Priorität der Quellen, das Zitationsverhalten und eine sichere Ausweichlösung definieren.
Die Fehlerbehebungshinweise von OpenAI empfehlen, bei Problemen mit der Wissensnutzung präzisere Eingabeaufforderungen zu verwenden, die direkter auf die angehängten Dokumente verweisen. Außerdem wird empfohlen, Regeln und Workflow-Verhalten in Anweisungen zu definieren, anstatt sie in hochgeladenen Dateien zu verstecken. Siehe Fehlerbehebung bei GPTs .
Vermeiden Sie widersprüchliche Anweisungen. „Beantworten Sie die Benutzeranfrage immer“ steht im Widerspruch zu „Beantworten Sie die Anfrage nur, wenn die Datei dies zulässt“. Ersetzen Sie diesen Widerspruch durch eine explizite Ausweichlösung, beispielsweise: „Wenn die Wissensdateien die benötigte Information nicht enthalten, weisen Sie darauf hin, dass die bereitgestellten Quellen die Antwort nicht liefern, und schlagen Sie den genehmigten nächsten Schritt vor.“
6. Führen Sie positive Erdungstests in der Vorschau durch.
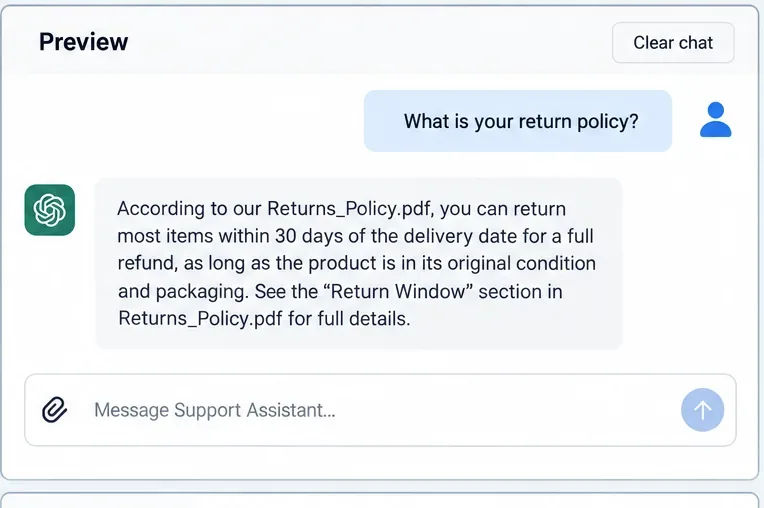
Testen Sie Fragen, deren richtige Antworten definitiv in den Dateien enthalten sind. Beschränken Sie sich nicht auf den einfachsten Satz von der ersten Seite. Stellen Sie Fragen, die das Abrufen verschiedener Abschnitte, das Erkennen alternativer Formulierungen und das Unterscheiden ähnlicher Richtlinien erfordern.
Ein positives Testergebnis liefert die richtige Antwort und identifiziert die zugehörige Datei oder den entsprechenden Abschnitt.
Für jeden Test sollten die erwartete Antwort, die erwartete Quelldatei und die Information, ob der GPT diese Quelle auf Anfrage zitiert oder identifiziert hat, protokolliert werden. Die Richtlinien der OpenAI Academy für benutzerdefinierte GPTs empfehlen, einen Evaluierungssatz von etwa 10 bis 15 repräsentativen Fragen mit korrekten Antworten zu erstellen. Dieser Umfang ist ausreichend, um wiederkehrende Fehlermuster aufzudecken, ohne dass jede Änderung zu einem umfangreichen Testprojekt wird.
Beurteilen Sie die Antwort danach, ob sie fundiert ist, nicht nur danach, ob sie flüssig klingt. Eine ausgefeilte Antwort mit der falschen Richtlinie ist unzureichend. Eine kürzere Antwort, die das maßgebliche Dokument korrekt zitiert, ist in der Regel das bessere Ergebnis.
7. Negative Tests durchführen und Tests umformulieren
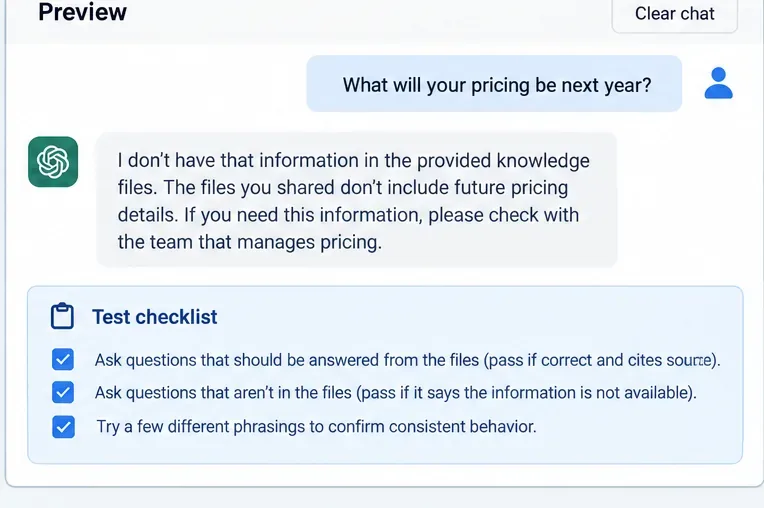
Ein zuverlässiger Wissensassistent muss seine Wissenslücken kennen. Stellen Sie Fragen, die bewusst nicht in den Unterlagen enthalten sind: ein zukünftiger Preis, eine noch nicht veröffentlichte Funktion, eine Richtlinie für ein Land, das nicht im Handbuch aufgeführt ist, oder ein Datum außerhalb des Geltungsbereichs des Dokuments. Das gewünschte Ergebnis ist eine klare Abgrenzung, keine plausible Neuerung.
Negative Tests sind wichtig: Der GPT sollte erkennen, wenn eine Antwort nicht in den Dateien vorhanden ist, und bei Umformulierungen konsistent bleiben.
Formulieren Sie anschließend einige positive und negative Fragen auf verschiedene Arten um. Wenn die Frage „Wie lange ist die Rückgabefrist?“ funktioniert, die Frage „Wie lange habe ich Zeit, es zurückzusenden?“ aber nicht, liegt das Problem möglicherweise eher an der Abdeckung der Datenabfrage als an fehlendem Wissen. Verbessern Sie Überschriften, Terminologie oder Anweisungen, bevor Sie weitere Dateien hinzufügen.
8. Versionsaktualisierungen, erneute Tests und das Erkennen, wann statisches Wissen das falsche Werkzeug ist.
Immer wenn Sie eine Quelle ändern, entfernen Sie die veraltete Version, fügen Sie die aktuelle Version hinzu, speichern oder aktualisieren Sie die GPT und führen Sie denselben Evaluierungssatz erneut aus. Ein kleines Änderungsprotokoll außerhalb der GPT kann Ihnen helfen festzustellen, ob eine Regression durch neue Anweisungen, eine ersetzte Quelle oder eine Plattformänderung verursacht wurde.
Nach Änderungen an Quelldateien oder Anweisungen speichern Sie die Aktualisierung und führen Sie denselben Evaluierungsprozess erneut aus.
Statisches Wissen hat seine Grenzen. Ändert sich die Quelle ständig, müssen die Zugriffsrechte den jeweiligen Benutzern entsprechen, oder benötigt der Assistent Echtzeit-Betriebsdaten, ist das wiederholte Hochladen von Dateien fehleranfällig. Die Apps von OpenAI mit synchronisierter Dokumentation beschreiben indizierte, verbundene Quellen, die unter Berücksichtigung der Quellberechtigungen stets aktuell bleiben. OpenAI treibt zudem die Entwicklung von benutzerdefinierten GPT-Workflows hin zu Plugins voran. Daher eignet sich eine sich häufig ändernde Wissensbasis eher für eine verbundene oder migrierte Architektur als für einen wachsenden Stapel statischer Dateien.
Wie man einen GPT diagnostiziert, der eine Datei immer noch „vergessen“
Wird eine bekannte Tatsache übersehen, prüfen Sie zunächst, ob diese Tatsache in einer angehängten, aktuellen Datei tatsächlich vorhanden ist. Stellen Sie anschließend eine präzisere Frage, die das Dokument oder Thema benennt. Falls die präzisere Frage zum Erfolg führt, verbessern Sie die Suchhinweise, indem Sie Überschriften vereinfachen, ein zu umfangreiches Dokument aufteilen oder konkurrierende Versionen entfernen. Sollte auch die präzisere Frage nicht zum Erfolg führen, wandeln Sie die relevanten Informationen in einen verständlicheren Text um und testen Sie erneut.
Beheben Sie nicht jeden Fehler sofort durch das Hinzufügen weiterer Anweisungen. Zu viele oder widersprüchliche Regeln können das Verhalten unvorhersehbarer machen. Fügen Sie ebenso wenig weitere Dateien hinzu, bevor Sie sicher sind, dass der bestehende Satz fehlerfrei ist. Das gewünschte Qualitätsmerkmal ist die Reproduzierbarkeit: Dieselbe kleine Testsuite sollte nach jeder Änderung erfolgreich durchlaufen, insbesondere bei risikoreichen Fragen zu Richtlinien, Recht, Preisgestaltung oder Betrieb.
Die praktische Grenze: Man kann die Abrufrate verbessern, aber nicht garantieren.
Keine Eingabeaufforderung kann ein generatives Modell dazu bringen, bei jeder Antwort mit absoluter Sicherheit alle Wissensdateien zu konsultieren. Ein zuverlässiger benutzerdefinierter GPT ist daher ein sorgfältig entwickelter Workflow und kein einmaliger Upload: fokussierte Quelldateien, explizite Anweisungen zur Quellpriorität, ein definiertes Absenzverhalten und wiederholbare Auswertung. Sollten diese Maßnahmen die benötigte Genauigkeit oder Aktualität nicht gewährleisten, ändern Sie die Architektur, anstatt die gleiche statische Konfiguration weiter zu optimieren.
Für geeignete GPTs kann dieser Prozess das Problem „Datei vergessen“ deutlich reduzieren. Bei neuen Projekten, die Ende 2026 begonnen werden, sollte die langfristige Entscheidung jedoch auch den angekündigten Übergang von OpenAI von benutzerdefinierten GPT-Workflows zu Plugins sowie die Verfügbarkeit vernetzter Wissensquellen berücksichtigen.