Startseite
» Domänen
»
Wie man die Antwortqualität von LLM-Kursen mithilfe von Evaluierungsrahmen misst
Wie man die Antwortqualität von LLM-Kursen mithilfe von Evaluierungsrahmen misst
Die zuverlässigste Methode zur Messung der Qualität von LLM-Antworten besteht darin, die Evaluierung als wiederholbares Testsystem und nicht als Einzelbewertung zu betrachten. Definieren Sie, was „gut“ für Ihre Anwendung bedeutet, erstellen Sie einen repräsentativen Evaluierungsdatensatz, kombinieren Sie deterministische Prüfungen mit modellbasierter und menschlicher Beurteilung, vergleichen Sie jede Änderungskandidatur mit einer Basislinie und prüfen Sie Fehler kategorienweise, bevor Sie die Anwendung veröffentlichen.
Dies ist wichtig, da ein LLM zwar ein scheinbar einwandfreies Ergebnis liefern kann, dieses aber dennoch falsch, unbegründet, unvollständig, unsicher oder nicht mit Ihren Anweisungen vereinbar ist. Ein hilfreiches Bewertungsframework wandelt diese vagen Bedenken in explizite Kriterien um, die nach einer Änderung der Eingabeaufforderung, einem Modell-Upgrade, einer Änderung der Datenabfrage, einem Tool-Update oder einer Überarbeitung der Sicherheitsrichtlinien erneut ausgeführt werden können.
Dokumentationshinweis: Die unten beschriebenen Framework-Funktionen wurden anhand der offiziellen Dokumentation vom 13. September 2026 überprüft. Da sich diese Tools schnell weiterentwickeln, sollten Sie die aktuellen APIs überprüfen, bevor Sie frameworkspezifischen Code in die Produktion übernehmen.
Was sollte man zuerst messen?
Beginnen Sie mit dem Fehler, der für Ihre Nutzer am relevantesten ist. Bei einem Bot für faktenbasierte Unterstützung sind Korrektheit und Richtlinienkonformität möglicherweise entscheidend. Bei der abfragegestützten Generierung (RAG) spielen Fundiertheit und Abfragequalität eine wichtige Rolle, da eine flüssige Antwort Fakten erfinden kann, die nicht durch den abgerufenen Kontext gestützt werden. Für einen Agenten reicht die Qualität der endgültigen Antwort nicht aus; Sie sollten auch die Werkzeugauswahl, die Werkzeugargumente, die Aufgabenerfüllung und unnötige Schritte bewerten.
Qualitätsdimension
Was es verlangt
Guter Evaluatortyp
Richtigkeit
Ist die Antwort faktisch oder logisch richtig?
Referenzvergleich, Codeprüfung, LLM-Gutachter oder menschliche Überprüfung
Anweisung folgen
Wurden die erforderlichen Nebenbedingungen vom Modell eingehalten?
Regelwerk plus bewertungsbasierter Richter
Erdung
Werden die Behauptungen durch den bereitgestellten Kontext gestützt?
RAG-spezifische Richter- oder Anspruchsprüfungen
Relevanz
Beantwortet die Antwort die eigentliche Frage, ohne vom Thema abzuweichen?
LLM-Richter oder menschliche Überprüfung
Formatkonformität
Ist die Ausgabe gültiges JSON, schemakonform oder anderweitig maschinenlesbar?
Deterministischer Code
Sicherheit und Richtlinien
Verstößt die Antwort gegen Ihre Bewerbungsrichtlinien?
Richtlinienprüfungen, LLM-Richter und gezielte menschliche Überprüfung
Effizienz
Welche Latenz, welchen Tokenverbrauch und welche Kosten erforderte die Antwort?
Telemetrie und Ortung
Diese Werte sollten nicht zu früh zu einem einzigen Wert zusammengefasst werden. Ein Kandidatenmodell, das zwar im Stil zwei Punkte gewinnt, aber auch nur wenige schwerwiegende Fehler in der Politik aufweist, könnte sich als schlechtere Lösung erweisen. Kritische Dimensionen sollten als separate Prüfpunkte sichtbar bleiben.
Ein vierstufiger Evaluierungsablauf, der rahmenübergreifend funktioniert
1. Erstellen Sie einen repräsentativen Evaluierungsdatensatz
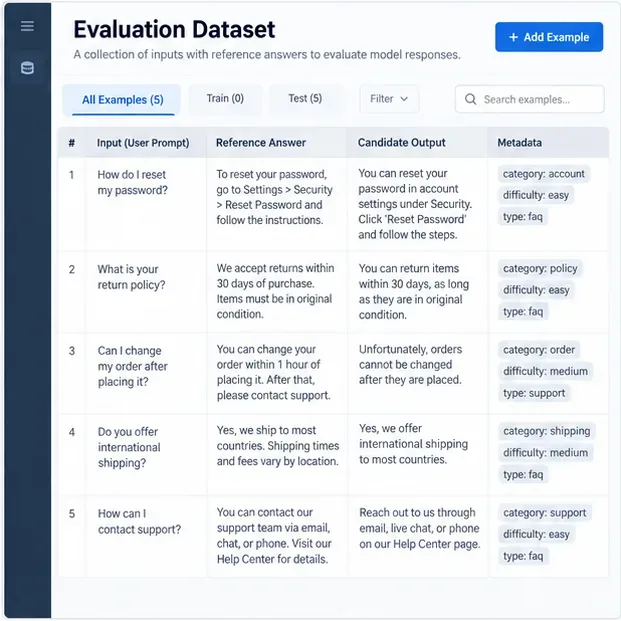
Ihr Datensatz sollte realistische Eingaben und, wenn möglich, erwartetes Verhalten enthalten. Einige Zeilen können exakte Referenzantworten enthalten; andere benötigen möglicherweise eine Rubrik anstelle eines einzelnen „Standardsatzes“. Fügen Sie Metadaten wie Aufgabentyp, Kundensegment, Sprache, Schwierigkeitsgrad, Abrufbedingungen oder Sicherheitskategorie hinzu, um die Ergebnisse später filtern zu können.
Stellen Sie sich beispielsweise einen Kundendienstmitarbeiter vor. Ein sinnvolles Testset sollte nicht nur einfache FAQ-Fragen enthalten. Es sollte auch mehrdeutige Anfragen, Ausnahmen von den Richtlinien, Fälle mit fehlendem Kontext, provokante Eingabeaufforderungen, mehrstufige Nachfragen und Beispiele umfassen, in denen das korrekte Verhalten darin besteht, mitzuteilen, dass die Antwort nicht ermittelt werden kann.
Die aktuellen Evaluierungsrichtlinien von LangSmith empfehlen, mit manuell zusammengestellten Beispielen zu beginnen, die gutes Verhalten veranschaulichen, und den Datensatz anschließend um historische Daten und im Produktivbetrieb aufgetretene Fehler zu erweitern. Das Evaluierungssystem unterstützt Datensätze mit Eingaben, optionalen Referenzausgaben und Metadaten. Weitere Informationen finden Sie in der Dokumentation zu den Evaluierungskonzepten von LangSmith .
Ein Evaluierungsdatensatz sollte realistische Eingabeaufforderungen mit Referenzen oder erwartetem Verhalten verknüpfen und Metadaten für eine spätere Fehleranalyse speichern.
Wann diese Vorgehensweise angebracht ist: fast immer. Selbst bei der Evaluierung im laufenden Betrieb benötigen Sie für Regressionstests einen stabilen Offline-Datensatz. Falls Sie für offene Aufgaben keine Referenzlösung haben, speichern Sie stattdessen eine Rubrik, erforderliche Fakten, verbotene Verhaltensweisen oder paarweise Präferenzen.
2. Ordnen Sie jede Qualitätsdimension dem richtigen Bewerter zu.
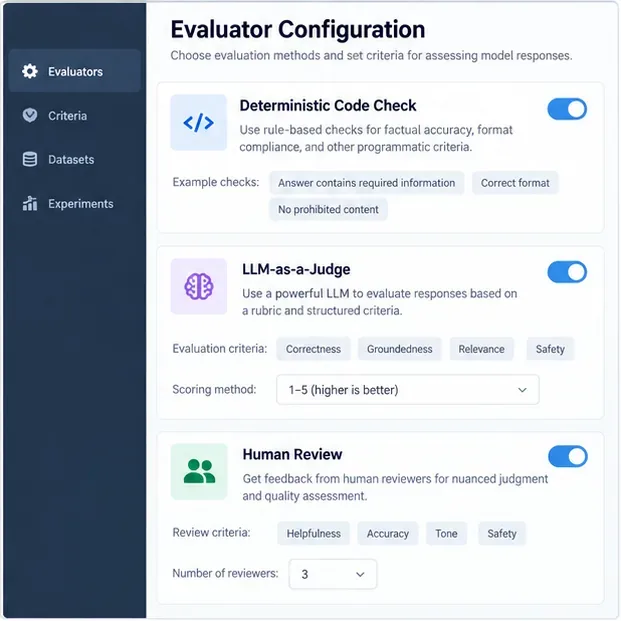
Die leistungsstärksten Bewertungssysteme kombinieren verschiedene Bewertungstypen, da kein einzelner Bewerter für jede Frage ideal ist.
Deterministische Prüfungen eignen sich am besten, wenn die Anforderung eindeutig ist: gültiges JSON, exakte Bezeichnungen, erforderliche Schlüssel, numerische Toleranz, Regex-Regeln oder ob ein Tool-Aufruf zulässige Argumente verwendet hat.
Referenzbasierte Metriken können hilfreich sein, wenn eine bekannte Antwort existiert, aber die Ähnlichkeit von Zeichenketten allein ist oft zu unzuverlässig für gültige Paraphrasen und zu nachsichtig gegenüber semantisch falschen Texten, die den gleichen Wortschatz verwenden.
LLM als Richter ist nützlich für Kriterien wie Vollständigkeit, Relevanz, Tonfall, Treue oder ob eine offene Antwort einer Rubrik entspricht.
Eine paarweise Auswertung ist dann sinnvoll, wenn es einfacher ist zu entscheiden, ob Kandidat A oder Basislinie B besser ist, als eine aussagekräftige absolute Punktzahl zu vergeben.
Die menschliche Überprüfung bleibt wichtig für die Kalibrierung automatisierter Bewertungssysteme, die Klärung subjektiver oder heikler Fälle und die Überprüfung, ob die Kennzahl selbst den Nutzen für den Nutzer widerspiegelt.
Die aktuelle Evals API von OpenAI definiert eine Evaluierung als Testkriterien plus Datenquellenschema und unterstützt wiederverwendbare Bewertungsalgorithmen. Die Grader-API umfasst deterministische String-Prüfungen, Textähnlichkeits-Grader und modellbasierte Grader; siehe die OpenAI Evals API-Referenz und die OpenAI-Grader-Referenz . Der Vertex AI Gen AI-Evaluierungsdienst von Google Cloud unterstützt punktweise und paarweise modellbasierte Metriken sowie rechenbasierte Metriken; die Ergebnisse können instanzspezifische Bewertungen, Erklärungen, aggregierte Mittelwerte, Standardabweichungen und paarweise Gewinnraten umfassen. Siehe die Dokumentation zu den Vertex AI-Evaluierungsergebnissen .
Wo immer möglich, sollten deterministische Regeln angewendet, auf Rubriken basierende LLM-Richter zur Beurteilung der semantischen Qualität hinzugefügt und eine menschliche Überprüfung zur Kalibrierung und für differenzierte Fälle bereitgestellt werden.
Wenn dieser Ansatz geeignet ist: Verwenden Sie deterministische Prüfungen für maschinenüberprüfbare Anforderungen, LLM-Richter für semantische Qualitäten und menschliche Experten, wenn Uneinigkeiten relevante geschäftliche oder sicherheitsrelevante Konsequenzen haben. Für ein RAG-System stellt Ragas Metriken wie Kontextpräzision, Kontextwiederholrate, Antwortrelevanz und -treue sowie Metriken zur Agenten-/Werkzeugnutzung bereit, darunter die Genauigkeit von Werkzeugaufrufen und die Genauigkeit der Agenten-Zielerreichung. Siehe die Dokumentation zu den Ragas-Metriken . DeepEval bietet ebenfalls aufgabenspezifische Metriken und benutzerdefinierte LLM-Richterbewertungen, einschließlich einer G-Eval-ähnlichen Bewertung; siehe die Dokumentation zu den DeepEval-Metriken .
3. Führen Sie denselben Datensatz gegen eine Basislinie und einen Kandidaten aus.
Absolute Werte sind zwar nützlich, aber Release-Entscheidungen lassen sich in der Regel besser treffen, wenn die neue Konfiguration mit der bereits bewährten Version getestet wird. Halten Sie Datensatz, Evaluatordefinitionen, Modellparameter und Sampling-Einstellungen so stabil wie möglich. Vergleichen Sie anschließend dieselben Beispiele direkt miteinander.
Erfassen Sie mindestens drei Ergebnisebenen:
Ergebnisse pro Beispiel: Welche konkreten Eingabeaufforderungen haben sich verbessert bzw. verschlechtert?
Ergebnisse pro Segment: Hat sich die Leistung bei Fragen mit langem Kontext, einer bestimmten Sprache, schwierigen Fällen, einer Produktkategorie oder bei gegnerischen Eingaben verändert?
Gesamtergebnisse: Wie haben sich Bestehensquote, Durchschnittspunktzahl, Latenz, Token-Nutzung, Kosten und Anzahl schwerwiegender Fehler entwickelt?
Bei nichtdeterministischen Systemen sollten wichtige Tests so oft wiederholt werden, dass die Variabilität verstanden wird, anstatt anzunehmen, ein einzelner Testlauf repräsentiere das Modell. Ist die Freigabeentscheidung wesentlich, sollten paarweise Vergleiche an denselben Beispielen durchgeführt und die Unsicherheit angegeben werden, anstatt sich lediglich auf eine geringfügige Änderung des Mittelwerts zu verlassen.
LangSmith unterstützt Offline-Experimente zum Vergleich von Versionen und paarweise Evaluatoren, während der aktuelle GenAI-Evaluierungsstack von MLflow Evaluierungsdatensätze, integrierte und benutzerdefinierte Bewertungsalgorithmen, LLM-Juroren, menschliches Feedback, Tracing und Produktionsüberwachung unterstützt. Siehe LangSmith-Evaluierung und MLflow LLM- und Agentenevaluierung .
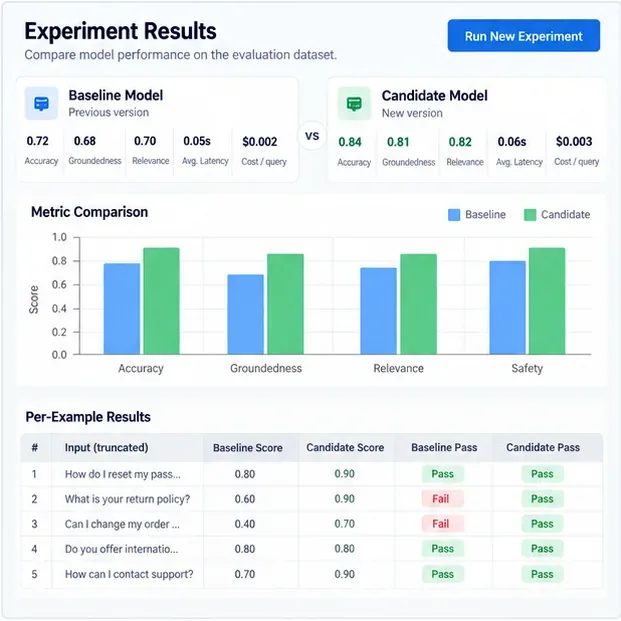
Vergleichen Sie einen Kandidaten mit der aktuellen Baseline anhand derselben Beispiele und prüfen Sie anschließend sowohl die aggregierten Metriken als auch die Ergebnisse (bestanden/nicht bestanden) pro Beispiel.
Dieser Ansatz ist immer dann angebracht, wenn Sie ein Modell, eine Systemabfrage, eine Abfragepipeline, eine Werkzeugimplementierung oder Dekodierungseinstellungen ändern. Ein Kandidat sollte nicht allein aufgrund einer Verbesserung einer aggregierten Metrik befördert werden; er muss die Freigabeschwellenwerte in kritischen Dimensionen erreichen und inakzeptable Regressionen auf Segmentebene vermeiden.
4. Fehler untersuchen, den Beurteilungsmechanismus kalibrieren und Regressionen in neue Tests umwandeln
Ein Evaluierungslauf ist nur dann sinnvoll, wenn er Ihr weiteres Vorgehen beeinflusst. Sortieren Sie Fehler nach Schweregrad und Ursache. Ein niedriger Wert für die Fundiertheit kann auf unzureichendes Erinnerungsvermögen, eine zum Raten verleitende Aufgabenstellung, einen zu vagen Bewertungsbogen oder eine falsche Referenzantwort zurückzuführen sein. Lesen Sie die zugrunde liegenden Beispiele, bevor Sie das Modell ändern.
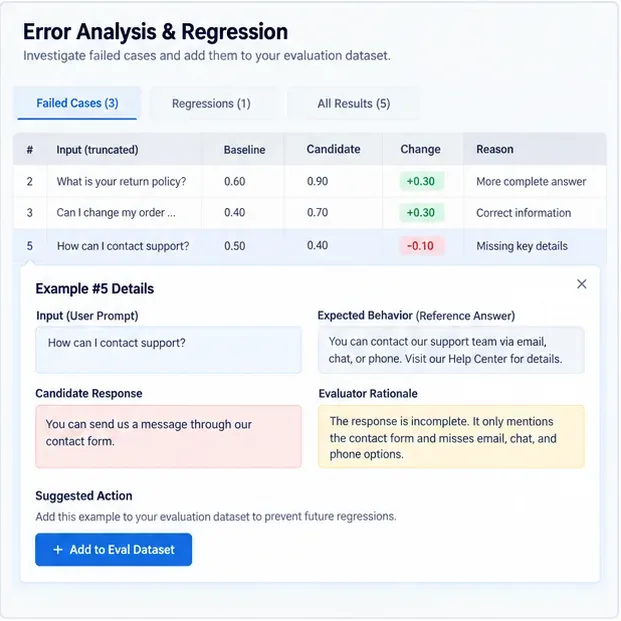
Wichtige Fehler werden dann zu permanenten Regressionsfällen. Dadurch entsteht ein positiver Kreislauf: In der Produktion wird ein Fehler aufgedeckt, ein Mitarbeiter bestätigt ihn, der Fall wird dem Offline-Datensatz hinzugefügt, die Korrektur wird anhand der gesamten Testsuite geprüft, und zukünftige Versionen können das gleiche Problem nicht mehr enthalten.
Auch LLM-Richter müssen evaluiert werden. Googles Dokumentation beschreibt explizit den Vergleich modellbasierter Metriken mit menschlichen Bewertungen, um festzustellen, ob der Richter für einen bestimmten Anwendungsfall geeignet ist. OpenAIs GDPval-Projekt verwendet ebenfalls die paarweise Bewertung durch Experten als primären Standard und beschreibt die automatisierte Bewertung als Annäherung, nicht als Ersatz für Expertenurteile. Siehe die Vertex AI-Richtlinien zur Evaluierung eines Richtermodells und die GDPval-Methodik von OpenAI .
Überprüfen Sie die tatsächlich fehlgeschlagenen Beispiele, vergewissern Sie sich, dass der Evaluator richtig urteilt, und fügen Sie wichtige Regressionen zum permanenten Testset hinzu.
Wann dieser Ansatz angebracht ist: immer bei schwerwiegenden Fehlern und immer dann, wenn ein LLM-Gutachter Einfluss auf einen Freigabeprozess nimmt. Wenn menschliche Gutachter wiederholt anderer Meinung sind als der Gutachter, sollte die Bewertungsmatrix angepasst, klarere Referenzen bereitgestellt, das Gutachtermodell geändert oder dieses Kriterium wieder der menschlichen Begutachtung unterzogen werden.
Wie zuverlässig ist ein LLM als Richter?
LLM-Gutachter sind so leistungsstark, weil sie offene Ergebnisse in einem Umfang bewerten können, der durch eine rein menschliche Begutachtung nicht erreicht wird. Die ursprüngliche G-Eval-Studie zeigte eine deutlich bessere Korrelation mit menschlichen Beurteilungen als herkömmliche automatische Metriken im untersuchten Kontext der Textzusammenfassung. Dieselbe Studie warnte jedoch davor, dass LLM-Gutachter von LLM generierte Texte bevorzugen könnten. Siehe die Originalstudie von G-Eval .
Separate Untersuchungen auf MT-Bench und Chatbot Arena ergaben, dass kompetente LLM-Beurteiler zwar gut mit menschlichen Präferenzen übereinstimmen, gleichzeitig aber auch Haltungs-, Rede-, Selbstdarstellungs- und Argumentationsverzerrungen dokumentieren. Siehe die Originalstudie „LLM als Beurteilungsinstrument“ .
Die praktische Schlussfolgerung lautet nicht „Verwenden Sie niemals LLM-Richter“. Vielmehr sollten Sie diese kalibrieren. Erstellen Sie eine von Menschen gekennzeichnete Stichprobe, messen Sie die Übereinstimmung, überprüfen Sie die Kategorien der Nichtübereinstimmung, randomisieren oder tauschen Sie die Antwortreihenfolge in paarweisen Tests, wenn Positionseffekte plausibel sind, und vermeiden Sie, dass dieselbe vage Richteranweisung stillschweigend jede Freigabeentscheidung bestimmt.
Welches Evaluierungsframework sollten Sie wählen?
Rahmen
Optimale Passform
Bemerkenswerte Stärke
OpenAI-Bewertungen und -Benoter
Teams, die bereits OpenAI-APIs nutzen und API-native Evaluierungsläufe wünschen.
Wiederverwendbare Bewertungsdefinitionen mit deterministischen und modellbasierten Benotungsmethoden
LangSmith
LLM-Anträge, die Tracing, Datensätze, Offline-Regressionstests und Online-Evaluierung erfordern
Starker Experimentvergleich und Produktionsrückkopplungsschleife
Ragas
RAG-Pipelines und Bewertung des Agenten-/Werkzeugeinsatzes
Zweckorientierte Abruf-, Zuverlässigkeits-, Relevanz- und Werkzeugmetriken
DeepEval
Python-zentrierte Teams, die testbasierte Evaluierungen und anpassbare LLM-Richter wünschen
Umfassender Metrikkatalog, Komponenten-/End-to-End-Bewertung und Agententrajektorienmetriken
MLflow GenAI-Evaluierung
Teams, die MLflow bereits nutzen oder Auswertungen mit Tracing und Lebenszyklusmanagement verknüpfen möchten
Datensätze, Bewertungskriterien, menschliches Feedback, Versuchsverfolgung und Produktionsüberwachung
Vertex AI Gen AI Evaluation
Google Cloud-Bereitstellungen
Punktweise, paarweise, modellbasierte und rechenbasierte Auswertungsabläufe
Die Wahl des Frameworks ist weniger wichtig als das Design der Evaluierung. Sie können eine schwache Evaluierungssuite auf einer komplexen Plattform oder eine starke mit wenigen Skripten erstellen. Bevorzugen Sie das Tool, das Ihre Tests reproduzierbar, versioniert, leicht überprüfbar und vor jeder wichtigen Änderung einfach ausführbar macht.
Eine praktische Bewertungstabelle für die Veröffentlichung
Für einen Produktionsassistenten kann eine sinnvolle Freigabeentscheidung als eine Reihe von Kriterien anstatt einer Gesamtbewertung ausgedrückt werden. Beispielsweise sollten folgende Kriterien gelten: keine kritischen Sicherheitsfehler im ausgewählten Sicherheitsset, keine statistisch signifikante Verschlechterung der Aufgabenkorrektheit, eine Mindestquote an bestandenen RAG-Fragen, gültige strukturierte Ausgabe in jedem Schemafall sowie Latenz oder Kosten innerhalb des Betriebskostenbudgets. Die genauen Schwellenwerte müssen sich aus der Risikotoleranz und den Benutzeranforderungen ergeben; es gibt keinen allgemeingültigen Prozentsatz, der ein LLM als „gut genug“ definiert.
Bewahren Sie auch die Rohdaten hinter der Bewertung auf. Wenn eine Version von 0,84 auf 0,86 springt, müssen Sie weiterhin wissen, welche beiden Fälle sich geändert haben und ob diese Änderungen relevant sind. In der Praxis lernen Teams mehr aus einer kleinen Anzahl klar kategorisierter Fehler als aus einem beeindruckenden Dashboard-Durchschnitt ohne Nachvollziehbarkeit.
Häufige Bewertungsfehler
Testen Sie nur die Normalfälle: Fügen Sie Mehrdeutigkeiten, Grenzfälle, Aufforderungs-Injection-Versuche, fehlenden Kontext und bekannte historische Fehler hinzu.
Exakte Übereinstimmung bei offenen Antwortmöglichkeiten verwenden: Die exakte Übereinstimmung sollte nur dann verwendet werden, wenn Genauigkeit wirklich erforderlich ist.
Sich auf einen LLM-Gutachter ohne Kalibrierung zu verlassen: Vergleichen Sie ihn mit menschlichen Beurteilungen und überprüfen Sie Unstimmigkeiten.
Den Durchschnitt optimieren und gleichzeitig schwerwiegende Fehler verbergen: Sicherheit, Richtlinien und andere kritische Dimensionen als explizite Kontrollpunkte beibehalten.
Ändern des Datensatzes während eines Modellvergleichs: Den Vergleichsdatensatz einfrieren oder versionieren, damit die Ergebnisse interpretierbar bleiben.
Ignorieren von Produktionsabweichungen: Offline-Evaluierungen schützen Releases; Online-Evaluierungen und stichprobenartige menschliche Überprüfungen decken neues Benutzerverhalten und neue Fehlermodi auf.
Fazit
Die Messung der Qualität von LLM-Antworten ist eine ingenieurwissenschaftliche Disziplin, keine reine Gefühlssache. Beginnen Sie mit einem repräsentativen Datensatz, definieren Sie aufgabenspezifische Qualitätsdimensionen, wählen Sie deterministische Prüfungen, wo immer die Anforderung berechnet werden kann, verwenden Sie LLM-Kritiker, wo semantische Beurteilungen erforderlich sind, kalibrieren Sie diese Kritiker mit menschlichen Prüfern und vergleichen Sie potenzielle Änderungen mit einer stabilen Basislinie. Nutzen Sie dann jeden wichtigen Fehler in der Praxis als Grundlage für einen zukünftigen Regressionstest.
Wenn Sie diesem Kreislauf folgen, wird das Evaluierungs-Framework mehr als nur ein Reporting-Dashboard: Es wird zum Qualitätskontrollsystem, das Ihnen mitteilt, ob eine Eingabeaufforderung, ein Modell, eine Abrufänderung oder ein Agenten-Update das Produkt tatsächlich verbessert hat.