Startseite
» Domänen
»
Wie man einen automatisierten Rechnungsverarbeitungsagenten mithilfe von Open-Source-KI erstellt
Wie man einen automatisierten Rechnungsverarbeitungsagenten mithilfe von Open-Source-KI erstellt
Ein automatisierter Rechnungsverarbeitungsagent muss nicht gleich ein großes, autonomes KI-System sein. Für eine erste, brauchbare Version kann man sich einen solchen Agenten als kontrollierten Software-Workflow vorstellen, der eine Rechnung empfängt, die entsprechenden Dokumenten- und KI-Tools aufruft, das Ergebnis validiert, entscheidet, ob eine manuelle Überprüfung erforderlich ist, und erst dann die freigegebenen Daten speichert oder exportiert.
Diese Unterscheidung ist im Finanzwesen wichtig. Ein Sprachmodell kann zwar helfen, unübersichtliche Rechnungsstrukturen in strukturierte Felder umzuwandeln, sollte aber nicht allein darüber entscheiden, ob eine Rechnung gültig oder sicher zu buchen ist. Das benutzerfreundliche Design dieses Leitfadens sorgt dafür, dass die Datenextraktion probabilistisch und die wichtigen Buchhaltungsprüfungen deterministisch erfolgen.
Am Ende verfügen Sie über einen lokalen Prototyp, der PDF- oder Bildrechnungen akzeptiert, Felder wie Lieferant, Rechnungsnummer, Datum, Währung, Summen und Einzelposten extrahiert, diese Felder anhand von Regeln validiert, fragwürdige Dokumente zur Überprüfung weiterleitet, einen Prüfpfad speichert und den Prozess über eine API zugänglich macht.
Was müssen Sie vor Beginn verstehen?
Es gibt vier Begriffe, die man kennen sollte:
OCR (optische Zeichenerkennung) wandelt in einem Bild oder Scan sichtbaren Text in maschinenlesbaren Text um.
Die Dokumentenanalyse erhält mehr Struktur als die einfache Texterkennung (OCR), wie z. B. die Lesereihenfolge, Tabellen, Überschriften und Layoutbereiche.
LLM (Large Language Model) kann variablen Rechnungstext in eine konsistente JSON-Struktur abbilden.
„Human-in-the-loop“ bedeutet, dass das System anhält und eine Person bittet, Fälle zu überprüfen, die die Prüfungen nicht bestehen, anstatt so zu tun, als sei jedes Ergebnis korrekt.
Stand September 2026 decken mehrere aktiv gepflegte Open-Source-Projekte diese Ebenen ab. Docling unterstützt PDF, Bild-, Office-Dokument- und andere Dokumentformate; PaddleOCR bietet OCR- und Dokumentenanalyse-Pipelines und wird unter der Apache-2.0-Lizenz veröffentlicht; und das Tesseract-Projekt dokumentiert seine aktuelle 5.x-Produktlinie als Open-Source-OCR-Engine im offiziellen Tesseract-Handbuch .
Für die lokale Modellinferenz beschreibt die Serverdokumentation von llama.cpp OpenAI-kompatible Endpunkte und schemabasierte JSON-Ausgabe. Dies macht es nützlich für einen Extraktionsdienst, da man ein lokal gehostetes Modell anweisen kann, ein definiertes Objekt anstelle von unstrukturiertem Text zurückzugeben.
Ein wichtiger Hinweis zur Lizenzierung: Eine Open-Source-Inferenz-Engine stellt nicht automatisch alle Modellgewichte als Open Source zur Verfügung. Prüfen Sie die Lizenz des jeweiligen Modell-Checkpoints, den Sie einsetzen, insbesondere bei kommerzieller Nutzung.
Welchen Stack sollte ein Anfänger verwenden?
Schicht
Praktische Wahl
Warum es hier ist
Dokumentenkonvertierung
Dokumentation
Konvertiert PDFs und Bilder in eine strukturierte Dokumentdarstellung und exportierbaren Text.
OCR-Fallback
PaddleOCR oder Tesseract
Nützlich, wenn es sich bei der Rechnung um einen Scan oder ein Foto handelt und die Textextraktion eine OCR erfordert.
Lokale KI-Extraktion
llama.cpp + ein geeignetes Befehlsmodell
Variable Rechnungstexte werden einem stabilen JSON-Schema zugeordnet, wobei die Inferenz lokal erfolgt.
Schema-Validierung
Pydantic
Validiert Python-Daten anhand der deklarierten Feldtypen und Einschränkungen.
API
FastAPI
Akzeptiert Rechnungs-Uploads und Ergebnisse der Retourenbearbeitung.
Lagerung
SQLite für einen Prototyp; PostgreSQL für einen gemeinsam genutzten Dienst
Speichert normalisierte Daten, Prüfstatus, Quelldateiidentität und Audit-Ereignisse.
Orchestrierung
Zuerst reines Python; LangGraph ist später optional.
Eine deterministische Funktion lässt sich leichter debuggen. Fügen Sie ein zustandsbehaftetes Agenten-Framework hinzu, wenn Verzweigungen und menschliche Überprüfung komplexer werden.
Die offizielle Dokumentation von Pydantic erklärt, dass Modelle von `Model` erben BaseModel, eingehende Daten validieren und JSON-Schemas über `Model` ausgeben können model_json_schema(). Siehe Pydantic-Modellvalidierung . Falls Sie später dauerhaftes, zustandsbehaftetes Branching benötigen, beschreibt die LangGraph-Referenz die Unterstützung für langlaufende zustandsbehaftete Agenten, Persistenz und Workflows mit menschlicher Interaktion.
Schritt 1: Projekt einrichten und ein eng gefasstes erstes Ziel definieren
Beginnen Sie nicht mit der Automatisierung der Kreditorenbuchhaltung. Konzentrieren Sie sich zunächst auf eine Dokumentenklasse und einen Ausgabevertrag. Ein gutes MVP (Minimum Viable Product) umfasst: englischsprachige Lieferantenrechnungen, PDF- oder Bildeingabe, eine juristische Person, einen Währungssatz und keine automatische Zahlungsabwicklung.
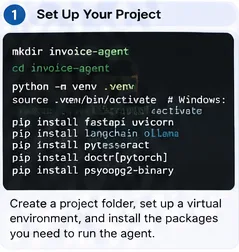
Installieren Sie Ihre OCR-Engine separat, falls erforderlich. Die aktuelle Installationsanleitung von Docling verwendet die Standardversion pip install docling; die aktuelle Installationsdokumentation von PaddleOCR unterscheidet das Basis-OCR-Paket von optionalen Abhängigkeitsgruppen für Dokumentenanalyse und Informationsextraktion. Verwenden Sie die Installationsanleitung von Docling oder die von PaddleOCR 3.x, anstatt eine alte Abhängigkeitsliste zu kopieren.
Schritt 1: Erstellen Sie zunächst ein kleines, isoliertes Python-Projekt. Halten Sie den ersten Rechnungstyp und das Ausgabeschema so einfach, dass Sie es gründlich testen können.
Schritt 2: Rechnungen in Text- und Layoutdaten umwandeln
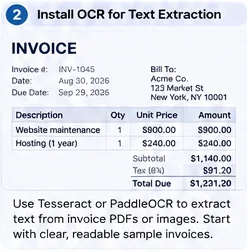
Digitale PDFs können bereits nutzbaren Text enthalten. Gescannte PDFs und Fotos benötigen OCR. Ihr Parser sollte diesen Unterschied vor dem Rest der Verarbeitungskette verbergen: Spätere Stufen sollten den normalisierten Dokumenttext sowie alle nützlichen Layout- oder Tabelleninformationen erhalten.
Eine minimale Docling-Konvertierung sieht folgendermaßen aus:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
Die offizielle Schnellstartanleitung von Docling verwendet dasselbe Konvertierungs- und Exportmuster. Bei Sammlungen mit hohem OCR-Anteil empfiehlt es sich, PaddleOCR oder Tesseract mit eigenen Scans zu testen. Die Projektdokumentation von PaddleOCR empfiehlt für die Dokumentenanalyse die neuere PP-StructureV3-Familie, während Tesseract für die OCR von gedrucktem Text über die Kommandozeile oder API aufgerufen werden kann.
Schritt 2: Beginnen Sie mit lesbaren Musterrechnungen, die die Felder enthalten, die Sie extrahieren möchten, und fügen Sie schwierigere Scans erst hinzu, nachdem die grundlegende Pipeline funktioniert.
Schritt 3: Legen Sie genau fest, welche Daten der Agent erzeugen darf.
Das Extraktionsschema bildet die Schnittstelle zwischen KI und Buchhaltungslogik. Vermeiden Sie ein riesiges Schema, das alles enthält, was auf einer Rechnung erscheinen könnte. Beginnen Sie mit Feldern, die Sie validieren können.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"Dies ist in diesem Zusammenhang hilfreich, da unerwartete LLM-Felder nicht unbemerkt in Ihre Buchhaltungsdaten gelangen sollten. Beachten Sie außerdem, dass die Pydantic-Validierung Struktur und Typen bestätigt; sie beweist jedoch nicht , dass der extrahierte Lieferant oder Betrag mit dem Rechnungsbild übereinstimmt.
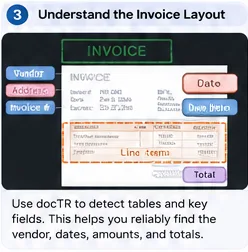
Schritt 3: Definieren Sie die Zielfelder anhand der Geschäftsanforderungen und verwenden Sie dann Layout- und Tabelleninformationen, um zu erhalten, woher diese Werte stammen.
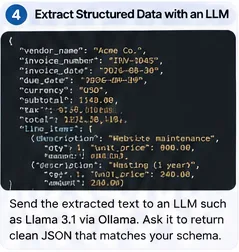
Schritt 4: Verwenden Sie ein lokales Modell, um Dokumenttext in strukturiertes JSON abzubilden
Führen Sie ein geeignetes Befehlsmodell hinter dem HTTP-Server von llama.cpp aus. Die genaue Modellgröße hängt von Ihrer Hardware und der Komplexität Ihrer Rechnungen ab. Gehen Sie nicht davon aus, dass ein größeres Modell automatisch besser ist; testen Sie Feldgenauigkeit, Latenz und Speicherverbrauch anhand Ihres eigenen Rechnungsdatensatzes.
llama.cpp unterstützt derzeit schemabasierte JSON-Antworten. Sie können dieses Schema von Pydantic ableiten und mit der Extraktionsanfrage senden:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
Die schemabasierte Generierung trägt zwar zu einer gültigen Struktur bei, garantiert aber keine semantische Korrektheit. Ein an sich gültiges JSON-Objekt kann dennoch eine falsche Summe enthalten. Daher ist der nächste Schritt zwingend erforderlich.
Schritt 4: Fordern Sie vom lokalen Modell ein streng strukturiertes Objekt an, keinen Freitext, damit die nachfolgende Validierung vorhersehbare Felder erhält.
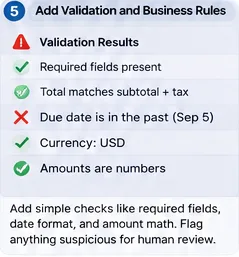
Schritt 5: Deterministische Buchhaltungsprüfungen und Überprüfungsregeln hinzufügen
Fragen Sie den LLM nicht: „Sind Sie zuversichtlich?“ und vertrauen Sie nicht einfach seiner Antwort. Selbstberichtete Modellzuversicht ist keine kalibrierte Kontrollmethode. Entwickeln Sie Prüfmechanismen, die anhand der extrahierten Daten und Ihrer Systeme neu berechnet werden können.
Nützliche erste Regeln sind unter anderem:
Pflichtfelder sind vorhanden;
Die Rechnungsnummer ist für denselben Lieferanten noch nicht erfasst;
Für diesen Händler oder diese Organisation ist die Währung zulässig;
Die Summe der Einzelposten ergibt annähernd die Zwischensumme;
Zwischensumme zuzüglich Steuern ergibt ungefähr den Gesamtbetrag;
Rechnungsdatum und Fälligkeitsdatum sind plausibel;
Der Lieferant ist in Ihren Lieferantenstammdaten vorhanden oder für das Onboarding vorgesehen;
Bestellreferenzen werden abgeglichen, wenn ein Bestellabgleich erforderlich ist.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Leiten Sie jede fehlgeschlagene Prüfung an eine Prüfwarteschlange weiter. Bei der ersten Implementierung ist es sinnvoll, alle Rechnungen zur Prüfung weiterzuleiten, während Sie die Qualität der Datenextraktion messen. Automatisierungsschwellenwerte sollten auf den in Ihren eigenen gekennzeichneten Rechnungen gesammelten Daten basieren und nicht auf einem allgemeinen Prozentsatz, der aus einem anderen System kopiert wurde.
Schritt 5: Arithmetische Prüfungen, Duplikaterkennung, Lieferantenabgleich und Datumsregeln werden als deterministische Kontrollen behandelt; Ausnahmen werden an eine Person weitergeleitet.
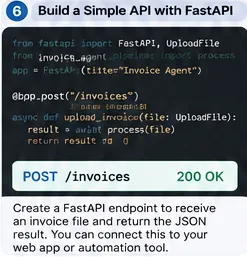
Schritt 6: Den Prozessor in eine kleine API einbetten
Eine API ermöglicht es Upload-Formularen, E-Mail-Prozessen, Ordnerüberwachungen oder Buchhaltungsintegrationen, dieselbe Verarbeitungsfunktion aufzurufen. Die offizielle Anleitung von FastAPI zum Datei-Upload empfiehlt UploadFiledie Verwendung einer Spool-Datei für hochgeladene Dateien, da diese besser geeignet ist als das vollständige Laden großer Dateien in den Arbeitsspeicher.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Die unterstützten Upload-Muster finden Sie in der aktuellen FastAPI-Dokumentation zu Anfragedateien . Im Produktivbetrieb sollten Sie außerdem Dateigrößenbeschränkungen, gegebenenfalls Malware-Scans, authentifizierte Aufrufer, Anfrage-IDs und die sichere Bereinigung temporärer Dateien durchsetzen.
Schritt 6: Stellen Sie einen Verarbeitungsendpunkt bereit, nachdem die lokale Pipeline funktioniert hat, damit mehrere Eingabekanäle denselben Validierungspfad wiederverwenden können.
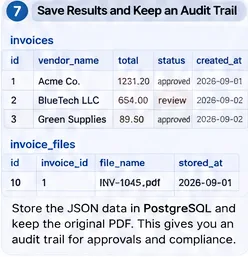
Schritt 7: Speichern Sie die Originalnachweise, das normalisierte Ergebnis und die Prüfereignisse.
Speichern Sie niemals nur das endgültige JSON. Bewahren Sie genügend Beweise auf, um den Vorgang rekonstruieren zu können: Identität der Originaldatei, Hashwert, Parserversion, Modellkennung, Eingabeaufforderungsversion, extrahiertes JSON, Validierungsergebnisse, Entscheidung der Überprüfung, Zeitstempel und den Benutzer oder Dienst, der eine Änderung genehmigt hat.
Ein einfacher Prototyp kann SQLite verwenden. Ein Mehrbenutzerdienst kann PostgreSQL mit Eindeutigkeits- und Fremdschlüsselbeschränkungen nutzen. Die aktuelle Dokumentation von PostgreSQL behandelt Tabellenbeschränkungen , die nützlich sind, um Schlüssel und Beziehungen unabhängig von der KI-Pipeline zu schützen.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
Der Quell-Hash bietet eine zweite Möglichkeit, versehentliche Wiedereinreichungen zu erkennen. Die Dateispeicherberechtigungen sollten strenger sein als für allgemeine Anwendungsprotokolle, da Rechnungen häufig Adressen, Bankverbindungen, Steueridentifikationsnummern und andere geschäftskritische Daten enthalten.
Schritt 7: Speichern Sie sowohl die normalisierten Rechnungsdaten als auch die Metadaten der Quelldatei, damit Genehmigungen, Duplikate und spätere Korrekturen nachvollziehbar bleiben.
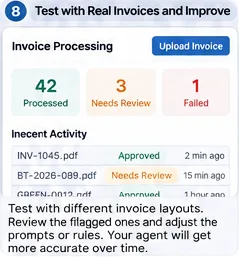
Schritt 8: Testen Sie mit einer realen Rechnungsvariante, bevor Sie nachgelagerte Aktionen automatisieren.
Ein Prototyp, der mit fünf sauberen PDFs funktioniert, ist noch nicht produktionsreif. Erstellen Sie einen beschrifteten Testdatensatz, der die tatsächlich eingehenden Eingaben widerspiegelt: verschiedene Lieferanten, Scans, gedrehte Seiten, kleine Schriftarten, mehrseitige Rechnungen, Rabatte, negative Zeilen, Steuern, Versandkosten, verschiedene Währungen, fehlende Bestellungen und doppelte Einreichungen.
Erfassen Sie Kennzahlen auf Feldebene separat. Die „Rechnungsgenauigkeit“ kann verschleiern, dass der Name des Lieferanten zwar leicht zu ermitteln ist, die Mengenangaben der einzelnen Positionen jedoch unzuverlässig sind. Messen Sie mindestens Folgendes:
Exakte Übereinstimmung von Rechnungsnummer, Währung und Datum;
Genauigkeit der numerischen Toleranz für Zwischensumme, Steuer und Gesamtsumme;
Genauigkeit und Trefferquote der einzelnen Positionen, falls die einzelnen Positionen im weiteren Verlauf relevant sind;
Prozentsatz, der zur menschlichen Überprüfung weitergeleitet wird;
Fehlerhafte automatische Genehmigungsrate;
Verarbeitungslatenz und Fehlerrate;
Präzision der Duplikaterkennung.
Speichern Sie Fehler als Testfälle. Führen Sie nach jeder Korrektur einer Parserregel, einer Eingabeaufforderung, eines Schemas oder eines Modells den gesamten Evaluierungsprozess erneut aus. Dadurch wird verhindert, dass Verbesserungen eines Anbieters unbemerkt das Layout eines anderen Anbieters beeinträchtigen.
Schritt 8: Messen Sie die Prüfwarteschlange und die Fehlerfälle anhand repräsentativer Rechnungen, bevor Sie dem Agenten erlauben, nachgelagerte Buchhaltungsvorgänge zu automatisieren.
Wie soll der Agent entscheiden, wie es weitergeht?
Die Zustandsmaschine sollte explizit dargestellt werden. Der „Agent“ kann zunächst eine einfache Python-Funktion sein:
Dies ähnelt bereits einem Agenten, da es Werkzeuge koordiniert und einen Zweig auswählt. Sie benötigen kein LLM, um jeden nächsten Schritt festzulegen. Fügen Sie LangGraph oder ein anderes Orchestrierungsframework hinzu, wenn Sie persistente mehrstufige Überprüfungen, Wiederholungsversuche, asynchrone Rückrufe oder mehrere spezialisierte Werkzeuge benötigen, deren Ausführungsreihenfolge sich je nach Fall ändert.
Welche Fehler sollten Anfänger vermeiden?
Die LLM-Prüfung soll die Buchhaltungskontrolle übernehmen
Das Modell sollte extrahieren und normalisieren; Code und Daten aus vertrauenswürdigen Systemen sollten verifiziert werden. Arithmetische Operationen, Duplikatsprüfungen, Lieferantenstatus, Bestellabgleich und Genehmigungslimits gehören zur deterministischen Logik.
Das Quelldokument wird nach der Extraktion verworfen.
Bewahren Sie die Originalrechnung oder einen entsprechenden Beleg auf. Prüfer benötigen Nachweise, und Sie benötigen eine Möglichkeit, Fehler nach Modell- oder Parser-Aktualisierungen zu reproduzieren.
Verwendung einer Eingabeaufforderung ohne Version
Speichern Sie zu jeder verarbeiteten Rechnung eine Versionsnummer und eine Modellkennung. Andernfalls können Sie nicht erklären, warum sich zwei Rechnungen, die in einem Abstand von mehreren Monaten verarbeitet wurden, unterschiedlich verhalten haben.
Die Gültigkeit von JSON-Daten ist nicht gleichbedeutend mit der Gültigkeit von Rechnungen. Beginnen Sie mit einer manuellen Prüfung und automatisieren Sie erst dann Fälle mit geringem Risiko, wenn Ihre Bewertung eine zufriedenstellende Leistung ergibt.
Modell- und Datenlizenzen werden ignoriert
Bibliotheken und Modellgewichte können unterschiedliche Lizenzen haben. PaddleOCR und Tesseract veröffentlichen Open-Source-Lizenzen, während die Lizenz des Modells, das Sie über llama.cpp ausführen, vom jeweiligen Prüfpunkt abhängt. Überprüfen Sie dies vor der Bereitstellung.
Die Benutzeroberfläche wird erstellt, bevor die Extraktionsqualität nachgewiesen wird.
Ein perfekt gestaltetes Dashboard kann fehlerhafte Beträge nicht ausgleichen. Testen Sie zuerst das Parsen von Dokumenten, die Schemaextraktion und die Validierung; fügen Sie eine Prüfoberfläche erst hinzu, wenn Sie wissen, welche Informationen die Prüfer tatsächlich benötigen.
Wann sollte man OCR-basierte Verfahren, Layoutmodelle oder ein LLM verwenden?
Ansatz
Optimale Passform
Hauptbeschränkung
OCR + Regeln
Geringe Anzahl hochstabiler Anbietervorlagen
Regeln werden brüchig, wenn die Layouts variieren.
Dokumentenlayoutmodell
Tabellen, Formulare und Felder, bei denen die Position wichtig ist
Möglicherweise sind aufgabenspezifische Schulungen oder eine Nachbearbeitung erforderlich.
OCR/Dokumentenparser + lokales LLM
Viele Rechnungsformate mit einem gemeinsamen Zielschema
Muss eingeschränkt und validiert werden; Inferenz benötigt mehr Rechenleistung.
Bild-Sprach-Modell
Komplexe Dokumente, bei denen Text und visuelles Layout eng miteinander verknüpft sind
Höhere Hardwareanforderungen und zusätzlicher Auswertungsaufwand.
Die aktuelle Dokumentation von Hugging Faces LayoutLMv3 beschreibt ein Dokumenten-KI-Modell, das Text- und visuelle Layoutinformationen kombiniert. Die Dokumentation von PaddleOCRs PP-StructureV3 konzentriert sich ebenfalls auf Layout, Tabellen und die Analyse strukturierter Dokumente. Diese Optionen bieten sich an, wenn reiner Text in Kombination mit einem Layoutmodell nicht ausreicht.
Welcher Weg vom Prototyp zur Serienproduktion ist sinnvoll?
Gehen Sie schrittweise vor. Führen Sie zunächst eine lokale Verarbeitung in einem Ordner mit gekennzeichneten Rechnungen durch. Fügen Sie anschließend die API und den persistenten Speicher hinzu. Führen Sie im dritten Schritt eine manuelle Prüfwarteschlange ein. Integrieren Sie im vierten Schritt schreibgeschützte Abfragen, z. B. zu Lieferantenstammdaten oder Bestellungen. Ermöglichen Sie schließlich den kontrollierten Export in einen Buchhaltungs-Staging-Bereich. Erst wenn die Überwachung die Wirksamkeit der Kontrollen bestätigt hat, sollten Sie die automatische Buchung für klar definierte, risikoarme Fälle in Betracht ziehen.
In jeder Phase sollten drei Dinge bewahrt werden: Beweise (das Originaldokument und die extrahierte Quelle), Determinismus (Geschäftsregeln, die erneut ausgeführt werden können) und Rückverfolgbarkeit (welcher Parser, welches Modell, welche Eingabeaufforderung und welcher Prüfer den endgültigen Datensatz erzeugt haben).
Abschließende Checkliste
Der Rechnungs-Parser funktioniert sowohl mit digital erstellten PDFs als auch mit den Scans, die Sie tatsächlich erhalten.
Die Extraktionsausgabe ist auf ein versioniertes Pydantic-Schema beschränkt.
Das Modell darf keine fehlenden Werte erfinden.
Summen, Datumsangaben, Duplikate, Lieferantenidentität und Bestellregeln werden außerhalb des LLM validiert.
Fehlerhafte Regeln führen zu einer manuellen Überprüfung anstelle einer stillen Korrektur.
Das Originaldokument, der Quell-Hash, das Modell, die Prompt-Version und das Validierungsergebnis werden protokolliert.
Die API beschränkt Dateityp und -größe und wird vor dem Produktiveinsatz authentifiziert.
Ihr Testdatensatz enthält reale Layoutvariationen und Grenzfälle.
Die Modell- und Bibliothekslizenzen wurden für Ihre geplante Bereitstellung geprüft.
Nachgelagerte Buchungsvorgänge werden schrittweise eingeführt und bleiben revisionsfähig.
Sind diese Kontrollmechanismen implementiert, verfügen Sie über mehr als nur eine OCR-Demo: Sie besitzen die Grundlage für einen zuverlässigen Rechnungsverarbeitungsassistenten. Die Open-Source-Komponenten können sich im Laufe der Zeit ändern, die Architektur bleibt jedoch robust – Beweise analysieren, in ein Schema extrahieren, per Code validieren, Unklarheiten an Mitarbeiter weiterleiten und jede Entscheidung protokollieren.