Startseite
» Domänen
»
Wie man Lippensynchronisationsverzögerungen in KI-Videogeneratoren (HeyGen & ElevenLabs) behebt
Wie man Lippensynchronisationsverzögerungen in KI-Videogeneratoren (HeyGen & ElevenLabs) behebt
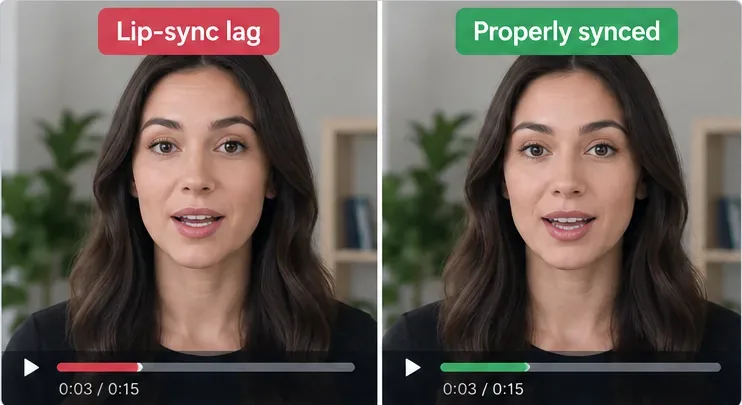
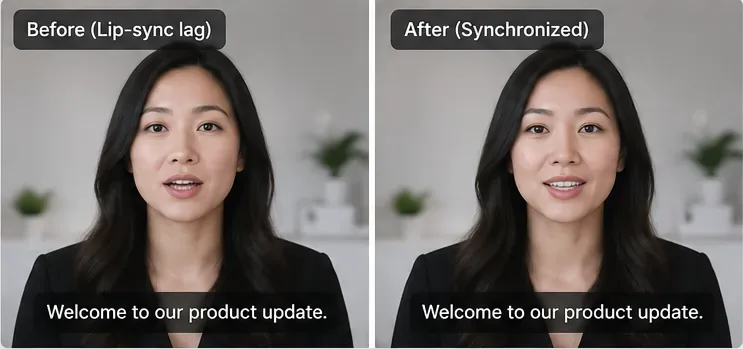
Eine wichtige Klarstellung aus dem Jahr 2026, bevor jegliche Fehlersuche beginnt: ElevenLabs Dubbing führt derzeit keine Lippensynchronisation durch. Laut ElevenLabs ist die Lippensynchronisation in Image & Video, Flows und Studio separat über spezielle Drittanbietermodelle verfügbar. HeyGen hingegen unterteilt die Übersetzung aktuell in „Nur Audio“, „Schnelle Lippensynchronisation“ und „Präzise Lippensynchronisation“. Die richtige Lösung hängt also davon ab, wo in Ihrem Workflow die Mundanimation erzeugt wird.
Wenn Sie in ElevenLabs Sprache generieren und anschließend einen Avatar in HeyGen animieren, verwenden Sie die ElevenLabs-Datei als Audioquelle und HeyGen als Lippensynchronisationsplattform. Wenn Sie ElevenLabs Dubbing für die Übersetzung nutzen, sollten Sie nicht erwarten, dass der Dubbing-Schritt allein die Mundbewegungen verändert; leiten Sie die fertige Sprache anschließend an ein Lippensynchronisationstool weiter. Wenn Sie ein bestehendes Video in HeyGen übersetzen, wählen Sie die Lippensynchronisations-Engine anhand des Videomaterials und nicht automatisch den ressourcenintensiveren Modus.
Diese Anleitung wurde am 13. September 2026 anhand der aktuellen Dokumentation von HeyGen und ElevenLabs überprüft. Produktkontrollen und Kreditkonditionen können sich ändern; daher sind die verlinkten offiziellen Seiten die maßgebliche Informationsquelle.
Zuerst sollte die Art des Lippensynchronisationsproblems diagnostiziert werden.
„Lippensynchronisationsverzögerung“ kann Verschiedenes bedeuten. Die Korrektur der falschen Ebene verschwendet Generationen und Credits.
Was Sie sehen
Wahrscheinliches Problem
Der beste erste Schritt
Der Mund ist von Anfang bis Ende um etwa den gleichen Betrag verspätet.
Konstante Audio-/Videoverschiebung oder vorangehende Stille
Schneiden oder verschieben Sie den Ton, bevor Sie das gesamte Video neu generieren.
Der erste Satz passt noch, aber die Abweichung verstärkt sich mit der Zeit.
Rededauer und Video-Timing weichen voneinander ab.
Regenerieren Sie in einem besseren Tempo, teilen Sie die Szene auf oder verwenden Sie die Daueranpassung.
Nur bestimmte Wörter sehen falsch aus.
Phonem-/Artikulationsfehler
Regenerieren Sie den betroffenen Satz oder verwenden Sie eine Lippensynchronisations-Funktion mit höherer Genauigkeit.
Frontalaufnahmen funktionieren, Seitenansichten jedoch nicht.
Schwierigkeiten bei der visuellen Verfolgung
Verwenden Sie HeyGen Precision oder vereinfachen Sie die Quellaufnahme.
Die ElevenLabs-Synchronisation klingt gut getimt, aber die Mundbewegungen im Original bleiben unverändert.
Die Synchronisation wurde fälschlicherweise für Lippensynchronisation gehalten.
Sende die synchronisierte Audioaufnahme an ein spezielles Lippensynchronisationsmodell oder HeyGen.
Bevor Sie die Einstellungen ändern, sollten Sie entscheiden, ob Sie einen konstanten Versatz, eine progressive Abweichung oder nur wenige fehlerhafte Mundformen haben; jedes Problem erfordert eine andere Lösung.
1. Wählen Sie vor der Videoerstellung eine verlässliche Audioquelle aus.
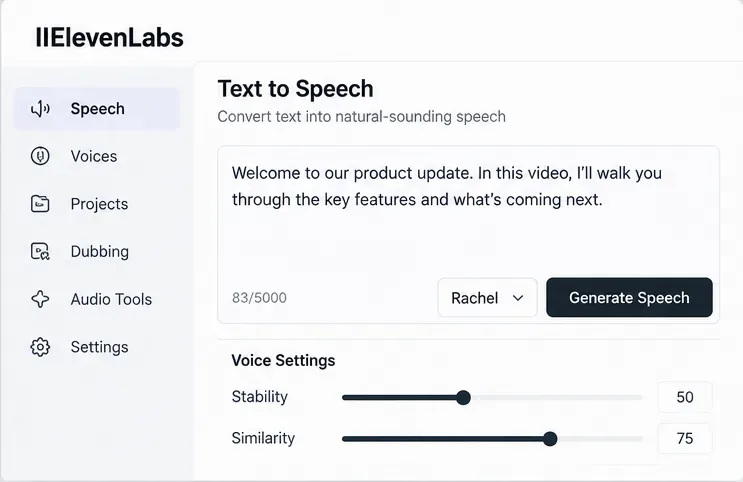
Ein häufiger Fehler im Arbeitsablauf besteht darin, in ElevenLabs eine Sprachaufnahme zu erstellen und anschließend das Videotool das Skript synthetisieren oder neu interpretieren zu lassen. Dadurch entstehen zwei Timing-Entscheidungen statt nur einer. Wenn Sie die ElevenLabs-Performance verwenden möchten, sollten Sie die Audioaufnahme zuerst fertigstellen und sie konsequent als Quelle für die Avatar-Szene verwenden.
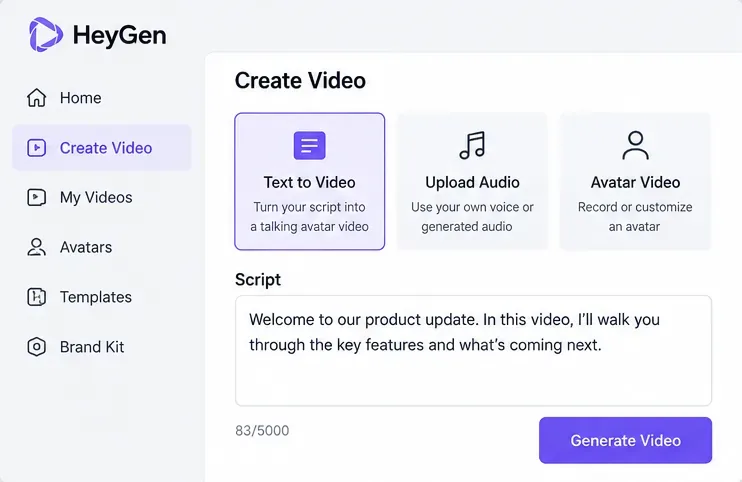
Laut der aktuellen Studio-Dokumentation von HeyGen kann benutzerdefinierter Ton durch Hochladen einer vorab aufgenommenen Datei oder durch direkte Audioaufnahme hinzugefügt werden. Das Studio ist skriptorientiert, und HeyGen weist darauf hin, dass während der Bearbeitung keine vollständigen animierten Avatar-Vorschauen verfügbar sind, da der Avatar erst generiert werden muss; eine Audiovorschau ist jedoch vor der Veröffentlichung möglich.
Empfehlung: Bei aufwändigen oder langen Szenen empfiehlt es sich, zunächst eine kurze Testszene zu erstellen. Überprüfen Sie Audio, Gesichtsausdruck und Mundbewegungen, bevor Sie die vollständige Laufzeitumgebung freigeben.
Wählen Sie eine Sprachquelle für die Szene. Wenn Sie die ElevenLabs-Audiodatei bereits freigegeben haben, laden Sie diese hoch, anstatt die Aufnahme separat neu zu erstellen.
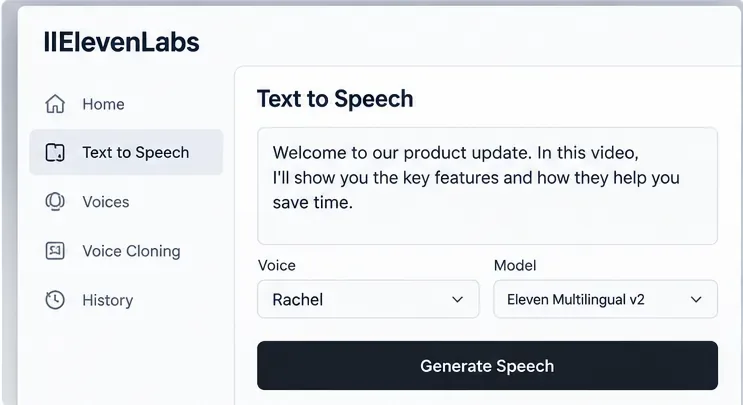
2. Bevor man die Lippensynchronisations-Engine kritisiert, sollte man das Pacing von ElevenLabs verbessern.
Wenn die Rede selbst gehetzt, ungewöhnlich langsam oder voller unnatürlicher Pausen ist, muss der Videogenerator diese Timing-Animationen vornehmen. Sauberer Ton lässt sich leichter synchronisieren als Ton, den man nachträglich bearbeiten möchte, nachdem die Mundanimation bereits generiert wurde.
ElevenLabs dokumentiert derzeit eine Sprachausgabegeschwindigkeit von 0,7 bis 1,2 für die Text-to-Speech-Funktion, wobei 1,0 der Standardwert ist. Das Unternehmen weist darauf hin, dass extreme Werte die Qualität beeinträchtigen können. In den Best-Practice-Empfehlungen wird außerdem darauf hingewiesen, dass übermäßige Pausenmarkierungen zu Instabilität oder unerwartetem Sprechtempo führen können.
Abwägung: Eine Änderung der Sprechgeschwindigkeit kann zwar dazu beitragen, dass ein Satz die gewünschte Länge erreicht, verändert aber auch die Aussprache. Klingt die Stimme gehetzt oder unnatürlich gedehnt, ist es meist besser, den Satz umzuschreiben, als die Sprechgeschwindigkeit weiter zu erhöhen.
Generieren und genehmigen Sie zuerst die Sprachaufnahme. Achten Sie auf Tempoprobleme, ungleichmäßige Pausen oder gehetzte Formulierungen, bevor Sie die Datei für die Lippensynchronisation verwenden.
Ein Hinweis zu den Geschwindigkeitsreglern von Eleven v3
Die offizielle Dokumentation von ElevenLabs ist derzeit in einem Punkt widersprüchlich: Im Hilfecenter heißt es, die Geschwindigkeitseinstellung sei für alle Stimmen und Modelle verfügbar, während die Produktanleitung für die Sprachausgabe einen modellspezifischen Hinweis enthält, wonach die Geschwindigkeitseinstellung für Eleven v3 nicht verfügbar ist. Da beide Aussagen offiziell sind, überprüfen Sie bitte die tatsächlich angezeigten Steuerelemente für das von Ihnen gewählte Modell, anstatt davon auszugehen, dass ein Geschwindigkeitsregler immer vorhanden ist.
Vorgehen: Falls das ausgewählte Modell keine Geschwindigkeitsanzeige bietet, steuern Sie das Timing durch Formulierungen, Interpunktion, modellspezifische Audio-Tags oder ein anderes unterstütztes Modell, anstatt sich auf ein nicht vorhandenes Steuerelement zu verlassen.
3. Vermeiden Sie unnötige Stille und prüfen Sie auf einen konstanten Versatz.
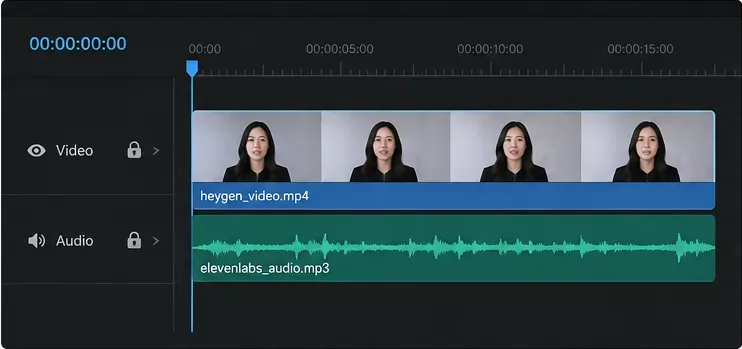
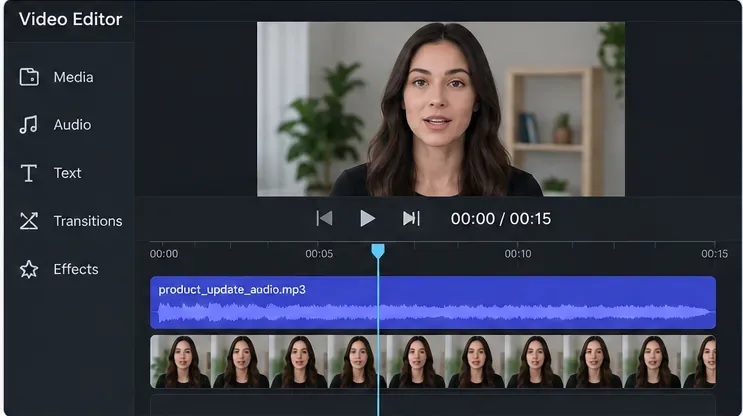
Wenn die Mundbewegungen stets um denselben Betrag zu spät oder zu früh erfolgen, ist eine Änderung des KI-Modells möglicherweise nicht erforderlich. Untersuchen Sie die Audiodatei in einer Zeitleiste. Ein kurzer Vorlauf vor dem ersten gesprochenen Konsonanten oder ein Audioausschnitt, der einige Frames vor dem vorgesehenen Beginn platziert ist, kann den Eindruck einer fehlerhaften Lippensynchronisation erwecken.
Beispielsweise entspricht ein Versatz von vier Einzelbildern bei 30 Bildern pro Sekunde etwa 133 Millisekunden. Das ist groß genug, um bei Nahaufnahmen von Sprache unnatürlich zu wirken, selbst wenn die Mundanimation an sich konsistent ist.
Maßnahme: Richten Sie den ersten klaren Sprachimpuls auf den erwarteten visuellen Startpunkt aus. Falls das Problem nach der Generierung weiterhin besteht, verschieben Sie die Audiospur in einem Videoeditor, anstatt alle Assets neu zu generieren.
Bei einem konstanten Offset sollten Sie die Wellenform und die Clipping-Startpunkte überprüfen, bevor Sie Credits für die Generierung eines neuen Avatars ausgeben.
4. Verwenden Sie kürzere Segmente, wenn die Drift mit der Zeit zunimmt.
Eine progressive Abweichung unterscheidet sich von einer festen Abweichung. Wenn die ersten Sekunden korrekt erscheinen und die Mundbewegungen allmählich hinterherhinken, stimmt die Sprechdauer nicht mehr gut mit dem visuellen Timing überein. Lange, zusammenhängende Szenen verstärken kleine Timing-Unterschiede.
Teilen Sie eine längere Erzählung in kürzere, logische Sätze oder Abschnitte auf, generieren Sie diese separat und fügen Sie sie später zusammen. So erhalten Sie eine kleinere Einheit, die Sie neu generieren können, falls nur ein Abschnitt fehlerhaft ist. Die Sprachspiegelungs-Anleitung von HeyGen empfiehlt außerdem, mit kurzen Segmenten zu beginnen, um das gewünschte Tempo und die Verarbeitungsprozesse zu erlernen.
Abwägung: Kürzere Segmente verbessern die Reparierbarkeit, aber zu viele Schnitte können Tonfall und Atmosphäre inkonsistenter machen. Behalten Sie die Stimmeinstellungen bei und vermeiden Sie Änderungen des Sprechstils zwischen aufeinanderfolgenden Segmenten, es sei denn, das Drehbuch erfordert dies.
Testen Sie zunächst einen kurzen Satz. Sobald das Timing zuverlässig ist, können Sie den Workflow auf längere Szenen ausweiten, anstatt ein komplettes Video auf einmal zu debuggen.
5. Wählen Sie in HeyGen Video Translation je nach Aufnahme entweder Geschwindigkeit oder Präzision.
Das aktuelle Videoübersetzungssystem von HeyGen bietet drei Engine-Optionen:
Nur Audio: Übersetzt und vertont ohne Lippensynchronisation.
Geschwindigkeit: Lippensynchronisation optimiert für Frontalaufnahmen, geringe Gesichtsverdeckung und einfachere Konversationen.
Präzision: Hochwertigere Lippensynchronisation für Seitenansichten, Kamerawinkeländerungen, Gesichtsverdeckungen, Sprecherwechsel und komplexere Konversationen.
Laut HeyGens Hilfecenter vom 13. September 2026 beträgt der Preis für Geschwindigkeit 6 Credits pro Minute und für Präzision 10 Credits pro Minute. Diese Angabe verdeutlicht den jeweiligen Kompromiss, jedoch sollten Sie das Produkt vor der Generierung überprüfen, da sich die Preise ändern können.
Empfehlung: Verwenden Sie „Geschwindigkeit“ für eine einzelne Person, die sich in einem Winkel von etwa 45 Grad zur Kamera befindet und deren Gesicht gut zu sehen ist. Wechseln Sie zu „Präzision“, wenn das Videomaterial schwieriger zu verfolgen ist. Zusätzliche Credits beheben keine Probleme mit dem Quellton; kümmern Sie sich daher zuerst um das Sprechtempo.
HeyGen empfiehlt außerdem Nahaufnahmen, minimale Kameraschnitte, reduziertes Hintergrundrauschen und dass jeweils nur eine Person spricht, um eine bessere Lippensynchronisation der Übersetzung zu gewährleisten.
6. Verwenden Sie die dynamische Dauer, wenn die übersetzte Sprache mehr Platz benötigt.
Verschiedene Sprachen benötigen selten exakt die gleiche Zeit, um denselben Gedanken auszudrücken. Die erweiterten Einstellungen von HeyGen beinhalten die Option „Dynamische Dauer aktivieren“ , mit der die Segmentdauer um bis zu ±20 % angepasst werden kann, um eine natürlichere Übersetzung zu erzielen. HeyGen weist darauf hin, dass sich dadurch die Gesamtlänge des Videos verändern kann.
Wählen Sie die dynamische Dauer, wenn: eine natürliche Wiedergabe wichtiger ist als die Beibehaltung der exakten ursprünglichen Laufzeit.
Verwenden Sie diese Funktion nicht, wenn die Videosequenzen exakt mit Musik, festen Grafiken, Sendezeiten oder externen Zeitsignalen synchronisiert bleiben müssen. In diesem Fall sollten Sie die Übersetzung überarbeiten oder die Sprachausgabe von ElevenLabs anpassen.
Wenn es auf die Laufzeit ankommt, sollte die gesprochene Zeile so lange neu generiert werden, bis ihre natürliche Dauer zur Szene passt, anstatt nachträglich eine große Timingkorrektur zu erzwingen.
7. Erwarten Sie nicht, dass ElevenLabs Dubbing allein den Mund animiert.
Dies ist der wichtigste Unterschied im Workflow zwischen den beiden Plattformen. Die aktuelle Dokumentation von ElevenLabs zum Thema Synchronisation weist ausdrücklich darauf hin, dass die Synchronisation keine Lippensynchronisation beinhaltet. Lippensynchronisationswerkzeuge sind in ElevenLabs Image & Video, Flows und Studio separat über spezielle Modelle verfügbar.
ElevenLabs Dubbing v2 befindet sich aktuell in der Alpha-Phase. Timing, Tonfall und Sprechercharakteristika bleiben erhalten, der standardmäßige Web-Workflow von v2 ist jedoch automatisch und bietet keine Möglichkeit zur Transkriptbearbeitung direkt in der App. Transkriptbearbeitung und Audio-Generierung über die v2-API sind derzeit nur für Unternehmen verfügbar. Dubbing Studio, basierend auf v1, ist weiterhin erhältlich, befindet sich aber im Wartungsmodus und erhält nur noch kritische Fehlerbehebungen.
Für einen HeyGen + ElevenLabs Workflow: Generieren oder synchronisieren Sie die endgültige Sprachaufnahme in ElevenLabs und laden Sie dann die freigegebene Audiodatei für die Mundanimation in HeyGen hoch.
Wenn ElevenLabs die endgültige Sprachspur liefert, verwenden Sie diese freigegebene Datei als Eingabe für die Lippensynchronisationsphase, anstatt zu erwarten, dass der Synchronisationsschritt die Mundbewegungen verändert.
Was, wenn Sie sich ausschließlich innerhalb von ElevenLabs bewegen möchten?
ElevenLabs Image & Video bietet derzeit spezielle Lippensynchronisationsmodelle für Quellbilder oder -videos mit Sprachausgabe an. Die Dokumentation listet Optionen wie HeyGen Avatar 4, Sync 3, Sync Lipsync 2 Pro, Veed Lipsync und weitere auf. Die Verfügbarkeit kann je nach Modell und Region variieren; so ist beispielsweise OmniHuman 1.5 laut Dokumentation in den USA nicht verfügbar.
Abwägung: Die Verwendung eines einzigen Arbeitsbereichs vereinfacht zwar die Asset-Verwaltung, es handelt sich jedoch um separate Nachbearbeitungs- oder Avatar-Modelle mit eigenen Kosten und Einschränkungen. Verwechseln Sie diese nicht mit der Dubbing-Funktion selbst.
8. Falls nur noch eine konstante Restverzögerung verbleibt, korrigieren Sie diese einmalig im finalen Editor.
Nachdem Sie Tempo, Quellton und Lippensynchronisation korrigiert haben, kann unter Umständen noch eine kleine, gleichmäßige Abweichung bestehen. Wenn die Mundbewegungen im gesamten Clip um denselben Betrag zu früh oder zu spät sind, ist eine abschließende Anpassung der Timeline oft kostengünstiger und besser vorhersagbar als eine weitere vollständige Bearbeitung.
Verschieben Sie die Audiospur um einige Frames, hören Sie sich Plosivlaute wie p , b und m an und überprüfen Sie mindestens drei Punkte: Anfang, Mitte und Ende. Wenn sich die Abweichung im Laufe der Zeit ändert, verschieben Sie nicht die gesamte Spur, sondern kehren Sie zur Tempo- oder Segmentdauer zurück, da es sich um eine Abweichung und nicht um eine feste Abweichung handelt.
Ein abschließender Editor eignet sich am besten für kleine, konstante Abweichungen. Eine fortschreitende Abweichung sollte zuvor durch Ändern der Sprachdauer oder Regenerieren des betroffenen Segments korrigiert werden.
Wie lassen sich Pausen in ElevenLabs steuern?
Die Pausenbehandlung ist modellabhängig. ElevenLabs gibt an, dass Eleven v3 Audio-Tags und Satzzeichen anstelle von SSML-Pause-Tags verwendet. Multilingual v2, Flash v2 und Flash v2.5 unterstützen SSML-ähnliche <break time="1.5s" />Pausen von bis zu drei Sekunden. Das Unternehmen warnt davor, dass zu viele Pause-Tags Geschwindigkeitsänderungen, Rauschen oder andere Artefakte verursachen können.
Empfehlung: Verwenden Sie nur die minimal notwendigen Pausenmarkierungen, um den Text natürlich wiederzugeben. Wenn ein übersetzter Satz viele künstliche Pausen benötigt, nur um dem visuellen Timing zu entsprechen, schreiben Sie den Satz um oder teilen Sie die Einstellung stattdessen auf.
Was, wenn der benutzerdefinierte HeyGen-Avatar selbst eine schwache Lippensynchronisation aufweist?
Wenn jede generierte Zeile unzuverlässig ist – selbst bei einwandfreier Audioqualität – liegt das Problem möglicherweise eher am Trainingsvideo des Avatars als an der aktuellen Sprachdatei. Laut den Richtlinien von HeyGen für den digitalen Zwilling muss das Trainingsvideo die sprechende Person enthalten, da Audio und Video für die Lippensynchronisation des Systems entscheidend sind. Das Unternehmen empfiehlt mindestens 1080p und 30 fps, helle und gleichmäßige Beleuchtung sowie klaren Ton ohne starkes Echo oder Umgebungsgeräusche.
Maßnahme: Falls der Avatar bei mehreren sauberen Skripten immer wieder Probleme hat, sollten Sie ihn mit besserem Quellmaterial neu trainieren, bevor Sie Zeit mit der Feinjustierung jedes einzelnen generierten Clips verbringen.
Schnell sprechendes Video mit genehmigtem ElevenLabs-Kommentar
Generieren Sie zuerst ElevenLabs-Audio und laden Sie es dann in HeyGen Studio hoch.
Einfacher Workflow, aber der endgültige Avatar benötigt noch einen Generierungsdurchgang.
Übersetzen Sie ein einfaches, nach vorne gerichtetes Quellvideo
HeyGen-Videoübersetzung mit Geschwindigkeit
Geringere Kreditkosten als bei Precision, aber weniger geeignet für komplexe Aufnahmen.
Seitenansichten, Verdeckungen oder Aufnahmen mit mehreren Sprechern übersetzen
HeyGen-Videoübersetzung mit Präzision
Höhere Kreditnutzung im Austausch für höhere Lippensynchronisationsgenauigkeit
Hochwertige Audioübersetzung ohne Mundanimation
ElevenLabs-Synchronisation
Die Synchronisation erhält Timing und Stimmmerkmale, führt aber keine Lippensynchronisation durch.
Sprache und Lippensynchronisation innerhalb von ElevenLabs beibehalten
ElevenLabs Bild & Video mit einem spezialisierten Lippensynchronisationsmodell
Modellverfügbarkeit, Kosten und regionale Beschränkungen variieren
Es bleibt nur noch ein kleiner fester Versatz übrig.
Audio in einem normalen Videoeditor verschieben
Schnell und günstig, aber nur für konstante Offset-Werte geeignet – nicht für Drift.
Abschließende Checkliste zur Fehlerbehebung
Prüfen Sie, ob es sich um einen konstanten Versatz, eine progressive Drift oder eine Abweichung auf Wortebene handelt.
Genehmigen Sie die ElevenLabs-Audiodatei, bevor Sie das Avatar-Video generieren.
Vermeiden Sie extreme Änderungen der Sprechgeschwindigkeit, nur um die Sprechdauer zu erzwingen.
Verwenden Sie die für das jeweilige Modell geeigneten Pausensteuerungen und vermeiden Sie übermäßige Pausenmarkierungen.
Entfernen Sie offensichtliche einleitende Stille und überprüfen Sie den ersten gesprochenen Konsonanten.
Verwenden Sie kürzere Szenen, wenn die Drift im Laufe der Zeit zunimmt.
Wählen Sie HeyGen Speed für einfache Frontalaufnahmen und Precision für schwierige Winkel oder Verdeckung.
Die dynamische Laufzeit sollte nur dann verwendet werden, wenn eine Änderung der Gesamtlaufzeit akzeptabel ist.
Beachten Sie, dass ElevenLabs Dubbing allein keine Mundanimation bietet.
Verwenden Sie einen abschließenden Timeline-Nullpunkt nur für einen gleichmäßigen Versatz, der sich nicht über den gesamten Clip hinweg vergrößert.
Fazit
Die beste Lösung für Lippensynchronisationsverzögerungen ist keine einzelne Einstellung, sondern eine Diagnose. Ist der gesamte Clip um denselben Betrag asynchron, korrigieren Sie die Abweichung. Verstärkt sich die Verzögerung mit der Zeit, optimieren Sie das Tempo oder die Segmentdauer. Treten die Probleme nur bei schwierigen Kameraperspektiven auf, verwenden Sie einen stärkeren Lippensynchronisationsmodus. Wenn Sie ElevenLabs Dubbing verwenden, fügen Sie eine separate Lippensynchronisationsstufe hinzu, da Dubbing selbst den Mund nicht animiert.
Bei den meisten HeyGen + ElevenLabs Workflows ist der einfachste Weg, die Sprachqualität in ElevenLabs zu optimieren, ein kurzes Segment in HeyGen zu testen, je nach Quellmaterial zwischen Geschwindigkeit und Präzision zu wählen und die externe Timeline-Korrektur für die kleinen, konstanten Abweichungen aufzubewahren, die nach der Generierung noch vorhanden sind.