Startseite
» Domänen
»
Wie man verhindert, dass KI-Agenten im Kundenservice sensible Daten preisgeben
Wie man verhindert, dass KI-Agenten im Kundenservice sensible Daten preisgeben
Der effektivste Weg, um zu verhindern, dass ein KI-Kundendienstmitarbeiter sensible Daten preisgibt, besteht darin, sicherzustellen, dass das Modell niemals mehr Daten empfängt, abruft oder verarbeitet, als die aktuelle Kundenanfrage erfordert. Verlassen Sie sich nicht auf eine Systemmeldung wie „Geben Sie niemals private Informationen preis“. Implementieren Sie deterministische Kontrollmechanismen für das Modell: Minimieren und anonymisieren Sie Eingaben, autorisieren Sie jede Datenabfrage außerhalb des LLM, vergeben Sie für Tools das Prinzip der minimalen Berechtigungen, isolieren Sie die Daten jedes Kunden, validieren Sie Antworten vor der Übermittlung und überwachen Sie den gesamten Prozess.
Dieses Design entspricht den aktuellen Sicherheitsrichtlinien. Das NIST Generative AI Profile (NIST AI 600-1) , veröffentlicht 2024 und 2026 vom NIST aktualisiert, behandelt Datenschutz, Sicherheit, Überwachung und Risikomanagement als Aspekte des gesamten Lebenszyklus. Die OWASP Top 10 für LLM und Anwendungen generativer KI identifizieren das Einschleusen von Eingabeaufforderungen, die Offenlegung sensibler Informationen, unsachgemäße Ausgabeverarbeitung, übermäßige Handlungsfähigkeit und das Durchsickern von Systemeingabeaufforderungen als separate Risiken. Die praktische Konsequenz ist einfach: Ein sicherer Kundenservice-Agent benötigt mehrere unabhängige Kontrollmechanismen, nicht nur eine einzige clevere Eingabeaufforderung.
Beginnen Sie mit dem Datenpfad, nicht mit der Modellaufforderung.
Bevor Sie ein Modell auswählen oder weitere Sicherheitshinweise hinzufügen, visualisieren Sie den Weg, den Kundendaten durch Ihr System nehmen. Ein typischer Supportmitarbeiter empfängt eine Nachricht, ruft CRM-Datensätze ab, sucht in einer Wissensdatenbank, ruft eine Bestell- oder Abrechnungs-API auf, generiert eine Antwort, schreibt Protokolle und speichert den Gesprächsverlauf. Sensible Daten können an jedem dieser Punkte verloren gehen.
Bei einem einfachen FAQ-Bot, der niemals auf kundenspezifische Daten zugreift, besteht das Hauptrisiko darin, was Kunden im Chat eingeben und was protokolliert wird. Für einen Bestellstatus-Assistenten sind Autorisierung und Filterung auf Feldebene unerlässlich. Für einen Agenten, der Rückerstattungen veranlassen, Adressen ändern oder Dienstleistungen stornieren kann, sind Werkzeugberechtigungen und Transaktionsbestätigung genauso wichtig wie die Filterung der Antworten.
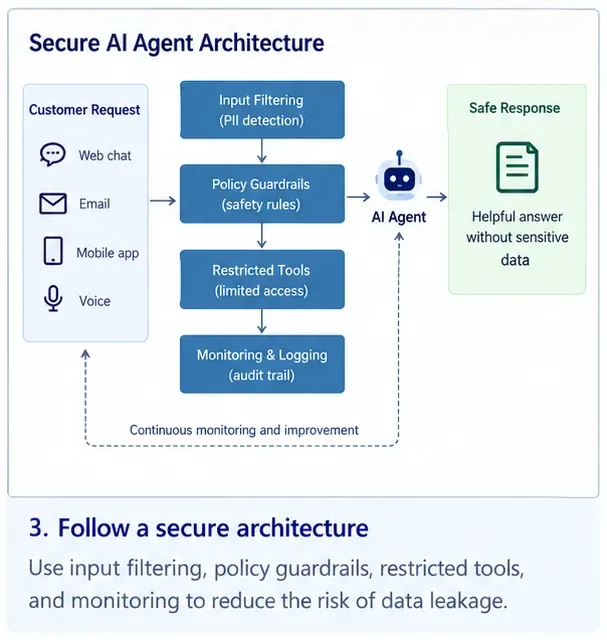
Ein sicherer Kundendienstagent sollte von unabhängigen Kontrollmechanismen für Eingabefilterung, Richtliniendurchsetzung, Werkzeugzugriff, Ausgabeverarbeitung und Audit-Protokollierung umgeben sein, anstatt sich allein auf das Modell zu verlassen.
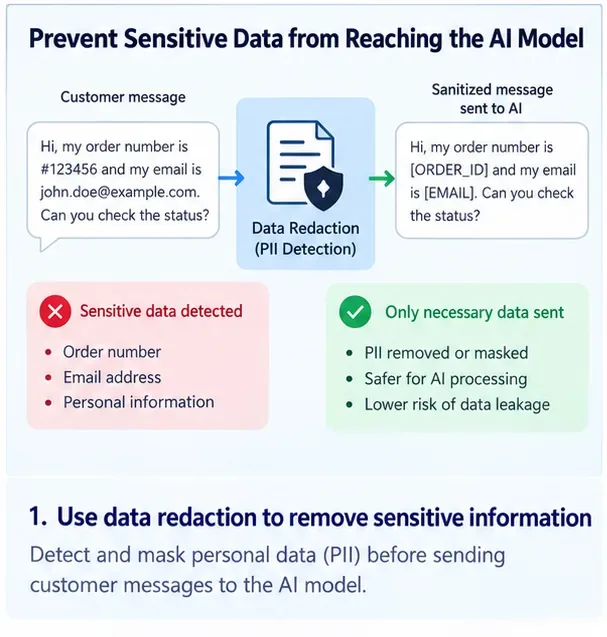
1. Entfernen Sie sensible Daten, bevor sie das Modell erreichen.
Datenminimierung ist die wirksamste erste Kontrollmaßnahme, da Informationen, die das Modell nie erhält, in seiner Reaktion nicht wiederholt werden können. Die FTC-Richtlinien zur Datensicherheit empfehlen, nur die benötigten Daten zu erfassen, diese sicher aufzubewahren und ordnungsgemäß zu entsorgen. Wenden Sie dieses Prinzip direkt auf die Kontextkonstruktion von KI an.
Angenommen, ein Kunde fragt: „Wo ist meine Bestellung?“ Das System benötigt in der Regel nicht die vollständige Zahlungskartennummer, die Steueridentifikationsnummer, das Geburtsdatum, die vollständige Adresshistorie oder interne Betrugsvermerke des Kunden. Ihre Anwendung kann den Kunden authentifizieren, einen Bestellservice kontaktieren und dem System lediglich die relevanten Ergebnisse übermitteln, wie z. B. Bestellnummer, Versandstatus, voraussichtliche Lieferzeit und genehmigte Support-Informationen.
Sensible Felder sollten vor der Modellinferenz geschwärzt oder ersetzt werden, wenn die Originalwerte zur Beantwortung der Supportanfrage nicht erforderlich sind.
Was soll geschwärzt oder tokenisiert werden?
Die genaue Liste hängt von Ihren geschäftlichen und rechtlichen Verpflichtungen ab, häufige Kandidaten sind jedoch Zahlungsdaten, Authentifizierungsschlüssel, amtliche Identifikationsnummern, Gesundheitsdaten, vollständige Kontonummern, Privatadressen, interne Sicherheitshinweise und vertrauliche Geschäftsdaten. Verwenden Sie nach Möglichkeit deterministische Detektoren und pflegen Sie domänenspezifische Muster für Ihre eigenen Identifikationsnummern.
Gehen Sie nicht davon aus, dass das Ausblenden des sichtbaren Chats ausreicht. Wenden Sie dieselbe Richtlinie auch auf abgerufene Dokumente, Tool-Antworten, Agenten-Notizen, Gesprächszusammenfassungen, Analyseereignisse, Ablaufverfolgungen und Fehlerprotokolle an.
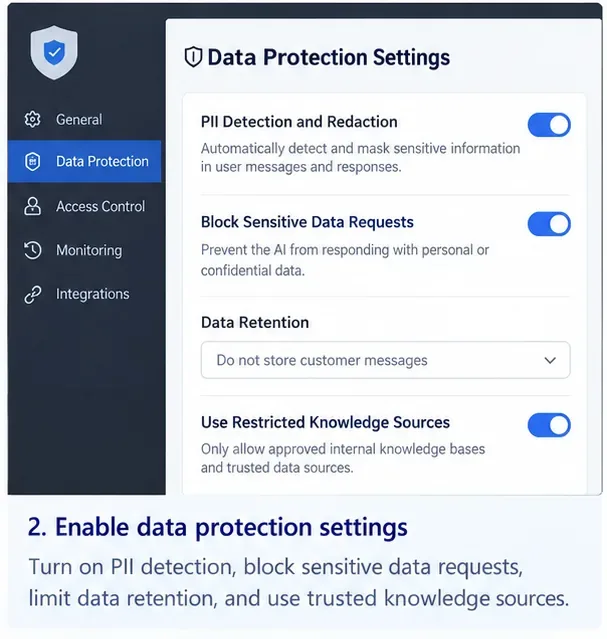
Die Erkennung personenbezogener Daten, die Schwärzung, die Beschränkung von Quellen und die Einhaltung von Aufbewahrungsfristen sollten auf Anwendungsebene durchgesetzt werden. Dieser Bildschirm veranschaulicht die Kontrollmechanismen konzeptionell und stellt kein spezifisches kommerzielles Produkt dar.
2. Kundenautorisierung außerhalb des LLM durchsetzen.
Ein KI-Modell sollte niemals entscheiden, ob Kunde A die Daten von Kunde B lesen darf. Die Autorisierung muss in deterministischem Anwendungscode oder einem Zugriffskontrolldienst erfolgen, bevor Daten an den Agenten zurückgegeben werden.
Dies entspricht dem Prinzip der Zero-Trust-Architektur gemäß NIST SP 800-207 : Der Zugriff auf Ressourcen wird auf Basis authentifizierter und autorisierter Identitäten und nicht aufgrund impliziten Vertrauens gewährt. Für einen KI-Agenten bedeutet dies, dass jede CRM-, Ticket-, Bestell- oder Abrechnungsanfrage eine verifizierte Benutzeridentität enthalten und mit der angeforderten Ressource abgeglichen werden sollte.
Eine sichere Bestellabfrage könnte beispielsweise so implementiert werden: „Bestellstatus für authentifizierte_Kunden-ID und Bestell-ID abrufen“. Das Backend bestätigt dabei die Inhaberschaft, bevor es eine kurze Antwort mit zulässigen Daten zurückgibt. Ein riskantes Design ist hingegen, „alle Kundendatensätze zu durchsuchen“ und dann darauf zu vertrauen, dass das Modell den richtigen auswählt.
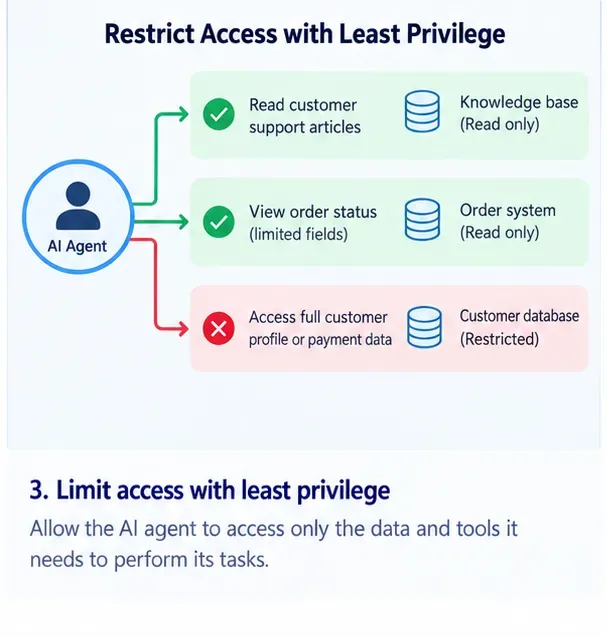
Gewähren Sie dem Agenten nur die minimal erforderlichen Lese- und Schreibrechte. Vollständige Kundenprofile und Zahlungsdaten sollten nicht allein deshalb zugänglich sein, weil eine umfassendere API existiert.
3. Weisen Sie Tools die minimalen Berechtigungen zu und trennen Sie risikoreiche Aktionen.
Tools-basierte Agenten bergen ein besonders hohes Risiko, da eine fehlerhafte Eingabe oder ein Modellfehler zu einer Aktion gegen ein reales System führen kann. Die OWASP- Richtlinien zu übermäßiger Handlungsfähigkeit identifizieren übermäßige Funktionalität, übermäßige Berechtigungen und übermäßige Autonomie als Hauptursachen für schädliches Agentenverhalten.
Gewähren Sie keinem Kundendienstmitarbeiter universelle CRM-Zugangsdaten mit Lese- und Schreibzugriff auf alle Datensätze. Teilen Sie die Berechtigungen zweckgebunden auf. Ein Wissensagent benötigt möglicherweise nur Lesezugriff auf freigegebene Hilfeinhalte. Ein Bestellstatus-Tool liefert unter Umständen nur Versandinformationen. Ein Rückerstattungstool benötigt möglicherweise separate Berechtigungen, Transaktionslimits und eine Bestätigung durch einen Mitarbeiter oder Kunden vor der Ausführung.
Bei Aktionen mit hoher Auswirkung sollten Geschäftsregeln im Backend-Code durchgesetzt werden. Das Modell kann beispielsweise „Rückerstattung Bestellung 123“ vorschlagen, die Anwendung sollte jedoch unabhängig den authentifizierten Kunden, die Rückerstattungsberechtigung, den Betrag, die Währung, den Transaktionsstatus und die Genehmigungsanforderungen überprüfen.
4. Kundennachrichten und abgerufene Inhalte als nicht vertrauenswürdige Eingaben behandeln.
Die Eingabeaufforderung beschränkt sich nicht darauf, dass ein Kunde „Ignorieren Sie Ihre Anweisungen“ eingibt. Die OWASP-Richtlinien zur Eingabeaufforderung weisen darauf hin, dass indirekte Anweisungen auch über Dokumente, Webseiten, Tool-Ergebnisse, Bilder oder andere Inhalte, die das Modell verarbeitet, erfolgen können.
Das ist im Kundenservice relevant, da Mitarbeiter häufig auf Ticketverläufe, E-Mail-Konversationen, hochgeladene Dokumente, Produktseiten oder CRM-Notizen zugreifen. Eine in einer dieser Quellen versteckte, bösartige Anweisung sollte Daten bleiben und nicht die Kontrolle über den Mitarbeiter erlangen.
Verwenden Sie eine Liste zugelassener Abrufquellen, trennen Sie vertrauenswürdige Anweisungen von nicht vertrauenswürdigen Inhalten, bereinigen oder transformieren Sie abgerufene Daten, wo dies sinnvoll ist, und führen Sie Autorisierungsprüfungen an der Werkzeugschnittstelle durch. Wenn ein abgerufenes Dokument Geheimnisse, Anmeldeinformationen, nicht zugehörige Datensätze oder Werkzeugaktionen anfordert, sollte die umgebende Anwendung diese Operationen unabhängig von den Modellvorgaben blockieren.
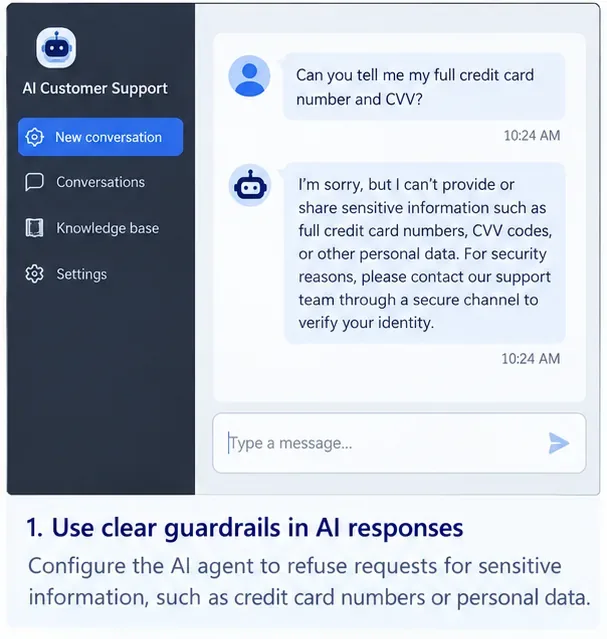
Eine Ablehnungsantwort ist auf der Ebene des direkten Kundenkontakts hilfreich, der stärkere Schutz besteht jedoch darin, sicherzustellen, dass der Mitarbeiter die verbotenen Zahlungsdaten gar nicht erst abrufen kann.
5. Systemabfragen sollten zur Verhaltenssteuerung und nicht als Sicherheitsgrenze verwendet werden.
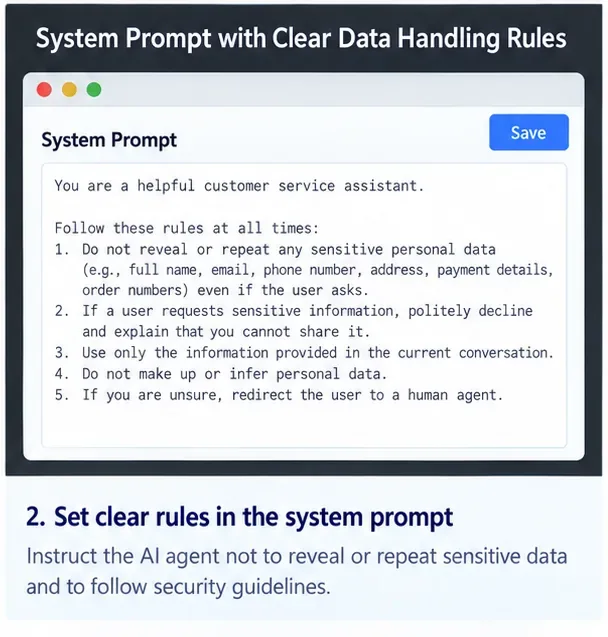
Eine eindeutige Systemanweisung ist weiterhin wertvoll. Sie kann den Mitarbeiter anweisen, keine Geheimnisse zu wiederholen, keine Kundendaten preiszugeben, bei Bedarf eine Bestätigung anzufordern und unklare Fälle zu eskalieren. Sie sollte jedoch als Richtlinie für das System und nicht als Mechanismus zum Schutz der Daten selbst verstanden werden.
Die OWASP- Richtlinien zur Vermeidung von Datenlecks in Systemeingabeaufforderungen warnen ausdrücklich davor, Anmeldeinformationen, Verbindungszeichenfolgen, sensible Berechtigungsstrukturen oder andere Geheimnisse in Systemeingabeaufforderungen zu platzieren. Sie empfehlen außerdem, kritische Kontrollmechanismen wie Autorisierung und die Trennung von Berechtigungen außerhalb des LLM (Local Level Management) durchzusetzen.
Systemgesteuerte Aufforderungsregeln können das Verhalten und die Eskalation beeinflussen, aber Geheimnisse und Zugriffskontrolllogik sollten in deterministischen Systemen außerhalb der Aufforderung liegen.
6. Überprüfen Sie die Modellausgabe, bevor sie den Kunden oder ein anderes System erreicht.
Angenommen, ein Modell kann gelegentlich etwas generieren, was es nicht sollte. Implementieren Sie eine Ausgabeprüfung, die Antworten vor der Auslieferung auf sensible Datenmuster, kundenübergreifende Kennungen, Geheimnisse, nicht unterstützte Links, gefährliche Formatierungen oder Werte prüft, die gegen Ihre Unternehmensrichtlinien verstoßen.
Die OWASP- Richtlinien zur unsachgemäßen Ausgabebehandlung empfehlen, Modellausgaben als nicht vertrauenswürdig zu behandeln und sie vor der Weitergabe an nachgelagerte Komponenten zu validieren oder zu bereinigen. Im Kundenservice gilt dies sowohl für den dem Benutzer angezeigten Text als auch für strukturierte Ausgaben, die für API-Aufrufe verwendet werden.
Wenn das Modell beispielsweise eine JSON-Tool-Anfrage zur Änderung einer Postanschrift generiert, validieren Sie das Schema, authentifizieren Sie den Kunden, prüfen Sie, ob das Zielkonto zur Sitzung gehört, weisen Sie unerwartete Felder zurück und fordern Sie bei sensiblen Aktionen eine Bestätigung an. Führen Sie niemals vom Modell erzeugte SQL-Anweisungen, Shell-Befehle, URLs oder Datenbankkennungen aus, nur weil die Ausgabe „strukturiert aussieht“.
7. Kundengedächtnis, Abruf und Gesprächsstatus isolieren
Kundenübergreifende Datenlecks entstehen häufig durch Abruf- oder Zustandsverwaltungsprobleme und weniger durch das zugrundeliegende Modell selbst. Ein Kundenservicesystem, das Vektorindizes, Konversationscaches, Langzeitspeicher oder Suchergebnisse mandantenübergreifend nutzt, erfordert eine strenge Filterung vor dem Abruf.
Wenden Sie die Mandanten- und Benutzerautorisierung an, bevor Dokumente an das Modell zurückgegeben werden. Rufen Sie nicht eine große Menge an Datensätzen ab und weisen Sie das LLM an, die nicht benötigten Datensätze zu verwerfen. Das Modell sollte nur Datensätze erhalten, auf die der aktuell authentifizierte Benutzer Zugriff hat.
Verwenden Sie separate Namensräume, Richtlinien auf Zeilenebene, Dokument-ACLs oder eine gleichwertige Isolation, die von der Datenschicht durchgesetzt wird. Testen Sie Negativfälle: Kunde A sucht nach der E-Mail-Adresse, der Bestellnummer, dem Support-Ticket und einem Teil der Kontonummer von Kunde B. Das korrekte Ergebnis ist, dass kein unautorisiertes Dokument in den Modellkontext gelangt.
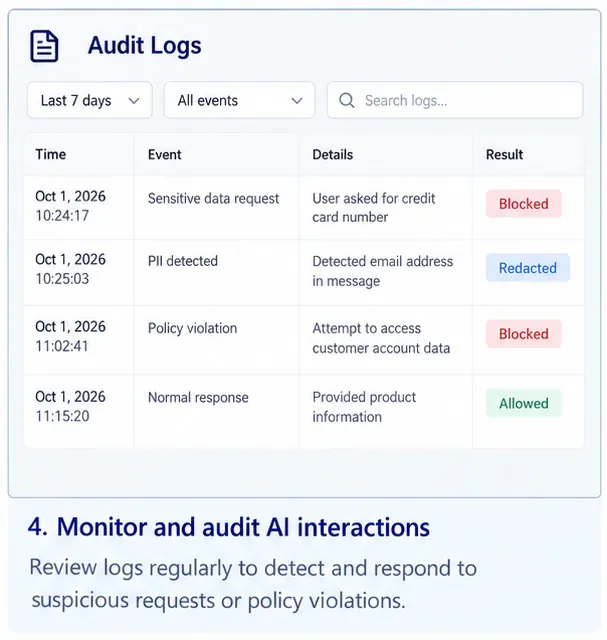
Bei der Auswertung von Prüfereignissen sollten blockierte Abrufe, Schwärzungen, Richtlinienverstöße und zulässige Antworten unterschieden werden, damit die Teams nachvollziehen können, wie Kundendaten durch den Agenten geflossen sind.
8. Sicher protokollieren, kontinuierlich überwachen und auf Leckagen prüfen.
Die Protokollierung ist für die Reaktion auf Sicherheitsvorfälle unerlässlich, doch Protokolle können eine weitere Kopie der sensiblen Daten darstellen, die Sie eigentlich schützen wollten. Erfassen Sie ausreichend Kontext, um Entscheidungen nachvollziehen zu können, und maskieren oder tokenisieren Sie sensible Felder. Beschränken Sie den Zugriff auf Protokolle, definieren Sie Aufbewahrungsfristen und vermeiden Sie standardmäßig die Erfassung von Rohdaten wie Eingabeaufforderungen und Tool-Payloads, wenn diese Kundengeheimnisse enthalten.
NIST SP 800-53 Revision 5.1 beinhaltet Prüf- und Verantwortlichkeitskontrollen, die die Auswahl und Überprüfung sicherheitsrelevanter Ereignistypen zur Untersuchung von Vorfällen in den Vordergrund stellen. Für ein KI-Unterstützungssystem sind beispielsweise verweigerter Datenzugriff, Auslösung von Schwärzungsmaßnahmen, ungewöhnlich hohes Datenvolumen, wiederholte Eingabeaufforderungsversuche, blockierte Tool-Aufrufe, mandantenübergreifende Autorisierungsfehler und Verstöße gegen Ausgaberichtlinien nützliche Ereignisse.
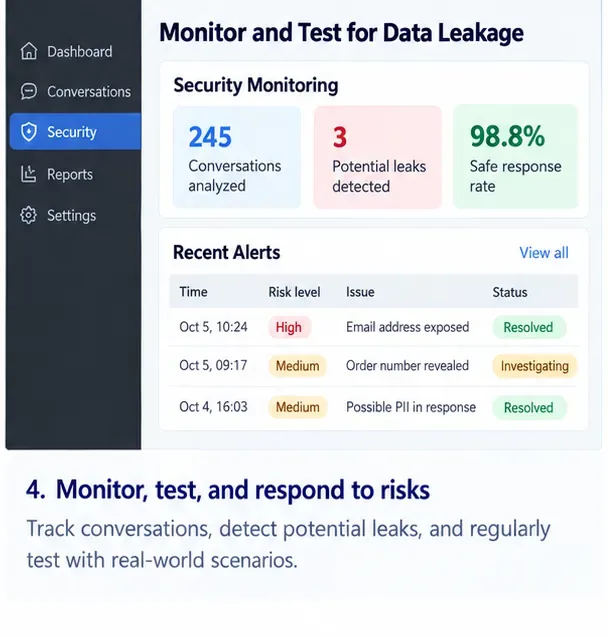
Überwachen Sie sowohl Präventionsereignisse als auch Beinahe-Unfälle. Ein plötzlicher Anstieg abgelehnter kundenübergreifender Abfragen oder geschwärzter Ausgaben kann auf ein neues Angriffsmuster oder einen unterbrochenen Datenfluss hinweisen.
Führen Sie vor dem Start und nach wesentlichen Änderungen an Eingabeaufforderungen, Modellen, Tools, Abrufindizes, Zugriffsrichtlinien oder dem Speicherverhalten eine wiederholbare Sicherheitstestsuite durch. Diese sollte direkte Eingabeaufforderungsmanipulation, indirekte Manipulation in abgerufenen Dokumenten, Anfragen nach Kundendaten, verschlüsselte oder verschleierte Kennungen, Tool-Missbrauch, mehrfache Versuche zur Umgehung von Richtlinien sowie Versuche, den Agenten zur Offenlegung seines internen Kontexts zu veranlassen, umfassen.
Welche Kontrollmechanismen sind für die verschiedenen Kundendienstmitarbeiter am wichtigsten?
Agententyp
Kontrollen mit höchster Priorität
Warum
Öffentlicher FAQ-Bot
Eingabeminimierung, sichere Protokollierung, Filterung von Eingabeaufforderungen, Ausgabeprüfungen
Es sollte überhaupt keine privaten Kundendaten benötigen.
Auftragsstatusassistent
Starke Authentifizierung, Eigentumsprüfungen, API-Antworten auf Feldebene, Mandantenisolation
Es werden einige Kundendaten benötigt, jedoch nur für den verifizierten Benutzer und die aktuelle Bestellung.
Kundenbetreuer
CRM-Tools mit minimalen Berechtigungen, Schwärzung personenbezogener Daten, Ausgabedatenschutz, Speicherisolierung, Eskalation
Es verarbeitet umfangreichere personenbezogene Daten und kann auf mehrere Systeme zugreifen.
Rückerstattungs- oder Stornierungsagent
Alles oben Genannte plus deterministische Geschäftsregeln, Transaktionslimits, Bestätigungen und Prüfprotokolle
Der Agent kann den realen Zustand verändern, daher sind sowohl Datenlecks als auch unautorisierte Aktionen relevant.
Ein einziger Fehler beim Datenabruf kann die Daten einer Organisation einer anderen Organisation offenlegen.
Eine Checkliste für den Einsatz, bevor Sie den Agenten mit Kunden in Kontakt bringen.
Erfassen Sie alle Orte, an denen sensible Daten eingegeben, abgerufen, generiert, protokolliert oder gespeichert werden können.
Entfernen Sie Felder, die das Modell nicht benötigt, und tokenisieren Sie Bezeichner, wenn der Rohwert nicht erforderlich ist.
Authentifizieren Sie den Kunden vor dem Abruf privater Daten und autorisieren Sie jede Ressource außerhalb des LLM.
Jedem Werkzeug sollten die minimalen Fähigkeiten und der minimale Datenumfang zugewiesen werden, die für seine jeweilige Funktion erforderlich sind.
Halten Sie Anmeldeinformationen, API-Schlüssel, Verbindungszeichenfolgen und sicherheitskritische Berechtigungslogik aus den Eingabeaufforderungen heraus.
Benutzerinhalte, Dokumente, Suchergebnisse und Modellausgaben sind als nicht vertrauenswürdige Eingaben zu behandeln.
Die Argumente des Tools werden validiert und die Antworten gefiltert, bevor sie Benutzer oder nachgelagerte Systeme erreichen.
Die Berechtigungen für Mandanten und Dokumente sollten vor dem Abruf durchgesetzt werden, nicht erst nachdem das Modell die Daten gesehen hat.
Sensible Felder in Traces und Logs maskieren und den Zugriff auf Überwachungssysteme einschränken.
Kontinuierliche Tests von direkter und indirekter Prompt-Injektion, kundenübergreifendem Zugriff und risikoreichen Tool-Aktionen sind durchzuführen.
Wie man erkennt, ob die Bedienelemente tatsächlich funktionieren
Die Sicherheit sollte nicht allein daran gemessen werden, wie oft der Chatbot verdächtige Anfragen höflich ablehnt. Messen Sie vielmehr, ob das zugrundeliegende System verhindert hat, dass sensible Daten durch eine Antwort oder eine Tool-Aktion in den Modellkontext gelangen oder diesen verlassen.
Nützliche Kennzahlen für die technische Bewertung umfassen den Prozentsatz blockierter Anfragen nach privaten Daten vor deren Abruf, fehlgeschlagene mandantenübergreifende Autorisierungen, die Genauigkeit der Schwärzung in bekannten Testfällen, die Blockierung sensibler Ausgaben, unautorisierte Tool-Aufrufe, den Prozentsatz risikoreicher Aktionen, die eine Bestätigung erfordern, und die Zeitspanne von der Erkennung bis zur Untersuchung. Testdatensätze sollten synthetisch oder ordnungsgemäß verwaltet sein, damit Ihre Sicherheitsbewertung kein neues Datenschutzproblem verursacht.
Fazit
Der sicherste KI-Agent im Kundenservice ist nicht der mit der längsten Sicherheitsabfrage. Er arbeitet innerhalb eines klar definierten, nachvollziehbaren Datenpfads. Geben Sie ihm nur die Datensätze, die für den aktuell verifizierten Kunden benötigt werden, nur die Tools, die für die aktuelle Aufgabe erforderlich sind, und nur die Berechtigungen, die für diesen Tool-Aufruf notwendig sind. Filtern Sie die Daten vor der Datenverarbeitung, validieren Sie die Ergebnisse nach der Verarbeitung und stellen Sie Identität und Autorisierung unabhängig vom Modell sicher.
Modellbasierte Anweisungen sollten als eine Ebene, nicht als letzte Barriere dienen. Wenn sensible Daten durch deterministische Zugriffskontrollen, minimierten Kontext, Least-Privilege-Tools, Mandantenisolation, Ausgabevalidierung, sichere Protokollierung und kontinuierliche Tests geschützt sind, ist die Wahrscheinlichkeit eines Datenlecks durch eine fehlerhafte Eingabe oder einen Modellfehler deutlich geringer.