Inicio
» Dominios
»
Cómo configurar una base de conocimientos de IA local y privada para documentos personales
Cómo configurar una base de conocimientos de IA local y privada para documentos personales
La respuesta práctica más sencilla: ejecuta el modelo de lenguaje, el modelo de incrustación, el índice de documentos y la interfaz de chat en tu propio ordenador. Una pila sencilla consiste en Ollama para el servicio de modelos local, junto con AnythingLLM autoalojado para la ingesta de documentos, la generación aumentada de recuperación (RAG) y el chat. Mantén la base de datos de vectores localmente, utiliza almacenamiento persistente, evita los proveedores de modelos en la nube y comprueba que las respuestas se basan realmente en tus archivos.
Ejemplo ilustrativo: a lo largo de esta guía, imagina que Jordan está organizando una colección personal que incluye manuales del hogar, documentos PDF sobre seguros, actas de reuniones, una guía de finanzas personales y algunos informes de proyectos. Jordan es un personaje ficticio. Los archivos, preguntas, respuestas y resultados que se describen a continuación son ejemplos para explicar el flujo de trabajo, no resultados de pruebas ni testimonios.
Esta guía utiliza una configuración de cuatro pasos para que el límite de privacidad sea comprensible. Es adecuada para una persona o un pequeño grupo familiar de confianza que desee realizar búsquedas de documentos y responder preguntas localmente. Si necesita controles de identidad empresariales, disponibilidad en múltiples nodos, auditoría centralizada o garantías regulatorias, debe considerar esta guía como una arquitectura inicial, no como una solución de cumplimiento completa.
Qué significa realmente “base de conocimiento de IA local privada”
Una base de conocimiento local no es lo mismo que entrenar un modelo con tus documentos. En un flujo de trabajo RAG típico, el sistema extrae texto de tus archivos, lo divide en fragmentos, convierte esos fragmentos en incrustaciones numéricas, los almacena en una base de datos vectorial, recupera los fragmentos relevantes para cada pregunta y envía solo esos fragmentos al modelo de lenguaje como contexto.
La documentación actual de AnythingLLM describe los flujos de trabajo de documentos adjuntos e incrustados. Los documentos adjuntos pueden insertar texto completo en un chat cuando la ventana de contexto lo permite, mientras que RAG recupera fragmentos relevantes de los documentos incrustados. Su documentación actual de LanceDB local también indica que la instancia predeterminada de LanceDB almacena el texto y las incrustaciones de los documentos dentro de la aplicación AnythingLLM. Consulte la documentación del flujo de trabajo de documentos de AnythingLLM y la documentación de LanceDB de AnythingLLM .
Componente
Rol en la pila local
Elección que respeta la privacidad
Ollama
Ejecuta el modelo de chat y, opcionalmente, un modelo de incrustación en su máquina.
Utilice un modelo local, no un punto final de modelo alojado en la nube.
Cualquier cosaLLM
Proporciona la interfaz de usuario, la gestión de documentos, la segmentación, el formato RAG y la organización del espacio de trabajo.
Ejecútalo localmente y mantén su directorio de almacenamiento persistente.
Modelo de incrustación
Convierte fragmentos de documentos y consultas en vectores para la recuperación semántica.
Utilice un incrustador local si los documentos no deben enviarse a un servicio externo.
LanceDB
Almacena vectores utilizados para encontrar pasajes relevantes.
Mantén la instancia local predeterminada a menos que necesites intencionalmente una base de datos remota.
Archivos originales y copias de seguridad
Sigue siendo la fuente autorizada.
Protéjalos con los controles de acceso habituales del sistema operativo, cifrado y copias de seguridad.
Antes de comenzar: defina el límite de privacidad.
La pregunta clave no es "¿La aplicación es local?", sino "¿Qué componentes pueden enviar texto o mensajes de documentos fuera del equipo?". Una interfaz de usuario local aún puede configurarse para llamar a un LLM en la nube, una API de incrustación en la nube, una búsqueda web o herramientas remotas. Para una configuración privada, mantenga el LLM, el incrustador y la base de datos vectorial en local, a menos que haya aceptado deliberadamente las implicaciones de compartir datos de un proveedor externo.
AnythingLLM documenta la telemetría anónima y ofrece una forma de desactivarla. Su documentación sobre privacidad también distingue entre eliminar un documento de un espacio de trabajo y eliminarlo por completo de la biblioteca de documentos. Para eliminarlo por completo dentro de AnythingLLM, la documentación actual indica que se debe eliminar el documento de Mis documentos , lo que elimina el código fuente analizado, las incrustaciones en caché y las referencias al espacio de trabajo. Consulte la documentación de privacidad y gestión de datos de AnythingLLM antes de agregar material confidencial.
También necesitas suficiente memoria para el modelo local que elijas. No existe un tamaño de modelo único y correcto, ya que la velocidad útil depende de la CPU, la GPU, la RAM o la VRAM, la cuantización, la longitud del contexto y la cantidad de documentos recuperados. Empieza con un modelo que se ajuste cómodamente en lugar de elegir el modelo más grande que tu máquina apenas pueda cargar.
Paso 1: Instale Ollama y prepare los modelos de chat local e incrustación.
Instala Ollama siguiendo las instrucciones vigentes para tu sistema operativo. Ollama está disponible para macOS, Windows y Linux, y su API local se ejecuta en el puerto 11434 por defecto. La guía de inicio rápido oficial de Ollama es la mejor fuente para obtener información actualizada sobre la instalación y la sintaxis de los comandos.
Tras la instalación, seleccione un modelo de chat que se adapte a su hardware. El modelo exacto no se especifica aquí, ya que el catálogo de modelos cambia y los requisitos de hardware varían. Un comando típico tiene este formato:
ollama pull <chat-model-name>
Para RAG, también necesitas un modelo de incrustación. La documentación actual de incrustaciones de Ollama, revisada en septiembre de 2026, enumera modelos como embeddinggemma, qwen3-embedding, y all-minilmcomo opciones de incrustación recomendadas. Puedes revisar la lista actual en la documentación de incrustaciones de Ollama . Por ejemplo:
ollama pull embeddinggemma
No utilice un modelo de chat normal como modelo de incrustación solo porque aparezca en un menú desplegable de modelos. La documentación actual del incrustador Ollama de AnythingLLM advierte explícitamente que Ollama puede mostrar tanto modelos de chat como modelos de incrustación en la misma lista. Utilice un modelo de incrustación real para la indexación de documentos. Consulte la configuración del incrustador Ollama de AnythingLLM .
Diagrama de flujo de terminal para descargar un modelo local con Ollama. El número de versión que se muestra en este ejemplo no es una recomendación de versión actual; verifique la versión instalada con la documentación oficial de Ollama.
En el caso del modelo ficticio de Jordan, el objetivo en esta etapa es sencillo: tanto la generación como la incrustación deberían ser posibles sin necesidad de enviar los documentos domésticos a una API remota.
Paso 2: Ejecute AnythingLLM localmente con almacenamiento persistente y conéctelo a Ollama.
AnythingLLM ofrece opciones de escritorio y autoalojadas. Esta guía utiliza Docker porque el almacenamiento es explícito y fácil de respaldar. Su documentación actual de Docker local indica a los usuarios que descarguen la imagen y enfatiza que se requiere almacenamiento persistente, de lo contrario, se pueden perder datos de la aplicación al recrear el contenedor. También indica que la aplicación web está disponible en [dirección web] http://localhost:3001. Utilice la guía oficial de Docker local de AnythingLLM en lugar de copiar un comando antiguo de un foro.
docker pull mintplexlabs/anythingllm:latest
Al ejecutar el contenedor, preserve el almacenamiento de AnythingLLM montando un directorio del host en /app/server/storage. La documentación del proveedor especifica que el montaje persistente es necesario. Mantenga ese directorio de almacenamiento en un disco incluido en su plan de copia de seguridad.
Luego configure el proveedor LLM como Ollama. Si AnythingLLM se ejecuta directamente en el host, la dirección Ollama predeterminada documentada es http://127.0.0.1:11434. Si AnythingLLM se ejecuta dentro de Docker mientras Ollama se ejecuta en el host, no use localhostdesde dentro del contenedor. La documentación de redes de Docker de AnythingLLM dice que use http://host.docker.internal:11434en plataformas de escritorio compatibles; en Linux documenta 172.17.0.1para este patrón de conexión de host. Consulte la nota de redes de localhost de AnythingLLM y la configuración LLM de Ollama .
En la configuración, seleccione Ollama como proveedor de LLM y, si lo desea, como proveedor de incrustación. Seleccione el modelo de chat para la generación y el modelo de incrustación para la indexación. Mantener estas funciones separadas evita un error de configuración común.
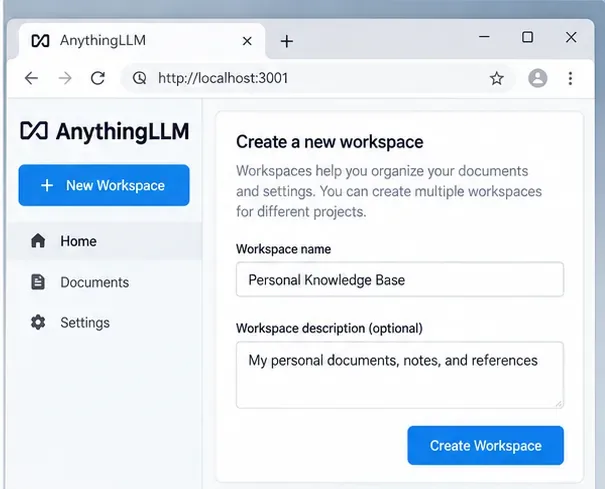
AnythingLLM autoalojado está documentado para ejecutarse en localhost:3001. Un espacio de trabajo dedicado le da a una colección de documentos un propósito claro y mantiene el material no relacionado fuera del grupo de recuperación.
Jordan crea un espacio de trabajo llamado "Base de Conocimiento Personal" y evita conectarse a proveedores de modelos en la nube. Esto facilita la auditoría posterior del límite previsto: interfaz de usuario local, modelo de lenguaje natural local, incrustaciones locales, vectores locales.
Paso 3: Añada documentos, elija RAG o adjunto de texto completo y verifique la ingesta.
No empieces subiendo todo tu disco duro. Comienza con un pequeño conjunto representativo de documentos cuyo contenido conozcas bien. Esto te permitirá detectar problemas de extracción o recuperación de forma controlada antes de que el índice crezca.
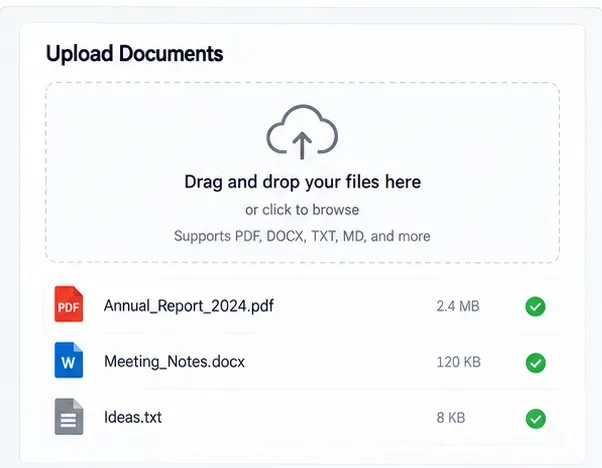
En el ejemplo de Jordan, un primer lote útil podría incluir un PDF con texto seleccionable, un archivo DOCX y una nota en texto plano o Markdown. Si los PDF escaneados contienen imágenes en lugar de texto seleccionable, confirme que el método de procesamiento de documentos elegido extrae el texto necesario; un archivo que le parezca legible aún puede generar una representación de texto vacía o deficiente para RAG.
AnythingLLM actualmente admite dos comportamientos generales de documentos:
Documentos adjuntos: útiles cuando el texto completo cabe dentro de la ventana de contexto del modelo y se desea que el modelo vea el archivo completo para ese hilo.
Documentos incrustados con RAG: útiles para colecciones grandes o reutilizables. El sistema divide el contenido en fragmentos, lo incrusta y recupera las partes relevantes para una pregunta.
La guía de documentación actual de AnythingLLM indica que los documentos integrados en un espacio de trabajo estarán disponibles para todos los subprocesos de ese espacio. Esto resulta práctico, pero también implica que la pertenencia a un espacio de trabajo forma parte de su modelo de privacidad en implementaciones multiusuario. Mantenga los espacios de trabajo personales separados de cualquier espacio de trabajo compartido.
Ejemplo de vista de ingesta con varios tipos de documentos. Utilice primero un lote pequeño y fiable, luego verifique la extracción y la indexación antes de agregar un archivo grande.
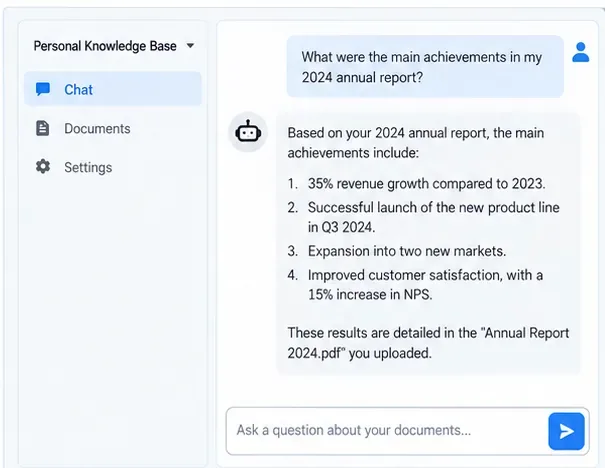
Tras la incrustación, formule una pregunta cuya respuesta aparezca en un solo archivo. A continuación, solicite un detalle que no aparezca en ningún archivo. La primera pregunta evalúa la recuperación; la segunda evalúa si el modelo admite incertidumbre en lugar de inventar una respuesta.
Qué ajustar si la recuperación es débil
AnythingLLM expone controles RAG a nivel de espacio de trabajo, como preferencias de búsqueda, fragmentos de contexto máximos y umbral de similitud de documentos. Su documentación recomienda comenzar con la configuración del espacio de trabajo en lugar de asumir que el problema reside en el modelo base. Aumentar el contexto recuperado puede ser útil cuando la respuesta abarca varias secciones, pero enviar demasiados fragmentos también puede añadir texto irrelevante y consumir la capacidad de la ventana de contexto.
Si modifica los modelos de incrustación después de la indexación, vuelva a incrustar los documentos afectados de manera que los vectores almacenados y los vectores de consulta provengan del mismo espacio de incrustación. Combinar incrustaciones de diferentes modelos no constituye una estrategia de recuperación eficaz.
Paso 4: Pruebe las respuestas fundamentadas, proteja la privacidad y haga una copia de seguridad de la base de conocimientos.
Una base de conocimientos solo es útil si se puede detectar cuándo es errónea. Crea una pequeña lista de evaluación a partir de hechos que puedas verificar directamente. Por ejemplo:
Solicite que la fecha, el importe, el modelo del producto o la cláusula de la póliza aparezcan textualmente en un solo documento.
Formula una pregunta que abarque varios documentos y que requiera información de dos archivos.
Formula una pregunta deliberadamente imposible de responder y comprueba que la respuesta no invente una fuente.
Formula la misma pregunta con una redacción diferente para comprobar si la recuperación de la información es estable.
Abra el documento fuente y confirme manualmente cada afirmación de gran importancia.
Respuesta hipotética basada en documentos, utilizada para ilustrar el paso de verificación. Las figuras mostradas son ejemplos ficticios; en una base de conocimiento real, verifique las afirmaciones importantes con el archivo original.
Para Jordan, una buena regla de aceptación no es que "la respuesta parezca correcta", sino que "la respuesta coincida con la fuente, incluya el contexto necesario y falle de forma segura cuando la fuente no contenga la información". Esta regla es especialmente importante en el ámbito de los impuestos, los seguros, los documentos legales, los historiales médicos o las decisiones financieras.
Mantén la configuración en privado una vez que funcione.
La inferencia local reduce la exposición de datos, pero la privacidad sigue dependiendo de la configuración. Utilice estos controles como una lista de verificación práctica:
Mantenga el servicio AnythingLLM vinculado a la máquina local o a una red privada de confianza, a menos que el acceso remoto esté protegido intencionalmente.
No añada integraciones de LLM en la nube, incrustación en la nube, búsqueda web, navegador o agentes a un espacio de trabajo que contenga material confidencial a menos que comprenda qué transmiten dichas integraciones.
Desactive la telemetría anónima si su política de privacidad exige que no se registre ningún dato de telemetría del producto.
Utilice el cifrado de disco y los permisos de cuenta de su sistema operativo. Una base de datos de vectores local sigue siendo legible si un atacante obtiene acceso al equipo.
Elimine los archivos confidenciales de la biblioteca de documentos, no solo de un espacio de trabajo, cuando desee eliminarlos por completo dentro de AnythingLLM.
Actualizar Ollama, AnythingLLM, Docker y el sistema operativo anfitrión. "Sin conexión" no significa "sin mantenimiento".
Haz copias de seguridad de las piezas que sean difíciles de recrear.
Los documentos originales siguen siendo la fuente de información principal, pero el directorio de almacenamiento de AnythingLLM contiene la base de datos de la aplicación, los documentos analizados, los datos vectoriales y la configuración necesaria para evitar tener que reconstruir todo tras un fallo del disco. Realice una copia de seguridad tanto de la carpeta de documentos original como del almacenamiento persistente de AnythingLLM. Si utiliza volúmenes de Docker en lugar de un directorio del host montado mediante enlace, siga la documentación oficial de Docker sobre copias de seguridad y restauración de volúmenes .
Pruebe la restauración, no solo la creación de copias de seguridad. Una copia de seguridad solo se considera válida cuando puede restaurarla en otro directorio o máquina, iniciar la pila local, abrir el espacio de trabajo y recuperar correctamente un dato conocido.
Cuándo esta configuración es adecuada y cuándo no lo es.
Esta arquitectura resulta ideal si su prioridad es almacenar documentos personales en hardware que usted controla, si se siente cómodo ejecutando software localmente y si desea realizar búsquedas semánticas y obtener respuestas en lenguaje natural en una biblioteca de documentos de tamaño moderado. También es útil cuando el acceso a internet es inestable o si desea prever los costos locales tras la descarga de los modelos.
Resulta menos adecuado si su equipo no puede ejecutar un modelo local apropiado, necesita acceso sin interrupciones desde múltiples dispositivos fuera de su red doméstica o requiere identidad, auditoría, retenciones legales, administración centralizada de claves o soporte garantizado de nivel empresarial. En esos casos, la solución más apropiada podría ser una implementación privada administrada o una plataforma RAG empresarial, en lugar de una configuración de un solo PC.
Lista de verificación de configuración compacta
Instale Ollama y verifique la inferencia del modelo local.
Instale un modelo de incrustación específico, como alguno de los que aparecen en la documentación actual de incrustaciones de Ollama.
Ejecuta AnythingLLM localmente con almacenamiento persistente.
Conecte AnythingLLM al punto final local de Ollama utilizando la dirección de host correcta para su método de implementación.
Utilice una base de datos vectorial local, como LanceDB, la base de datos predeterminada de AnythingLLM, cuando el objetivo sea la recuperación de documentos exclusivamente local.
Crea un espacio de trabajo con un alcance limitado.
Empiece con algunos documentos conocidos y verifique la extracción.
Utilice RAG para colecciones grandes y reutilizables, y adjunte el texto completo solo cuando el documento se ajuste cómodamente al contexto del modelo.
Pruebe las preguntas que se pueden responder y las que no, antes de confiar en el sistema.
Desactive las integraciones externas y la telemetría innecesarias según sus requisitos de privacidad.
Realice una copia de seguridad tanto de los documentos de origen como del almacenamiento persistente de la aplicación y, a continuación, pruebe la restauración.