Inicio
» Dominios
»
Cómo reducir el tiempo de renderizado en ComfyUI para un flujo de trabajo SDXL
Cómo reducir el tiempo de renderizado en ComfyUI para un flujo de trabajo SDXL
La forma más rápida de reducir el tiempo de renderizado en un flujo de trabajo SDXL de ComfyUI suele ser disminuir la cantidad de trabajo de difusión antes de modificar los parámetros de lanzamiento de bajo nivel: prueba con una resolución SDXL adecuada, mantén el tamaño del lote en 1 durante el ajuste, utiliza menos pasos de muestreo cuando la calidad se mantiene y omite temporalmente los extras costosos como refinadores, ramas de ControlNet, pases de escalado o preprocesadores. Solo después de esto deberías ajustar la VRAM, la atención, la vista previa y el comportamiento de la caché.
Este orden es importante porque las opciones de inicio no pueden compensar un flujo de trabajo que simplemente le exige a la GPU realizar dos o tres veces más trabajo del necesario. La documentación actual de ComfyUI también recomienda reducir primero la resolución o el tamaño del lote cuando la generación es lenta, y luego usar optimizaciones de memoria y atención según sea necesario. Las siguientes recomendaciones se verificaron con la documentación actual de ComfyUI y PyTorch el 13 de septiembre de 2026.
¿Por qué los flujos de trabajo SDXL se ralentizan en ComfyUI?
Un renderizado SDXL puede emplear tiempo en varias etapas: carga o redistribución de pesos del modelo, codificación de texto CLIP, eliminación repetida de ruido dentro de KSampler, ControlNet u otros procesos de acondicionamiento, decodificación VAE, escalado y cualquier etapa de refinamiento o segunda pasada. Si la VRAM es limitada, las transferencias adicionales de CPU a GPU pueden aumentar aún más la latencia.
Esto significa que dos usuarios con la misma GPU pueden experimentar tiempos de renderizado muy diferentes. Un gráfico básico de conversión de texto a imagen de 1024 clases no es comparable a un flujo de trabajo que incluye un refinador, dos ControlNets, una segunda pasada de alta resolución y un procesamiento por lotes grande. El objetivo es identificar qué parte del gráfico consume muchos recursos y, a continuación, eliminar u optimizar esa parte sin sacrificar la calidad de salida que realmente importa.
1. Establezca una línea de base limpia antes de cambiar nada.
Utilice una solicitud fija, una semilla fija, un tamaño de lote de 1 y la misma resolución de salida. Ejecute el flujo de trabajo al menos dos veces. La primera ejecución puede incluir la carga de puntos de control, la compilación, la entrada/salida de disco o la transferencia de modelos; una ejecución posterior proporciona una mejor medida de la velocidad de generación en estado estable.
Compruebe también si la GPU está realizando el trabajo. En los sistemas NVIDIA, nvidia-smise puede visualizar el uso de la VRAM y la utilización de la GPU. Si la utilización de la GPU se mantiene baja mientras el sistema transfiere datos o carga modelos constantemente, el cuello de botella podría deberse a la presión de la memoria o a las operaciones de entrada/salida, en lugar de al propio muestreador.
Compruebe el comportamiento de la GPU y la VRAM antes de optimizar ComfyUI. Considere los valores mostrados aquí como un ejemplo de diseño, no como un objetivo de referencia para las pruebas de rendimiento.
2. Empiece por el gráfico SDXL más pequeño que produzca el resultado que necesita.
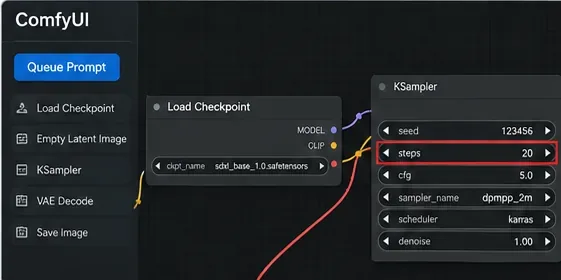
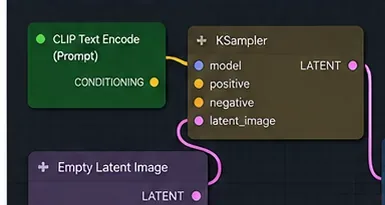
Antes de optimizar un flujo de trabajo complejo, compárelo con una ruta mínima: carga de punto de control, acondicionamiento de la solicitud, una imagen latente vacía, KSampler, decodificación VAE y guardado de la imagen. Los ejemplos oficiales de ComfyUI muestran que el punto de control base SDXL se puede usar como un punto de control normal. Si este gráfico básico es rápido, pero su gráfico de producción es lento, las ramificaciones adicionales son el problema.
Para la fase de borrador, omita temporalmente los componentes que no sean esenciales para la decisión actual. Algunos ejemplos son el refinador, una segunda pasada de escalado, los preprocesadores de imágenes, las múltiples ControlNets o las ramas de estilo opcionales. Vuelva a habilitarlos uno por uno una vez que la imagen base sea aceptable.
Un gráfico SDXL pequeño es la mejor referencia. Añade ramas costosas solo después de saber cuánto tiempo consume cada una.
3. Reduce los pasos de KSampler antes de buscar configuraciones de velocidad extremas.
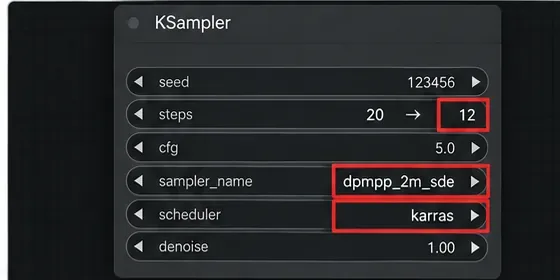
Los pasos de muestreo son uno de los factores más importantes, ya que cada paso adicional de reducción de ruido incrementa el trabajo. Si se reducen los pasos de un valor alto a uno bajo, la parte de muestreo del renderizado debería acortarse, aunque el tiempo total de ejecución no disminuirá exactamente en el mismo porcentaje, puesto que la carga del modelo, la codificación de la solicitud, la decodificación VAE y otros nodos siguen consumiendo tiempo.
No copies el número de pasos óptimo de otra persona. El número correcto depende del punto de control, el muestreador, el programador, la solicitud, el CFG y el objetivo de calidad. Un método práctico consiste en mantener la semilla fija y probar una pequeña escalera; por ejemplo, tu configuración actual, luego una reducción moderada y después otra reducción. Detente cuando las texturas, la anatomía, la tipografía o la fidelidad de la solicitud se degraden más de lo que estás dispuesto a aceptar.
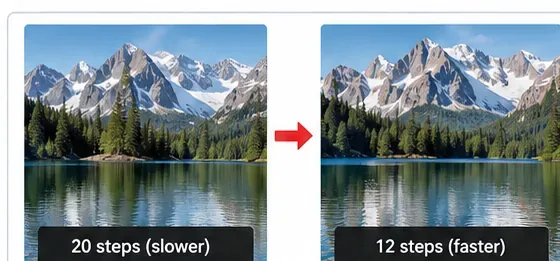
Reducir los pasos de KSampler puede disminuir el tiempo de eliminación de ruido. Los valores mostrados son ilustrativos; verifique la calidad con su propio punto de control y semilla fija.
4. Mantenga bajo control la resolución de las pruebas y el tamaño del lote.
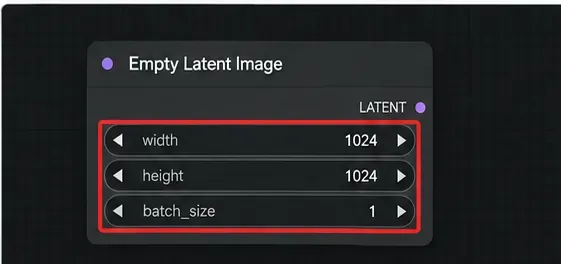
Para SDXL, los ejemplos oficiales de ComfyUI recomiendan una relación de aspecto de 1024×1024 u otras con una cantidad de píxeles similar, como 896×1152 o 1536×640, para un comportamiento óptimo del modelo base. Superar sustancialmente ese límite de píxeles aumenta el tamaño latente y, por lo tanto, el uso de memoria y capacidad de procesamiento.
Durante la optimización de la solicitud y el flujo de trabajo, manténgalo batch_sizeen 1 a menos que necesite específicamente realizar pruebas de rendimiento. Un lote de cuatro solicita al proceso que genere cuatro imágenes en una sola ejecución; esto puede mejorar el rendimiento en algunas configuraciones, pero no es la forma de minimizar el tiempo hasta la primera imagen y aumenta los requisitos de memoria.
Si el resultado final debe ser mayor que la resolución base normal de SDXL, considere separar las pruebas de composición de la pasada final de alta resolución. Asegúrese primero de que la imagen inicial, la semilla, el acondicionamiento y la composición sean correctos, y luego pague por el costoso escalado o la segunda pasada solo en los candidatos seleccionados.
Un conjunto latente de 1024 clases con un tamaño de lote de 1 es una base de ajuste SDXL sensata antes de realizar ejecuciones de mayor resolución o con múltiples imágenes.
5. Comparar el rendimiento de los muestreadores y planificadores en lugar de asumir que uno siempre es el más rápido.
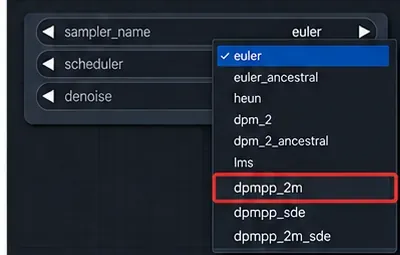
ComfyUI ofrece múltiples opciones de muestreador y planificador en KSampler. Diferentes combinaciones pueden lograr una calidad aceptable en diferentes cantidades de pasos, por lo que "más rápido" debería significar el más rápido con la calidad que necesitas , no simplemente la ejecución individual más corta.
Al comparar, utilice el mismo punto de control, solicitud, semilla, resolución y CFG. Modifique únicamente el muestreador o el programador y compare tanto el tiempo de renderizado como la calidad visible. Si una combinación requiere muchos menos pasos para el punto de control, manteniendo el resultado deseado, supone una clara ventaja en velocidad. Si requiere pasos adicionales para recuperar el detalle, la ventaja aparente podría desaparecer.
Modifique una variable del muestreador a la vez y compare con una semilla fija. No asuma que un muestreador es más rápido para cada punto de control SDXL o objetivo de calidad.
6. Elimine el trabajo redundante con los gráficos y aproveche el modelo de ejecución de ComfyUI.
ComfyUI está diseñado para ejecutar únicamente las partes del gráfico que sean necesarias. Su documentación indica que las partes sin cambios pueden reutilizarse entre ejecuciones, y el backend actual incluye almacenamiento en caché configurable de los resultados de los nodos. Esto resulta útil cuando se modifica solo un valor posterior en lugar de reconstruir todo el flujo de trabajo.
Mantenga estables los nodos de carga y el procesamiento ascendente costoso siempre que sea posible. Si cambia constantemente los puntos de control, redimensiona repetidamente imágenes grandes o invalida los nodos ascendentes, pierde la ventaja del trabajo almacenado en caché.
ComfyUI también cuenta con una función documentada de ejecución parcial que permite ejecutar únicamente la parte de un flujo de trabajo necesaria para un nodo de salida seleccionado. Úsela cuando esté probando una rama posterior y no necesite regenerar todas las salidas de un gráfico extenso.
Un gráfico simplificado facilita la identificación de cuellos de botella. Utilice el almacenamiento en caché y la ejecución parcial para evitar que el trabajo previo sin cambios se repita innecesariamente.
7. Ajuste las vistas previas, el almacenamiento en caché, el modo VRAM y la atención solo después de que el gráfico sea eficiente.
Las opciones de línea de comandos actuales de ComfyUI ofrecen varios controles de rendimiento. Sus efectos dependen del hardware y la memoria disponible, por lo que conviene considerarlas como posibles pruebas de rendimiento en lugar de opciones obligatorias.
Configuración
Cuando pueda ayudar
Principal compensación
--preview-method none
Si las vistas previas del muestreador están habilitadas y solo le interesa el resultado final.
Se pierden las vistas previas latentes en tiempo real. La interfaz de línea de comandos actual ya no utiliza vistas previas por defecto.
--highvram
Si tienes suficiente VRAM y la descarga/recarga repetida del modelo te está costando tiempo
Mantiene los modelos en la memoria de la GPU y puede provocar errores de falta de memoria en tarjetas gráficas con recursos limitados.
--lowvram
Si el flujo de trabajo no cabe en la VRAM,
Este es principalmente un modo de ahorro de memoria, no un modo de velocidad; el uso de la CPU o las transferencias pueden aumentar la latencia.
--use-pytorch-cross-attention
Merece la pena realizar pruebas de rendimiento en combinaciones modernas de PyTorch/GPU.
No combines indiscriminadamente indicadores de modo de atención mutuamente excluyentes.
--use-flash-attention
Merece la pena probarlo cuando su pila de hardware/software admite la ruta optimizada.
La disponibilidad y los beneficios dependen de los insumos y núcleos compatibles.
--cache-classico--cache-lru N
Flujos de trabajo repetitivos donde se acepta memoria caché adicional
Puede utilizar más RAM/VRAM.
--cache-none
Solo cuando reducir la memoria caché sea más importante que la velocidad.
La propia interfaz de línea de comandos de ComfyUI indica que cada nodo se ejecutará en cada ejecución, por lo que suele ser peor para el tiempo de renderizado.
La interfaz de línea de comandos actual también permite la descarga de peso asíncrona, y su texto de ayuda indica que está habilitada por defecto en NVIDIA. Esto significa que añadir más parámetros no supone automáticamente una optimización; primero, compruebe su comando de inicio y los registros.
El mecanismo de atención de producto escalar escalado de PyTorch puede seleccionar automáticamente implementaciones CUDA optimizadas, como FlashAttention o la atención eficiente en memoria, cuando las entradas y el hardware lo permiten. Por eso, las rutas de atención modernas pueden ser importantes, pero la mejora exacta depende del hardware. Evite citar un porcentaje genérico como si se aplicara a su flujo de trabajo SDXL.
8. Mantén el comportamiento de la cola y del lote alineado con tu objetivo.
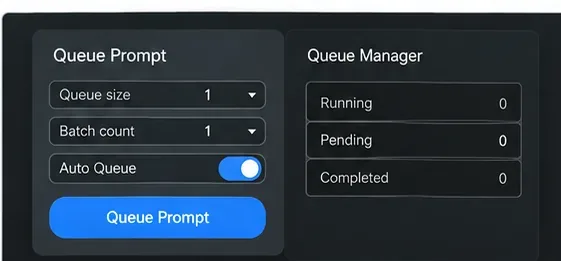
Si su prioridad es obtener la retroalimentación más rápida, ponga en cola una imagen a la vez durante el proceso de ajuste. Las colas grandes y los lotes son útiles cuando ya se conocen los ajustes y se busca un alto rendimiento, pero no aceleran la llegada de la primera imagen.
Una vez finalizado el flujo de trabajo, se puede evaluar el rendimiento por separado. En ese momento, un lote más grande podría ser conveniente si la VRAM lo permite y si el número total de imágenes por minuto es más importante que la latencia por imagen.
Utilice una imagen en cola y un tamaño de lote de 1 para el ajuste interactivo; pruebe lotes más grandes más adelante cuando el objetivo sea el rendimiento.
Cómo saber si la optimización realmente funcionó.
Una ejecución más rápida solo es útil si la imagen aún cumple con el objetivo. Compara el antes y el después con la misma semilla y la misma consigna. Verifica primero las áreas que fallan cuando la configuración es demasiado agresiva: texto pequeño, manos y rostros, patrones repetitivos, materiales finos, detalles de los bordes y cumplimiento de los atributos específicos de la consigna.
Registre al menos estos cuatro datos para cada prueba: tiempo total de ejecución, pasos de muestreo, resolución y si se realizó la carga del modelo. Si la primera ejecución tarda 30 segundos y la segunda 12 segundos, no acredite automáticamente un cambio de muestreador; es posible que la primera ejecución simplemente haya cubierto el costo de carga del punto de control.
Utilice comparaciones paralelas con semilla fija para decidir si un número de pasos menor es aceptable. Las etiquetas que se muestran ilustran el método y no representan resultados de referencia.
Un orden de optimización práctico
Realiza una prueba comparativa con una ejecución en caliente. Mantén fijos el valor de la semilla, el indicador, la resolución y el lote.
Elimine las ramas innecesarias. Pruebe la ruta base SDXL sin refinador, ControlNet, escalado ni preprocesadores opcionales.
Reduce los pasos. Encuentra la cantidad mínima que aún cumpla con tus estándares de calidad.
Mantén una resolución razonable. Ajusta la resolución al límite de píxeles de 1024 de la SDXL antes de aplicar el acabado de alta resolución.
Mantén el tamaño del lote en 1 durante la iteración. Optimiza el rendimiento solo después de que el flujo de trabajo sea estable.
Compare las opciones de muestreador/planificador. Evalúe la velocidad manteniendo una calidad aceptable equivalente.
Utilice el almacenamiento en caché y la ejecución parcial. Evite volver a ejecutar el trabajo realizado anteriormente sin cambios.
Luego, evalúa los indicadores de lanzamiento. Prueba la vista previa, la VRAM, la caché y los cambios de atención uno por uno.
Cuándo deberías cambiar de estrategia en lugar de optimizar más
Si un flujo de trabajo SDXL sigue tardando demasiado después de estos cambios, analice qué está haciendo exactamente el proceso. Un gráfico de producción con múltiples ControlNet, refinador y escalado puede ser, simplemente, un proceso computacionalmente intensivo por diseño. En ese caso, tiene tres opciones: aceptar un renderizado más lento para las imágenes finales, usar un flujo de trabajo de borrador más simple para la iteración o trasladar la carga de trabajo a un hardware más rápido.
Asimismo, si te quedas constantemente sin VRAM, forzar un modo de GPU más rápido no es la solución adecuada. Una ejecución estable con la gestión de memoria dinámica predeterminada o una configuración con menos VRAM es preferible a fallos repetidos por falta de memoria. Si bien la configuración de ahorro de memoria puede aumentar el tiempo de renderizado, un renderizado exitoso, aunque sea más lento, sigue siendo más útil que un fallo repentino.