Inicio
» Dominios
»
Cómo generar automáticamente títulos y descripciones meta SEO con Local Ollama
Cómo generar automáticamente títulos y descripciones meta SEO con Local Ollama
Tienes 300 páginas de productos, documentación o blog listas para publicar, pero la columna de metadatos sigue en blanco. Escribir cada título y meta descripción manualmente es lento; copiar un mismo patrón en todo el sitio produce resultados repetitivos; y solicitar un "título SEO" a un modelo de lenguaje local suele generar comentarios adicionales, afirmaciones inventadas o formatos inconsistentes.
Un enfoque más adecuado consiste en tratar la generación de metadatos como un pequeño flujo de datos: proporcionar al modelo únicamente información específica de cada página, exigir una salida estructurada, validarla mediante código y, finalmente, revisar las excepciones antes de publicar. Ollama se adapta bien a este flujo de trabajo, ya que su API local está disponible http://localhost:11434/apitras la instalación y admite salidas estructuradas con esquema JSON. La documentación de Ollama y Google Search a la que se hace referencia aquí se revisó el 13 de septiembre de 2026.
Por qué fallan los metadatos SEO automáticos
La mayoría de los fallos se deben al flujo de trabajo del modelo, más que a una única "indicación incorrecta". Las causas comunes incluyen proporcionar muy poco contenido a la página, permitir que el modelo responda con prosa de formato libre, aplicar la misma fórmula de palabras clave a todas las URL y publicar resultados sin realizar comprobaciones de duplicados a nivel del sitio.
También existe una idea errónea persistente sobre los límites de caracteres. Google afirma que no hay un límite de longitud fijo para <title>los elementos o meta descripciones de una página; los enlaces de título y los fragmentos se truncan según sea necesario, generalmente de acuerdo con el ancho del dispositivo. Google también puede generar un enlace de título o fragmento diferente a partir del contenido de la página cuando sus sistemas consideran que otra representación es más útil. Consulte la guía oficial de Google sobre enlaces de título , fragmentos y meta descripciones .
Esto significa que un script puede establecer límites de longitud editorial para garantizar la coherencia, pero no debe indicar que esos números son requisitos de Google. En el ejemplo siguiente, 65 caracteres para el título y 165 para la descripción son solo límites internos. Modifícalos para que se ajusten a tu CMS, marca, necesidades de localización y proceso de revisión.
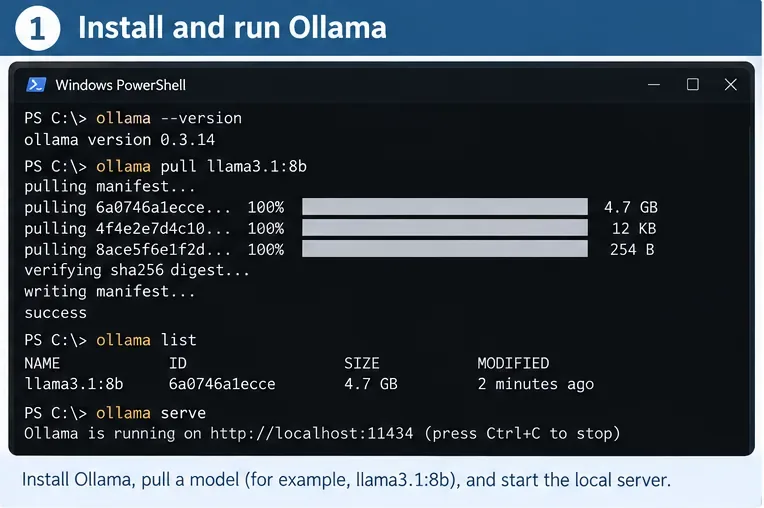
Paso 1: Instale Ollama y confirme que la API local funciona.
La guía de inicio rápido oficial de Ollama indica compatibilidad con macOS, Windows y Linux. Tras la instalación, descargue un modelo local. La documentación actual de Ollama utiliza con frecuencia gemma3ejemplos de API, por lo que resulta un ejemplo neutral y práctico para este tutorial:
ollama pull gemma3
A continuación, prueba el punto final local:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
La documentación de la API de Ollama indica que la API local se sirve en http://localhost:11434/api. Ollama también indica que el acceso local a esta dirección no requiere autenticación. Si su servicio local no está en ejecución, ollama servees el comando CLI documentado para iniciarlo. Evite sustituir un -cloudmodelo si su objetivo es realmente la inferencia local.
Flujo de trabajo para la configuración en la terminal: verificar Ollama, descargar un modelo local, confirmar que aparece en la lista de modelos locales y asegurarse de que el servicio esté disponible en localhost. Los valores de nombre y longitud del modelo que se muestran son ejemplos de flujo de trabajo, no requisitos de SEO.
Elige un modelo según tu hardware.
Este artículo no pretende afirmar que un modelo sea universalmente el mejor para los metadatos SEO. La disponibilidad de modelos y la compatibilidad con el hardware cambian con el tiempo, y los modelos más grandes requieren más memoria y, por lo general, responden más lentamente. Comience con un modelo que su equipo pueda ejecutar sin problemas, genere un pequeño conjunto de datos de referencia y, a continuación, compare la precisión, la unicidad, la latencia y la coherencia de los datos antes de procesar miles de páginas.
Paso 2: Forzar la salida estructurada en lugar de analizar la prosa.
El texto libre es frágil para la automatización. Una respuesta como «Aquí hay tres excelentes opciones…» obliga al programa a adivinar dónde comienza el título real. La documentación de salidas estructuradas de Ollama admite el paso de un esquema JSON en el formatcampo. La documentación también recomienda esquemas reutilizables a través de Pydantic en Python y señala que una temperatura baja, como 0, puede mejorar el determinismo.
Instala los dos paquetes de Python utilizados en este ejemplo:
python -m pip install -U ollama pydantic
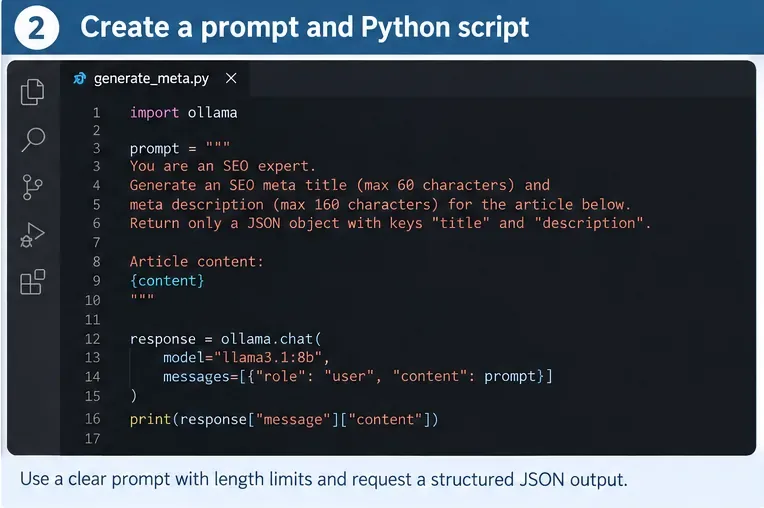
Luego crea generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
El generador debe especificar claramente la evidencia de la página, los campos de salida y las restricciones editoriales. En producción, es preferible utilizar la salida estructurada en esquema JSON de Ollama y la validación del lado de la aplicación, en lugar de basarse únicamente en la redacción de las indicaciones.
Por qué la solicitud incluye el título actual y H1
Google afirma que su sistema de enlaces de título puede tener en cuenta el <title>título visual principal de la página, encabezados como <h1><p>, og:title<h1>, texto destacado, texto de anclaje y otras señales. Su generador local no necesita reproducir el sistema de Google, pero proporcionarle el título de origen, el encabezado H1, la URL y un texto representativo del cuerpo ayuda a que los metadatos propuestos se ajusten a la página que los lectores verán realmente.
No introduzca listas de palabras clave no relacionadas ni le pida al modelo que las “ajuste”. Google recomienda explícitamente títulos descriptivos y concisos, y advierte contra el uso excesivo de palabras clave y la repetición de textos repetitivos. En cuanto a las descripciones, Google indica que la generación programática específica para cada página es apropiada para sitios web con grandes bases de datos, siempre que las descripciones sean precisas, fáciles de leer y variadas.
Paso 3: Ejecuta una página y luego valida antes de escalar.
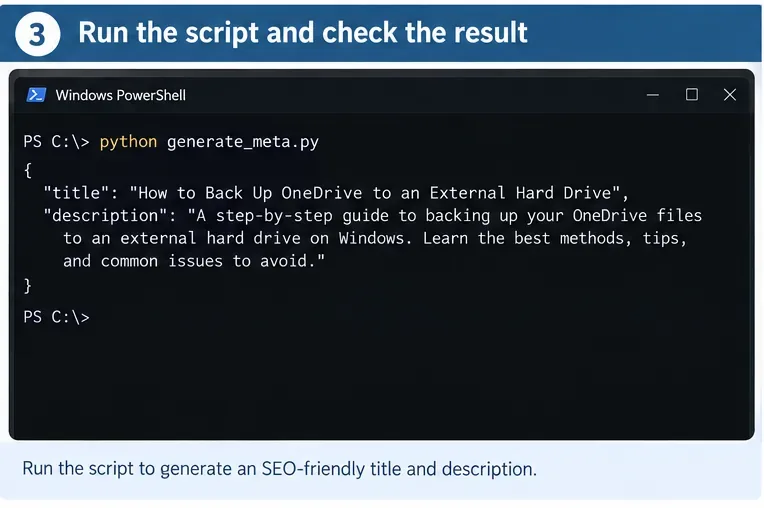
Ejecuta el script:
python generate_meta.py
Un resultado satisfactorio debería ser un objeto JSON que Pydantic pueda validar. Más importante aún, un revisor humano debería poder compararlo con la página de origen y responder rápidamente a cuatro preguntas:
¿El título describe esta página en concreto, en lugar de la página web en general?
¿La descripción evita afirmaciones, fechas, precios o características que no aparecen en el contenido original?
¿Seguirían teniendo sentido estos metadatos si se leyeran sin el cuerpo de la página?
¿Es diferente de los metadatos que ya se utilizan en páginas cercanas?
Pruebe primero una página representativa e inspeccione el resultado estructurado antes de iniciar un proceso por lotes. Es necesaria una respuesta JSON analizable, pero la precisión de los datos y la relevancia a nivel de página aún requieren validación.
Agregue reintentos para fallas editoriales, no solo para errores de API.
Un esquema puede restringir los tipos y longitudes de datos, pero no garantiza que una oración sea veraz o suficientemente específica. Implemente una lógica de reintento basada en comprobaciones medibles. Por ejemplo, rechace un campo vacío, un título duplicado, texto repetitivo prohibido o una descripción que repita el título casi palabra por palabra. Si la página contiene afirmaciones reguladas o de gran importancia, exija una revisión humana en lugar de intentar automatizar la generación de confianza.
Mantén las indicaciones para reintentar concisas. En lugar de regenerar todo con la opción "mejorarlo", indícale al modelo qué falló: "El título propuesto duplica otra página. Reescríbelo utilizando el tema único del encabezado H1, manteniendo cada afirmación basada en el contenido proporcionado". Esto facilita la auditoría de los fallos.
Paso 4: Exportar las páginas a CSV para su revisión y publicación.
Una vez que la prueba de una página sea fiable, guarde sus datos de entrada en un archivo CSV con columnas como url, source_title, h1, y content. El campo de contenido debe contener texto de página limpio, no menús de navegación, avisos de cookies ni miles de enlaces de pie de página irrelevantes.
Agregue esta lógica de procesamiento por lotes debajo de la función generadora o colóquela en un script separado:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
El archivo CSV resultante se puede revisar en Excel, LibreOffice, una herramienta de importación de bases de datos o el flujo de trabajo de su CMS. No sobrescriba automáticamente los metadatos en tiempo real en la primera ejecución. Conserve el título y la descripción originales junto con la propuesta generada para que los revisores puedan compararlos y para facilitar la reversión de cambios.
Una cola de revisión de hojas de cálculo facilita la auditoría de la generación masiva: conserve el identificador de la página de origen, el título generado, la descripción generada, las longitudes y los indicadores de control de calidad antes de publicar los cambios.
Haga que el proceso por lotes sea más seguro.
Controlar
Qué marcar
Por qué es importante
Validación de esquema
Campos faltantes o no válidos
Impide que la salida con formato incorrecto ingrese al CMS.
Verificación de título duplicado
El mismo título normalizado en dos URL.
Ayuda a diferenciar las páginas.
Comprobación de idioma
El lenguaje de los metadatos difiere del lenguaje de la página.
Google recomienda que el idioma y el sistema de escritura coincidan con el idioma principal de la página.
Verificación de pruebas
Faltan números, precios, fechas, marcas o garantías en la fuente.
Reduce las afirmaciones relacionadas con alucinaciones.
Verificación estándar
Frases largas y repetidas en todo el sitio
Google desaconseja el uso repetido de títulos genéricos.
Verificación de la longitud editorial
Fuera del rango de viviendas seleccionado
Mantiene la coherencia en la salida del CMS; esto no es una regla de límite de caracteres de Google.
Revisión humana
Páginas estratégicas, sensibles, de alto tráfico o ambiguas
La automatización debe sacar a la luz las excepciones, no ocultarlas.
Problemas comunes, desde la solución más sencilla hasta la más difícil.
La conexión a la API falla.
Primero, confirme que Ollama se está ejecutando y que http://localhost:11434es accesible. La documentación oficial de autenticación indica que no se requiere autenticación para la API local. Si su script apunta accidentalmente a https://ollama.com/api, se trata de un punto final alojado diferente y requiere autenticación.
La respuesta contiene prosa alrededor del JSON
Utilice el esquema format=SeoMeta.model_json_schema()en lugar de solicitar JSON únicamente en lenguaje natural. La salida estructurada es la capa de control adecuada para un flujo de producción.
Todos los títulos suenan igual
Inserta texto H1 específico para cada página y contenido relevante en el cuerpo del texto, elimina el ruido de navegación global y solicita explícitamente una descripción específica para cada página. Luego, realiza una comprobación de duplicados y similitudes entre páginas. La repetición suele ser un problema de entrada antes que un problema del modelo.
El modelo inventa características o estadísticas
Reduzca la entrada al texto de la página autorizada y refuerce la regla fundamental: no se permiten afirmaciones fácticas más allá del contenido proporcionado. Para páginas importantes, compare las afirmaciones generadas con los campos de origen estructurados antes de su aprobación. Si el origen es ambiguo, envíe la fila a revisión humana en lugar de pedirle repetidamente al modelo que intente adivinar.
El modelo es demasiado lento para miles de páginas.
Mide antes de cambiar la arquitectura. Registra el tiempo de generación por página, el tamaño de entrada, el nombre del modelo y la tasa de fallos. Elimina el texto irrelevante del cuerpo, procesa las secciones estables de la página y prueba un modelo local más pequeño si la calidad sigue siendo aceptable. El modelo más rápido no sirve de nada si sus metadatos generan más trabajo de revisión del que ahorran.
Opcional: utilice una integración existente al estilo OpenAI.
Si ya dispone de código escrito para un cliente compatible con OpenAI, Ollama documenta la compatibilidad parcial con la API de OpenAI en http://localhost:11434/v1/. Esto puede reducir el trabajo de migración. Para una nueva herramienta de metadatos de uso exclusivo local, el cliente nativo de Ollama para Python es más sencillo y expone ejemplos de salida estructurada directamente en la documentación de Ollama.
Cómo autocomprobar el sistema finalizado
Antes de dar por finalizada la automatización, cree un conjunto de revisión que contenga diferentes tipos de contenido: un artículo breve, una guía extensa, una página de producto, una página de categoría, una página con números y una página en cada idioma compatible. Ejecute el mismo modelo y la misma solicitud en todos ellos y, a continuación, verifique la siguiente lista de comprobación.
El punto final local es localhosty el modelo seleccionado es un modelo local, no un modelo etiquetado en la nube.
Cada respuesta se valida según el esquema sin necesidad de limpieza manual del JSON.
Ningún título generado se duplica en el conjunto de reseñas.
Todas las afirmaciones fácticas aparecen en el contenido de la página proporcionada.
Los metadatos utilizan el mismo idioma principal y sistema de escritura que la página.
El título es descriptivo y conciso, sin palabras clave repetidas.
La descripción resume la página específica, no el sitio web en su conjunto.
Las directrices de longitud interna que has establecido están etiquetadas como reglas editoriales, no como requisitos de Google.
Los metadatos antiguos, la propuesta generada, los indicadores de control de calidad, el nombre del modelo y la versión de la solicitud se guardan para fines de auditoría y reversión.
Un revisor sabe qué indicadores requieren aprobación manual antes de su publicación.
Finalmente, recuerda qué puede y qué no puede controlar la automatización. Una buena <title>descripción y meta descripción proporcionan a los motores de búsqueda señales útiles a nivel de página, pero Google puede generar enlaces de título y fragmentos a partir de otro contenido de la página. Por lo tanto, el objetivo no es forzar una representación específica de los resultados de búsqueda, sino producir metadatos precisos, distintivos y útiles a gran escala, manteniendo al mismo tiempo la validación y revisión necesarias para detectar errores antes de que lleguen a producción.