Inicio
» Dominios
»
Cómo solucionar el error "Ventana de contexto excedida" en el análisis de documentos extensos sin perder información clave.
Cómo solucionar el error "Ventana de contexto excedida" en el análisis de documentos extensos sin perder información clave.
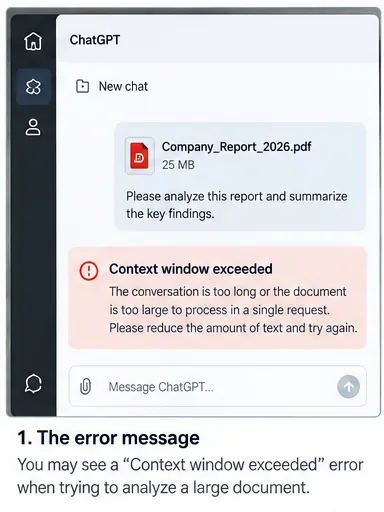
Subes un informe extenso, solicitas un análisis exhaustivo y, en lugar de una respuesta, recibes un mensaje como «Se ha superado el límite de la ventana de contexto», «Se ha superado la longitud máxima del contexto» u otra advertencia de que la solicitud es demasiado grande. Lo frustrante es que el archivo puede haberse subido correctamente, e incluso el mismo documento podría haber servido para una pregunta más específica.
La razón es simple, pero fácil de pasar por alto: un límite de carga y la ventana de contexto de un modelo no son lo mismo. Un modelo debe ajustar el material que está considerando a un presupuesto de tokens finito. Este presupuesto puede incluir tus instrucciones, el historial de conversaciones, el texto extraído de archivos, las definiciones de herramientas, los pasajes recuperados, los tokens de razonamiento y espacio para la respuesta. Por lo tanto, un documento puede ser válido para cargar, pero aun así ser demasiado grande para analizarlo en una sola pasada.
La mejor solución suele ser no volver a intentar con la misma solicitud gigante. Empiece con los cambios menos disruptivos y, si el enfoque más sencillo sigue fallando, recurra a la segmentación, la recuperación o un flujo de trabajo con un contexto más amplio.
Primero, confirme que el error es realmente un problema de la ventana de contexto.
Antes de modificar el documento, conviene distinguir entre un error de contexto y un límite de carga o almacenamiento. Las directrices actuales de OpenAI para la carga de archivos indican que los archivos subidos a ChatGPT o a una GPT tienen un límite estricto de 512 MB por archivo, mientras que los archivos de texto y documentos están limitados a 2 millones de tokens por archivo. Estos son límites de carga, no una garantía de que todo el texto se incorporará al contexto activo del modelo de una sola vez.
Las preguntas frecuentes sobre la carga de archivos de OpenAI son la fuente oficial para consultar los límites de carga actuales. Los límites exactos varían según el producto, el plan, el modelo y el proveedor, así que no dé por sentado que un número copiado de un artículo antiguo sigue siendo válido.
Lo que ves
Posible cuello de botella
El mejor primer paso
El archivo es rechazado antes de que comience el análisis.
Tamaño del archivo, tipo de archivo, almacenamiento o cuota de carga
Consulta las reglas de carga actuales.
El archivo se carga, pero una solicitud larga falla con un error de contexto.
La solicitud activa supera el presupuesto de contexto del modelo.
Acortar la solicitud y reducir el contexto activo
La respuesta abarca las primeras páginas, pero omite las secciones posteriores.
No todo el material se colocó directamente en contexto, o la recuperación omitió pasajes relevantes.
Haga preguntas más específicas o divídalas por sección.
Una conversación funcionó antes, pero falla después de muchos giros.
El historial de chat acumulado está consumiendo contexto.
Inicie un nuevo hilo de análisis con un resumen de traspaso conciso.
Puede aparecer un error de ventana de contexto después de que un documento se haya cargado correctamente, ya que la solicitud activa aún debe ajustarse al presupuesto de tokens del modelo.
Paso 1: Mide el documento antes de modificarlo.
El número de páginas y los megabytes son pistas útiles, pero los tokens son la medida que importa para el contexto del texto. La tokenización depende del idioma, el formato, la puntuación y la codificación del modelo, por lo que un manual técnico de 100 páginas puede consumir una cantidad de tokens muy diferente a la de una presentación de diapositivas de 100 páginas.
La guía de OpenAI para el conteo de tokens recomienda revisar la ventana de contexto del modelo objetivo y dejar espacio para la salida y, en el caso de los modelos de razonamiento, para los tokens de razonamiento. También señala que la estructura del mensaje, las herramientas, los archivos, las imágenes y los esquemas pueden añadir tokens más allá del texto plano que se contabiliza.
Para una evaluación rápida, anote el número de páginas del archivo, el número aproximado de palabras, el número de secciones principales y si contiene apéndices, lenguaje legal repetitivo, registros sin procesar, transcripciones, tablas o referencias que en realidad no necesita para la tarea.
Antes de solucionar problemas, compruebe la escala del documento. El tamaño del archivo y el número de páginas son solo indicadores aproximados; el uso de tokens es el límite más relevante para el análisis de texto.
Paso 2: Reduzca la conversación activa antes de tocar el archivo.
Si el documento no es excesivamente grande, la solución más económica podría ser eliminar el contexto acumulado en lugar de dividir el archivo. Inicie una nueva conversación o solicitud y transfiera solo las instrucciones relevantes. Reemplace una larga conversación de ida y vuelta con una entrega breve como esta: «Analice el informe adjunto para identificar los factores que impulsan los ingresos, los riesgos importantes y las directrices de gestión. Proporcione cinco conclusiones con referencias a páginas o secciones».
Elimine también el material de fondo repetido, los ejemplos que ya no sean necesarios, el texto pegado duplicado y los borradores anteriores. Si utiliza un flujo de trabajo de API, cuente la solicitud completa en lugar de solo el documento. Una solicitud demasiado pequeña deja poco espacio para la respuesta y puede fallar de forma impredecible a medida que aumentan las instrucciones o los esquemas de las herramientas.
Señal de éxito: el mismo archivo funciona en un hilo nuevo con un indicador de comandos enfocado. De ser así, el problema radicaba, al menos en parte, en el contexto acumulado, y no en el documento en sí.
Paso 3: Limitar la pregunta y el resultado solicitado.
La instrucción «Analice todo el contenido de este documento de 400 páginas y elabore un informe exhaustivo» obliga al sistema a considerar muchos temas a la vez. En su lugar, formule una pregunta a la vez. Por ejemplo, solicite primero los principales riesgos del documento, luego sus supuestos financieros y, finalmente, las contradicciones entre las afirmaciones de la gerencia y los datos que los respaldan.
Mantenga el formato de respuesta limitado. Una solicitud de un informe de 20 páginas consume mucho más presupuesto de impresión que una solicitud de una tabla de evidencias de 10 filas. Siempre puede ampliar la respuesta final una vez recopiladas las evidencias.
Una consigna útil y específica es: «Utilizando únicamente este documento, identifique hasta ocho afirmaciones relevantes para la pérdida de clientes. Para cada afirmación, indique la sección o página de referencia, una explicación de una sola frase y cualquier limitación que se mencione. Si el documento no contiene suficiente evidencia, indíquelo».
Cuándo pasar a la siguiente sección: si una pregunta específica sigue produciendo el mismo error, o si necesita una cobertura fiable de todo el documento en lugar de un solo tema, divida la fuente.
Paso 4: Divide el documento por significado, no solo por número de páginas.
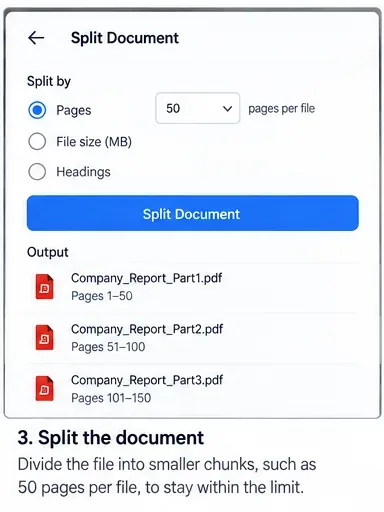
La segmentación es la solución más fiable y general para documentos muy extensos. Divida el archivo en límites naturales como capítulos, secciones de informes, contratos, apéndices, rangos de fechas o turnos de oradores. La segmentación lógica preserva mejor el contexto que los cortes arbitrarios cada 50 páginas.
Si una sección depende en gran medida de la anterior, incluya una pequeña superposición o una breve nota de transición que describa la sección precedente. Nombre las partes con claridad, por ejemplo 01_Executive_Summary.pdf, , 02_Financial_Results.pdf, y 03_Risk_Factors.pdf. Conserve la numeración original de las páginas siempre que sea posible para que se pueda revisar la síntesis final.
Divide una fuente muy extensa en secciones lógicas y con nombres claros. Conserva las referencias a las páginas o secciones originales para que la síntesis posterior pueda cotejarse con la fuente original.
Paso 5: Analizar cada fragmento con el mismo esquema de evidencia.
No se limite a solicitar un resumen libre de cada parte. Utilice la misma estructura para cada segmento, de modo que los resultados puedan combinarse sin perder diferencias importantes. Un esquema práctico podría incluir el nombre de la sección, los hallazgos clave, la evidencia que los respalda, la referencia de página o encabezado, las incertidumbres y las preguntas abiertas.
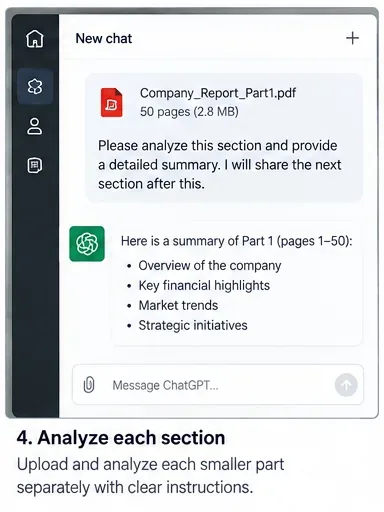
Por ejemplo: “Analice únicamente la Parte 3. Indique: (1) cinco o menos hallazgos relevantes, (2) la evidencia que respalda cada hallazgo, (3) la referencia a la página o sección original, (4) cualquier advertencia expresada por el autor y (5) las preguntas que deben consultarse en otra sección. No infiera hechos que no figuren en esta parte.”
Este enfoque también facilita la evaluación de la calidad. Si un resumen de fragmento contiene afirmaciones sin ubicaciones de origen, corrija ese fragmento antes de continuar, en lugar de esperar que la síntesis final lo solucione.
Analice una sección a la vez con un formato de salida fijo para que cada resultado parcial pueda combinarse posteriormente y rastrearse hasta la fuente.
Paso 6: Crea un resumen de resúmenes en lugar de recargar cada fragmento completo.
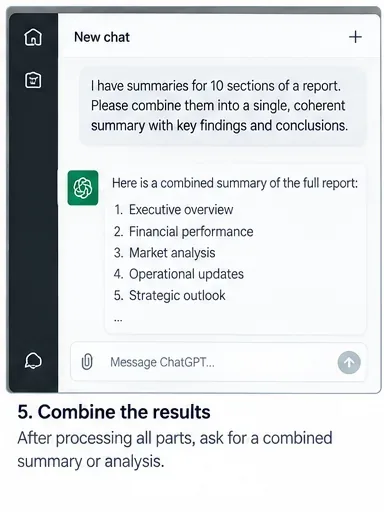
Una vez analizadas las partes, cree un paquete de evidencia compacto a partir de los resultados de los fragmentos y sintetícelo. No envíe automáticamente cada fragmento original junto con cada resumen en una única solicitud final; esto puede recrear el mismo problema de contexto.
La instrucción de síntesis debe indicar al modelo que conserve las discrepancias y las lagunas. Por ejemplo: «Combina estos análisis de sección en un solo informe. Fusiona los hallazgos duplicados, conserva la evidencia contradictoria como puntos separados, conserva todas las referencias bibliográficas y señala cualquier pregunta que no pueda resolverse a partir de los resúmenes».
Este método jerárquico resulta especialmente útil para libros, documentos regulatorios, conjuntos de pruebas, extensas recopilaciones de entrevistas e investigaciones con múltiples documentos. Su principal limitación es la compresión de la información: los detalles omitidos durante el resumen de un fragmento no pueden reaparecer automáticamente más adelante. Por ello, el esquema de evidencia y las referencias a las fuentes son fundamentales.
Combine análisis de secciones compactas en lugar de recargar todo el texto fuente. Conserve las citas, los desacuerdos y las preguntas sin resolver durante la síntesis.
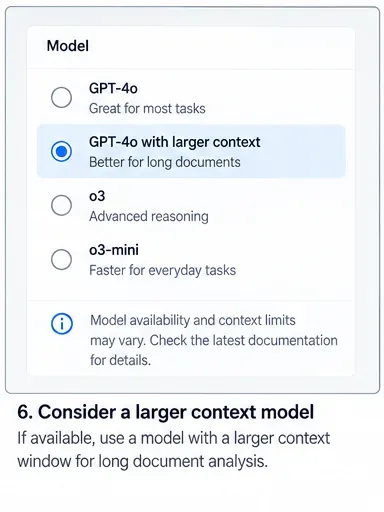
Paso 7: Considere un modelo de contexto más amplio, pero no lo trate como una solución completa.
Un modelo con una ventana de contexto más amplia puede reducir la necesidad de segmentar los datos. La documentación actual de OpenAI detalla los límites de la ventana de contexto y la salida máxima para los modelos de la API, y estas cifras pueden cambiar a medida que se actualizan los modelos.
Sin embargo, el tamaño del contexto del titular de un modelo no es necesariamente la cantidad de un archivo cargado que un producto coloca directamente en la solicitud. La guía de archivos específica para empresas de OpenAI describe actualmente un proceso separado de "relleno de contexto" para documentos de texto cargados: se pueden colocar hasta 110 000 tokens de documentos cargados directamente en el contexto, con material adicional disponible a través de un índice de búsqueda privado. OpenAI indica explícitamente que este comportamiento está en desarrollo activo y sujeto a cambios. Consulte Optimización de cargas de archivos en ChatGPT Enterprise .
La lección práctica consiste en elegir un modelo de contexto más amplio cuando simplifica considerablemente el flujo de trabajo, pero sin dejar de comprobar si se están teniendo en cuenta las secciones relevantes. Un contexto más amplio no elimina la necesidad de una buena definición del alcance, referencias bibliográficas ni verificación.
Un modelo de contexto más amplio puede ser útil, pero verifique los límites para el modelo exacto y la superficie del producto que está utilizando, en lugar de basarse en un número genérico.
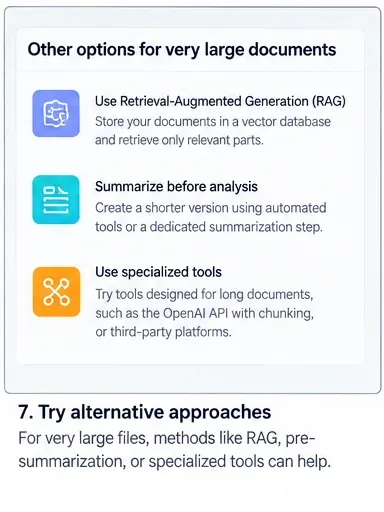
Paso 8: Para corpus muy grandes, cambie de "rellenar todo" a recuperación.
Si la tarea implica cientos o miles de páginas, la recuperación suele ser una arquitectura más eficaz que intentar adaptar todo el corpus a una sola pregunta. Los sistemas de recuperación indexan la fuente, buscan pasajes relevantes para la pregunta actual y colocan solo esos pasajes en un contexto activo.
La documentación de búsqueda de archivos de OpenAI describe una herramienta alojada para buscar archivos cargados en almacenes de vectores. La recuperación funciona especialmente bien para preguntas específicas como "¿Qué secciones definen la terminación para mayor comodidad?" o "¿Dónde se analiza la concentración de la cadena de suministro en el informe?".
La recuperación de datos es menos fiable cuando la tarea requiere un conocimiento simultáneo de cada pasaje, como demostrar que un tema nunca aparece, comparar cada celda de una tabla en una colección masiva o realizar una transformación exhaustiva línea por línea. En esos casos, además de la recuperación, utilice el procesamiento por lotes sistemático o el preprocesamiento basado en código.
En el caso de corpus que siguen siendo demasiado grandes después de la segmentación, la recuperación solo puede incorporar los pasajes más relevantes al contexto activo de cada pregunta.
Corrección avanzada de la API: control de truncamiento deliberado
Los desarrolladores que utilizan la API de OpenAI Responses tienen una opción adicional. La documentación de referencia de la API indica una truncationconfiguración: con disabled, que es la configuración predeterminada documentada, una solicitud que exceda la ventana de contexto del modelo fallará; con auto, se pueden descartar elementos de conversación anteriores para que la solicitud se ajuste. Consulte la documentación de referencia de la API de Responses .
El truncamiento automático puede evitar un fallo grave, pero altera la información disponible para el modelo. En el análisis de documentos, descartar silenciosamente el contexto inicial puede ser peor que recibir un error. Úselo solo cuando su aplicación esté diseñada de manera que los elementos de conversación más antiguos sean prescindibles o ya estén resumidos en otro lugar.
Cómo verificar que la solución realmente funcionó.
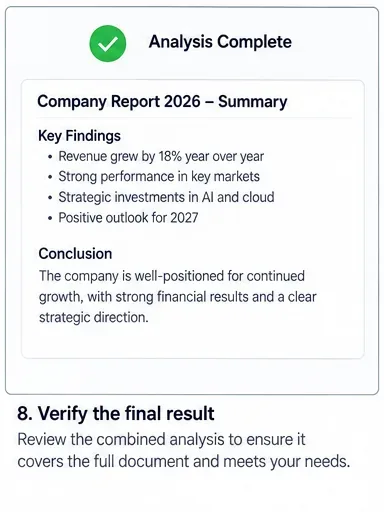
Una solicitud exitosa no es suficiente. El objetivo es un análisis sólido que abarque el material relevante sin omitir pruebas. Verifique el resultado antes de dar por resuelto el problema.
Verificación de cobertura: confirme que cada capítulo, rango de fechas o archivo fuente requerido aparece en el plan de análisis o en la tabla de evidencia final.
Verificación de trazabilidad: examine ejemplos de afirmaciones importantes y verifique sus referencias de página, sección o archivo con respecto a la fuente original.
Verificación de límites: inspeccione los hallazgos cerca de los límites de los fragmentos para asegurarse de que un concepto no se haya dividido o contradicho entre las partes.
Control negativo: formula una pregunta cuya respuesta se sabe que está ausente. Un buen flujo de trabajo debería indicar que la evidencia no está presente, en lugar de inventarla.
Verificación de repetibilidad: repita algunas preguntas representativas. Los cambios significativos en la evidencia citada pueden indicar una recuperación deficiente o una pregunta demasiado general.
Control de presupuesto: si utiliza una API, inspeccione el uso real de tokens de entrada y salida en lugar de basarse únicamente en estimaciones aproximadas del número de palabras.
El último paso es la verificación: compruebe la cobertura, las referencias a las fuentes, los límites de los fragmentos y las afirmaciones no respaldadas antes de confiar en el análisis combinado.
Qué no hacer
No sigas enviando la misma solicitud sobredimensionada esperando un límite de tokens diferente. No elimines las referencias de origen durante la segmentación. No des por sentado que la aceptación de un archivo implica que todas las páginas están activas en el contexto. Y no intentes solucionar el error acortando la respuesta de forma tan drástica que el análisis deje de cumplir la tarea.
Además, evite considerar el truncamiento automático como algo mágico. Si el sistema descarta elementos antiguos, la solicitud podría completarse con éxito, pero se perderían instrucciones o evidencias importantes. Para análisis de alto riesgo, la segmentación y recuperación explícitas suelen ser más fáciles de auditar.
Una regla de decisión práctica
Si un nuevo hilo de conversación y una pregunta más específica funcionan, mantenga el flujo de trabajo simple. Si la tarea requiere una cobertura amplia de un documento extenso, divídalo en secciones lógicas y sintetice análisis de fragmentos estructurados. Si consulta repetidamente una colección de documentos muy grande, utilice la recuperación. Si controla la API y aún así se acerca al límite, mida los tokens, reserve espacio de salida, seleccione un modelo apropiado y haga del comportamiento de truncamiento una decisión de diseño explícita.
El mejor resultado no es el que incluye la mayor cantidad de texto en una sola solicitud, sino el que abarca la evidencia requerida, preserva la trazabilidad y deja claro cuándo no se disponía de la información.