Inicio
» Dominios
»
Cómo crear GPT personalizadas que no olviden sus archivos de conocimiento
Cómo crear GPT personalizadas que no olviden sus archivos de conocimiento
Estado actual, comprobado el 13 de septiembre de 2026: OpenAI indica que las cuentas personales de ChatGPT, incluidas las gratuitas, Go, Plus y Pro, no pueden crear ni publicar nuevos GPT. Los GPT existentes aún se pueden usar y, cuando corresponda, editar. En los espacios de trabajo Business, Enterprise y Edu, la creación depende de la configuración y los permisos del espacio de trabajo. OpenAI también indica que los flujos de trabajo de GPT personalizados se están migrando a Plugins, con un proceso de migración previsto para el 17 de septiembre de 2026 y la retirada prevista para los GPT Enterprise afectados el 11 de diciembre de 2026. Si lee esto más tarde, verifique el estado más reciente en la documentación de OpenAI sobre la creación y edición de GPT antes de crear un nuevo flujo de trabajo.
Un GPT personalizado que parece "olvidar" un archivo de conocimiento generalmente no lo ha perdido. Las preguntas frecuentes sobre carga de archivos de OpenAI indican que los archivos cargados como conocimiento GPT se conservan hasta que se elimina el GPT personalizado. El problema más común es la recuperación: el modelo no necesariamente lee todos los archivos cargados por completo para cada pregunta. Recupera el material que parece relevante para la pregunta, por lo que la calidad de la fuente, la estructura del archivo, las instrucciones y las pruebas influyen en si se muestra el pasaje correcto.
Además, conviene diferenciar entre «conocimiento» y «memoria». La documentación de OpenAI sobre las GPT (Global Process Tools) indica que estas no utilizan memoria guardada, instrucciones personalizadas ni conversaciones anteriores; cada conversación comienza desde cero. Por lo tanto, el conocimiento cargado es una fuente de referencia configurada, no una memoria conversacional acumulada a partir de chats previos.
Así debería ser un resultado fiable.
El objetivo no es obligar a un GPT a mencionar un archivo en cada turno. El objetivo es que las respuestas que dependen de la fuente se basen consistentemente en el material correcto, mientras que las preguntas sin apoyo fallan de forma segura en lugar de generar una suposición confiada.
Señal de calidad
Cómo se ve “bien”
Cuándo cambiar la configuración
Exactitud
La respuesta coincide con el archivo oficial de la pregunta analizada.
Si la respuesta es incorrecta a pesar de que el dato esté presente, simplifique la fuente o acote la pregunta.
Toma de tierra
La GPT puede especificar el archivo o la sección de soporte cuando se le solicite.
Si responde basándose en conocimientos generales, refuerce las instrucciones de prioridad de la fuente y vuelva a realizar la prueba.
Abstención
Cuando los archivos no contienen la respuesta, la GPT lo indica claramente.
Si inventa una política, un precio, una fecha o un procedimiento, añada una regla explícita que prohíba adivinar.
Consistencia
Las formulaciones equivalentes producen respuestas sustancialmente coherentes.
Si pequeños cambios en la redacción provocan desviaciones importantes, reduzca la ambigüedad tanto en los archivos como en las instrucciones.
Integridad de la actualización
Tras una revisión del código fuente, las mismas preguntas de evaluación reflejan el nuevo contenido.
Si persisten las respuestas antiguas, verifique que el archivo actualizado esté adjunto, guarde la tabla de propósito general (GPT) y vuelva a ejecutar las pruebas.
Ocho pasos para hacer más fiable el uso de los archivos de conocimiento.
1. Confirma que tu cuenta o espacio de trabajo aún puede crear o editar el GPT.
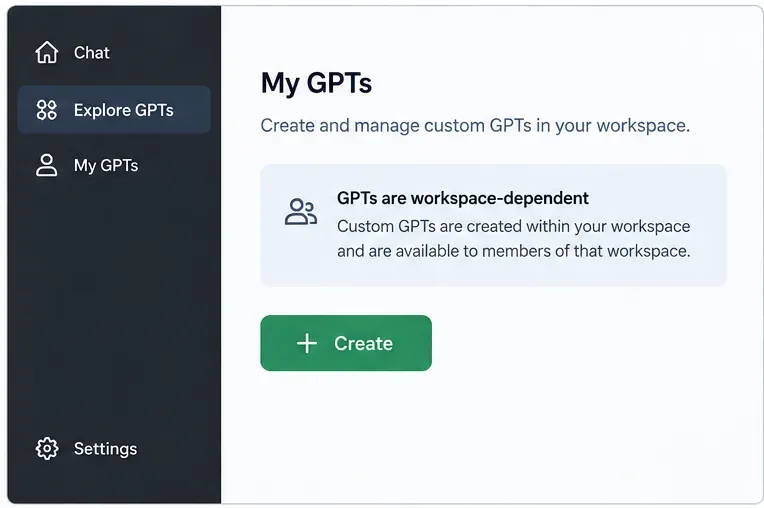
Comience por verificar la elegibilidad, ya que la ausencia del botón "Crear" podría ser un comportamiento esperado en lugar de un problema del navegador. La guía actual de OpenAI sobre GPT en ChatGPT indica que la creación de nuevos GPT no está disponible en cuentas personales. Los espacios de trabajo administrados aún pueden permitir la creación de GPT según la política de administrador y los permisos de rol. Si ya tiene un GPT existente, verifique si la edición aún está disponible en su cuenta.
En los espacios de trabajo gestionados que cumplan los requisitos, comience desde el área GPT; la disponibilidad depende de los permisos del espacio de trabajo.
No dedique tiempo a solucionar problemas de recuperación de conocimiento hasta que sepa que está trabajando en un editor compatible. Si su organización ya está migrando a complementos, considere la GPT personalizada restante como una candidata para la migración, en lugar de una nueva dependencia a largo plazo.
2. Separar las instrucciones de comportamiento del conocimiento.
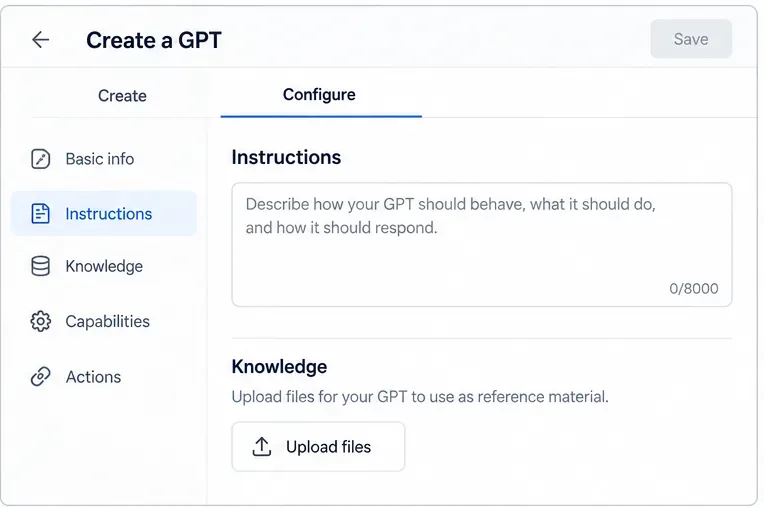
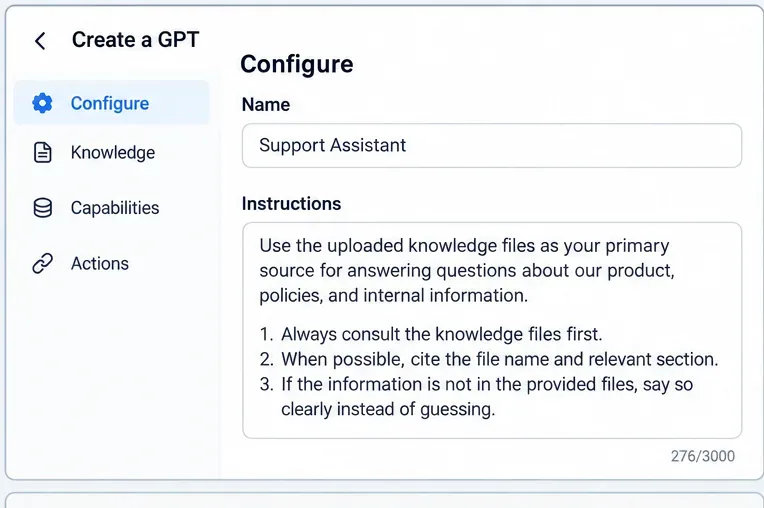
Utilice el campo Instrucciones para definir reglas como el tono, el orden de decisión, el formato de citación, el comportamiento de escalamiento y qué debe hacer el GPT cuando una fuente no responde. Utilice Conocimiento para material de referencia: manuales, documentación de productos, políticas, preguntas frecuentes, especificaciones o guías internas. OpenAI recomienda explícitamente esta separación, ya que Conocimiento funciona mejor como material de origen, mientras que Instrucciones define el comportamiento.
Mantén las normas de comportamiento en las Instrucciones y el material de referencia en la sección de Conocimientos.
Esta distinción es importante para la fiabilidad. Una frase como «Nunca cite un precio caducado» debe ir en las Instrucciones. La tabla de precios propiamente dicha debe ir en la Base de conocimientos. Mezclar reglas en un PDF de referencia extenso dificulta el control y la comprobación del comportamiento.
3. Prepare los archivos para su recuperación, no solo para su lectura humana.
Prefiera archivos claros y concisos, con encabezados descriptivos, secciones cortas, terminología estable y fechas de versión inequívocas. Un folleto con un diseño atractivo puede resultar menos informativo que un simple archivo Markdown o de texto si la información crucial se encuentra dispersa en columnas, recuadros, capturas de pantalla o diseños decorativos.
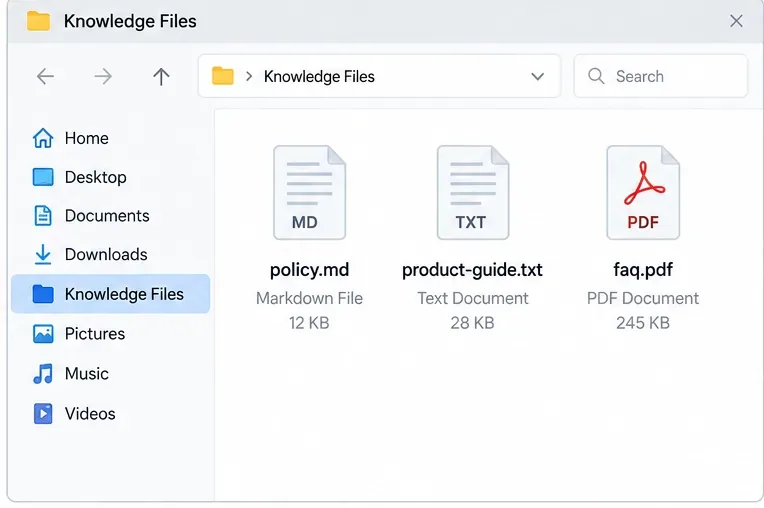
Los archivos de texto plano con nombres claros y una estructura sencilla son más fáciles de recuperar de forma fiable.
Esto es especialmente importante para los PDF. Las preguntas frecuentes de OpenAI sobre la recuperación visual con PDF indican que los PDF cargados como conocimiento GPT se procesan mediante la recuperación de texto únicamente. En otras palabras, un gráfico, diagrama o captura de pantalla dentro del PDF no debería ser el único lugar donde exista una regla crítica. Añada una explicación de texto o un archivo complementario en formato de texto.
Elimine también los duplicados obsoletos. Si un archivo indica un plazo de devolución de 14 días y otro de 30, la consulta puede mostrar cualquiera de las dos versiones. Los nombres de archivo como returns-policy-2026-09.md y la presencia de la fecha de entrada en vigor facilitan la auditoría del control de versiones.
4. Carga un conjunto de conocimientos pequeño y coherente y verifícalo.
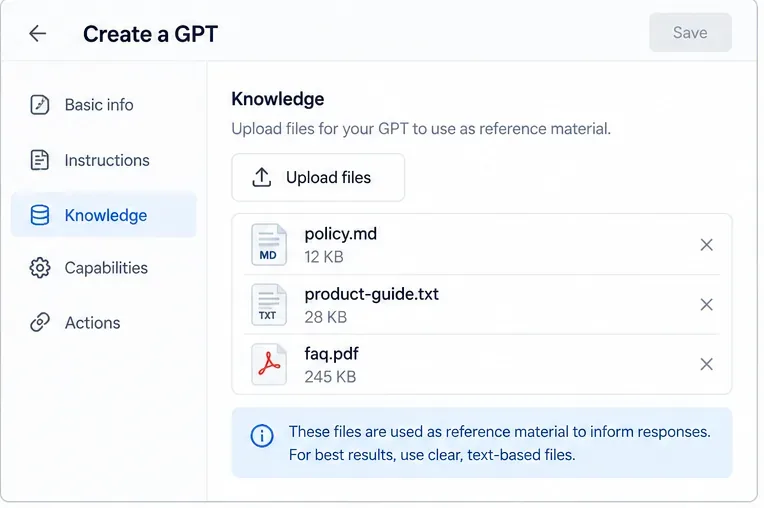
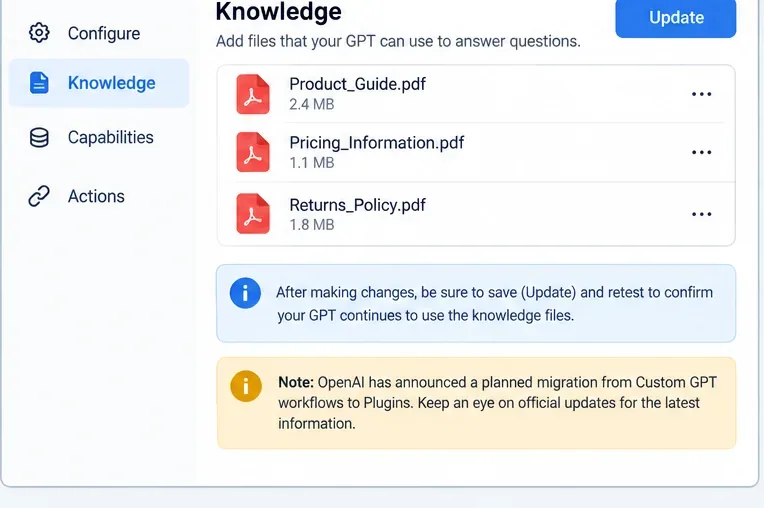
Cargue únicamente los archivos que GPT realmente necesita. La guía de OpenAI sobre archivos empresariales indica que, por lo general, una menor cantidad de documentos, pero más específicos, mejora la precisión en la recuperación de información basada en archivos. Tras la carga, confirme que todos los archivos esperados aparecen en la lista de conocimiento antes de continuar.
Cargue el conjunto de referencia y, a continuación, verifique que aparezcan todos los archivos esperados antes de realizar las pruebas.
Actualmente existe una inconsistencia en la documentación respecto al número de archivos. La guía del editor de GPT indica que se pueden adjuntar hasta 20 archivos a una GPT, mientras que las preguntas frecuentes sobre carga de archivos mencionan un máximo de 10 archivos por GPT durante la vigencia de dicha GPT. Ambos documentos establecen un límite estricto de 512 MB por archivo, y las preguntas frecuentes sobre carga de archivos indican un límite de 2 millones de tokens para archivos de texto y documentos. Dado que las páginas oficiales discrepan sobre el número de archivos, no diseñe un flujo de trabajo crítico basado en la cifra más alta sin antes consultar el editor y la documentación vigentes para su cuenta.
5. Añadir instrucciones orientadas a la recuperación
No se fíe de instrucciones vagas como «Utilice los archivos cargados». Indique qué debe ocurrir cuando una pregunta pertenece a un dominio con base de conocimiento. Un ejemplo práctico es: consultar primero la base de conocimiento cargada; darle preferencia sobre el conocimiento general del modelo para datos específicos de la empresa; identificar el archivo o la sección de apoyo cuando sea posible; e indicar que la información no está disponible cuando los archivos no proporcionan una respuesta.
Las instrucciones orientadas a la recuperación deben definir la prioridad de la fuente, el comportamiento de las citas y una alternativa que impida adivinar la fuente.
La guía de solución de problemas de OpenAI recomienda usar indicaciones más específicas que hagan referencia directa a los documentos adjuntos cuando el conocimiento no se utiliza correctamente. También recomienda mantener las reglas y el comportamiento del flujo de trabajo en las Instrucciones en lugar de ocultarlas en los archivos cargados. Consulte Solución de problemas de GPT .
Evite instrucciones contradictorias. La instrucción «Responda siempre al usuario» entra en conflicto con «Nunca responda a menos que el archivo lo permita». Reemplace ese conflicto con una alternativa explícita como: «Si los archivos de conocimiento no contienen la información requerida, indique que las fuentes proporcionadas no establecen la respuesta y sugiera el siguiente paso aprobado».
6. Ejecuta pruebas de conexión a tierra positivas en Vista previa.
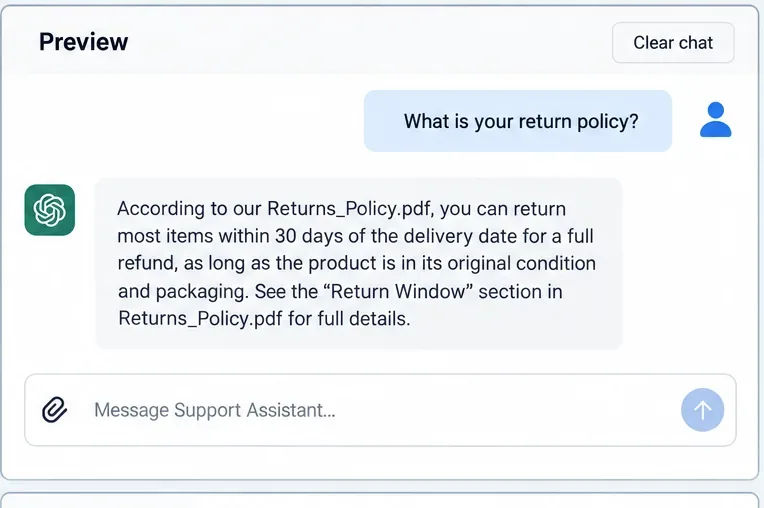
Prueba preguntas cuyas respuestas correctas estén claramente presentes en los archivos. No te limites a evaluar solo la frase más sencilla de la primera página. Incluye preguntas que requieran consultar diferentes secciones, reconocer formulaciones alternativas y distinguir políticas similares.
Un resultado positivo en la prueba proporciona la respuesta correcta e identifica el archivo o la sección de apoyo.
Para cada prueba, registre la respuesta esperada, el archivo fuente esperado y si la GPT citó o identificó dicha fuente cuando se le solicitó. La guía personalizada de GPT de OpenAI Academy recomienda crear un conjunto de evaluación de entre 10 y 15 preguntas representativas con respuestas correctas. Esto es suficiente para detectar patrones de fallos recurrentes sin convertir cada edición en un proyecto de prueba complejo.
Evalúe la respuesta según su fundamento, no solo según su fluidez. Una respuesta impecable con una política incorrecta es un fracaso. Una respuesta más breve que cite correctamente el documento de referencia suele ser mejor.
7. Realizar pruebas negativas y reformular las pruebas.
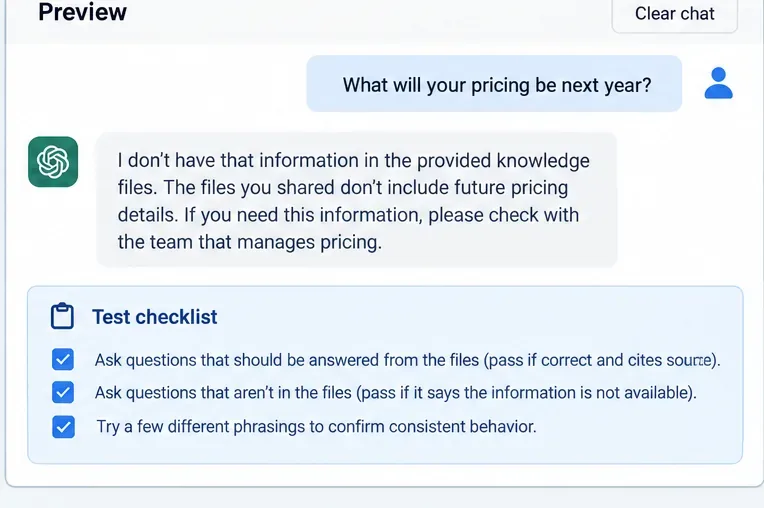
Un asistente de conocimiento fiable debe saber lo que desconoce. Formule preguntas que no aparecen en los archivos: un precio futuro, una función aún no lanzada, una política para un país no cubierto por el manual o una fecha que queda fuera del alcance del documento. El resultado deseado es una limitación clara, no una invención plausible.
Las pruebas negativas son importantes: la GPT debe admitir cuando una respuesta no se encuentra en los archivos y mantener la coherencia entre las diferentes reformulaciones.
Luego, reformula algunas preguntas, tanto positivas como negativas, de varias maneras. Si la pregunta "¿Cuál es el plazo para el reembolso?" funciona, pero "¿Cuánto tiempo tengo para devolverlo?" no, el problema podría ser la cobertura de recuperación, más que la falta de conocimiento. Mejora los encabezados, la terminología o las instrucciones antes de añadir más archivos.
8. Actualizaciones de versión, nuevas pruebas y saber cuándo el conocimiento estático no es la herramienta adecuada.
Siempre que modifique una fuente, elimine la versión obsoleta, adjunte la actual, guarde o actualice la GPT y vuelva a ejecutar el mismo conjunto de evaluación. Mantener un pequeño registro de cambios fuera de la GPT puede ayudarle a identificar si una regresión se debe a nuevas instrucciones, a una fuente reemplazada o a un cambio de plataforma.
Tras modificar los archivos fuente o las instrucciones, guarde la actualización y vuelva a ejecutar el mismo conjunto de evaluación.
El conocimiento estático tiene limitaciones. Si la fuente cambia constantemente, el acceso debe reflejar los permisos de cada usuario, o si el asistente necesita datos operativos en tiempo real, la carga repetida de archivos resulta poco fiable. Las aplicaciones de OpenAI con documentación sincronizada describen fuentes conectadas indexadas que se mantienen actualizadas respetando los permisos de la fuente. OpenAI también está orientando los flujos de trabajo GPT personalizados hacia los complementos, por lo que una base de conocimiento que cambia con frecuencia es una candidata idónea para una arquitectura conectada o migrada, en lugar de una creciente pila de archivos estáticos.
Cómo diagnosticar una GPT que aún “olvida” un archivo
Si se omite un dato conocido, primero compruebe que dicho dato se encuentra en un archivo adjunto actual. A continuación, formule una pregunta más específica que mencione el documento o tema. Si la pregunta específica funciona, mejore las pistas de recuperación simplificando los encabezados, dividiendo un documento demasiado amplio o eliminando versiones contradictorias. Si la pregunta específica sigue sin funcionar, convierta el material clave a un texto más claro y vuelva a realizar la prueba.
No solucione inmediatamente cada error añadiendo más instrucciones. Las reglas excesivas o contradictorias pueden hacer que el comportamiento sea menos predecible. Del mismo modo, no añada más archivos hasta que sepa que el conjunto existente está correcto. La señal de calidad que busca es la repetibilidad: el mismo conjunto de evaluación reducido debe superarse tras cada cambio, especialmente en cuestiones de alto riesgo relacionadas con políticas, aspectos legales, precios u operaciones.
El límite práctico: puedes mejorar la recuperación, pero no garantizarla.
Ningún comando puede garantizar que un modelo generativo consulte todos los archivos de conocimiento para cada respuesta con absoluta certeza. Por lo tanto, una GPT personalizada confiable es un flujo de trabajo diseñado, no una carga única: archivos fuente específicos, instrucciones explícitas de prioridad de origen, un comportamiento de abstención definido y evaluación repetible. Si estos controles aún no cumplen con la precisión o la actualización que necesita, cambie la arquitectura en lugar de seguir ajustando la misma configuración estática.
Para las GPT que cumplan los requisitos, este proceso puede reducir considerablemente el problema de que se pierda el archivo. Sin embargo, para los nuevos proyectos que comiencen a finales de 2026, la decisión a largo plazo también debería tener en cuenta la transición anunciada por OpenAI de los flujos de trabajo de GPT personalizados a los complementos y la disponibilidad de fuentes de conocimiento conectadas.