Inicio
» Dominios
»
Cómo crear un agente automatizado de procesamiento de facturas utilizando IA de código abierto
Cómo crear un agente automatizado de procesamiento de facturas utilizando IA de código abierto
Un agente automatizado de procesamiento de facturas no tiene por qué comenzar como un gran sistema de IA autónomo. Para una primera versión útil, conciba el agente como un flujo de trabajo de software controlado que recibe una factura, activa las herramientas de IA y el documento correspondiente, valida el resultado, decide si debe ser revisado por un humano y solo entonces guarda o exporta los datos aprobados.
Esa distinción es importante en finanzas. Un modelo de lenguaje puede ayudar a convertir diseños de facturas desordenados en campos estructurados, pero no debería ser el único factor para determinar si una factura es válida o si se puede contabilizar sin problemas. El diseño intuitivo de esta guía mantiene la extracción probabilística y las comprobaciones contables importantes deterministas.
Al final, dispondrá de un prototipo local que acepta facturas en formato PDF o imagen, extrae campos como proveedor, número de factura, fechas, moneda, totales y partidas, valida esos campos según ciertas reglas, envía los documentos dudosos a revisión, almacena un registro de auditoría y expone el proceso a través de una API.
¿Qué necesitas entender antes de empezar?
Hay cuatro términos que vale la pena conocer:
El OCR (reconocimiento óptico de caracteres) convierte el texto visible en una imagen o escaneo en texto legible por máquina.
El análisis de documentos conserva más estructura que el OCR convencional, como el orden de lectura, las tablas, los encabezados y las regiones de diseño.
El LLM (modelo de lenguaje grande) puede convertir el texto variable de una factura en una estructura JSON coherente.
El sistema de intervención humana implica que el sistema se detiene y solicita a una persona que revise los casos que no superan las comprobaciones, en lugar de asumir que todos los resultados son correctos.
A septiembre de 2026, varios proyectos de código abierto con mantenimiento activo cubren estas capas. Docling admite PDF, imágenes, documentos de Office y otros formatos de documentos; PaddleOCR proporciona sistemas de OCR y comprensión de documentos y se publica bajo Apache 2.0; y el proyecto Tesseract documenta su línea actual 5.x como un motor de OCR de código abierto en el manual oficial de Tesseract .
Para la inferencia de modelos locales, la documentación del servidor de llama.cpp describe puntos finales compatibles con OpenAI y una salida JSON con restricciones de esquema. Esto lo hace útil para un servicio de extracción, ya que se puede solicitar a un modelo alojado localmente que devuelva un objeto definido en lugar de texto sin restricciones.
Una advertencia importante sobre la licencia: un motor de inferencia de código abierto no implica automáticamente que todos los pesos del modelo sean de código abierto. Verifique la licencia del punto de control del modelo específico que implemente, especialmente si lo va a usar con fines comerciales.
¿Qué conjunto de herramientas debería usar un principiante?
Capa
Elección práctica
Por qué está aquí
Conversión de documentos
Documentación
Convierte archivos PDF e imágenes en una representación de documento estructurada y texto exportable.
Opción alternativa de OCR
PaddleOCR o Tesseract
Útil cuando la factura es un escaneo o una foto y se necesita OCR para extraer el texto.
Extracción de IA local
llama.cpp + un modelo de instrucciones adecuado
Asigna el texto variable de la factura a un esquema JSON estable, manteniendo la inferencia a nivel local.
Validación de esquema
Pydantic
Valida los datos de Python comparándolos con los tipos de campo y las restricciones declaradas.
API
API rápida
Acepta la carga de facturas y devuelve los resultados del procesamiento.
Almacenamiento
SQLite para un prototipo; PostgreSQL para un servicio compartido.
Almacena datos normalizados, el estado de revisión, la identidad del archivo de origen y los eventos de auditoría.
Orquestación
Primero Python puro; LangGraph opcional más adelante.
Una función determinista es más fácil de depurar. Añada un marco de agente con estado cuando la ramificación y la revisión humana se vuelvan más complejas.
La documentación oficial de Pydantic explica que los modelos heredan de BaseModel, validan los datos entrantes y pueden emitir JSON Schema a través de model_json_schema(). Consulte la validación de modelos de Pydantic . Si posteriormente necesita ramificaciones duraderas con estado, la referencia de LangGraph describe la compatibilidad con agentes con estado de larga duración, persistencia y flujos de trabajo con intervención humana.
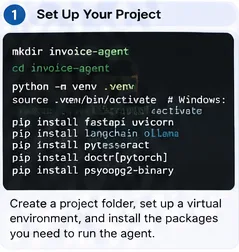
Paso 1: Configurar el proyecto y definir un primer objetivo concreto.
No empieces con la automatización de cuentas por pagar. Empieza con una clase de documento y un contrato de salida. Un buen producto mínimo viable (MVP) incluye: facturas de proveedores en inglés, entrada de PDF o imágenes, una entidad legal, un conjunto de monedas y sin ejecución automática de pagos.
Instale su motor OCR por separado si lo necesita. La guía de instalación actual de Docling utiliza pip install docling; la documentación de instalación actual de PaddleOCR distingue su paquete OCR base de los grupos de dependencias opcionales de análisis de documentos y extracción de información. Utilice la guía de instalación de Docling o la guía de instalación de PaddleOCR 3.x en lugar de copiar una lista de dependencias antigua.
Paso 1: Primero, crea un pequeño proyecto Python aislado. Mantén el primer tipo de factura y el esquema de salida lo suficientemente sencillos como para poder realizar pruebas exhaustivas.
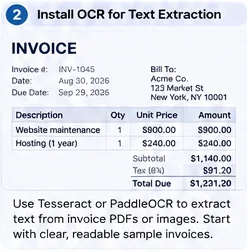
Paso 2: Convertir las facturas en datos de texto y diseño.
Los archivos PDF digitales originales pueden contener texto utilizable. Los archivos PDF escaneados y las fotos requieren OCR. El analizador debe ocultar esta diferencia al resto del proceso: las etapas posteriores deben recibir el texto normalizado del documento, además de cualquier información útil sobre el formato o las tablas.
Una conversión mínima de Docking se ve así:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
La guía de inicio rápido oficial de Docling utiliza el mismo patrón de conversión y exportación. Para colecciones con gran cantidad de OCR, pruebe PaddleOCR o Tesseract con sus propios escaneos. La documentación del proyecto PaddleOCR recomienda su nueva familia PP-StructureV3 para el análisis de documentos, mientras que Tesseract se puede ejecutar desde la línea de comandos o la API para el OCR de texto impreso.
Paso 2: Comience con facturas de muestra legibles que contengan los campos que planea extraer, y luego agregue escaneos más complejos solo después de que el proceso básico funcione.
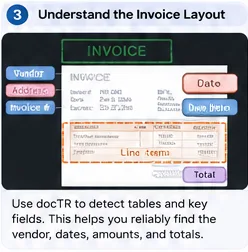
Paso 3: Decida exactamente qué datos tiene permitido generar el agente.
El esquema de extracción es el contrato entre la IA y la lógica contable. Evite un esquema gigante que incluya "todo lo que pueda aparecer en una factura". Comience con los campos que pueda validar.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"Esto resulta útil en este contexto, ya que los campos LLM inesperados no deberían incorporarse sin previo aviso a su registro contable. Tenga en cuenta también que la validación de Pydantic confirma la estructura y los tipos; no demuestra que el proveedor o el importe extraídos coincidan con la imagen de la factura.
Paso 3: Defina los campos objetivo en función de las necesidades del negocio y, a continuación, utilice la información de diseño y de tabla para preservar el origen de esos valores.
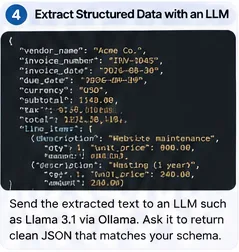
Paso 4: Utilice un modelo local para convertir el texto del documento en JSON estructurado.
Ejecute un modelo de instrucciones adecuado detrás del servidor HTTP de llama.cpp. El tamaño exacto del modelo depende de su hardware y de la complejidad de la factura. No dé por sentado que un modelo más grande es automáticamente mejor; evalúe la precisión de los campos, la latencia y el uso de memoria con su propio conjunto de facturas.
Actualmente, llama.cpp admite respuestas JSON con restricciones de esquema. Puede obtener ese esquema de Pydantic y enviarlo con la solicitud de extracción:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
La generación con restricciones de esquema ayuda a obtener una estructura válida, pero no garantiza la veracidad semántica. Un objeto JSON perfectamente válido aún puede contener un total incorrecto. Por eso, el siguiente paso es obligatorio.
Paso 4: Solicite al modelo local un objeto con estructura estricta, no prosa de formato libre, para que la validación posterior reciba campos predecibles.
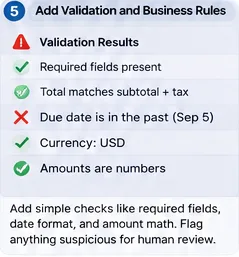
Paso 5: Agregar controles contables deterministas y reglas de revisión.
No le pregunte al LLM "¿Tiene confianza?" y confíe en la respuesta. La confianza en el modelo autoinformada no es un control calibrado. Implemente verificaciones que puedan recalcularse a partir de los datos extraídos y sus sistemas.
Algunas reglas iniciales útiles incluyen:
Los campos obligatorios están presentes;
El número de factura no está registrado previamente para el mismo proveedor;
Se permite el uso de moneda extranjera para ese proveedor o entidad;
Los importes de cada partida suman aproximadamente el subtotal;
El subtotal más los impuestos son aproximadamente iguales al total;
La fecha de la factura y la fecha de vencimiento son plausibles;
El proveedor existe en su base de datos de proveedores o está enrutado para su incorporación;
Las referencias de las órdenes de compra coinciden cuando se requiere la conciliación de las mismas.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Dirige cada verificación fallida a una cola de revisión. Para una primera implementación, es recomendable enviar todas las facturas a revisión mientras se mide la calidad de la extracción. Los umbrales de automatización deben basarse en la evidencia recopilada en tus propias facturas etiquetadas, no en un porcentaje genérico copiado de otro sistema.
Paso 5: Trate las reglas aritméticas, de detección de duplicados, de coincidencia de proveedores y de fechas como controles deterministas; dirija las excepciones a una persona.
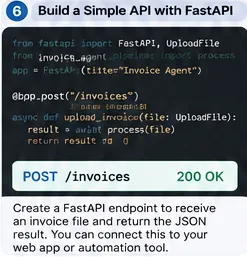
Paso 6: Envuelva el procesador en una pequeña API.
Una API permite que un formulario de carga, un procesador de correo electrónico, un monitor de carpetas compartidas o una integración contable llamen a la misma función de procesamiento. La guía oficial de carga de archivos de FastAPI recomienda UploadFileutilizar un archivo en cola para los archivos cargados, lo cual es más adecuado que cargar archivos grandes directamente en la memoria.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Consulte la documentación actual de FastAPI sobre archivos de solicitud para conocer los patrones de carga compatibles. En entornos de producción, también se deben aplicar límites de tamaño de archivo, análisis de malware cuando corresponda, autenticación de los usuarios, identificadores de solicitud y una limpieza segura de los archivos temporales.
Paso 6: Exponga un punto final de procesamiento después de que la canalización local funcione, de modo que varios canales de entrada puedan reutilizar la misma ruta de validación.
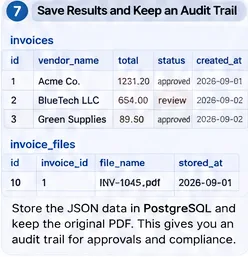
Paso 7: Almacenar la evidencia original, el resultado normalizado y los eventos de auditoría.
Nunca almacene únicamente el JSON final. Conserve suficiente evidencia para reconstruir lo sucedido: identidad del archivo original, hash, versión del analizador, identificador del modelo, versión de la solicitud, JSON extraído, resultados de la validación, decisión de revisión, marcas de tiempo y el usuario o servicio que aprobó el cambio.
Un prototipo sencillo puede usar SQLite. Un servicio multiusuario puede usar PostgreSQL con restricciones de unicidad y clave externa. La documentación actual de PostgreSQL cubre las restricciones de tabla , que son útiles para proteger claves y relaciones independientemente del proceso de IA.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
El hash de origen ofrece una segunda forma de detectar reenvíos accidentales. Mantenga los permisos de almacenamiento de archivos más estrictos que los de los registros generales de la aplicación, ya que las facturas suelen contener direcciones, datos bancarios, números de identificación fiscal y otra información confidencial de la empresa.
Paso 7: Conserve tanto los datos normalizados de la factura como los metadatos del archivo fuente para que las aprobaciones, los duplicados y las correcciones posteriores sigan siendo auditables.
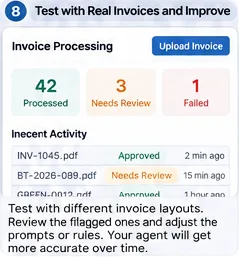
Paso 8: Pruebe con una variación de factura real antes de automatizar las acciones posteriores.
Un prototipo que funciona con cinco archivos PDF limpios no está listo para producción. Cree un conjunto de evaluación etiquetado que represente los datos que realmente recibe: diferentes proveedores, escaneos, páginas giradas, fuentes pequeñas, facturas de varias páginas, descuentos, líneas negativas, impuestos, gastos de envío, varias monedas, órdenes de compra faltantes y envíos duplicados.
Realice un seguimiento de las métricas a nivel de campo por separado. La "precisión de la factura" puede ocultar el hecho de que el nombre del proveedor es fácil de obtener, mientras que la cantidad de cada artículo no es confiable. Como mínimo, mida:
Coincidencia exacta en el número de factura, la moneda y las fechas;
Precisión de la tolerancia numérica para el subtotal, el impuesto y el total;
precisión y exhaustividad de las partidas individuales si estas son importantes posteriormente;
porcentaje enviado a revisión humana;
tasa de aprobación automática falsa;
latencia de procesamiento y tasa de fallos;
precisión en la detección de duplicados.
Almacena los fallos como casos de prueba. Cada vez que corrijas una regla del analizador, una solicitud, un esquema o un modelo, vuelve a ejecutar todo el conjunto de evaluación. Esto evita que una mejora de un proveedor afecte negativamente al diseño de otro.
Paso 8: Mida la cola de revisión y los casos de fallo en las facturas representativas antes de permitir que el agente automatice las acciones contables posteriores.
¿Cómo debe decidir el agente qué sucede a continuación?
Mantén la máquina de estados explícita. El “agente” puede ser inicialmente una función Python simple:
Esto ya se asemeja a un agente, ya que coordina herramientas y elige una rama. No necesitas un LLM para seleccionar cada paso siguiente. Agrega LangGraph u otro marco de orquestación cuando necesites revisiones persistentes de varias etapas, reintentos, devoluciones de llamada asíncronas o varias herramientas especializadas cuyo orden de ejecución cambie según el caso.
¿Qué errores deben evitar los principiantes?
Dejar que el LLM sea el control contable
El modelo debe extraer y normalizar los datos; el código y los datos del sistema de confianza deben verificarlos. Los cálculos aritméticos, las comprobaciones de duplicados, el estado del proveedor, la conciliación de órdenes de compra y los límites de aprobación deben regirse por una lógica determinista.
Descartar el documento fuente después de la extracción.
Conserve la factura original o una referencia controlada a la misma. Los revisores necesitan pruebas, y usted necesita una forma de reproducir los fallos tras las actualizaciones del modelo o del analizador sintáctico.
Utilizar una solicitud sin una versión
Almacene la versión y el identificador del modelo de la solicitud con cada factura procesada. De lo contrario, no podrá explicar por qué dos facturas procesadas con meses de diferencia se comportaron de manera distinta.
Publicar automáticamente cada resultado válido según el esquema.
La validez del JSON no es la misma que la validez de la factura. Comience con una revisión humana y, una vez que su evaluación demuestre un rendimiento aceptable, automatice únicamente los casos de bajo riesgo.
Ignorar las licencias del modelo y de los datos
Las bibliotecas y los pesos del modelo pueden tener licencias diferentes. PaddleOCR y Tesseract publican licencias de código abierto, mientras que la licencia del modelo que se ejecuta a través de llama.cpp depende de ese punto de control específico. Confírmelo antes de la implementación.
Construir la interfaz de usuario antes de demostrar la calidad de la extracción.
Un panel de control impecable no puede compensar cantidades incorrectas. Primero, pruebe el análisis de documentos, la extracción de esquemas y la validación; agregue una interfaz de revisión una vez que sepa qué necesitan ver realmente los revisores.
¿Cuándo se debe utilizar únicamente OCR, modelos de diseño o un LLM?
Acercarse
Mejor ajuste
Limitación principal
OCR + reglas
Un número reducido de plantillas de proveedores altamente estables.
Las reglas se vuelven frágiles a medida que varían los diseños.
Modelo de diseño de documentos
Tablas, formularios y campos donde la posición importa.
Puede requerir capacitación específica para la tarea o procesamiento posterior.
OCR/analizador de documentos + LLM local
Muchos formatos de factura con un esquema de destino común
Debe estar restringido y validado; la inferencia requiere mayor capacidad de cálculo.
Modelo de lenguaje visual
Documentos complejos donde el texto y el diseño visual están estrechamente vinculados.
Mayores requisitos de hardware y mayor complejidad en la evaluación.
La documentación actual de LayoutLMv3 de Hugging Face describe un modelo de IA para documentos que combina texto e información de diseño visual. La documentación de PP-StructureV3 de PaddleOCR también se centra en el diseño, las tablas y el análisis de documentos estructurados. Estas son opciones cuando el texto plano combinado con un modelo LLM no es suficiente.
¿Cuál es la ruta más sensata desde el prototipo hasta la producción?
Proceda por etapas. Primero, ejecute localmente en una carpeta de facturas etiquetadas. Segundo, añada la API y el almacenamiento persistente. Tercero, implemente una cola de revisión humana. Cuarto, integre consultas de solo lectura, como el maestro de proveedores o las órdenes de compra. Quinto, permita la exportación controlada a un área de preparación contable. Solo después de que el monitoreo demuestre la eficacia de los controles, considere la contabilización automática para casos de bajo riesgo claramente definidos.
En cada etapa, conserve tres cosas: la evidencia (el documento original y la fuente extraída), el determinismo (las reglas de negocio que se pueden volver a ejecutar) y la trazabilidad (qué analizador, modelo, solicitud y revisor produjeron el registro final).
Lista de verificación final
El analizador de facturas funciona tanto con archivos PDF digitales como con los escaneos que usted recibe.
El resultado de la extracción está restringido a un esquema Pydantic versionado.
El modelo no tiene permitido inventar valores faltantes.
Los totales, las fechas, los duplicados, la identidad del proveedor y las reglas de la orden de compra se validan fuera del LLM.
Las reglas que no funcionan dan lugar a una revisión humana en lugar de una corrección silenciosa.
Se registran el documento original, el hash de origen, el modelo, la versión de la solicitud y el resultado de la validación.
La API restringe el tipo y el tamaño de los archivos y requiere autenticación antes de su uso en producción.
Su conjunto de pruebas contiene variaciones de diseño reales y casos límite.
Se han comprobado las licencias del modelo y de la biblioteca para la implementación prevista.
Los instrumentos de contabilidad posteriores se introducen gradualmente y siguen siendo auditables.
Si se implementan esos controles, no se trata solo de una demostración de OCR, sino de la base de un agente de procesamiento de facturas confiable. Los componentes de código abierto pueden cambiar con el tiempo, pero la arquitectura se mantiene sólida: analiza la información, la extrae a un esquema, la valida mediante código, canaliza la incertidumbre a las personas y registra cada decisión.