Inicio
» Dominios
»
Cómo medir la calidad de respuesta a los programas de aprendizaje de idiomas utilizando marcos de evaluación.
Cómo medir la calidad de respuesta a los programas de aprendizaje de idiomas utilizando marcos de evaluación.
La forma más fiable de medir la calidad de respuesta de LLM es considerar la evaluación como un sistema de pruebas repetible, no como una puntuación única. Defina qué significa "bueno" para su aplicación, cree un conjunto de datos de evaluación representativo, combine comprobaciones deterministas con modelos y juicios humanos, compare cada cambio propuesto con una línea base e inspeccione los fallos por categoría antes de su lanzamiento.
Esto es importante porque un modelo de lógica descriptiva (LLM) puede generar una respuesta que parezca impecable, pero que en realidad sea incorrecta, no esté respaldada, sea incompleta, insegura o inconsistente con las instrucciones. Un marco de evaluación útil transforma estas dudas en criterios explícitos que pueden repetirse tras un cambio en la solicitud, una actualización del modelo, un cambio en la recuperación de datos, una actualización de la herramienta o una revisión de la política de seguridad.
Nota sobre la documentación: las funcionalidades del framework descritas a continuación se compararon con la documentación oficial disponible el 13 de septiembre de 2026. Estas herramientas evolucionan rápidamente, por lo que conviene verificar las API actuales antes de copiar código específico del framework a producción.
¿Qué deberías medir primero?
Empiece por el fallo que más afecte a sus usuarios. Para un bot de soporte que se basa en información objetiva, la precisión y el cumplimiento de las políticas pueden ser prioritarios. Para la generación aumentada por recuperación (RAG), la coherencia y la calidad de la recuperación son importantes, ya que una respuesta fluida aún puede inventar datos que no se corresponden con el contexto recuperado. Para un agente, la calidad de la respuesta final no es suficiente; también puede ser necesario evaluar la selección de herramientas, los argumentos de las herramientas, la finalización de la tarea y los pasos innecesarios.
Dimensión de calidad
Lo que pide
Buen tipo de evaluador
Exactitud
¿La respuesta es correcta desde el punto de vista de los hechos o de la lógica?
Comparación de referencias, verificación de códigos, juez LLM o revisión humana
Instrucciones a continuación
¿El modelo cumplió con las restricciones requeridas?
Reglas del código más juez basado en rúbricas
Enraizamiento
¿Están respaldadas las afirmaciones por el contexto proporcionado?
Verificaciones específicas del juez o a nivel de reclamación de RAG
Pertinencia
¿La respuesta contesta a la pregunta planteada sin desviarse del tema?
Juez de LLM o revisión humana
Cumplimiento del formato
¿La salida es un JSON válido, cumple con el esquema o es utilizable por máquina?
Código determinista
Seguridad y política
¿La respuesta infringe las normas de la aplicación?
Verificaciones de políticas, juez LLM y revisión humana específica
Eficiencia
¿Qué latencia, uso de tokens y coste requirió la respuesta?
Telemetría y rastreo
No promedies estos valores demasiado pronto. Un modelo candidato que mejora en estilo en dos puntos, pero introduce incluso un pequeño número de fallos graves en las políticas, podría resultar en una versión peor. Mantén las dimensiones críticas visibles como puntos de control separados.
Un flujo de trabajo de evaluación de cuatro etapas que funciona en diferentes marcos de trabajo.
1. Construir un conjunto de datos de evaluación representativo
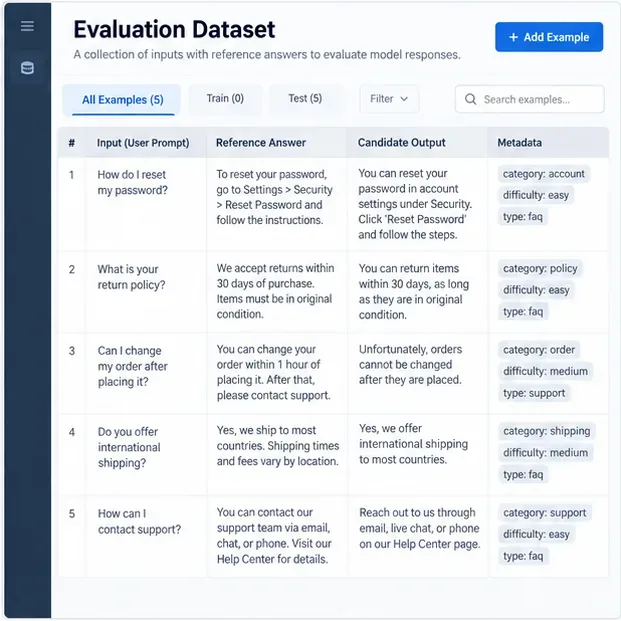
Tu conjunto de datos debe contener entradas realistas y, siempre que sea posible, el comportamiento esperado. Algunas filas pueden tener respuestas de referencia exactas; otras pueden requerir una rúbrica en lugar de una sola frase "clave". Agrega metadatos como tipo de tarea, segmento de clientes, idioma, dificultad, condición de recuperación o categoría de seguridad para que puedas segmentar los resultados posteriormente.
Por ejemplo, imaginemos un asistente de atención al cliente. Un conjunto de preguntas de evaluación útil no solo contendría preguntas frecuentes sencillas. También debería incluir solicitudes ambiguas, excepciones a las políticas, casos de contexto faltante, indicaciones adversariales, seguimientos de varias rondas y ejemplos donde el comportamiento correcto es indicar que la respuesta no se puede determinar.
La guía de evaluación actual de LangSmith recomienda comenzar con ejemplos seleccionados manualmente que muestren cómo debe ser un buen comportamiento, para luego ampliar el conjunto de datos con registros históricos y fallos detectados en producción. Su sistema de evaluación admite conjuntos de datos con entradas, salidas de referencia opcionales y metadatos. Consulte la documentación sobre conceptos de evaluación de LangSmith .
Un conjunto de datos de evaluación debe combinar indicaciones realistas con referencias o comportamientos esperados y conservar los metadatos para un análisis posterior de fallos.
¿Cuándo es apropiado este enfoque? Casi siempre. Incluso si utiliza la evaluación en producción en tiempo real, necesita un conjunto estable de datos fuera de línea para las pruebas de regresión. Si no dispone de una respuesta de referencia para las tareas abiertas, almacene una rúbrica, los datos requeridos, los comportamientos prohibidos o las preferencias por pares.
2. Asocie cada dimensión de calidad con el evaluador correcto.
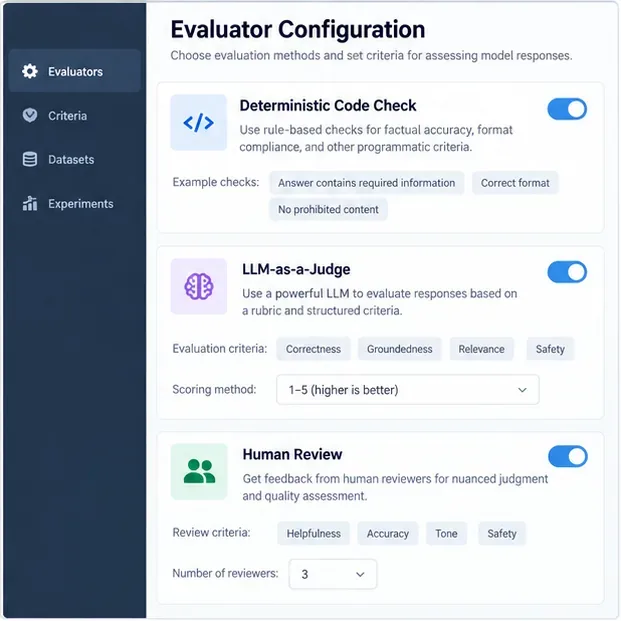
Las mejores plataformas de evaluación combinan diferentes tipos de evaluadores, ya que ningún evaluador individual es ideal para todas las preguntas.
Las comprobaciones deterministas son más adecuadas cuando el requisito es inequívoco: JSON válido, etiquetas exactas, claves obligatorias, tolerancia numérica, reglas de expresiones regulares o si una llamada a una herramienta utilizó argumentos aprobados.
Las métricas basadas en referencias pueden ser útiles cuando existe una respuesta conocida, pero la similitud de cadenas por sí sola suele ser demasiado frágil para paráfrasis válidas y demasiado indulgente con textos semánticamente incorrectos que comparten vocabulario.
El método LLM como criterio de evaluación resulta útil para evaluar criterios como la exhaustividad, la relevancia, el tono, la fidelidad o si una respuesta abierta cumple con una rúbrica.
La evaluación por pares resulta útil cuando es más fácil decidir si el candidato A o la línea base B es mejor que asignar una puntuación absoluta significativa.
La revisión humana sigue siendo importante para calibrar los sistemas de calificación automatizados, resolver casos subjetivos o de gran trascendencia y comprobar si la métrica en sí misma refleja el valor para el usuario.
La API Evals actual de OpenAI define una evaluación como criterios de prueba más un esquema de fuente de datos y admite calificadores reutilizables. Su API de calificadores incluye comprobaciones de cadenas deterministas, calificadores de similitud de texto y calificadores basados en modelos; consulte la referencia de la API Evals de OpenAI y la referencia de los calificadores de OpenAI . El servicio de evaluación Vertex AI Gen AI de Google Cloud admite métricas basadas en modelos puntuales y por pares, así como métricas basadas en cálculos; sus resultados pueden incluir puntuaciones por instancia, explicaciones, medias agregadas, desviaciones estándar y tasas de victoria por pares. Consulte la documentación de los resultados de evaluación de Vertex AI .
Utilice reglas deterministas siempre que sea posible, añada jueces LLM basados en rúbricas para la calidad semántica y mantenga disponible la revisión humana para la calibración y los casos con matices.
Cuando este enfoque sea apropiado: utilice comprobaciones deterministas para requisitos verificables por máquina, jueces LLM para cualidades semánticas y humanos cuando el desacuerdo tenga consecuencias comerciales o de seguridad significativas. Para un sistema RAG, Ragas expone métricas como precisión de contexto, recuperación de contexto, relevancia de respuesta y fidelidad, además de métricas de uso de agente/herramienta que incluyen precisión de llamada de herramienta y precisión de objetivo del agente. Consulte la documentación de métricas de Ragas . DeepEval también proporciona métricas específicas de la tarea y evaluación personalizada de jueces LLM, incluida la puntuación al estilo G-Eval; consulte la documentación de métricas de DeepEval .
3. Ejecute el mismo conjunto de datos contra una línea base y un candidato.
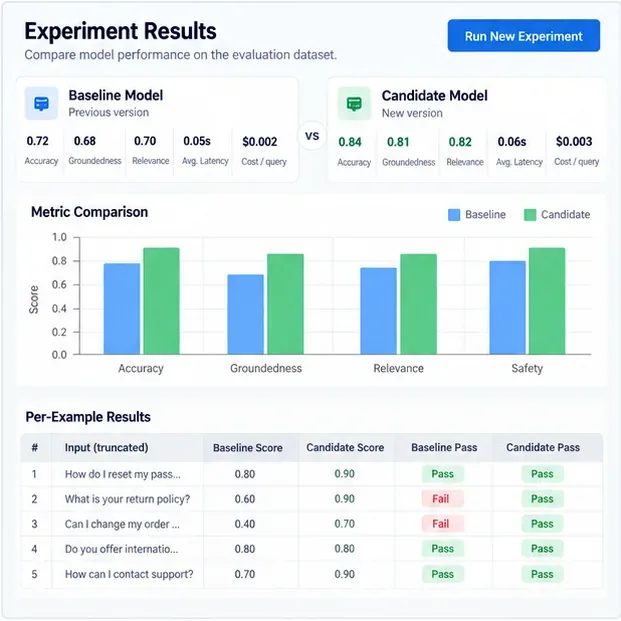
Las puntuaciones absolutas son útiles, pero las decisiones de lanzamiento suelen ser más claras cuando se prueba la nueva configuración con la versión en la que ya se confía. Mantenga el conjunto de datos, las definiciones del evaluador, los parámetros del modelo y la configuración de muestreo lo más estables posible. Luego, compare los mismos ejemplos uno al lado del otro.
Realizar un seguimiento de al menos tres niveles de resultados:
Puntuaciones por ejemplo: ¿Qué indicaciones específicas mejoraron o empeoraron?
Resultados por segmento: ¿Cambió el rendimiento en el caso de preguntas con contexto extenso, un idioma determinado, casos difíciles, una categoría de producto o entradas adversarias?
Resultados agregados: ¿Qué sucedió con la tasa de aprobación, la puntuación promedio, la latencia, el uso de tokens, el costo y el número de fallos graves?
Para sistemas no deterministas, repita las pruebas importantes suficientes veces para comprender la variabilidad, en lugar de asumir que una sola ejecución representa el modelo. Si la decisión de lanzamiento es relevante, utilice comparaciones por pares con los mismos ejemplos e informe la incertidumbre, en lugar de basarse únicamente en un pequeño cambio en la media.
LangSmith admite experimentos sin conexión para comparar versiones y evaluadores por pares, mientras que la pila de evaluación GenAI actual de MLflow admite conjuntos de datos de evaluación, puntuadores integrados y personalizados, jueces LLM, retroalimentación humana, seguimiento y monitorización de la producción. Consulte Evaluación de LangSmith y Evaluación de agentes y LLM de MLflow .
Compare un candidato con la línea base actual en los mismos ejemplos, luego inspeccione tanto las métricas agregadas como los resultados de aprobación o reprobación por ejemplo.
Este enfoque es adecuado siempre que se modifique un modelo, una solicitud del sistema, una canalización de recuperación, la implementación de una herramienta o la configuración de decodificación. Un candidato no debe ser promovido simplemente porque una métrica agregada aumente; debe cumplir con los umbrales de lanzamiento en dimensiones críticas y evitar regresiones inaceptables a nivel de segmento.
4. Inspeccione los fallos, calibre al juez y convierta las regresiones en nuevas pruebas.
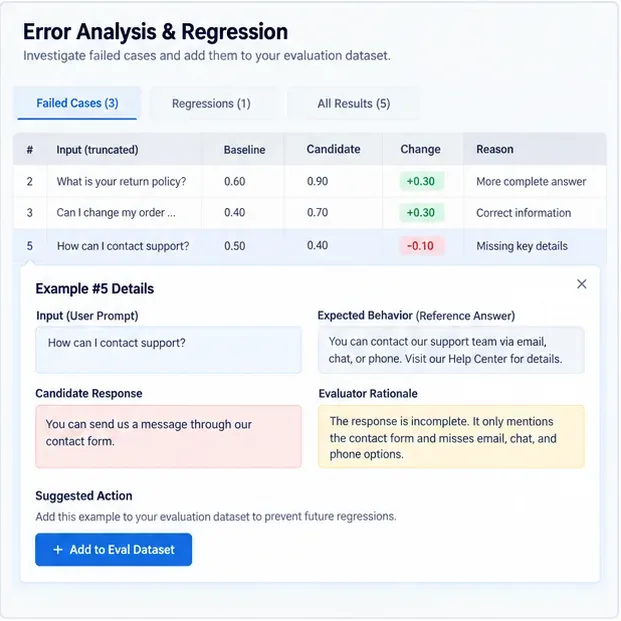
Una evaluación solo es valiosa si modifica tus acciones posteriores. Clasifica los fallos por gravedad y causa raíz. Una puntuación baja en la fundamentación puede deberse a una recuperación deficiente, una pregunta que incite a adivinar, una rúbrica de evaluación demasiado vaga o una respuesta de referencia incorrecta. Lee los ejemplos subyacentes antes de modificar el modelo.
Luego, se convierten los fallos importantes en casos de regresión permanentes. Esto crea un círculo virtuoso: en producción se detecta un fallo, un humano lo confirma, el caso se añade al conjunto de datos sin conexión, la solución se prueba con el conjunto completo de pruebas y se impide que las futuras versiones reintroduzcan el mismo problema.
Los jueces de LLM también necesitan evaluación. La documentación de Google describe explícitamente la comparación de los resultados de las métricas basadas en modelos con las calificaciones humanas para determinar si el juez es suficientemente bueno para un caso de uso particular. El trabajo de GDPval de OpenAI utiliza de manera similar la calificación por pares de expertos como estándar principal y describe la calificación automatizada como una aproximación, no como un reemplazo del juicio de expertos. Consulte la guía de Vertex AI sobre la evaluación de un modelo de juez y la metodología de GDPval de OpenAI .
Revise los ejemplos fallidos reales, confirme que el evaluador está juzgando correctamente y agregue las regresiones importantes al conjunto de pruebas permanente.
Este enfoque es adecuado siempre que se trate de errores de alto impacto y cuando un juez de LLM influya en una fase de publicación. Si los revisores humanos discrepan repetidamente con el juez, se debe corregir la rúbrica, proporcionar referencias más claras, modificar el modelo de evaluación o volver a someter ese criterio a revisión humana.
¿Qué tan confiable es un LLM como juez?
Los evaluadores de LLM son poderosos porque pueden evaluar resultados abiertos a una escala que la revisión exclusivamente humana no puede igualar. La investigación original de G-Eval reportó una correlación sustancialmente mejor con el juicio humano que las métricas automáticas tradicionales en el contexto de resumen estudiado. Sin embargo, el mismo artículo advirtió que los evaluadores de LLM pueden favorecer el texto generado por LLM. Consulte el artículo original de G-Eval .
Investigaciones independientes realizadas en MT-Bench y Chatbot Arena descubrieron que los jueces con un alto nivel de competencia en LLM pueden alinearse bien con las preferencias humanas, al tiempo que documentan sesgos relacionados con la posición, la verborrea, la autoafirmación y el razonamiento. Consulte el estudio original sobre LLM como juez .
La conclusión práctica no es «nunca usar jueces de LLM». Es: calibrelos. Cree una muestra etiquetada por humanos, mida el grado de acuerdo, examine las categorías de desacuerdo, aleatorice o intercambie el orden de las respuestas en las pruebas por pares cuando los efectos de posición sean plausibles, y evite que la misma indicación vaga del juez determine tácitamente cada decisión de publicación.
¿Qué marco de evaluación debería elegir?
Estructura
Mejor ajuste
Fuerza notable
Evaluadores y calificadores de OpenAI
Equipos que ya utilizan las API de OpenAI y desean ejecutar evaluaciones nativas de la API.
Definiciones de evaluación reutilizables con calificadores deterministas y basados en modelos.
LangSmith
Aplicaciones LLM que requieren seguimiento, conjuntos de datos, pruebas de regresión fuera de línea y evaluación en línea.
Comparación de experimentos sólida y ciclo de retroalimentación de producción
Ragas
Evaluación de flujos de trabajo RAG y del uso de agentes/herramientas
Métricas de recuperación, fidelidad, relevancia y herramientas diseñadas específicamente para este fin.
Evaluación profunda
Equipos centrados en Python que desean evaluaciones estilo prueba y jueces LLM personalizables.
Amplio catálogo de métricas, evaluación de componentes/de extremo a extremo y métricas de trayectoria de agentes.
Evaluación de MLflow GenAI
Equipos que ya utilizan MLflow o que desean que las evaluaciones estén vinculadas al rastreo y la gestión del ciclo de vida.
Conjuntos de datos, evaluadores, retroalimentación humana, seguimiento de experimentos y monitorización de la producción.
Evaluación de IA Gen de Vertex AI
Implementaciones de Google Cloud
Flujos de trabajo de evaluación puntuales, por pares, basados en modelos y basados en cálculos.
La elección del framework es menos importante que el diseño de la evaluación. Puedes crear un conjunto de pruebas deficiente en una plataforma sofisticada o uno robusto con unos pocos scripts. Prioriza la herramienta que permita que tus pruebas sean reproducibles, versionadas, fáciles de inspeccionar y fáciles de ejecutar antes de cada cambio significativo.
Un cuadro de mando práctico para el lanzamiento
Para un asistente de producción, una decisión de lanzamiento útil puede expresarse como un conjunto de criterios en lugar de una puntuación combinada. Por ejemplo, exigir cero fallos críticos de seguridad en el conjunto de seguridad seleccionado, ninguna regresión estadísticamente significativa en la corrección de las tareas, una tasa mínima de aprobación de fundamentos para las preguntas RAG, una salida estructurada válida en cada caso de esquema y una latencia o coste dentro del presupuesto operativo. Los umbrales exactos deben derivarse de la tolerancia al riesgo y los requisitos del usuario; no existe un porcentaje universal que determine que un LLM sea "suficientemente bueno".
Además, conserva los ejemplos originales que respaldan la puntuación. Si una versión pasa de 0,84 a 0,86, aún necesitas saber qué dos casos cambiaron y si esos cambios son relevantes. En la práctica, los equipos aprenden más de un número reducido de fallos claramente categorizados que de un promedio impresionante en un panel de control sin trazabilidad.
Errores comunes en la evaluación
Probar únicamente los escenarios ideales: añadir ambigüedad, casos límite, intentos de inyección de código, contexto faltante y fallos históricos conocidos.
Utilice la coincidencia exacta para respuestas abiertas: reserve la coincidencia exacta para resultados donde la exactitud sea realmente necesaria.
Confiar en un juez de LLM sin calibración: compárelo con las etiquetas humanas y revise las discrepancias.
Optimizar el promedio ocultando fallas graves: mantener la seguridad, las políticas y otras dimensiones críticas como criterios explícitos.
Modificación del conjunto de datos durante la comparación de modelos: congele el conjunto de comparación o cree versiones para que los resultados sigan siendo interpretables.
Ignorar las desviaciones en la producción: las evaluaciones fuera de línea protegen los lanzamientos; la evaluación en línea y la revisión humana por muestreo revelan nuevos comportamientos del usuario y nuevos modos de fallo.
En resumen
Medir la calidad de respuesta de LLM es una disciplina de ingeniería, no una simple evaluación. Comience con un conjunto de datos representativo, defina dimensiones de calidad específicas para cada tarea, elija verificaciones deterministas siempre que sea posible calcular el requisito, utilice evaluadores de LLM cuando sea necesario un juicio semántico, calibre dichos evaluadores con humanos y compare los cambios propuestos con una línea base estable. Luego, convierta cada fallo importante del mundo real en una futura prueba de regresión.
Si se sigue ese ciclo, el marco de evaluación se convierte en algo más que un panel de informes: se convierte en el sistema de control de calidad que indica si una solicitud, un modelo, un cambio en la recuperación o una actualización del agente realmente mejoraron el producto.