Inicio
» Dominios
»
Cómo solucionar el error "API Timeout Error" al ejecutar flujos de trabajo multiagente.
Cómo solucionar el error "API Timeout Error" al ejecutar flujos de trabajo multiagente.
Un error de tiempo de espera de API en un flujo de trabajo multiagente rara vez se soluciona cambiando un solo valor. Un planificador puede llamar a tres agentes, cada agente puede llamar a una API de LLM, servicio de búsqueda, base de datos o herramienta, y cada capa puede tener su propio tiempo de espera, política de reintentos, grupo de conexiones y límite de concurrencia. La solución práctica consiste en identificar qué capa agota el tiempo de espera primero y, a continuación, elegir entre esperas más largas, menos llamadas concurrentes, reintentos más inteligentes, una ruta crítica más corta o un diseño de trabajo asíncrono.
La compensación es importante: aumentar el tiempo de espera es sencillo, pero consume recursos durante más tiempo; los reintentos agresivos pueden multiplicar la carga y el coste; reducir la concurrencia mejora la estabilidad, pero disminuye el rendimiento máximo; los agentes paralelos reducen la latencia real solo cuando los servicios posteriores pueden absorber la carga de trabajo. No existe una configuración óptima para todos los sistemas multiagente.
¿Qué tiempo de espera estás alcanzando realmente?
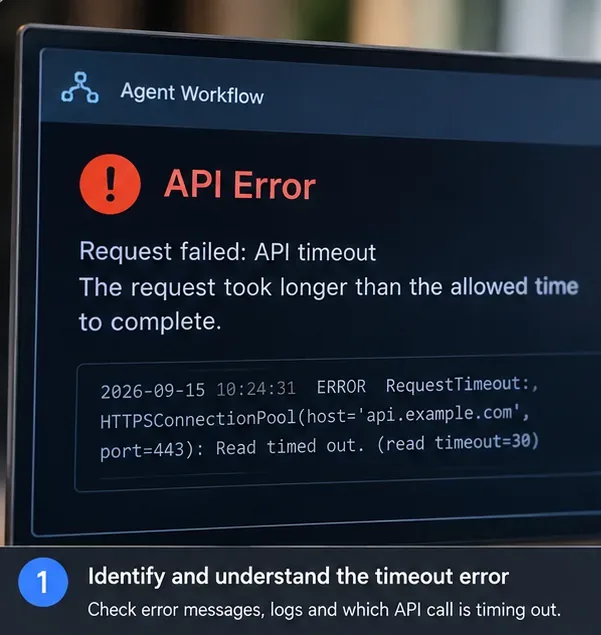
Comience por clasificar el fallo en lugar de tratar cada tiempo de espera como el mismo evento. Los clientes HTTP pueden agotar el tiempo de espera mientras se conectan, leen, escriben o esperan una conexión de un grupo. HTTPX, por ejemplo, documenta cuatro tipos de tiempo de espera distintos: conexión, lectura, escritura y grupo. Su comportamiento predeterminado es generar un tiempo de espera después de cinco segundos de inactividad de la red, no necesariamente cinco segundos de duración total de la solicitud. Consulte la documentación oficial de tiempos de espera de HTTPX .
Si utiliza el SDK de OpenAI para Python, su archivo README oficial actual indica que las solicitudes tienen un tiempo de espera predeterminado de 10 minutos y que los fallos de tiempo de espera se reintentan dos veces por defecto. El SDK también reintenta automáticamente los errores de conexión, así como las respuestas HTTP 408, 409, 429 y 5xx con un breve retroceso exponencial. Estos son los valores predeterminados del SDK, no una garantía de que cada proxy, balanceador de carga, puerta de enlace u orquestador que se encuentre delante de la solicitud espere 10 minutos. Consulte el archivo README oficial del SDK de OpenAI para Python .
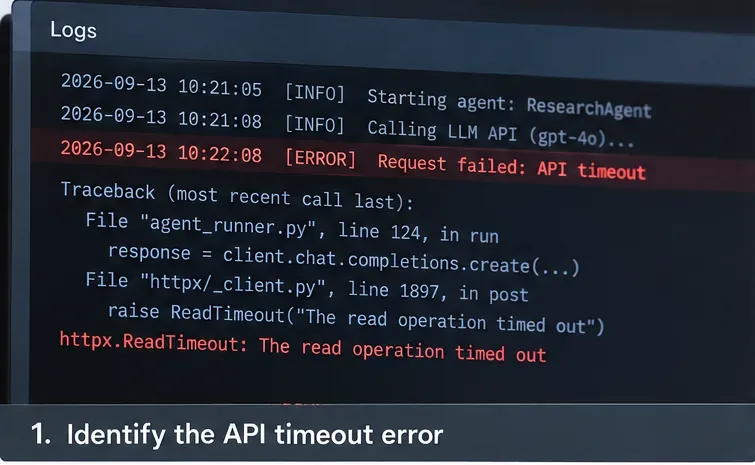
Paso 1: capture la excepción exacta y el agente, el punto final y la capa de transporte que agotaron el tiempo de espera, en lugar de registrar solo un fallo genérico del flujo de trabajo.
¿Qué solución debería elegir?
Opción
Mejor ajuste
Beneficio principal
principal compensación
Aumentar el tiempo de espera de la solicitud
Llamadas a modelos/herramientas saludables pero legítimamente lentas
Cambios mínimos en el código y la arquitectura.
Los trabajadores y las conexiones permanecen ocupados durante más tiempo; una puerta de enlace ascendente aún puede finalizar la solicitud primero.
Reintentar con retroceso exponencial
Errores transitorios de red, límites de velocidad, fallos 5xx seleccionados
Se recupera automáticamente de fallos de corta duración.
Puede multiplicar el tráfico, la latencia y el costo; no es seguro para acciones no idempotentes a menos que esté diseñado cuidadosamente.
Menor concurrencia de agentes
429s, tiempos de espera en la piscina, saturación aguas abajo
Reduce los picos de tráfico y la contención de la cola.
Menor rendimiento máximo y, en ocasiones, mayor tiempo de finalización del flujo de trabajo.
Paralelizar agentes independientes
Flujos de trabajo secuenciales con ramas independientes
Acorta la ruta crítica
Aumenta las solicitudes simultáneas y puede activar límites de velocidad o de conexión.
Salida parcial del flujo
Experiencia de usuario interactiva donde la latencia del primer byte es crucial.
Los usuarios ven el progreso antes.
No resuelve automáticamente un tiempo de espera de integración estricto ni un servicio descendente sobrecargado.
Trasladar el trabajo a una tarea/cola asíncrona.
Flujos de trabajo que pueden tardar decenas de segundos o minutos.
Desacopla el ciclo de vida de la solicitud HTTP del ciclo de vida del flujo de trabajo.
Requiere estado del trabajo, sondeo/webhooks, idempotencia, persistencia y monitorización operativa.
Paso 1: Encuentra la primera capa que exceda su fecha límite.
Registre un ID de correlación para todo el flujo de trabajo y un ID de segmento o secundario para cada llamada de agente y herramienta. Registre la hora de inicio, la hora de finalización, el punto final, el número de intento, el tipo de excepción, el estado de la respuesta (cuando esté disponible) y si la cancelación provino de la persona que realizó la llamada o del servicio posterior.
La pregunta clave es: "¿Quién dejó de esperar primero?". Si la llamada LLM finaliza en 42 segundos, pero una puerta de enlace API se rinde a los 30 segundos, aumentar el tiempo de espera del cliente LLM de 60 a 120 segundos no cambia nada. La documentación actual de Amazon para las API HTTP de API Gateway indica un tiempo de espera máximo de integración de 30 segundos, lo que ilustra por qué el plazo más corto de la cadena suele determinar el resultado. Consulte Cuotas de la API HTTP de Amazon API Gateway .
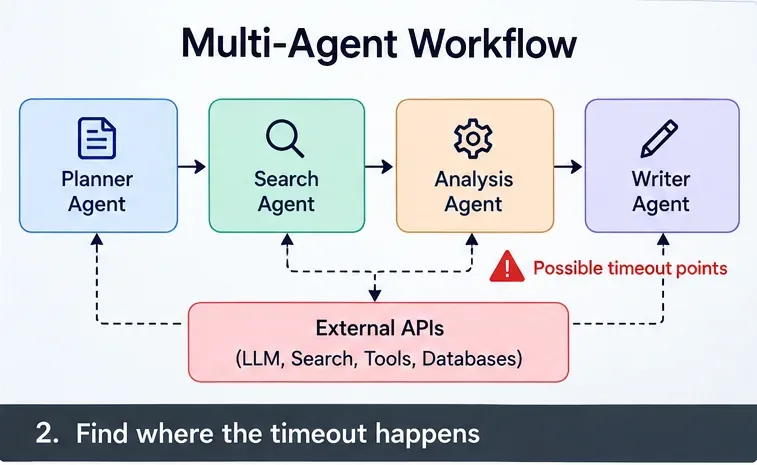
Paso 2: mapee la ruta de la solicitud y marque cada lugar que pueda terminar o retrasar una llamada: orquestador, agente, puerta de enlace, API del modelo, API de búsqueda, base de datos y servicio de herramientas.
Paso 2: Mida la ruta crítica, no solo la latencia promedio.
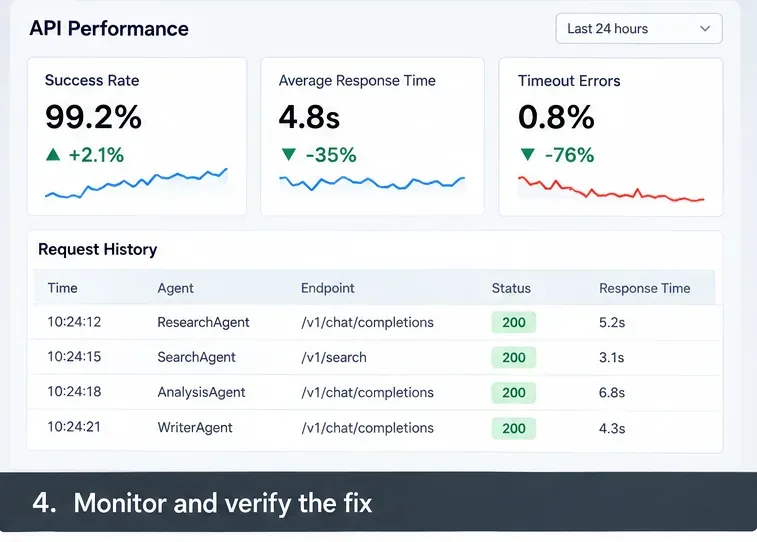
Una latencia promedio puede parecer normal, mientras que una pequeña cantidad de llamadas lentas provoca la mayoría de los fallos en el flujo de trabajo. Monitorice al menos la tasa de éxito por dependencia, además de la latencia p50, p95 y p99. En una etapa de distribución, registre también el tiempo de espera en la cola y el tiempo de espera del grupo de conexiones, ya que una "API lenta" podría deberse en realidad a un cliente sobrecargado esperando una conexión libre.
Utilice los registros de seguimiento para responder a tres preguntas prácticas: qué dependencia domina la ruta crítica, si varios agentes lentos se ejecutan secuencialmente cuando podrían ejecutarse simultáneamente y si los picos de concurrencia coinciden con los errores 429, pool-timeout o 5xx.
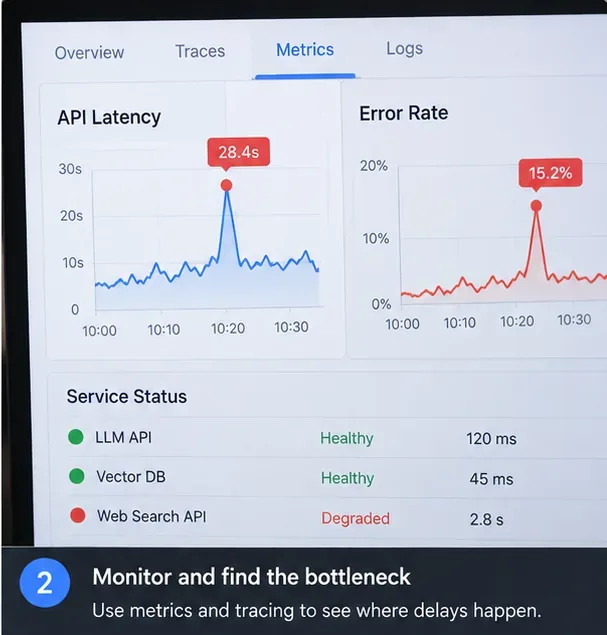
Paso 3: compare la latencia, los errores y el estado de las dependencias; un pico de tiempo de espera que coincida con una dependencia degradada sugiere una solución diferente a la de un pico de concurrencia en todo el sistema.
Paso 3: Elabore un presupuesto de tiempo fuera desde afuera hacia adentro.
Primero, establece un plazo para el flujo de trabajo completo y luego reduce los plazos internos para que las capas inferiores fallen con la suficiente antelación como para que el orquestador pueda recuperarse. Por ejemplo, un plazo de 120 segundos para el usuario final podría reservar 10 segundos para la orquestación y el procesamiento de respuestas, dejando 110 segundos para tareas útiles. Una llamada a una herramienta individual podría recibir 15 segundos, mientras que una llamada a un modelo podría recibir 45 o 60 segundos, dependiendo de la latencia observada.
No copie esos valores a ciegas; son solo un ejemplo de método de presupuestación, no valores predeterminados universales. Elija valores de la distribución de latencia medida y del SLO del producto. El plazo externo debe ser lo suficientemente largo como para abarcar la llamada interna, sus reintentos permitidos, los retrasos de retroceso y el tiempo de limpieza.
Python 3.11 y versiones posteriores permiten asyncio.timeout()establecer un plazo límite para el trabajo asíncrono. Cuando expira el plazo, la tarea se cancela y el gestor de contexto muestra un error TimeoutError. Consulte la documentación oficial de Python sobre el tiempo de espera de asyncio .
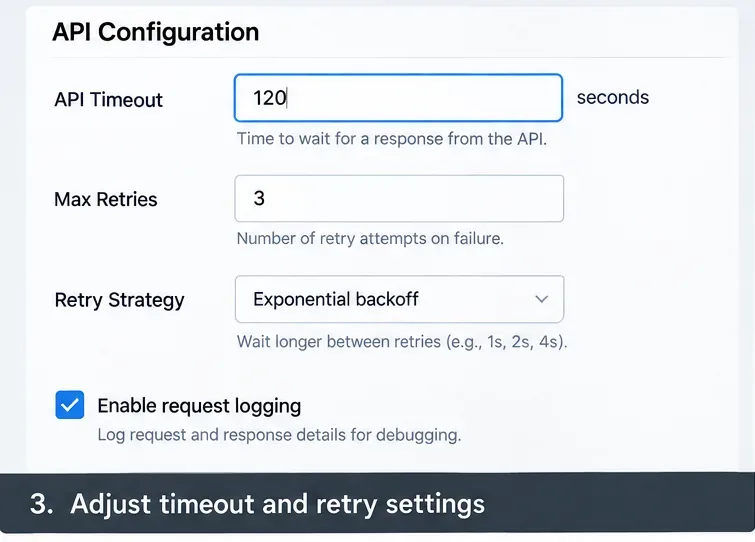
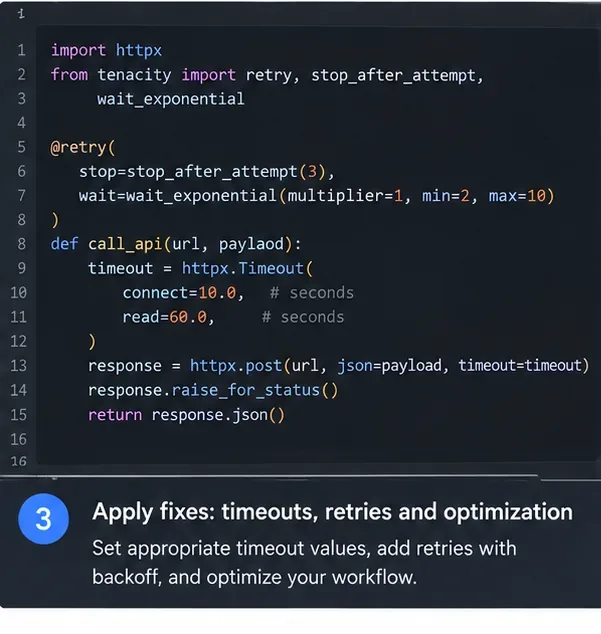
Paso 4: configure los valores de tiempo de espera y reintentos como un presupuesto coordinado en lugar de aumentar cada valor de forma independiente.
Paso 4: Limita la concurrencia antes de aumentar los reintentos.
Los sistemas multiagente suelen fallar porque la propagación de solicitudes crece más rápido de lo previsto. Si 20 solicitudes de usuario activan cinco agentes cada una, y cada agente ejecuta dos herramientas, el sistema puede generar hasta 200 llamadas descendentes antes de los reintentos. Añadir reintentos desde el principio puede convertir la congestión en una avalancha de reintentos.
Un limitador de concurrencia suele ser la mejor primera medida cuando se observan respuestas 429, tiempos de espera agotados en el pool, un aumento en el tiempo de espera en la cola o una dependencia descendente saturada. Python asyncio.Semaphoreofrece una forma sencilla, basada en contadores, de limitar cuántas corrutinas acceden a una sección protegida a la vez. Consulte la documentación oficial de semáforos de Python .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
La compensación es intencionada: un límite inferior protege los servicios posteriores, pero puede aumentar la congestión en la cola dentro de la aplicación. Ajústelo en función del rendimiento, la latencia p95, los límites de velocidad y la capacidad del grupo de conexiones, en lugar de elegir el número máximo que su máquina pueda programar.
Paso 5: combine la concurrencia limitada con configuraciones de transporte explícitas para que un grupo de conexiones completo no se haga pasar por un modelo o herramienta lenta.
Paso 5: Vuelva a intentar solo los fallos que tengan probabilidades de éxito posteriormente.
Los reintentos son útiles para fallos de conexión transitorios, límites de velocidad, errores específicos del servidor y tiempos de espera de las solicitudes cuando repetir la operación es seguro. Sin embargo, son una mala opción predeterminada para errores de validación, fallos de autenticación, errores deterministas de las herramientas o acciones con efectos secundarios sin protección de idempotencia.
Presta atención a la multiplicación de reintentos. Si un SDK realiza dos reintentos, esto significa hasta tres intentos para una llamada lógica. Si la capa de agentes también reintenta la llamada completa dos veces, el máximo teórico se convierte en nueve intentos para esa operación lógica: tres intentos externos multiplicados por tres intentos del SDK. Si el orquestador reintenta entonces toda una etapa de cinco agentes, el volumen de solicitudes puede aumentar rápidamente.
Centralice la gestión de los reintentos siempre que sea posible. Para las llamadas LLM que utilizan el SDK de OpenAI para Python, recuerde que el SDK actual ya reintenta ciertas clases de fallos dos veces por defecto. Añada un reintento externo solo cuando tenga un motivo específico y pueda limitar el presupuesto total de intentos. citeturn212133view0turn212133view1
Paso 6: clasifique el error antes de volver a intentarlo; un tiempo de espera de lectura agotado puede justificar un reintento limitado, mientras que un error de configuración permanente generalmente no lo justifica.
Paso 6: Acortar la ruta crítica sin crear un problema de ramificación.
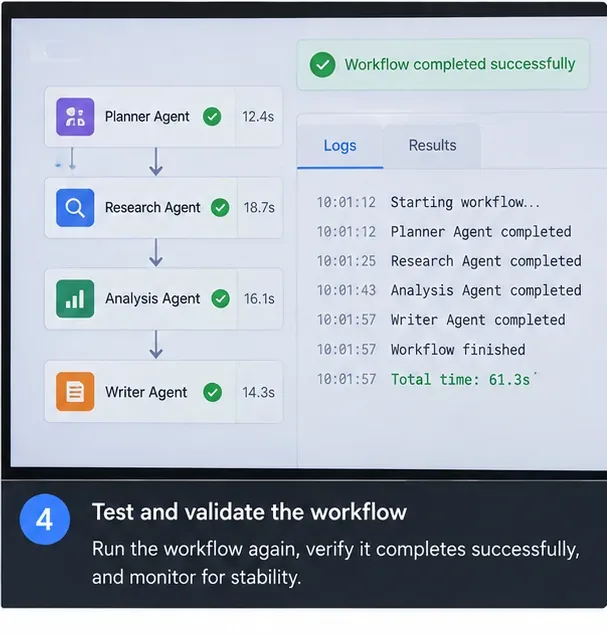
Si los agentes de planificación, investigación, evaluación y redacción se ejecutan uno tras otro, la latencia total es aproximadamente la suma de sus duraciones. En ocasiones, las ramas independientes pueden ejecutarse simultáneamente, lo que reduce el tiempo real de ejecución hacia la rama más lenta en lugar de la suma de todas las ramas.
En Python, TaskGroup asyncio.TaskGroupes una forma estructurada de ejecutar tareas relacionadas simultáneamente. La documentación actual de Python indica que TaskGroup espera a que finalicen las tareas del grupo y cancela las restantes cuando una falla con una excepción que no requiere cancelación, lo que proporciona un comportamiento de seguridad más robusto que la generación de tareas no estructurada. Consulte la documentación oficial de Python TaskGroup .
La paralelización tiene un coste. Si el mismo proveedor impone un límite estricto de solicitudes por minuto o de solicitudes concurrentes, ejecutar cuatro agentes a la vez puede convertir un flujo de trabajo lento pero exitoso en una ráfaga rápida de 429 respuestas. Paralelice únicamente el trabajo verdaderamente independiente y mantenga el limitador de concurrencia global.
Paso 7: ¿Cuándo se debe dejar de usar una solicitud HTTP síncrona?
Si los flujos de trabajo habituales superan con frecuencia el tiempo de espera de solicitud más corto en su ruta de red, migrar a un modelo de trabajo asíncrono suele ser más eficiente que extender continuamente cada tiempo de espera. La solicitud HTTP inicial puede validar la entrada, crear un trabajo persistente y devolver inmediatamente un ID de trabajo. Los trabajadores ejecutan el gráfico multiagente fuera del ciclo de vida de la solicitud, mientras que el cliente recibe información sobre el progreso mediante sondeo, eventos enviados por el servidor, WebSockets o un webhook.
La transmisión de datos es útil cuando el servidor puede comenzar a enviar información relevante con anticipación. El SDK de OpenAI para Python, por ejemplo, admite la transmisión de eventos enviados por el servidor para las llamadas a la API Responses. La transmisión mejora la percepción de la capacidad de respuesta y puede mantener una conexión activa que genere datos, pero no resuelve automáticamente el problema de la duración máxima de las solicitudes de cada proxy. Consulte la referencia oficial de eventos de transmisión de OpenAI .
Elija una tarea asíncrona cuando la durabilidad sea más importante que la simplicidad inmediata: tareas de investigación extensas, flujos de trabajo de agentes con aprobación humana, numerosas llamadas a herramientas, operaciones costosas que no desea repetir o cargas de trabajo que deben sobrevivir a desconexiones de clientes. El costo radica en la gestión adicional del estado: estado de la tarea, puntos de control, claves de idempotencia, cancelación, almacenamiento de resultados y propiedad de los reintentos.
Paso 7: para flujos de trabajo largos, realice un seguimiento de la finalización del agente como un estado de flujo de trabajo duradero en lugar de depender de que una conexión de cliente permanezca abierta hasta que todos los agentes terminen.
Paso 8: Validar la solución bajo una carga realista.
Una solución no se considera probada solo porque una solicitud tenga éxito. Realice pruebas con la concurrencia prevista en producción y mida la tasa de éxito, la tasa de tiempo de espera, los intentos de reintento por tarea lógica, la latencia p95 y p99, el retraso de la cola, el tiempo de espera del grupo de conexiones, las tasas de errores 429/5xx posteriores y el costo por flujo de trabajo completado.
Si ejecutas agentes en Kubernetes, utiliza las sondas de disponibilidad y de actividad para distintos fines. Kubernetes documenta las sondas de disponibilidad como el mecanismo que determina si un Pod debe recibir tráfico, mientras que las sondas de actividad determinan cuándo debe reiniciarse un contenedor. Su documentación advierte explícitamente que las comprobaciones de actividad mal implementadas pueden provocar fallos en cascada bajo carga. Consulta la documentación oficial de las sondas de Kubernetes .
Ante una sobrecarga temporal, declararse "no preparado" suele ser más seguro que poner en riesgo la salud de trabajadores que, aun estando sanos, están muy ocupados. Reserve las fallas de disponibilidad para situaciones en las que reiniciar el proceso sea realmente la medida de recuperación adecuada.
Paso 8: verifique el cambio con tráfico similar al de producción y métricas de latencia de cola, no solo con una única prueba exitosa.
¿Cómo saber qué solución es la adecuada para tu patrón de fallos?
Patrón observado
Primer cambio más útil
Qué no hacer primero
Las llamadas finalizan justo después de la fecha límite del cliente; la comunicación descendente es correcta.
Aumenta el tiempo límite interno específico y reajusta el presupuesto del plazo externo.
Aumentar los reintentos
Los errores 429 y los tiempos de espera del pool aumentan con la concurrencia.
Reducir la concurrencia y añadir colas/contrapresión.
Lanzar más agentes en paralelo
Errores 408/5xx o fallos de red ocasionales.
Utilice reintentos con retroceso exponencial limitado para operaciones idempotentes.
Reintentar cada excepción indefinidamente
El flujo de trabajo suele tardar más de lo que permiten los límites de la puerta de enlace.
Utilice una arquitectura de trabajo asíncrono o un diseño de transmisión compatible.
Sigue aumentando solo el tiempo de espera del SDK.
Una dependencia lenta domina la latencia p99.
Optimiza, almacena en caché, reemplaza o aísla esa dependencia; considera una alternativa.
Ajustar los tiempos de espera de los agentes no relacionados
Los fallos aparecen solo después de añadir agentes paralelos.
Mantén el paralelismo útil, pero añade un semáforo global y límites por proveedor.
Supongamos que el procesamiento en paralelo siempre es más rápido.
Una base de producción práctica
Para una API multiagente típica, una base sólida consiste en asignar a cada flujo de trabajo un ID de correlación, rastrear cada llamada de agente y herramienta, definir un plazo de extremo a extremo, asignar plazos más cortos por llamada dentro de él, imponer un límite de concurrencia global por proveedor descendente, mantener los reintentos limitados e idempotentes, y conservar suficiente estado para reanudar o informar de una finalización parcial.
Luego, ajuste el sistema a partir de las mediciones. Si el sistema es estable pero demasiado lento, paralelice selectivamente las tareas independientes. Si es rápido con poca carga pero falla con carga máxima, reduzca la distribución de recursos y aumente la contrapresión. Si los flujos de trabajo exitosos tardan más de lo que permite la ruta de solicitud síncrona, cambie de arquitectura en lugar de intentar que cada proxy espere más.