Accueil
» Domaines
»
Comment configurer une base de connaissances IA locale et privée pour les documents personnels
Comment configurer une base de connaissances IA locale et privée pour les documents personnels
La solution pratique la plus simple : exécuter le modèle de langage, le modèle d’embeddings, l’index des documents et l’interface de chat sur votre propre ordinateur. Une solution simple consiste à utiliser Ollama pour le déploiement local du modèle, associé à AnythingLLM auto-hébergé pour l’ingestion des documents, la génération assistée par la recherche (RAG) et le chat. Conservez la base de données vectorielle en local, utilisez un stockage persistant, évitez les fournisseurs de modèles cloud et vérifiez que les réponses sont bien basées sur vos fichiers.
Exemple illustratif : tout au long de ce guide, imaginez que Jordan organise une collection privée comprenant des manuels d’utilisation, des documents PDF sur les assurances, des comptes rendus de réunions, un guide de finances personnelles et quelques rapports de projets. Jordan est un personnage fictif. Les fichiers, questions, réponses et résultats décrits ci-dessous sont des exemples illustrant le processus, et non des résultats de tests ou un témoignage.
Ce guide propose une configuration en quatre étapes pour une meilleure compréhension des limites de confidentialité. Il convient à une personne seule ou à un petit foyer de confiance souhaitant effectuer des recherches de documents en local et obtenir des réponses à des questions. Si vous avez besoin de contrôles d'identité d'entreprise, d'une disponibilité multi-nœuds, d'un audit centralisé ou de garanties réglementaires, considérez ce guide comme une architecture de base plutôt que comme une solution de conformité complète.
Que signifie concrètement « base de connaissances IA locale privée » ?
Une base de connaissances locale ne revient pas à entraîner un modèle sur vos documents. Dans un flux de travail RAG classique, le système extrait le texte de vos fichiers, le divise en segments, convertit ces segments en représentations vectorielles numériques, les stocke dans une base de données vectorielle, récupère les segments pertinents pour chaque question et envoie uniquement ces segments au modèle de langage comme contexte.
La documentation actuelle d'AnythingLLM décrit les flux de travail avec documents joints et documents intégrés. Les documents joints peuvent insérer du texte intégral dans une conversation lorsque la fenêtre de contexte le permet, tandis que RAG extrait des extraits pertinents des documents intégrés. La documentation actuelle de LanceDB local indique également que la base de données LanceDB par défaut de l'instance conserve le texte des documents et leurs intégrations au sein de l'application AnythingLLM. Consultez la documentation relative aux flux de travail documentaires d'AnythingLLM et la documentation relative à LanceDB pour AnythingLLM .
Composant
Rôle dans la pile locale
choix respectueux de la vie privée
Ollama
Exécute le modèle de chat et, en option, un modèle d'intégration sur votre machine.
Utilisez un modèle local, et non un point de terminaison de modèle hébergé dans le cloud
AnythingLLM
Fournit l'interface utilisateur, la gestion des documents, le découpage en segments, le RAG et l'organisation de l'espace de travail
Exécutez-le localement et conservez son répertoire de stockage de manière persistante.
Modèle d'intégration
Transforme les fragments de documents et les requêtes en vecteurs pour la recherche sémantique.
Utilisez un module d'intégration local si les documents ne doivent pas être envoyés à un service externe.
LanceDB
Stocke les vecteurs utilisés pour trouver les passages pertinents
Conservez l'instance locale par défaut, sauf si vous avez intentionnellement besoin d'une base de données distante.
Fichiers originaux et sauvegardes
Restez la source faisant autorité
Protégez-les avec les contrôles d'accès, le chiffrement et les sauvegardes habituels du système d'exploitation.
Avant de commencer : définissez les limites de votre vie privée.
La question essentielle n'est pas « L'application est-elle locale ? » mais plutôt « Quels composants peuvent envoyer du texte ou des invites depuis l'ordinateur ? ». Une interface utilisateur locale peut être configurée pour appeler un LLM cloud, une API d'intégration cloud, une recherche web ou des outils distants. Pour une configuration privée, conservez le LLM, l'outil d'intégration et la base de données vectorielles en local, sauf si vous avez délibérément accepté les implications du partage de données d'un fournisseur externe.
AnythingLLM documente la télémétrie anonyme et propose une méthode pour la désactiver. Sa documentation relative à la confidentialité fait également la distinction entre la suppression d'un document d'un espace de travail et sa suppression complète de la bibliothèque de documents. Pour une suppression définitive dans AnythingLLM, la documentation actuelle recommande de supprimer le document de « Mes documents » , ce qui supprime le code source analysé, les intégrations mises en cache ainsi que les références à l'espace de travail. Consultez la documentation d'AnythingLLM relative à la confidentialité et au traitement des données avant d'ajouter des données sensibles.
Vous devez également prévoir suffisamment de mémoire pour le modèle local choisi. Il n'existe pas de taille de modèle idéale, car la vitesse d'exécution dépend du processeur, de la carte graphique, de la RAM ou de la VRAM, de la quantification, de la longueur du contexte et du nombre de documents récupérés. Privilégiez un modèle adapté à votre configuration plutôt que le plus volumineux que votre machine puisse difficilement charger.
Étape 1 : Installez Ollama et préparez les modèles de chat et d’intégration locaux.
Installez Ollama en suivant les instructions correspondant à votre système d'exploitation. Ollama est disponible pour macOS, Windows et Linux, et son API locale est accessible par défaut sur le port 11434. Le guide de démarrage rapide officiel d'Ollama est la meilleure source d'informations pour l'installation et la syntaxe des commandes.
Après l'installation, téléchargez un modèle de chat compatible avec votre matériel. Le modèle exact n'est pas précisé ici, car le catalogue de modèles évolue et les exigences matérielles varient. Voici un exemple de commande :
ollama pull <chat-model-name>
Pour RAG, vous avez également besoin d'un modèle d'embedding. La documentation actuelle d'Ollama sur les embeddings, mise à jour en septembre 2026, recommande des modèles tels que embeddinggemma, qwen3-embedding, et all-minilm. Vous pouvez consulter la liste complète dans la documentation d'Ollama sur les embeddings . Par exemple :
ollama pull embeddinggemma
N'utilisez pas un modèle de chat standard comme modèle d'intégration simplement parce qu'il figure dans la liste déroulante des modèles. La documentation actuelle de l'intégrateur Ollama d'AnythingLLM indique clairement qu'Ollama peut inclure à la fois des modèles de chat et des modèles d'intégration dans la même liste. Utilisez un modèle d'intégration dédié à l'indexation des documents. Consultez la configuration de l'intégrateur Ollama d'AnythingLLM .
Exemple de procédure pour extraire un modèle local avec Ollama. La version affichée n'est pas recommandée ; veuillez vérifier la version installée dans la documentation officielle d'Ollama.
Dans le cadre fictif de Jordan, l'objectif à ce stade est simple : la génération et l'intégration doivent être possibles sans envoyer les documents du ménage à une API distante.
Étape 2 : Exécutez AnythingLLM localement avec un stockage persistant et connectez-le à Ollama.
AnythingLLM propose des options pour ordinateur et auto-hébergées. Ce guide utilise Docker car la délimitation du stockage est claire et la sauvegarde simplifiée. La documentation Docker locale actuelle indique aux utilisateurs de télécharger l'image et souligne l'importance d'un stockage persistant : sans cela, les données de l'application peuvent être perdues lors de la recréation du conteneur. Elle précise également que l'application web est disponible à l'adresse suivante : [adresse manquante] http://localhost:3001. Veuillez utiliser le guide Docker local officiel d'AnythingLLM plutôt que de copier une ancienne commande trouvée sur un forum.
docker pull mintplexlabs/anythingllm:latest
Lors de l'exécution du conteneur, préservez le stockage d'AnythingLLM en montant un répertoire hôte /app/server/storage. La documentation du fournisseur indique clairement que ce montage persistant est nécessaire. Conservez ce répertoire de stockage sur un disque inclus dans votre plan de sauvegarde.
Configurez ensuite le fournisseur LLM avec Ollama. Si AnythingLLM est exécuté directement sur l'hôte, l'adresse Ollama par défaut est `/var/log/localhost` http://127.0.0.1:11434. Si AnythingLLM est exécuté dans un conteneur Docker tandis qu'Ollama est exécuté sur l'hôte, n'utilisez pas `/var/ log/localhost` localhostdepuis le conteneur. La documentation réseau Docker d'AnythingLLM indique d'utiliser ` /var/log/localhost` http://host.docker.internal:11434sur les plateformes de bureau prises en charge ; sous Linux, elle documente 172.17.0.1ce modèle de connexion à l'hôte. Consultez la note relative au réseau localhost d'AnythingLLM et la configuration LLM d'Ollama .
Dans les paramètres, sélectionnez Ollama comme fournisseur LLM et, si vous le souhaitez, comme fournisseur d'intégration. Choisissez le modèle de chat pour la génération et le modèle d'intégration pour l'indexation. Dissocier ces rôles permet d'éviter une erreur de configuration fréquente.
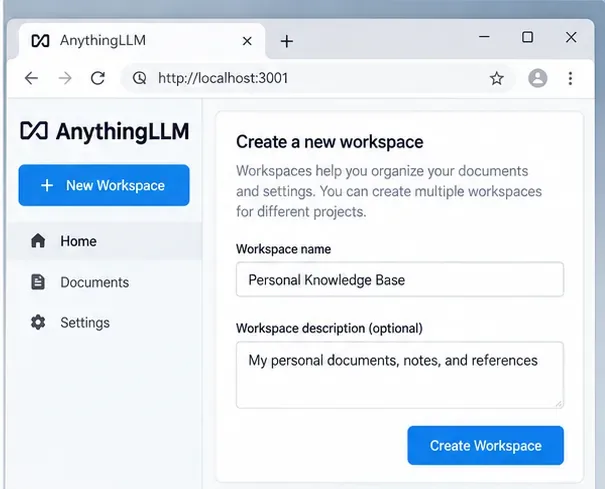
La version auto-hébergée d'AnythingLLM est conçue pour fonctionner sur localhost:3001. Un espace de travail dédié permet de définir clairement l'objectif d'une collection de documents et d'éviter que des documents non pertinents ne soient inclus dans le pool de récupération.
Jordan crée un espace de travail appelé « Base de connaissances personnelle » et évite de se connecter à des fournisseurs de modèles cloud. Cela facilite l'audit ultérieur du périmètre défini : interface utilisateur locale, LLM local, plongements lexicaux locaux, vecteurs locaux.
Étape 3 : Ajouter des documents, choisir entre RAG et pièce jointe en texte intégral, puis vérifier l’importation
Ne commencez pas par importer l'intégralité de votre disque dur. Optez plutôt pour un petit ensemble représentatif de documents dont vous connaissez bien le contenu. Cela vous permettra de détecter les problèmes d'extraction ou de récupération de manière contrôlée avant que l'index ne s'alourdisse.
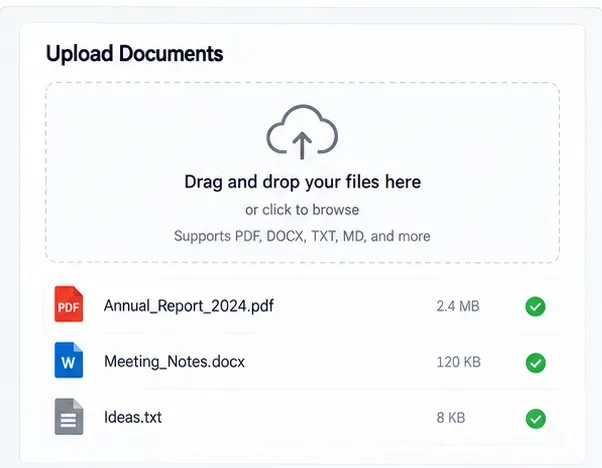
Pour reprendre l'exemple de Jordan, un premier lot utile pourrait inclure un PDF consultable, un fichier DOCX et une note en texte brut ou Markdown. Si les PDF numérisés contiennent des images au lieu de texte sélectionnable, vérifiez que votre logiciel de traitement de documents extrait bien le texte nécessaire ; un fichier qui vous semble lisible peut néanmoins produire une représentation textuelle vide ou de mauvaise qualité pour RAG.
AnythingLLM prend actuellement en charge deux grands comportements de documents :
Documents joints : utiles lorsque le texte intégral tient dans la fenêtre de contexte du modèle et que vous souhaitez que le modèle voie le fichier complet de cette discussion.
Documents intégrés avec RAG : utiles pour les collections volumineuses ou réutilisables. Le système segmente le contenu, l’intègre et extrait les portions pertinentes pour une question.
Le guide de documentation actuel d'AnythingLLM indique que les documents intégrés à un espace de travail sont accessibles depuis tous les fils de discussion de cet espace. C'est pratique, mais cela signifie également que l'appartenance à un espace de travail fait partie intégrante de votre modèle de confidentialité dans les environnements multi-utilisateurs. Veillez à bien séparer vos espaces de travail personnels des espaces de travail partagés.
Exemple de vue d'ingestion avec plusieurs types de documents. Commencez par un petit lot fonctionnel, puis vérifiez l'extraction et l'indexation avant d'ajouter une archive volumineuse.
Après l'intégration, posez une question dont la réponse n'apparaît que dans un seul fichier. Ensuite, demandez un détail qui n'apparaît dans aucun fichier. La première question teste la capacité de recherche ; la seconde teste si le modèle prend en compte l'incertitude au lieu d'inventer une réponse.
Que régler si la récupération est faible ?
AnythingLLM propose des options RAG (Recherche, Analyse, Affichage) au niveau de l'espace de travail, comme les préférences de recherche, le nombre maximal d'extraits de contexte et le seuil de similarité entre les documents. Sa documentation recommande de commencer par configurer l'espace de travail plutôt que de supposer que le modèle de base est à l'origine du problème. Augmenter la quantité de contexte récupéré peut s'avérer utile lorsque la réponse couvre plusieurs sections, mais envoyer trop d'extraits peut également ajouter du texte non pertinent et saturer l'espace disponible dans la fenêtre de contexte.
Si vous modifiez les modèles d'intégration après l'indexation, réintégrez les documents concernés afin que les vecteurs stockés et les vecteurs de requête proviennent du même espace d'intégration. Mélanger des intégrations issues de modèles différents ne constitue pas une stratégie de recherche pertinente.
Étape 4 : Tester les réponses validées, sécuriser la confidentialité et sauvegarder la base de connaissances
Une base de connaissances n'est utile que si l'on peut détecter ses erreurs. Constituez une petite liste d'évaluation à partir de faits que vous pouvez vérifier directement. Par exemple :
Demandez une date, un montant, un modèle de produit ou une clause de police qui figure textuellement dans un seul document.
Posez une question transversale qui nécessite des informations provenant de deux fichiers.
Posez une question délibérément impossible à répondre et vérifiez que la réponse ne falsifie pas une source.
Posez la même question avec une formulation différente pour voir si la récupération est stable.
Ouvrez le document source et vérifiez manuellement chaque affirmation cruciale.
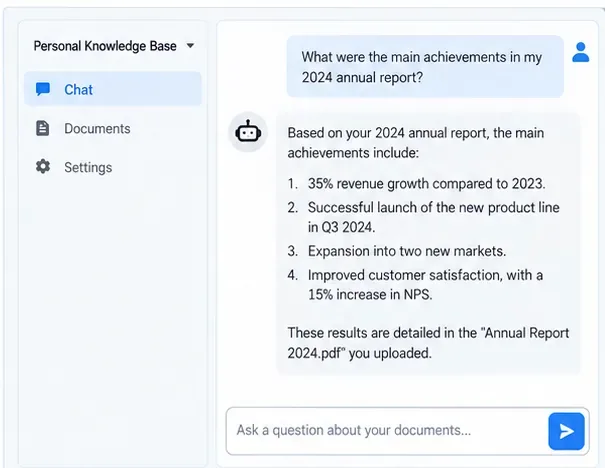
Réponse hypothétique, fondée sur un document, utilisée pour illustrer l'étape de vérification. Les figures présentées sont un exemple fictif ; dans une base de connaissances réelle, vérifiez les affirmations importantes par rapport au fichier original.
Pour Jordan, un bon critère d'acceptation n'est pas « la réponse semble correcte », mais « la réponse correspond à la source, inclut le contexte nécessaire et est invalidée sans risque lorsque la source ne contient pas l'information ». Ce critère est particulièrement important pour les impôts, les assurances, les documents juridiques, les dossiers médicaux et les décisions financières.
Conservez la configuration privée une fois qu'elle fonctionne.
L'inférence locale réduit l'exposition des données, mais la confidentialité dépend toujours de la configuration. Utilisez ces contrôles comme une liste de vérification pratique :
Limitez le service AnythingLLM à la machine locale ou à un réseau privé de confiance, sauf si l'accès à distance est intentionnellement sécurisé.
N’ajoutez pas d’intégrations LLM cloud, d’intégration cloud, de recherche Web, de navigateur ou d’agent à un espace de travail contenant des informations sensibles, sauf si vous comprenez ce que ces intégrations transmettent.
Désactivez la télémétrie anonyme si votre politique de confidentialité exige l'absence totale de télémétrie produit.
Utilisez le chiffrement de disque et les autorisations de compte de votre système d'exploitation. Une base de données de vecteurs locale reste accessible même si un attaquant accède à la machine.
Supprimez les fichiers sensibles de la bibliothèque de documents, et pas seulement d'un espace de travail, lorsque vous prévoyez une suppression complète dans AnythingLLM.
Mettez à jour Ollama, AnythingLLM, Docker et le système d'exploitation hôte. « Hors ligne » ne signifie pas « jamais maintenu ».
Sauvegardez les parties difficiles à recréer
Les documents originaux restent votre source de référence, mais le répertoire de stockage d'AnythingLLM contient la base de données de l'application, les documents analysés, les données vectorielles et la configuration nécessaires pour éviter de tout reconstruire après une panne de disque. Sauvegardez à la fois le dossier de documents original et le stockage persistant d'AnythingLLM. Si vous utilisez des volumes Docker au lieu d'un répertoire hôte monté, suivez la documentation officielle de Docker sur la sauvegarde et la restauration des volumes .
Testez la restauration, pas seulement la création de la sauvegarde. Une sauvegarde n'est validée que si vous pouvez la restaurer dans un autre répertoire ou sur une autre machine, démarrer l'environnement local, ouvrir l'espace de travail et retrouver correctement une donnée connue.
Quand cette configuration convient — et quand elle ne convient pas
Cette architecture est parfaitement adaptée si votre priorité est de conserver vos documents personnels sur un matériel que vous contrôlez, si vous êtes à l'aise avec l'utilisation de logiciels locaux et si vous souhaitez une recherche sémantique ainsi que des réponses en langage naturel pour une bibliothèque de documents de taille modeste. Elle s'avère également utile lorsque l'accès à Internet est instable ou si vous souhaitez des coûts locaux prévisibles après le téléchargement des modèles.
Cette solution est moins adaptée si votre ordinateur ne peut pas exécuter un modèle local adéquat, si vous avez besoin d'un accès continu depuis de nombreux appareils hors de votre réseau domestique, ou si vous exigez une gestion des identités, des audits, des obligations de conservation légale, une gestion centralisée des clés ou une assistance garantie de niveau entreprise. Dans ces cas, une solution de déploiement privé géré ou une plateforme RAG d'entreprise sera peut-être plus appropriée qu'une configuration sur un seul PC.
Liste de vérification compacte pour l'installation
Installez Ollama et vérifiez l'inférence du modèle local.
Installez un modèle d'intégration dédié tel que celui listé dans la documentation actuelle d'Ollama sur les intégrations.
Exécutez AnythingLLM localement avec un stockage persistant.
Connectez AnythingLLM au point de terminaison Ollama local en utilisant l'adresse hôte correcte pour votre méthode de déploiement.
Utilisez une base de données vectorielle locale telle que LanceDB, la base de données par défaut d'AnythingLLM, lorsque l'objectif est la récupération de documents uniquement en local.
Créez un espace de travail à périmètre restreint.
Commencez par quelques documents connus et vérifiez l'extraction.
Utilisez RAG pour les grandes collections réutilisables et les pièces jointes en texte intégral uniquement lorsque le document correspond parfaitement au contexte du modèle.
Testez les questions auxquelles il est possible de répondre et celles auxquelles il est impossible de répondre avant de faire confiance au système.
Désactivez les intégrations externes et la télémétrie inutiles conformément à vos exigences en matière de confidentialité.
Sauvegardez à la fois les documents sources et le stockage persistant de l'application, puis testez une restauration.