Accueil
» Domaines
»
Comment générer automatiquement des balises méta titres et descriptions SEO avec Local Ollama
Comment générer automatiquement des balises méta titres et descriptions SEO avec Local Ollama
Vous avez 300 pages produits, documentations ou articles de blog prêtes à être publiées, mais la colonne des métadonnées est encore vide. Rédiger manuellement chaque titre et chaque méta-description est fastidieux ; copier un modèle sur l’ensemble du site génère des résultats répétitifs ; et demander à un modèle de langue locale un « titre SEO » renvoie souvent des commentaires supplémentaires, des affirmations inventées ou une mise en forme incohérente.
Une meilleure approche consiste à traiter la génération de métadonnées comme un petit pipeline de données : fournir au modèle uniquement les informations spécifiques à la page, exiger une sortie structurée, la valider dans le code, puis examiner les exceptions avant publication. Ollama est parfaitement adapté à ce flux de travail car son API locale est disponible http://localhost:11434/apiaprès installation et il prend en charge les sorties structurées au format JSON. La documentation d'Ollama et de Google Search mentionnée ici a été consultée le 13 septembre 2026.
Pourquoi les métadonnées SEO automatiques dysfonctionnent-elles ?
La plupart des échecs proviennent du flux de travail autour du modèle plutôt que d'une seule « mauvaise invite ». Les causes courantes incluent la fourniture d'un contenu de page insuffisant, le fait de laisser le modèle répondre en prose libre, l'application de la même formule de mots clés à chaque URL et la publication de la sortie sans vérification des doublons au niveau du site.
Il existe également une idée fausse persistante concernant les limites de caractères. Google précise qu'il n'y a pas de limite de longueur fixe pour <title>l'élément titre ou la méta-description d'une page ; les liens titres et les extraits sont tronqués selon les besoins, généralement en fonction de la largeur de l'écran. Google peut également générer un lien titre ou un extrait différent à partir du contenu de la page si ses systèmes estiment qu'une autre représentation est plus pertinente. Consultez les recommandations officielles de Google concernant les liens titres , les extraits et les méta-descriptions .
Cela signifie qu'un script peut imposer des limites de longueur éditoriale pour des raisons de cohérence, mais il ne doit pas les présenter comme des exigences de Google. Dans l'exemple ci-dessous, les 65 caractères pour le titre et les 165 pour la description ne sont que des limites internes. Adaptez-les à votre système de gestion de contenu, votre marque, vos besoins de localisation et votre processus de validation.
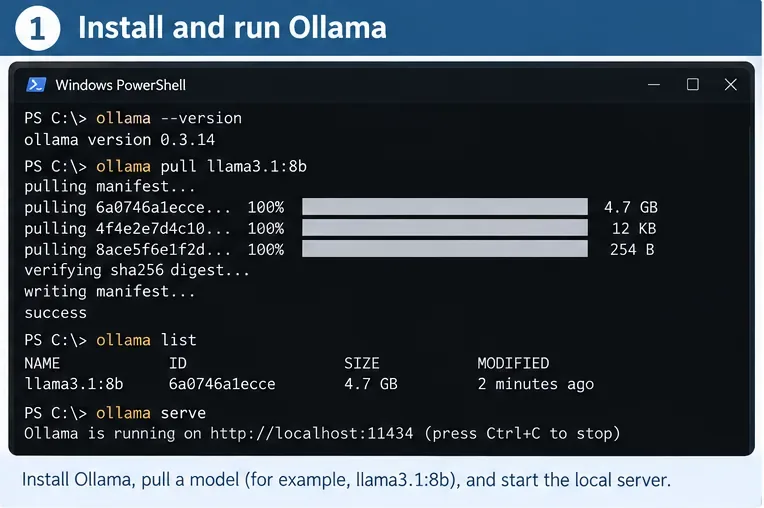
Étape 1 : Installez Ollama et vérifiez que l’API locale fonctionne.
Le guide de démarrage rapide officiel d'Ollama indique la compatibilité avec macOS, Windows et Linux. Après l'installation, téléchargez un modèle local. La documentation actuelle d'Ollama utilise fréquemment ce modèle gemma3dans ses exemples d'API ; il constitue donc un exemple neutre pratique pour ce tutoriel.
ollama pull gemma3
Testez ensuite le point de terminaison local :
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
La documentation de l'API Ollama indique que l'API locale est accessible à l'adresse http://localhost:11434/api. Ollama précise également que l'accès local à cette adresse ne nécessite aucune authentification. Si votre service local n'est pas en cours d'exécution, ollama servela commande CLI documentée pour le démarrer est . Évitez de substituer un -cloudmodèle si votre objectif est une inférence véritablement locale.
Procédure de configuration : vérifier Ollama, télécharger un modèle local, confirmer sa présence dans la liste des modèles locaux et s’assurer de la disponibilité du service en local. Les valeurs de nom et de longueur du modèle indiquées sont des exemples et ne constituent pas des exigences SEO.
Choisissez un modèle en fonction de votre matériel
Cet article ne prétend pas qu'un modèle soit universellement optimal pour les métadonnées SEO. La disponibilité des modèles et la compatibilité matérielle évoluent, et les modèles plus volumineux nécessitent davantage de mémoire et sont généralement plus lents. Commencez par un modèle que votre machine peut exécuter sans problème, générez un petit ensemble de données, puis comparez l'exactitude des faits, l'unicité, la latence et la cohérence avant de traiter des milliers de pages.
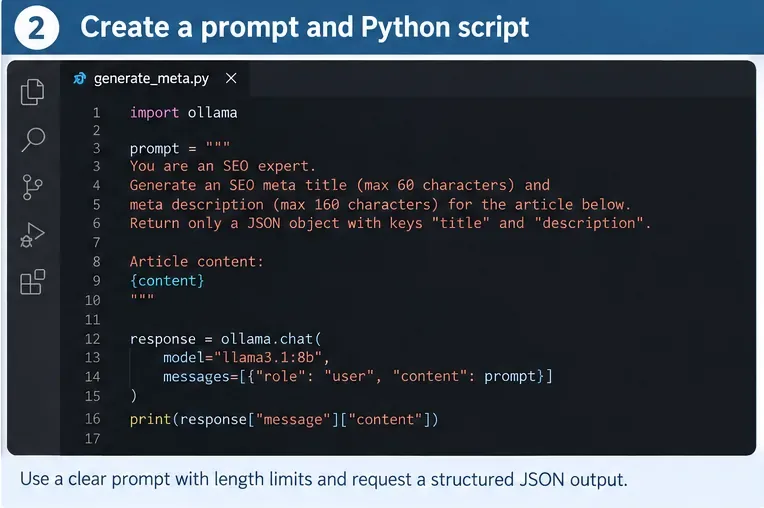
Étape 2 : Forcer la sortie structurée au lieu d’analyser le texte.
Le texte libre est difficile à automatiser. Une réponse comme « Voici trois excellentes options… » oblige votre programme à deviner où commence le titre. La documentation d'Ollama sur les sorties structurées permet de transmettre un schéma JSON dans le formatchamp. Elle recommande également l'utilisation de schémas réutilisables via Pydantic en Python et indique qu'une température basse, par exemple 0 ° 0C, peut améliorer le déterminisme.
Installez les deux packages Python utilisés dans cet exemple :
python -m pip install -U ollama pydantic
Ensuite, créez generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
Le générateur doit clairement indiquer les éléments de preuve de la page, les champs de sortie et les contraintes éditoriales. En production, privilégiez la sortie structurée JSON-schema d'Ollama et la validation côté application plutôt que de vous fier uniquement au libellé des invites.
Pourquoi l'invite inclut-elle le titre actuel et le H1 ?
Google indique que son système de liens et de titres prend en compte le <title>titre principal de la page, les balises de titre (comme « H1 » et « H2 ») <h1>, og:titlele texte principal, le texte d'ancrage et d'autres signaux. Votre générateur local n'a pas besoin de reproduire le système de Google, mais lui fournir le titre source, la balise H1, l'URL et un extrait de texte représentatif permet de garantir que les métadonnées proposées correspondent à la page que les lecteurs verront.
N’utilisez pas de listes de mots clés non pertinentes en demandant au modèle de les « intégrer ». Google recommande explicitement des titres descriptifs et concis et met en garde contre le bourrage de mots clés et les répétitions inutiles. Concernant les descriptions, Google indique que la génération automatique spécifique à chaque page est appropriée pour les sites web volumineux reposant sur une base de données, à condition que les descriptions soient précises, lisibles par un humain et variées.
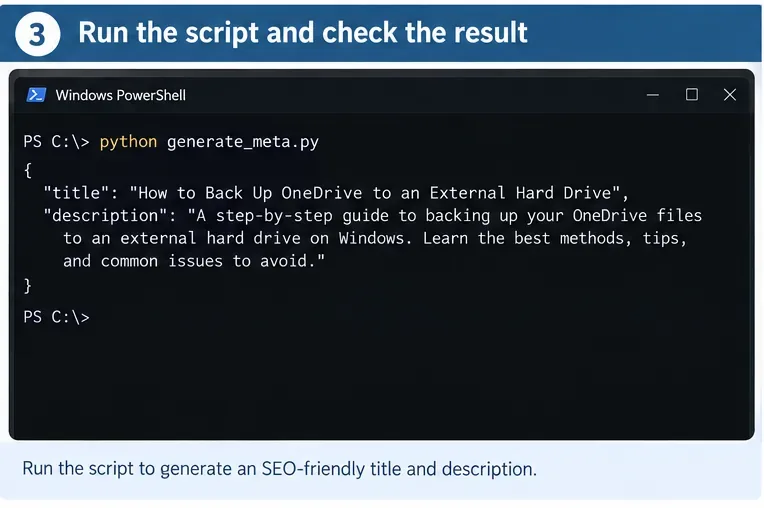
Étape 3 : Exécutez une page, puis validez avant de passer à l’échelle supérieure.
Exécutez le script :
python generate_meta.py
Le résultat attendu est un objet JSON que Pydantic peut valider. Plus important encore, un relecteur humain doit pouvoir le comparer à la page source et répondre rapidement à quatre questions :
Le titre décrit-il précisément cette page plutôt que le site web dans son ensemble ?
La description évite-t-elle les affirmations, dates, prix ou caractéristiques absentes du contenu source ?
Ces métadonnées resteraient-elles compréhensibles si on les lisait sans le corps de la page ?
Est-ce différent des métadonnées déjà utilisées sur les pages voisines ?
Commencez par tester une page représentative et examinez le résultat structuré avant de lancer un traitement par lots. Une réponse JSON analysable est nécessaire, mais l'exactitude des informations et la pertinence au niveau de la page doivent encore être validées.
Ajoutez des tentatives de nouvelle lecture pour les échecs éditoriaux, et pas seulement pour les erreurs d'API.
Un schéma peut restreindre les types et les longueurs de données, mais il ne peut garantir la véracité ni la précision d'une phrase. Concevez la logique de nouvelle tentative en fonction de contrôles mesurables. Par exemple, rejetez un champ vide, un titre dupliqué, du texte standard interdit ou une description reprenant presque mot pour mot le titre. Si la page contient des informations réglementées ou à fort enjeu, exigez une vérification humaine plutôt que de tenter d'automatiser le processus de confiance.
Limitez les invites de nouvelle tentative à des formulations concises. Au lieu de tout régénérer avec l'option « Améliorez-le », indiquez au modèle la cause de l'erreur : « Le titre proposé fait doublon avec une autre page. Réécrivez-le en utilisant le sujet unique du titre H1 tout en veillant à ce que chaque affirmation soit fondée sur le contenu fourni. » Cela facilite l'analyse des erreurs.
Étape 4 : Exporter les pages par lots au format CSV pour relecture et publication
Une fois le test sur une seule page validé, enregistrez vos données dans un fichier CSV avec des colonnes telles que : url, source_title, h1, et content. Le champ « content » doit contenir le texte de la page nettoyé, et non les menus de navigation, les mentions relatives aux cookies ou des milliers de liens de pied de page sans rapport avec le sujet.
Ajoutez cette logique de traitement par lots sous la fonction génératrice ou placez-la dans un script séparé :
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Le fichier CSV généré peut être consulté dans Excel, LibreOffice, un outil d'importation de base de données ou votre système de gestion de contenu. Ne pas écraser automatiquement les métadonnées existantes lors de la première exécution. Conserver le titre et la description d'origine avec la proposition générée afin que les relecteurs puissent les comparer et que la restauration soit simple.
Une file d'attente de révision sous forme de tableur facilite l'audit de la génération en masse : conservez l'identifiant de la page source, le titre généré, la description générée, les longueurs et les indicateurs d'assurance qualité avant de publier les modifications.
Rendre la chaîne de production par lots plus sûre
Vérifier
Que signaler
Pourquoi c'est important
Validation du schéma
Champs manquants ou non valides
Empêche l'entrée de données malformées dans le CMS.
Vérification des titres en double
Même titre normalisé sur deux URL
Permet de distinguer les pages.
Vérification linguistique
Le langage des métadonnées diffère du langage de la page
Google recommande d'utiliser une langue et un système d'écriture correspondant à ceux de la page.
Vérification des preuves
Les chiffres, prix, dates, marques ou garanties sont absents de la source.
Réduit les allégations hallucinatoires.
Vérification standard
Phrases répétées sur l'ensemble du site
Google déconseille l'utilisation répétée de titres standardisés.
Vérification de la longueur éditoriale
En dehors de votre zone de chalandise choisie
Garantit la cohérence du rendu du CMS ; il ne s’agit pas d’une règle de limite de caractères de Google.
Évaluation humaine
Pages stratégiques, sensibles, à fort trafic ou ambiguës
L'automatisation doit faire ressortir les exceptions, et non les masquer.
Problèmes courants, du plus facile au plus difficile
La connexion à l'API a échoué.
Vérifiez d'abord qu'Ollama est en cours d'exécution et http://localhost:11434accessible. La documentation officielle indique que l'authentification n'est pas requise pour l'API locale. Si votre script pointe par erreur vers une autre adresse https://ollama.com/api, il s'agit d'un point de terminaison hébergé différent qui nécessite une authentification.
La réponse contient du texte autour du JSON.
Utilisez le schéma format=SeoMeta.model_json_schema()plutôt que de demander uniquement du JSON en langage naturel. Une sortie structurée constitue la couche de contrôle appropriée pour un pipeline de production.
Tous les titres se ressemblent.
Fournissez un texte H1 spécifique à chaque page et un contenu pertinent, supprimez les éléments de navigation généraux superflus et demandez explicitement une description propre à chaque page. Effectuez ensuite une vérification des doublons et des similarités entre les pages. La répétition est souvent un problème de saisie avant d'être un problème de modélisation.
Le modèle invente des caractéristiques ou des statistiques
Limitez les données d'entrée au texte de la page faisant autorité et renforcez la règle de base : aucune affirmation factuelle allant au-delà du contenu fourni. Pour les pages importantes, comparez les assertions générées aux champs structurés de la source avant validation. Si la source elle-même est ambiguë, soumettez la ligne à une vérification humaine plutôt que de demander systématiquement au modèle de deviner.
Le modèle est trop lent pour des milliers de pages
Mesurez les performances avant de modifier l'architecture. Enregistrez le temps de génération par page, la taille des données d'entrée, le nom du modèle et le taux d'échec. Supprimez le texte non pertinent, traitez les sections stables de la page et testez un modèle local plus léger si la qualité reste acceptable. Le modèle le plus rapide est inutile si ses métadonnées engendrent plus de travail de vérification qu'elles n'en simplifient.
Facultatif : utiliser une intégration de type OpenAI existante
Si vous avez déjà du code écrit pour un client compatible avec OpenAI, Ollama documente la compatibilité partielle avec l'API OpenAI ici http://localhost:11434/v1/. Cela peut réduire le travail de migration. Pour un nouvel outil de métadonnées local, le client Python natif d'Ollama est plus simple et propose des exemples de sortie structurée directement dans la documentation d'Ollama.
Comment auto-vérifier le système final
Avant de considérer l'automatisation comme terminée, créez un ensemble de révision contenant différents types de contenu : un article court, un guide long, une page produit, une page catégorie, une page avec des numéros et une page dans chaque langue prise en charge. Exécutez le même modèle et la même invite sur l'ensemble de ces éléments, puis vérifiez la liste de contrôle suivante.
Le point de terminaison local est localhostet le modèle sélectionné est un modèle local, et non un modèle étiqueté dans le cloud.
Chaque réponse est validée par rapport au schéma sans nettoyage manuel du JSON.
Aucun titre généré n'est dupliqué dans l'ensemble des avis.
Chaque affirmation factuelle figure dans le contenu de la page fournie.
Les métadonnées utilisent la même langue principale et le même système d'écriture que la page.
Le titre est descriptif et concis, sans répétition de mots-clés.
La description résume la page en question plutôt que le site dans son ensemble.
Vos limites de longueur internes sont considérées comme des règles éditoriales, et non comme des exigences de Google.
Les anciennes métadonnées, la proposition générée, les indicateurs d'assurance qualité, le nom du modèle et la version de l'invite sont enregistrés à des fins d'audit et de restauration.
Un relecteur sait quels indicateurs nécessitent une approbation manuelle avant publication.
Enfin, n'oubliez pas les limites de l'automatisation. Une bonne <title>description et une méta-description fournissent aux moteurs de recherche des informations utiles au niveau de la page, mais Google peut générer des liens et des extraits à partir d'autres contenus. L'objectif n'est donc pas d'imposer un affichage particulier des résultats de recherche, mais de produire des métadonnées précises, distinctes et utiles à grande échelle, tout en conservant un processus de validation et de vérification suffisant pour corriger les erreurs avant leur mise en production.