Accueil
» Domaines
»
Comment réduire le temps de rendu dans ComfyUI pour un flux de travail SDXL
Comment réduire le temps de rendu dans ComfyUI pour un flux de travail SDXL
Dans un workflow ComfyUI SDXL, la méthode la plus rapide pour réduire le temps de rendu consiste généralement à diminuer le travail de diffusion avant de modifier les options de lancement de bas niveau : effectuez des tests à une résolution SDXL appropriée, conservez une taille de lot de 1 pendant les réglages, réduisez le nombre d’étapes d’échantillonnage tant que la qualité est maintenue et désactivez temporairement les opérations coûteuses telles que les affineurs, les branches ControlNet, les passes de mise à l’échelle ou les préprocesseurs. Ce n’est qu’ensuite que vous pourrez optimiser la VRAM, l’attention, la prévisualisation et le comportement du cache.
Cet ordre est important car les options de démarrage ne peuvent pas compenser un flux de travail qui sollicite le GPU deux ou trois fois plus que nécessaire. La documentation ComfyUI actuelle recommande également de réduire d'abord la résolution ou la taille des lots lorsque la génération est lente, puis d'utiliser les optimisations de mémoire et d'attention selon les besoins. Les recommandations ci-dessous ont été vérifiées par rapport à la documentation ComfyUI et PyTorch en vigueur le 13 septembre 2026.
Pourquoi les flux de travail SDXL ralentissent-ils dans ComfyUI ?
Le rendu SDXL peut passer du temps à différentes étapes : chargement ou déplacement des poids du modèle, encodage du texte CLIP, débruitage répété au sein de KSampler, ControlNet ou autres traitements, décodage VAE, mise à l’échelle et toute étape de second passage ou d’affinage. Si la VRAM est limitée, les transferts CPU-GPU supplémentaires peuvent engendrer une latence encore plus importante.
Cela signifie que deux utilisateurs disposant du même GPU peuvent observer des temps de rendu très différents. Un graphe de base de conversion texte-image à 1024 classes n'est pas comparable à un flux de travail intégrant un affineur, deux ControlNets, une seconde passe haute résolution et un traitement par lots important. L'objectif est d'identifier la partie du graphe qui est gourmande en ressources, puis de la supprimer ou de l'optimiser sans compromettre la qualité de rendu qui vous importe réellement.
1. Mesurez une valeur de référence stable avant de modifier quoi que ce soit.
Utilisez une invite fixe, une graine fixe, une taille de lot de 1 et la même résolution de sortie. Exécutez le flux de travail au moins deux fois. La première exécution peut inclure le chargement de points de contrôle, la compilation, les E/S disque ou les transferts de modèles ; une exécution ultérieure permet de mieux évaluer la vitesse de génération en régime permanent.
Vérifiez également si le GPU est bien sollicité. Sur les systèmes NVIDIA, nvidia-smivous pouvez afficher l'utilisation de la VRAM et du GPU. Si l'utilisation du GPU reste faible alors que le système transfère constamment des données ou charge des modèles, le goulot d'étranglement peut provenir d'une saturation de la mémoire ou des E/S plutôt que de l'échantillonneur lui-même.
Vérifiez le comportement du GPU et de la VRAM avant de régler ComfyUI. Les valeurs affichées ici servent d'exemple et ne constituent pas une cible de référence.
2. Commencez par le plus petit graphique SDXL qui produit le résultat souhaité.
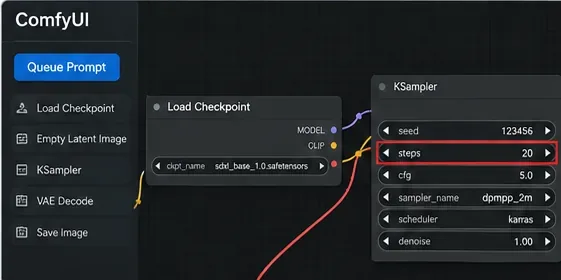
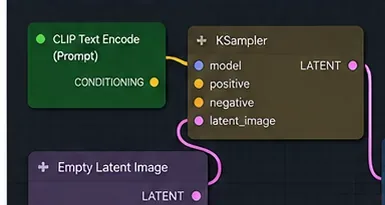
Avant d'optimiser un flux de travail complexe, comparez-le à un chemin minimal : chargement du point de contrôle, conditionnement des invites, image latente vide, KSampler, décodage VAE et enregistrement de l'image. Les exemples officiels de ComfyUI montrent que le point de contrôle de base SDXL peut être utilisé comme un point de contrôle classique. Si ce graphe de base est rapide mais que votre graphe de production est lent, les branches supplémentaires sont la cause du problème.
Pour la phase de conception, désactivez temporairement les composants non essentiels à la décision en cours. Il peut s'agir, par exemple, d'un module d'affinage, d'une seconde passe de suréchantillonnage, de préprocesseurs d'image, de plusieurs ControlNets ou de branches de style optionnelles. Réactivez-les un par un une fois l'image de base validée.
Un petit graphique SDXL constitue la meilleure base de référence. N'ajoutez les branches coûteuses qu'après avoir déterminé le temps de calcul de chacune.
3. Réduisez le nombre d'étapes du KSampler avant de rechercher des paramètres de vitesse exotiques.
Le nombre d'étapes d'échantillonnage est un levier essentiel, car chaque étape de débruitage supplémentaire engendre une charge de travail supplémentaire. En réduisant ce nombre, la phase d'échantillonnage du rendu devrait se raccourcir, même si le temps de rendu total ne diminuera pas exactement dans les mêmes proportions, car le chargement du modèle, l'encodage des invites, le décodage VAE et les autres étapes du processus prennent toujours du temps.
Ne copiez pas un nombre d'étapes « optimal » universel. Le nombre approprié dépend du point de contrôle, de l'échantillonneur, du planificateur, de l'invite, du CFG et de l'objectif de qualité. Une méthode pratique consiste à conserver la valeur initiale et à tester une petite échelle : par exemple, votre configuration actuelle, puis une légère réduction, puis une autre. Arrêtez-vous lorsque la qualité des textures, de l'anatomie, de la typographie ou des invites se dégrade plus que vous ne le souhaitez.
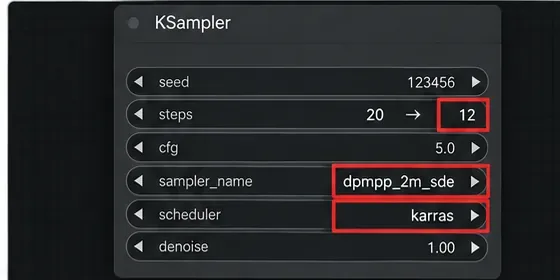
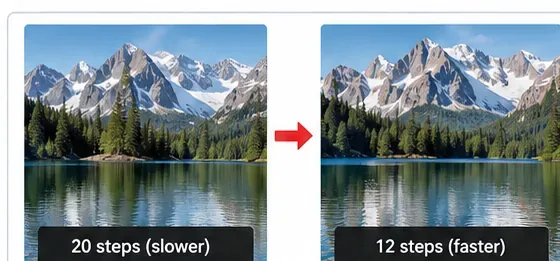
Diminuer le nombre d'étapes de KSampler permet de réduire le temps de débruitage. Les valeurs affichées sont données à titre indicatif ; vérifiez la qualité avec votre propre point de contrôle et une valeur initiale fixe.
4. Maîtrisez la résolution des tests et la taille des lots.
Pour SDXL, les exemples officiels de ComfyUI recommandent une résolution de 1024×1024 ou d'autres formats d'image avec un nombre de pixels similaire, comme 896×1152 ou 1536×640, pour un comportement optimal du modèle de base. Un nombre de pixels nettement supérieur augmente la taille latente et, par conséquent, la consommation de ressources de calcul et de mémoire.
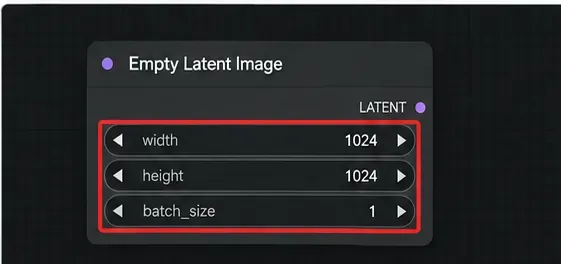
Lors du réglage des invites et des flux de travail, conservez batch_sizela valeur 1, sauf si vous devez spécifiquement effectuer des tests de débit. Un lot de quatre images demande au pipeline de produire quatre images en une seule exécution ; cela peut améliorer le débit dans certaines configurations, mais ce n’est pas la méthode la plus efficace pour minimiser le délai d’obtention de la première image et cela augmente les besoins en mémoire.
Si votre fichier final doit dépasser la résolution de base standard de SDXL, envisagez de dissocier les tests de composition de la passe finale haute résolution. Optimisez d'abord l'image d'amorce, l'image de départ, le conditionnement et la composition, puis investissez dans une mise à l'échelle plus poussée ou une seconde passe uniquement pour les éléments sélectionnés.
Un latent de classe 1024 avec une taille de lot de 1 constitue une base de réglage SDXL judicieuse avant des exécutions à plus haute résolution ou multi-images.
5. Évaluer les performances des échantillonneurs et des planificateurs au lieu de supposer que l'un est toujours le plus rapide.
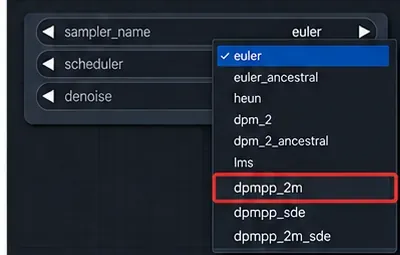
ComfyUI propose plusieurs options d'échantillonneur et de planificateur dans KSampler. Différentes combinaisons permettent d'atteindre une qualité acceptable en un nombre d'étapes variable ; ainsi, « le plus rapide » doit signifier le plus rapide avec la qualité requise , et non pas simplement l'exécution la plus courte.
Utilisez le même point de contrôle, la même invite, la même graine, la même résolution et le même fichier de configuration (CFG) pour la comparaison. Modifiez uniquement l'échantillonneur ou le planificateur, puis comparez le temps de rendu et la qualité visuelle. Si une combinaison nécessite nettement moins d'étapes pour votre point de contrôle tout en préservant le résultat souhaité, c'est un gain de vitesse réel. Si elle requiert des étapes supplémentaires pour récupérer les détails, l'avantage apparent peut disparaître.
Modifiez une variable d'échantillonnage à la fois et comparez les résultats avec une valeur initiale fixe. Ne présumez pas qu'un échantillonneur est plus rapide pour chaque point de contrôle SDXL ou cible de qualité.
6. Supprimez les tâches graphiques redondantes et tirez parti du modèle d'exécution de ComfyUI.
ComfyUI est conçu pour n'exécuter que les parties du graphe nécessaires. Sa documentation indique que les portions inchangées peuvent être réutilisées d'une exécution à l'autre, et le système actuel inclut une mise en cache configurable des résultats des nœuds. Ceci est utile lorsque vous modifiez uniquement une valeur en aval au lieu de reconstruire l'intégralité du flux de travail.
Maintenez la stabilité des nœuds de chargement et des processus en amont les plus gourmands en ressources. Si vous changez constamment de point de contrôle, redimensionnez fréquemment des images volumineuses ou invalidez des nœuds en amont, vous perdez les avantages du travail mis en cache.
ComfyUI propose également une fonctionnalité d'exécution partielle documentée , permettant d'exécuter uniquement la partie d'un workflow nécessaire à un nœud de sortie sélectionné. Utilisez-la lors du test d'une branche en aval, lorsque la régénération de toutes les sorties d'un graphe volumineux n'est pas requise.
Un graphique allégé permet de repérer plus facilement les goulots d'étranglement. Utilisez la mise en cache et l'exécution partielle pour éviter de répéter inutilement le travail en amont qui n'a pas changé.
7. Ajustez les aperçus, la mise en cache, le mode VRAM et l'attention uniquement une fois le graphe optimisé.
Les options de ligne de commande actuelles de ComfyUI proposent plusieurs contrôles de performance. Leurs effets dépendent du matériel et de la mémoire disponible ; il convient donc de les considérer comme des pistes d’amélioration plutôt que comme des options obligatoires.
Paramètre
Quand cela peut aider
Compromis principal
--preview-method none
Si les aperçus de l'échantillonneur étaient activés et que seul le résultat final vous intéresse
Vous perdez les aperçus latents en direct. L'interface de ligne de commande actuelle n'utilise déjà aucun aperçu par défaut.
--highvram
Si vous disposez de suffisamment de VRAM et que le déchargement/rechargement répété du modèle prend du temps
Conserve les modèles dans la mémoire du GPU et peut provoquer des erreurs de mémoire insuffisante sur les cartes graphiques moins performantes.
--lowvram
Si le flux de travail ne tient pas dans la VRAM
Il s'agit principalement d'un mode d'économie de mémoire, et non d'un mode de vitesse ; l'utilisation du processeur ou les transferts peuvent augmenter la latence.
--use-pytorch-cross-attention
Il serait intéressant de réaliser des tests comparatifs sur les combinaisons modernes PyTorch/GPU.
Ne combinez pas aveuglément des indicateurs de mode d'attention mutuellement exclusifs.
--use-flash-attention
Il est intéressant de tester ce chemin optimisé lorsque votre configuration matérielle et logicielle le prend en charge.
La disponibilité et les avantages dépendent des entrées et des noyaux pris en charge.
--cache-classicou--cache-lru N
Flux de travail répétitifs pour lesquels une mémoire cache supplémentaire est acceptable
Peut utiliser plus de RAM/VRAM.
--cache-none
Uniquement lorsque la réduction de la mémoire cache est plus importante que la vitesse
L'interface de ligne de commande de ComfyUI indique que chaque nœud sera exécuté à chaque exécution, ce qui a généralement pour conséquence une dégradation du temps de rendu.
L'interface de ligne de commande actuelle propose également le déchargement asynchrone des poids, et son aide indique qu'il est activé par défaut sur les cartes NVIDIA. Par conséquent, l'ajout de paramètres supplémentaires n'entraîne pas automatiquement une optimisation ; il est donc conseillé de vérifier au préalable votre commande de lancement et les journaux.
L'attention à produit scalaire modulée de PyTorch peut sélectionner automatiquement des implémentations CUDA optimisées, telles que FlashAttention, ou une attention économe en mémoire, lorsque les entrées et le matériel le permettent. C'est pourquoi les chemins d'attention modernes peuvent avoir un impact, mais le gain exact dépend du matériel. Évitez de citer un pourcentage générique comme s'il s'appliquait à votre flux de travail SDXL.
8. Veillez à ce que le comportement des files d'attente et des lots soit conforme à votre objectif.
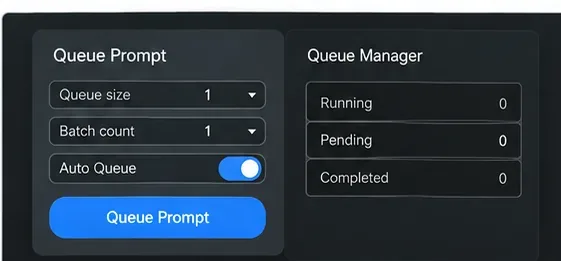
Si votre priorité est d'obtenir un retour d'information rapide, mettez en file d'attente une image à la fois pendant le réglage. Les files d'attente et les lots importants sont utiles lorsque vous connaissez déjà les paramètres et que vous recherchez un débit élevé, mais ils n'accélèrent pas l'arrivée de la première image.
Une fois le flux de travail finalisé, vous pouvez évaluer le débit séparément. À ce stade, un traitement par lots plus important peut s'avérer pertinent si la mémoire VRAM le permet et si le nombre total d'images par minute est plus important que la latence par image.
Utilisez une image en file d'attente et une taille de lot de 1 pour le réglage interactif ; testez des lots plus importants ultérieurement lorsque le débit est l'objectif.
Comment savoir si l'optimisation a réellement fonctionné ?
Un traitement plus rapide n'est utile que si l'image reste conforme à vos attentes. Comparez le résultat avant et après traitement avec les mêmes paramètres d'amorçage et de consigne. Vérifiez les zones qui posent problème en premier lorsque les paramètres sont trop restrictifs : petits textes, mains et visages, motifs répétitifs, matériaux fins, détails des contours et respect des attributs spécifiques à la consigne.
Pour chaque test, veuillez consigner au moins ces quatre éléments : durée totale d’exécution, nombre d’étapes d’échantillonnage, résolution et indication du chargement du modèle. Si la première exécution dure 30 secondes et la seconde 12 secondes, ne considérez pas automatiquement un changement d’échantillonneur comme significatif ; la première exécution a peut-être simplement couvert le coût du chargement du point de contrôle.
Utilisez des comparaisons côte à côte avec une valeur initiale fixe pour déterminer si un nombre d'étapes inférieur est acceptable. Les étiquettes illustrées présentent la méthode et ne constituent pas des résultats de référence.
Un ordre d'optimisation pratique
Effectuez un test de performance après avoir préchauffé le système. Conservez les paramètres de graine, d'invite, de résolution et de lot constants.
Supprimez les branches inutiles. Testez le chemin SDXL de base sans raffineur, ControlNet, mise à l'échelle ni préprocesseurs optionnels.
Réduisez le nombre d'étapes. Trouvez le nombre minimal d'étapes qui correspond à vos exigences de qualité.
Veillez à conserver une résolution raisonnable. Ajustez-la aux limites de 1024 pixels de la classe SDXL avant la finition haute résolution.
Conservez la taille du lot à 1 pendant l'itération. Optimisez le débit uniquement une fois le flux de travail stabilisé.
Comparez les options d'échantillonneur/planificateur. Évaluez la vitesse à qualité acceptable équivalente.
Utilisez la mise en cache et l'exécution partielle. Évitez de réexécuter des tâches en amont inchangées.
Ensuite, testez les indicateurs de lancement. Testez l'aperçu, la VRAM, le cache et les modifications d'attention un par un.
Quand vaut-il mieux changer de stratégie plutôt que d'optimiser davantage ?
Si un flux de travail SDXL reste trop long après ces modifications, examinez son fonctionnement. Un graphe de production multi-ControlNet, avec affinage et mise à l'échelle, peut être volontairement gourmand en ressources de calcul. Dans ce cas, trois options s'offrent à vous : accepter un rendu plus long pour les images finales, utiliser un flux de travail de brouillon simplifié pour l'itération, ou transférer la charge de travail vers un matériel plus performant.
De même, si vous manquez constamment de VRAM, forcer un mode résident GPU « plus rapide » n'est pas la solution. Une exécution stable avec la gestion dynamique de la mémoire par défaut ou une configuration avec moins de VRAM est préférable à des plantages répétés dus à une insuffisance de mémoire. Les paramètres d'économie de mémoire peuvent augmenter le temps de rendu, mais un rendu réussi, même plus lent, reste plus utile qu'un plantage rapide.