Accueil
» Domaines
»
Comment résoudre l'erreur « Dépassement de la fenêtre de contexte » lors de l'analyse de documents longs sans perdre d'informations clés ?
Comment résoudre l'erreur « Dépassement de la fenêtre de contexte » lors de l'analyse de documents longs sans perdre d'informations clés ?
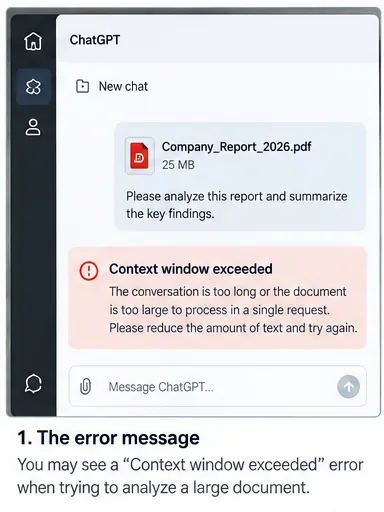
Vous téléchargez un long rapport, demandez une analyse approfondie, et au lieu d'une réponse, vous recevez un message d'erreur tel que « Fenêtre de contexte dépassée », « Longueur de contexte maximale dépassée » ou un autre avertissement indiquant que la requête est trop volumineuse. Le plus frustrant, c'est que le fichier a peut-être été téléchargé avec succès, et que ce même document aurait même pu convenir pour une question plus précise.
La raison est simple, mais facile à oublier : la limite de chargement et la fenêtre de contexte d'un modèle sont deux choses différentes. Un modèle doit intégrer les données qu'il traite dans un budget de jetons limité. Ce budget peut inclure vos instructions, l'historique des conversations, le texte extrait des fichiers, les définitions d'outils, les passages récupérés, les jetons de raisonnement et l'espace réservé à la réponse. Un document peut donc être autorisé à être chargé tout en étant trop volumineux pour être analysé en une seule passe.
La meilleure solution consiste généralement à éviter de répéter sans cesse la même requête complexe. Commencez par des modifications minimales, puis passez au découpage, à la récupération ou à un flux de travail plus contextuel uniquement si l'approche la plus simple échoue.
Vérifiez d'abord qu'il s'agit bien d'un problème de fenêtre contextuelle.
Avant de modifier le document, il est important de distinguer une erreur de contexte d'une limite de chargement ou de stockage. Les recommandations actuelles d'OpenAI concernant le chargement de fichiers indiquent que les fichiers chargés sur ChatGPT ou une table de hachage GPT sont limités à 512 Mo par fichier, tandis que les fichiers texte et les documents sont limités à 2 millions de jetons par fichier. Il s'agit de limites de chargement, et non d'une garantie que l'intégralité du texte sera placée simultanément dans le contexte actif d'un modèle.
La FAQ d'OpenAI sur le chargement de fichiers est la source de référence pour connaître les limites de chargement actuelles. Ces limites varient selon le produit, l'abonnement, le modèle et le fournisseur ; par conséquent, ne considérez pas qu'une valeur copiée d'un ancien article soit toujours valable.
Ce que vous voyez
Goulot d'étranglement probable
Meilleur premier pas
Le fichier est rejeté avant même le début de l'analyse.
Taille du fichier, type de fichier, espace de stockage ou quota de téléchargement
Veuillez consulter les règles de téléchargement en vigueur.
Le fichier se télécharge, mais une longue invite de commande échoue avec une erreur de contexte.
La requête active dépasse le budget de contexte du modèle
Raccourcissez la requête et réduisez le contexte actif
La réponse couvre les premières pages mais omet les sections suivantes.
Tous les éléments n'ont pas été placés directement dans leur contexte, ou la recherche a omis des passages pertinents.
Posez des questions plus précises ou divisez par section
Une conversation avait fonctionné au début, mais elle échoue après de nombreux rebondissements.
L'historique des conversations accumulé consomme le contexte
Ouvrez une nouvelle discussion d'analyse avec un résumé concis du transfert.
Une erreur de fenêtre de contexte peut apparaître après le téléchargement réussi d'un document, car la requête active doit encore respecter le budget de jetons du modèle.
Étape 1 : Mesurez le document avant de le modifier.
Le nombre de pages et la taille du fichier (en mégaoctets) sont des indications utiles, mais c'est le nombre de tokens qui est déterminant pour le contexte du texte. La tokenisation dépend de la langue, de la mise en forme, de la ponctuation et de l'encodage du modèle ; ainsi, un manuel technique de 100 pages peut utiliser un nombre de tokens très différent de celui d'une présentation PowerPoint de 100 pages.
Les recommandations d'OpenAI concernant le comptage des jetons préconisent de vérifier la fenêtre de contexte du modèle cible et de prévoir de l'espace pour la sortie et, pour les modèles de raisonnement, pour les jetons de raisonnement. Elles précisent également que la structure des messages, les outils, les fichiers, les images et les schémas peuvent ajouter des jetons au-delà du texte brut comptabilisé.
Pour un tri rapide, notez le nombre de pages du fichier, le nombre approximatif de mots, le nombre de sections principales et s'il contient des annexes, un langage juridique répétitif, des journaux bruts, des transcriptions, des tableaux ou des références dont vous n'avez pas réellement besoin pour la tâche.
Vérifiez la taille du document avant de procéder au dépannage. La taille du fichier et le nombre de pages ne sont que des indicateurs ; le nombre de caractères utilisés est la limite la plus pertinente pour l’analyse de texte.
Étape 2 : Réduisez la conversation en cours avant de modifier le fichier.
Si le document n'est pas excessivement volumineux, la solution la plus économique consiste peut-être à supprimer le contexte superflu plutôt qu'à scinder le fichier. Créez une nouvelle conversation ou une nouvelle demande et ne transmettez que les instructions essentielles. Remplacez un long échange par une brève transmission d'informations, par exemple : « Analysez le rapport ci-joint afin d'identifier les facteurs de revenus, les risques importants et les recommandations de la direction. Veuillez me communiquer cinq points clés en indiquant les pages ou sections correspondantes. »
Supprimez également les éléments de contexte redondants, les exemples devenus inutiles, les textes collés en double et les versions préliminaires. Si vous utilisez un flux de travail API, tenez compte de la requête complète et non du seul document. Une requête trop courte laisse peu de place pour la réponse et risque d'échouer de manière imprévisible à mesure que les instructions ou les schémas d'outils s'étoffent.
Signe de réussite : le même fichier fonctionne dans un nouveau thread avec une invite de commande ciblée. Si c’est le cas, le problème provenait au moins en partie du contexte accumulé, et non du document lui-même.
Étape 3 : Préciser la question et le résultat attendu
L'instruction « Analysez l'intégralité de ce document de 400 pages et rédigez un rapport complet » oblige le système à traiter de nombreux sujets simultanément. Il est préférable de poser une question à la fois. Par exemple, commencez par demander quels sont les principaux risques mentionnés dans le document, puis ses hypothèses financières, et enfin les contradictions entre les affirmations de la direction et les données justificatives.
Limitez la taille de votre réponse. Une demande de document de 20 pages consomme beaucoup plus de ressources qu'une demande de tableau de preuves de 10 lignes. Vous pourrez toujours étoffer la réponse finale une fois les preuves collectées.
Une consigne ciblée et utile est la suivante : « À partir de ce seul document, identifiez jusqu’à huit affirmations relatives au taux de désabonnement des clients. Pour chaque affirmation, indiquez la référence de la section ou de la page, une brève explication et toute limitation mentionnée. Si le document ne contient pas suffisamment d’éléments de preuve, veuillez le préciser. »
Quand passer à autre chose : si une question ciblée produit toujours la même erreur, ou si vous avez besoin d’une couverture fiable de l’ensemble du document plutôt que d’un seul sujet, divisez la source.
Étape 4 : Divisez le document en fonction du sens, et non pas seulement en fonction du nombre de pages.
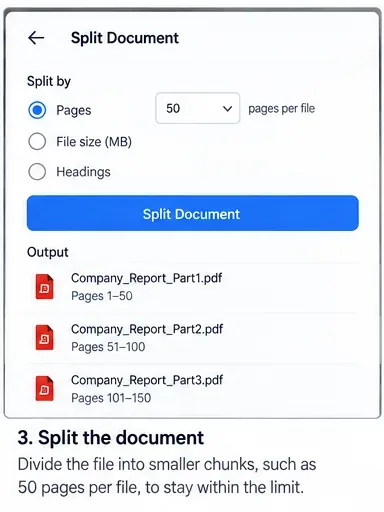
Le découpage en segments est la solution la plus fiable et polyvalente pour les documents très longs. Divisez le fichier selon des limites naturelles telles que les chapitres, les sections de rapport, les contrats, les annexes, les plages de dates ou les interventions des intervenants. Des segments logiques préservent mieux le contexte que des coupes arbitraires toutes les 50 pages.
Si une section dépend fortement de la précédente, prévoyez un léger chevauchement ou une courte note de transition décrivant la section précédente. Nommez clairement les différentes parties, par exemple : « 1 », « 2 » 01_Executive_Summary.pdfet 02_Financial_Results.pdf« 303_Risk_Factors.pdf ». Conservez les numéros de page originaux autant que possible afin de permettre la vérification de la synthèse finale.
Divisez un texte très long en sections logiques et clairement identifiées. Conservez les références aux pages ou sections originales afin de pouvoir vérifier ultérieurement la synthèse par rapport au texte source.
Étape 5 : Analyser chaque segment avec le même schéma de preuves
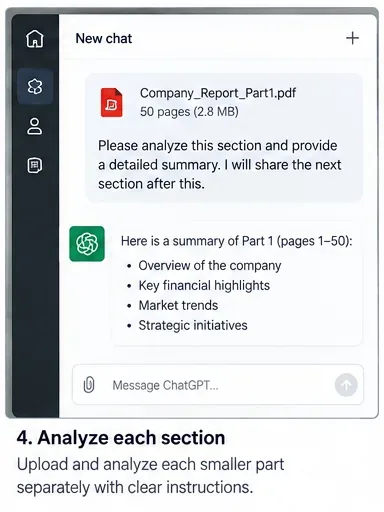
Ne vous contentez pas de demander un résumé libre de chaque partie. Utilisez la même structure pour chaque section afin que les résultats puissent être fusionnés sans perte de détails importants. Un schéma pratique pourrait inclure le nom de la section, les principaux résultats, les preuves à l'appui, la référence de page ou de titre, les incertitudes et les questions ouvertes.
Par exemple : « Analysez uniquement la partie 3. Retournez : (1) cinq conclusions importantes au maximum, (2) les preuves pour chaque conclusion, (3) la référence de la page ou de la section d’origine, (4) toute mise en garde formulée par l’auteur et (5) les questions qui doivent être vérifiées dans une autre section. Ne tirez pas de conclusions qui ne figurent pas dans cette partie. »
Cette approche facilite également l'évaluation de la qualité. Si un résumé de segment contient des affirmations sans indication de source, corrigez ce segment avant de poursuivre plutôt que d'espérer que la synthèse finale le résolve.
Analysez une section à la fois avec un format de sortie fixe afin que chaque résultat partiel puisse être combiné ultérieurement et retracé jusqu'à la source.
Étape 6 : Créer un résumé des résumés au lieu de recharger chaque bloc complet
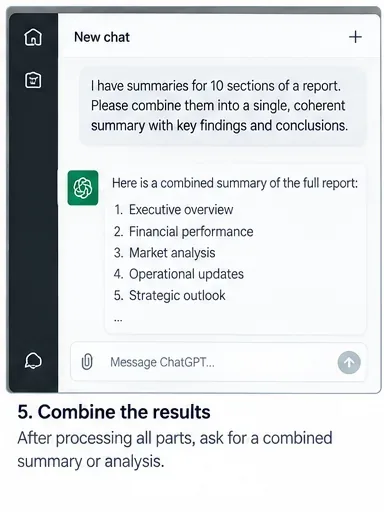
Une fois les éléments analysés, créez un ensemble de preuves compact à partir des résultats des segments et synthétisez-le. N'envoyez pas automatiquement chaque segment original et chaque résumé dans une seule requête finale ; cela risque de reproduire le même problème de contexte.
L'instruction de synthèse doit indiquer au modèle de préserver les divergences et les lacunes. Par exemple : « Combinez ces analyses de section en un seul rapport. Fusionnez les résultats redondants, conservez les éléments contradictoires comme points distincts, préservez toutes les références des sources et signalez toute question qui ne peut être résolue à partir des résumés. »
Cette méthode hiérarchique est particulièrement utile pour les livres, les documents réglementaires, les ensembles de preuves, les longs recueils d'entretiens et la recherche multidocumentaire. Sa principale limite réside dans la compression de l'information : les détails omis lors d'un résumé ne peuvent réapparaître comme par magie par la suite. C'est pourquoi le schéma de preuves et les références des sources sont essentiels.
Privilégiez les analyses de sections concises plutôt que de réintégrer l'intégralité du texte source. Conservez les citations, les divergences et les questions en suspens lors de la synthèse.
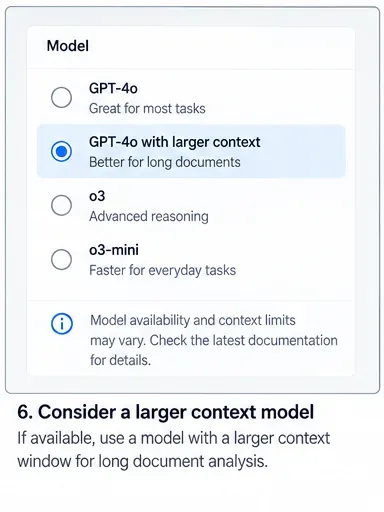
Étape 7 : Envisagez un modèle à contexte plus large, mais ne le considérez pas comme une solution complète.
Un modèle doté d'une fenêtre de contexte plus large peut réduire la fréquence de segmentation nécessaire. La documentation actuelle des modèles OpenAI indique les limites de la fenêtre de contexte et du nombre maximal de sorties pour les modèles API ; ces valeurs peuvent évoluer lors des mises à jour.
Cependant, la taille du contexte principal d'un modèle ne correspond pas nécessairement à la quantité d'un fichier téléchargé directement insérée dans l'invite. Les recommandations d'OpenAI pour les solutions d'entreprise décrivent actuellement un processus distinct de « remplissage de contexte » pour les documents texte téléchargés : jusqu'à 110 000 éléments issus de ces documents peuvent être insérés directement dans le contexte, et des éléments supplémentaires sont disponibles via un index de recherche privé. OpenAI précise que ce comportement est en cours de développement et susceptible d'évoluer. Voir Optimisation des téléchargements de fichiers dans ChatGPT Enterprise .
En pratique, il est conseillé d'opter pour un modèle à contexte élargi lorsqu'il simplifie sensiblement le flux de travail, tout en vérifiant que les sections pertinentes sont bien prises en compte. Un contexte élargi ne dispense pas d'une définition précise du périmètre, de références bibliographiques ni de vérifications.
Un modèle plus général peut être utile, mais vérifiez les limites pour le modèle et la surface de produit exacts que vous utilisez plutôt que de vous fier à un nombre générique.
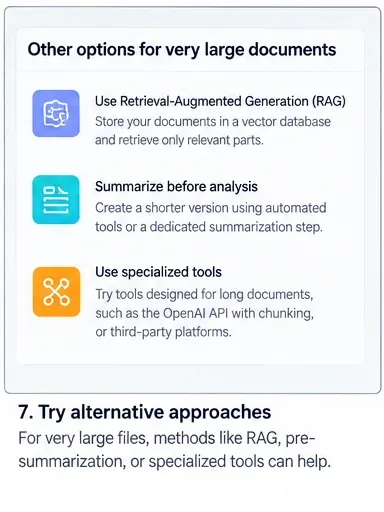
Étape 8 : Pour les très grands corpus, passez de « tout inclure » à la récupération.
Si la tâche implique des centaines ou des milliers de pages, la recherche documentaire est généralement une architecture plus efficace que de tenter de faire correspondre l'intégralité du corpus à une seule requête. Les systèmes de recherche documentaire indexent la source, recherchent les passages pertinents pour la question posée et les intègrent uniquement dans leur contexte.
La documentation d'OpenAI sur la recherche de fichiers décrit un outil hébergé permettant de rechercher des fichiers téléchargés dans des bases de données vectorielles. La recherche est particulièrement efficace pour des questions ciblées telles que : « Quelles sections définissent la notion de résiliation par commodité ? » ou « Où le rapport aborde-t-il la concentration de la chaîne d'approvisionnement ? »
La recherche est moins fiable lorsque la tâche exige une connaissance simultanée de chaque passage, par exemple pour prouver qu'un sujet n'apparaît jamais, comparer chaque cellule d'un tableau dans une vaste collection ou effectuer une transformation exhaustive ligne par ligne. Dans ces cas, il est conseillé d'utiliser un traitement par lots systématique ou un prétraitement basé sur le code en complément de la recherche.
Pour les corpus qui restent trop volumineux après le découpage en segments, la recherche ne peut ramener que les passages les plus pertinents dans le contexte actif de chaque question.
Correctif avancé de l'API : troncature délibérée des contrôles
Les développeurs utilisant l'API Responses d'OpenAI disposent d'une option supplémentaire. La documentation de l'API décrit un truncationparamètre : avec disabled`true`, la valeur par défaut documentée, une requête dépassant la fenêtre de contexte du modèle échoue ; avec auto`false`, les éléments de conversation précédents peuvent être supprimés pour que la requête tienne dans cette fenêtre. Consultez la documentation de l'API Responses .
La troncature automatique peut éviter une erreur irrémédiable, mais elle modifie les informations disponibles pour le modèle. Pour l'analyse de documents, la suppression silencieuse du contexte initial peut être pire qu'une erreur. N'utilisez cette fonction que si votre application est conçue de sorte que les éléments de conversation plus anciens soient superflus ou déjà résumés ailleurs.
Comment vérifier que la correction a bien fonctionné
Une requête acceptée ne suffit pas. L'objectif est une analyse rigoureuse qui couvre les éléments pertinents sans négliger les preuves. Testez le résultat avant de considérer le problème comme résolu.
Vérification de la couverture : confirmer que chaque chapitre, plage de dates ou fichier source requis figure dans le plan d’analyse ou le tableau final des preuves.
Contrôle de traçabilité : examiner des exemples d’affirmations importantes et vérifier leurs références de page, de section ou de fichier par rapport à la source originale.
Vérification des limites : inspectez les résultats à proximité des limites des blocs pour vous assurer qu’un concept n’a pas été divisé ou contredit entre les parties.
Contrôle négatif : poser une question dont on sait que la réponse est absente. Une bonne méthodologie consiste à constater l’absence de preuves plutôt que de les inventer.
Vérification de la reproductibilité : relancez quelques questions représentatives. Des variations importantes dans les preuves citées peuvent indiquer une faible capacité de récupération ou une question trop générale.
Vérification budgétaire : si vous utilisez une API, examinez l’utilisation réelle des jetons d’entrée et de sortie au lieu de vous fier uniquement à des estimations approximatives du nombre de mots.
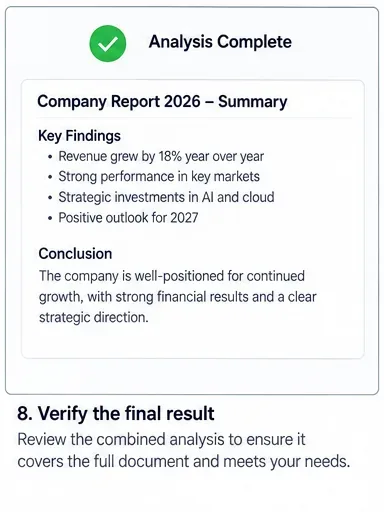
La dernière étape est la vérification : contrôler la couverture, les références des sources, les limites des blocs et les affirmations non étayées avant de faire confiance à l’analyse combinée.
Ce qu'il ne faut pas faire
Ne soumettez pas systématiquement la même requête surdimensionnée en espérant une limite de jetons différente. Ne supprimez pas les références sources lors du découpage en segments. Ne présumez pas que l'acceptation d'un fichier signifie que chaque page est active dans son contexte. Enfin, ne corrigez pas l'erreur en raccourcissant la réponse de manière excessive, au risque de rendre l'analyse impossible.
Évitez également de considérer la troncature automatique comme une magie invisible. Si le système supprime les éléments les plus anciens, la requête peut aboutir, mais entraîner la perte d'instructions ou de preuves importantes. Pour les analyses critiques, le découpage et la récupération explicites des données sont généralement plus faciles à auditer.
Une règle de décision pratique
Si une nouvelle discussion et une question plus précise suffisent, privilégiez un flux de travail simple. Si la tâche nécessite une analyse approfondie d'un document long, divisez-le en sections logiques et synthétisez des analyses de blocs structurés. Si vous interrogez régulièrement une très grande collection de documents, utilisez la récupération. Si vous contrôlez l'API et que vous approchez malgré tout de la limite, mesurez le nombre de jetons, prévoyez de l'espace de sortie, sélectionnez un modèle approprié et intégrez explicitement le comportement de troncature dans la conception.
Le résultat le plus probant n'est pas celui qui condense le plus de texte dans une seule requête. C'est celui qui fournit les preuves requises, assure la traçabilité et indique clairement les cas où l'information était indisponible.