Une bonne configuration Ollama–Obsidian n'est pas simplement celle où une boîte de chat renvoie du texte. Pour la gestion des connaissances personnelles, le meilleur test est de savoir si le système peut utiliser les notes que vous avez prévues, préserver votre contrôle sur le coffre, répondre à une vitesse acceptable et admettre lorsque vos notes ne contiennent pas la réponse. Si ces conditions ne sont pas remplies, changer le modèle, la configuration de récupération ou les paramètres du plugin est plus utile que de modifier constamment les prompts.
En septembre 2026, l'API locale d'Ollama est toujours servie par défaut sur http://localhost:11434, avec des routes API sous /api, et l'accès local ne nécessite pas d'authentification. Ollama fournit également des embeddings pour la recherche sémantique et la génération augmentée par récupération (RAG), ce qui est la partie qui rend le questionnement sur l'ensemble du coffre matériellement différent d'un chat ordinaire. Consultez l'introduction officielle à l'API Ollama, la documentation sur l'authentification locale et la documentation sur les embeddings.
Ce guide utilise Copilot for Obsidian comme exemple de plugin communautaire car son projet prend actuellement en charge les modèles Ollama locaux et les flux de travail orientés coffre. La formulation exacte des paramètres peut changer entre les versions du plugin, donc utilisez le dépôt Copilot for Obsidian actuel et son guide de configuration des modèles locaux si une étiquette dans votre installation diffère des captures d'écran ou des étapes ci-dessous.
Que doit réellement accomplir une configuration PKM locale réussie ?
Avant d'installer quoi que ce soit, définissez le résultat souhaité. Une configuration locale utile doit passer quatre tests pratiques :
- Connexion : Obsidian peut atteindre un modèle qu'Ollama sert réellement sur votre machine.
- Ancrage : lorsque vous posez une question sur une note ou votre coffre, la réponse reflète le contenu pertinent de la note au lieu de se reposer uniquement sur la formation générale du modèle.
- Performance : le temps de réponse et l'utilisation de la mémoire sont suffisamment acceptables pour que vous utilisiez réellement le flux de travail.
- Contrôle : vous savez quel plugin peut lire ou modifier les notes, quel point de terminaison de modèle il utilise, et si des fonctionnalités web ou cloud optionnelles sont activées.
Ces critères sont importants car « modèle local connecté » et « bonne gestion des connaissances personnelles » ne sont pas la même chose. Le chat peut fonctionner parfaitement alors que la récupération du coffre est faible, et un modèle puissant peut toujours produire de mauvaises réponses si les mauvaises notes sont récupérées.
Étape 1 : Installer Ollama, tirer un modèle et vérifier l'API locale
Installez Ollama en utilisant les instructions officielles pour votre système d'exploitation. Ollama prend actuellement en charge macOS, Windows et Linux ; le démarrage rapide officiel est le point de départ le plus sûr car les recommandations d'installation et de modèles changent avec le temps.
Tirez un modèle de chat avant d'ouvrir Obsidian. Par exemple :
ollama pull gemma3
ollama ls
Vous n'avez pas besoin d'utiliser gemma3. La partie importante est que le nom du modèle que vous entrerez plus tard dans Obsidian doit correspondre à un modèle qu'Ollama peut lister localement. Commencez par un modèle que votre ordinateur peut exécuter confortablement plutôt que de choisir automatiquement le plus grand modèle disponible.
Ensuite, vérifiez l'API indépendamment d'Obsidian :
curl http://localhost:11434/api/tags
Si cette commande renvoie une liste JSON contenant votre modèle, le service Ollama de base fonctionne. Vous pouvez également exécuter ollama ps pendant qu'un modèle est actif. Ollama documente cette commande comme un moyen de voir si un modèle est chargé dans la mémoire CPU, la mémoire GPU ou un mélange des deux. Si les réponses sont douloureusement lentes ou si la machine devient non réactive, c'est un signal pour passer à un modèle plus petit ou réduire les exigences de contexte plutôt que de supposer qu'Obsidian est le problème.
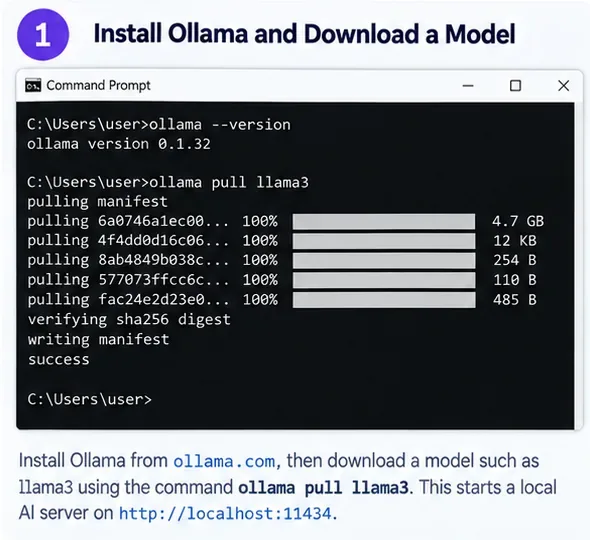
Illustration générée par IA de l'étape d'installation d'Ollama et de tirage du modèle. Les numéros de version et les détails de téléchargement du modèle montrés dans l'image sont illustratifs, pas un enregistrement de version actuelle.
Étape 2 : Installer le plugin Obsidian et connecter son modèle de chat à Ollama
Obsidian traite les plugins communautaires comme du code tiers. Sa documentation officielle avertit que ces plugins exécutent du code en votre nom, donc examinez le code source du plugin et les permissions si votre coffre contient des matériaux sensibles. Pour en installer un, ouvrez Paramètres → Plugins communautaires, activez les plugins communautaires si nécessaire, choisissez Parcourir, puis installez et activez le plugin. Le processus exact est documenté dans la page d'aide officielle d'Obsidian sur les plugins communautaires.
Pour ce guide, installez Copilot depuis le répertoire communautaire et confirmez que le plugin pointe vers le projet vérifié Copilot for Obsidian lié ci-dessus. Évitez de choisir un plugin au nom similaire simplement parce qu'il apparaît en premier dans les résultats de recherche.
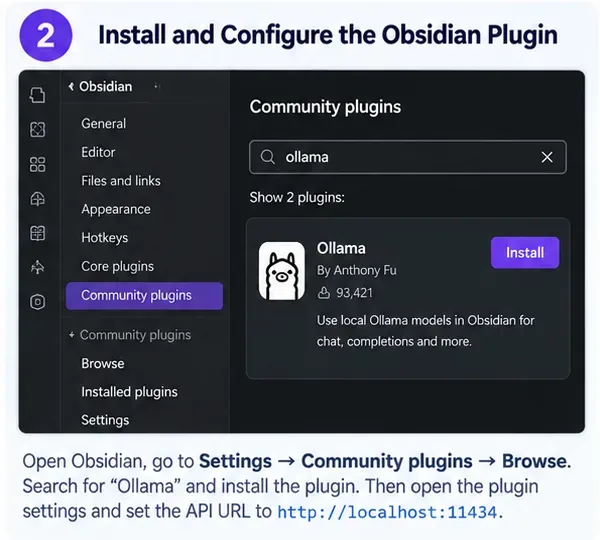
Illustration conceptuelle générée par IA du navigateur de plugins communautaires. La carte du plugin, le nom de l'auteur et le nombre de téléchargements montrés sont illustratifs et ne doivent pas être traités comme des données vérifiées du répertoire ; utilisez le projet Copilot vérifié lié dans cet article.
Ouvrez les paramètres de Copilot et cherchez la zone de configuration du modèle, actuellement organisée sous ses paramètres Modèles. Ajoutez un modèle de chat personnalisé avec ces valeurs :
- Fournisseur : Ollama.
- Modèle : le nom exact du modèle local rapporté par
ollama ls.
- URL de base :
http://localhost:11434.
- Clé API : Ollama lui-même n'en nécessite pas pour l'accès localhost. Si un champ de plugin nécessite un espace réservé, suivez les instructions actuelles de ce plugin plutôt que d'inventer une clé cloud.
Il y a une erreur d'URL facile à éviter. Lorsque vous testez Ollama manuellement, les points de terminaison API ressemblent à http://localhost:11434/api/chat. Le fournisseur Ollama natif de Copilot, cependant, attend l'adresse du serveur de base et construit le point de terminaison en interne, donc utilisez http://localhost:11434 à moins que le plugin actuel ne demande spécifiquement un point de terminaison complet. De même, n'ajoutez pas /v1 lors de l'utilisation du fournisseur Ollama natif. L'API compatible OpenAI séparée d'Ollama utilise /v1, mais c'est un chemin d'intégration différent.
Étape 3 : Tester l'ancrage au niveau de la note avant d'indexer tout votre coffre
Ne commencez pas par indexer des milliers de notes. D'abord, prouvez que la connexion de chat de base fonctionne avec un petit test contrôlé. Créez une note temporaire contenant trois faits faciles à vérifier, tels qu'un nom de projet, une échéance et une décision. Puis joignez ou mentionnez cette note dans Copilot et demandez au modèle de résumer uniquement ce que la note dit.
Un bon résultat devrait reproduire ces faits avec précision, éviter d'ajouter des affirmations non soutenues et rester dans la portée que vous avez demandée. Un mauvais résultat pourrait répondre à partir de connaissances générales tout en ignorant la note, inventer des détails ou omettre un fait important qui est clairement présent.
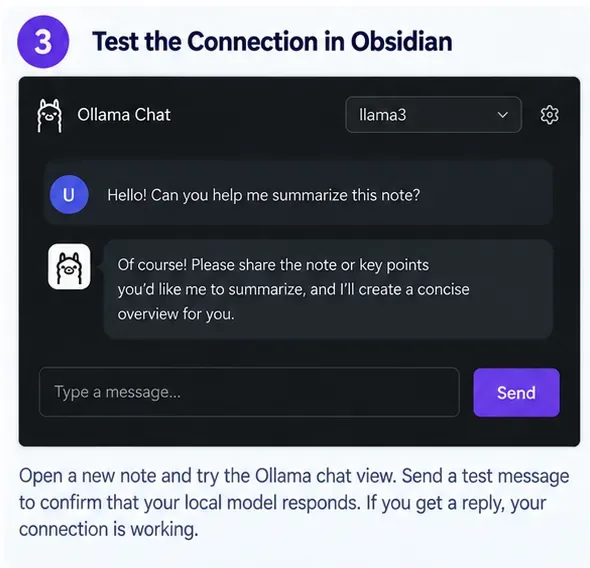
Illustration conceptuelle générée par IA d'un test de chat local dans Obsidian. Elle démontre le type de résultat à vérifier, pas une capture d'écran réelle d'une version spécifique du plugin.
S'il n'y a pas de réponse, dépannez du bas vers le haut. D'abord, relancez curl http://localhost:11434/api/tags. Si cela échoue, le problème est Ollama, pas Obsidian. Si l'API fonctionne mais que Copilot ne fonctionne pas, revérifiez le nom du modèle et l'URL de base. Ce n'est qu'après ces vérifications que vous devriez enquêter sur un problème d'origine/CORS. Le code actuel de Copilot inclut un chemin de requête destiné à gérer l'accès Ollama local, tandis que son guide de configuration locale documente également OLLAMA_ORIGINS pour les configurations qui nécessitent un accès direct à l'origine Obsidian. Utilisez la méthode documentée pour votre version installée de Copilot au lieu d'appliquer automatiquement d'anciennes solutions de contournement de variables d'environnement.
Étape 4 : Ajouter une récupération consciente du coffre uniquement si le chat au niveau de la note réussit
Pour la gestion des connaissances personnelles, la plus grande amélioration de qualité vient souvent de la récupération plutôt que de passer à un modèle de chat plus grand. RAG signifie que le système récupère d'abord des fragments de vos notes qui semblent pertinents, puis donne ces fragments au modèle de langage comme contexte. Cela permet à un modèle local de répondre à des questions sur des informations sur lesquelles il n'a jamais été entraîné.
Pour rendre la récupération locale également, utilisez un modèle d'embedding Ollama. La documentation actuelle d'Ollama recommande des modèles tels que embeddinggemma, qwen3-embedding et all-minilm. Par exemple :
ollama pull embeddinggemma
Configurez ce modèle dans les paramètres d'embedding de recherche de coffre ou de QA de Copilot en utilisant le fournisseur Ollama, puis construisez ou reconstruisez l'index local. Utilisez le même modèle d'embedding pour l'indexation et les requêtes ; Ollama le recommande explicitement car les vecteurs produits par différents modèles ne sont pas directement interchangeables.

Illustration conceptuelle générée par IA d'un flux de travail de notes alimenté par Ollama. Les noms de commandes et la disposition du menu sont des exemples, pas une affirmation sur l'interface utilisateur exacte de la version actuelle de Copilot.
Une fois l'indexation terminée, testez la récupération avec des questions dont vous connaissez déjà les réponses. Demandez un fait qui apparaît dans une note, puis une relation qui nécessite deux notes. Enfin, demandez quelque chose qui n'est pas dans le coffre. Le meilleur résultat n'est pas la réponse la plus fluide ; c'est celle qui utilise la bonne preuve et refuse d'inventer des faits manquants.
Comment juger si le résultat est suffisamment bon
| Contrôle de qualité | Signal de réussite | Quand changer d'approche |
|---|
| Connexion locale | /api/tags fonctionne et le même modèle répond dans Obsidian | Si curl échoue, corrigez Ollama d'abord ; si seul Obsidian échoue, inspectez les paramètres de modèle/URL du plugin |
| Ancrage de note | Les faits connus de la note jointe sont reproduits avec précision | Si le chat ignore la note, corrigez la sélection de contexte avant de changer de modèles |
| Récupération du coffre | Les notes pertinentes sont constamment mises en avant pour les questions à réponse connue | Si la récupération est faible, améliorez les embeddings/l'indexation ou réduisez la portée indexée |
| Qualité de génération | Le modèle sépare les faits soutenus de l'incertitude | Si la récupération est bonne mais que les réponses sont faibles, essayez un modèle de chat plus puissant |
| Latence | Vous pouvez interagir sans longs arrêts répétés | Si Ollama est principalement limité par le CPU ou manque de mémoire, utilisez un modèle plus petit ou moins de contexte |
| Confidentialité | Le point de terminaison configuré est localhost et les fonctionnalités cloud/web optionnelles sont désactivées | Si un point de terminaison distant ou un outil web est actif, le flux de travail n'est plus entièrement local |
Quand un modèle plus grand n'est pas la bonne solution
Si les réponses sont fausses parce que le système récupère les mauvaises notes, améliorer le modèle de chat peut rendre la prose meilleure sans corriger la preuve. Améliorez la récupération d'abord. Inversement, si les passages corrects sont récupérés mais que le modèle ne peut pas les synthétiser de manière fiable, alors un meilleur modèle de chat peut aider.
Le matériel définit également un plafond pratique. Ollama note que les fichiers de modèle peuvent consommer un stockage substantiel, et les contextes plus grands consomment plus de mémoire. Utilisez ollama ps pour voir comment le modèle actuel est chargé. Un flux de travail qui fonctionne techniquement mais prend tellement de temps que vous arrêtez de l'utiliser n'est pas un système PKM réussi.
Limites de confidentialité et de sécurité de l'IA Obsidian « locale »
L'API localhost d'Ollama elle-même ne nécessite pas d'authentification, ce qui est pratique sur une seule machine mais signifie aussi que vous ne devriez pas exposer légèrement le port 11434 à un réseau. Gardez-le lié localement à moins que vous ne sécurisiez délibérément une configuration distante.
Rappelez-vous également que « Ollama est local » ne signifie pas automatiquement que « l'ensemble du flux de travail Obsidian est hors ligne ». Les plugins communautaires peuvent contenir des intégrations de fournisseurs cloud, une recherche web, de la télémétrie ou des outils d'agent. Examinez les paramètres actuels du plugin et désactivez les fonctionnalités que vous n'avez pas l'intention d'utiliser. Si votre objectif est un traitement strictement hors ligne, testez avec le réseau déconnecté après que tous les modèles et plugins sont déjà installés.
Auto-vérification finale
Votre configuration est prête pour la gestion quotidienne des connaissances personnelles lorsque toutes ces affirmations sont vraies : l'API d'Ollama répond localement ; Obsidian utilise le modèle local exact que vous vouliez ; un test de note contrôlé renvoie les faits corrects ; la récupération du coffre trouve les bonnes notes pour les questions à réponse connue ; les questions non soutenues ne déclenchent pas de fabrication confiante ; et la performance est assez rapide pour que vous utilisiez réellement le flux de travail.
Si seules les deux premières affirmations sont vraies, vous avez réussi à connecter Ollama à Obsidian, mais vous n'avez pas encore un assistant de gestion des connaissances fiable. Traitez la qualité de récupération, le comportement du modèle et la configuration de confidentialité comme des parties séparées du système, et changez la partie qui échoue réellement.









