Accueil
» Domaines
»
Comment exécuter DeepSeek hors ligne sur Windows 11 avec LM Studio
Comment exécuter DeepSeek hors ligne sur Windows 11 avec LM Studio
Oui, vous pouvez exécuter DeepSeek entièrement hors ligne sur Windows 11 avec LM Studio, mais vous avez besoin d'une première configuration en ligne. Installez LM Studio, téléchargez un modèle DeepSeek compatible et le runtime requis, chargez le modèle une fois, puis vous pouvez vous déconnecter d'Internet. La documentation officielle hors ligne de LM Studio indique que la discussion avec les modèles téléchargés, la discussion avec des documents locaux et l'exécution de son serveur local ne nécessitent pas d'accès Internet.
Pour un PC Windows 11 typique, le point de départ le plus pratique n'est pas le plus grand modèle DeepSeek actuel. Un modèle GGUF plus petit tel que DeepSeek-R1-0528-Qwen3-8B est beaucoup plus facile à exécuter localement. LM Studio a publié la prise en charge de ce modèle distillé de 8B en mai 2025 et indique qu'il fonctionne au format GGUF avec LM Studio 0.3.16 ou plus récent. En revanche, les directives d'août 2026 de LM Studio pour DeepSeek V4 Flash indiquent que l'utilisation locale nécessite environ 156 Go de mémoire système. Cela fait de V4 Flash un mauvais choix pour la plupart des machines Windows grand public, même s'il est plus récent et plus performant.
Ce guide a été vérifié le 11 septembre 2026. Le journal des modifications de LM Studio répertorie la version 0.4.24 datée du 9 septembre 2026. Parce que l'interface de LM Studio évolue, un bouton peut se déplacer légèrement entre les versions, mais le flux de travail principal—télécharger un modèle, le charger, discuter localement et éventuellement exposer une API localhost—reste documenté par LM Studio.
Avant de commencer : Votre PC Windows 11 est-il adapté ?
LM Studio prend actuellement en charge les PC Windows x64 et les systèmes Windows basés sur ARM. Pour x64, le processeur doit prendre en charge AVX2. LM Studio recommande au moins 16 Go de RAM et au moins 4 Go de VRAM dédiée. Ce sont des recommandations au niveau de l'application, pas une promesse que tous les modèles tiendront. La taille du modèle, la quantification, la longueur du contexte et le déchargement sur le GPU affectent tous l'utilisation de la mémoire.
Ce que vous avez
Recommandation pratique
Pourquoi
16 Go de RAM, GPU modeste ou graphiques intégrés
Commencez avec un modèle distillé DeepSeek de 8B ou plus petit dans une variante GGUF 4 bits
Cela maintient l'empreinte du modèle relativement gérable tout en préservant une capacité de raisonnement utile.
Plus de RAM et un GPU plus puissant
Essayez des variantes distillées plus grandes uniquement après avoir vérifié l'estimation d'adéquation de l'appareil de LM Studio
Les modèles plus grands peuvent améliorer la qualité mais consomment considérablement plus de mémoire et peuvent être beaucoup plus lents.
PC de jeu ou ordinateur portable ordinaire
Ne commencez pas avec DeepSeek V4 Flash
LM Studio indique que le modèle V4 Flash local nécessite au moins 156 Go de mémoire système.
La documentation de téléchargement de modèles de LM Studio explique que les versions quantifiées sacrifient une partie de la fidélité pour des fichiers plus petits et une pression mémoire moindre. Sa recommandation générale est de choisir une option 4 bits ou supérieure lorsque votre matériel peut le gérer. Si vous n'êtes pas sûr, une version GGUF 4 bits est un premier test judicieux.
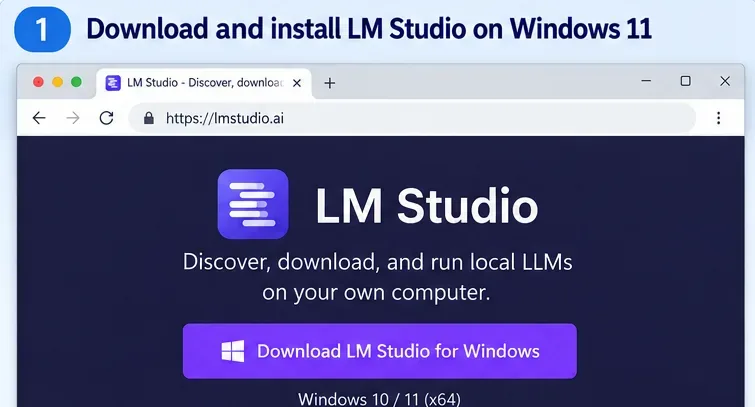
Téléchargez la version stable actuelle pour Windows depuis la page de téléchargement officielle de LM Studio. Utilisez l'installateur qui correspond à l'architecture de votre Windows. Sur un PC x64, assurez-vous que votre processeur prend en charge AVX2 avant de résoudre les erreurs de chargement de modèle plus tard.
La vue de téléchargement Windows pour LM Studio. Choisissez l'installateur qui correspond à votre système Windows 11 avant de passer au téléchargement du modèle.
Lancez LM Studio tant que vous avez encore une connexion Internet. Cela est important car l'application peut avoir besoin de télécharger ou de mettre à jour un LM Runtime. LM Studio décrit les runtimes comme des moteurs d'inférence empaquetés, tels que son runtime basé sur llama.cpp pour les modèles GGUF. Les téléchargements de runtimes nécessitent une connectivité même si l'inférence peut fonctionner hors ligne par la suite.
Étape 2 : Télécharger un modèle DeepSeek adapté à votre PC
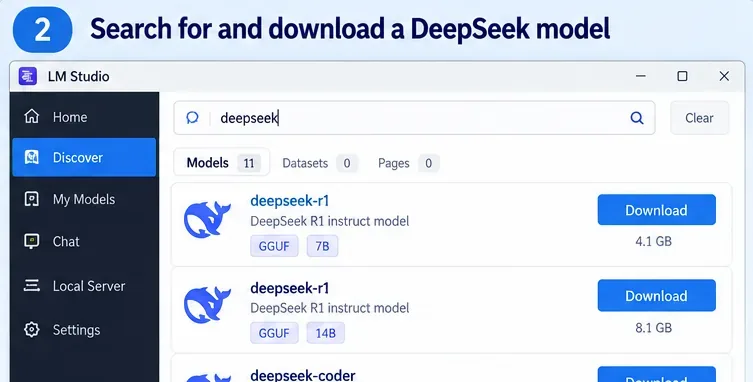
Ouvrez la zone Discover dans LM Studio et recherchez DeepSeek. LM Studio peut rechercher les modèles Hugging Face pris en charge par mot-clé, par un identifiant utilisateur/modèle, ou même par une URL Hugging Face complète.
Recherchez DeepSeek dans Discover, puis choisissez un modèle et une quantification appropriés pour votre matériel. Les entrées exactes du catalogue et les tailles de fichiers changent avec le temps.
Quel modèle DeepSeek devriez-vous choisir ?
Pour la plupart des personnes suivant ce guide, commencez par DeepSeek-R1-0528-Qwen3-8B. LM Studio indique que ce modèle distillé de 8B prend en charge le raisonnement et l'utilisation d'outils, est disponible en GGUF, et peut fonctionner avec beaucoup moins de mémoire que les modèles DeepSeek phares. Les directives Windows de LM Studio recommandent toujours 16 Go de RAM pour l'application dans son ensemble, ne traitez donc pas une affirmation de faible mémoire spécifique au modèle comme une cible confortable pour l'ensemble du système.
DeepSeek a également publié des variantes distillées R1 antérieures avec 1,5B, 7B, 8B, 14B, 32B et 70B paramètres. Celles-ci vous donnent la possibilité de compenser la vitesse et l'utilisation de la mémoire contre la capacité. Consultez le dépôt officiel DeepSeek-R1 pour la famille de modèles et les détails de licence, et la note d'exécution locale DeepSeek-R1-0528 de LM Studio pour l'option 8B.
Si vous êtes tenté par DeepSeek V4 Flash parce qu'il est plus récent, vérifiez d'abord l'exigence matérielle. L'article officiel V4 Flash de LM Studio indique que le modèle Mixture-of-Experts de 284B nécessite au moins 156 Go de mémoire système pour une utilisation locale. Il est viable sur des stations de travail à haute mémoire, pas sur un ordinateur portable Windows normal.
Étape 3 : Charger le modèle en mémoire
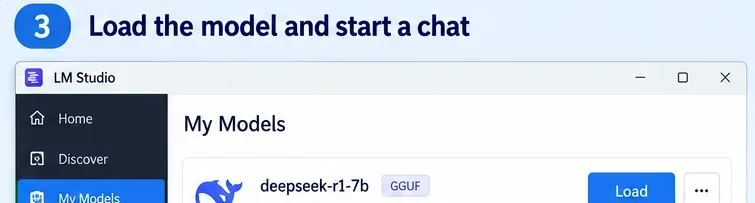
Une fois le téléchargement terminé, accédez à vos modèles téléchargés ou ouvrez le chargeur de modèle depuis Chat. Sélectionnez le modèle DeepSeek et chargez-le. LM Studio explique que le chargement d'un modèle alloue de la mémoire pour les poids du modèle et l'état d'exécution associé.
Un modèle DeepSeek GGUF téléchargé prêt à être chargé. Si le chargement échoue, essayez un modèle plus petit ou une quantification à mémoire inférieure avant de modifier les paramètres avancés.
Pour votre première exécution, gardez les paramètres de chargement conservateurs. Une très grande fenêtre de contexte peut consommer une mémoire supplémentaire significative, il y a donc peu de raisons de maximiser le contexte immédiatement. Chargez le modèle avec un contexte modeste, vérifiez qu'il fonctionne, et étendez-le uniquement lorsque votre charge de travail l'exige.
Si LM Studio signale que le modèle ne tient pas, la correction la plus fiable est généralement de choisir un modèle plus petit ou une quantification plus compacte. Fermer des applications gourmandes en mémoire peut aider, mais cela ne change pas l'empreinte fondamentale du modèle.
Étape 4 : Déconnectez Internet et vérifiez que DeepSeek fonctionne vraiment hors ligne
C'est l'étape qui sépare « modèle local » de simplement « utiliser un client de bureau ». Une fois le modèle et son runtime installés, désactivez le Wi-Fi et débranchez l'Ethernet. Puis démarrez une nouvelle discussion et envoyez une invite simple telle que :
Expliquez la différence entre la RAM et la VRAM en cinq points.
Si le modèle répond alors que le PC n'a pas de connexion réseau, l'inférence est locale. LM Studio déclare qu'une fois qu'un LLM est sur votre machine, il peut fonctionner entièrement hors ligne et que le texte saisi dans les discussions LLM locales ne quitte pas votre appareil. Sa documentation hors ligne indique également que le traitement de documents locaux et le RAG restent sur la machine.
Un modèle DeepSeek chargé répondant dans LM Studio Chat. Pour vérifier vous-même le fonctionnement hors ligne, déconnectez l'accès réseau après que le modèle et le runtime sont entièrement téléchargés et répétez une invite simple.
Il y a une frontière importante : la recherche de modèles, le téléchargement de nouveaux modèles, le téléchargement de runtimes et la vérification des mises à jour de l'application nécessitent un accès Internet. Si vous ajoutez ultérieurement des modèles cloud, des serveurs MCP distants, des outils web ou d'autres intégrations réseau, ces fonctionnalités peuvent également nécessiter une connectivité. Les affirmations de confidentialité hors ligne s'appliquent au flux de travail local, pas aux services auxquels vous vous connectez délibérément par la suite.
Étape 5 : Optionnel—Utiliser DeepSeek via une API locale
Si vous souhaitez qu'une autre application Windows, script, extension IDE ou outil interne appelle votre modèle DeepSeek local, LM Studio peut exécuter un serveur local. La documentation développeur actuelle indique que vous pouvez le démarrer depuis la page Développeur ou avec :
lms server start
Par défaut, le serveur est disponible sur http://localhost:1234. LM Studio fournit des points de terminaison REST natifs et des points de terminaison compatibles OpenAI. Le serveur lui-même peut fonctionner hors ligne tant que le modèle et le runtime sont déjà locaux. Si vous exposez le serveur au-delà de localhost, cependant, examinez d'abord les paramètres d'authentification et d'accès réseau.
Problèmes courants et la correction la plus rapide
Problème
Cause probable
Que faire
Le modèle ne se charge pas
Pas assez de RAM/VRAM, contexte surdimensionné, ou CPU/runtime non pris en charge
Essayez un modèle DeepSeek plus petit, une quantification plus petite, ou une longueur de contexte inférieure. Sur Windows x64, confirmez la prise en charge AVX2.
LM Studio fonctionne en ligne mais pas après la déconnexion
Le modèle ou le runtime requis n'a pas été entièrement téléchargé
Reconnectez-vous une fois, terminez tous les téléchargements de modèles/runtimes, chargez le modèle avec succès, puis répétez le test hors ligne.
La génération est très lente
Le modèle est trop grand pour l'accélération GPU disponible et repose fortement sur la mémoire CPU/système
Choisissez un modèle ou une quantification plus petits. Un modèle plus grand n'est pas utile si la latence rend le flux de travail impraticable.
Vous ne pouvez pas trouver un modèle hors ligne
La recherche Discover nécessite un accès réseau
Téléchargez les modèles avant de passer hors ligne, ou installez manuellement un fichier de modèle obtenu via un autre processus contrôlé.
Vous vous attendiez à ce que V4 Flash fonctionne sur un ordinateur portable normal
Sa exigence de mémoire locale est de classe station de travail
Utilisez plutôt un modèle distillé R1 à moins que votre machine n'ait environ 156 Go ou plus de mémoire système.
Quand cette configuration est-elle adaptée ?
Exécuter DeepSeek hors ligne avec LM Studio est un excellent choix lorsque vous souhaitez une inférence locale privée, des coûts prévisibles après le téléchargement du modèle, de l'expérimentation sans clés API, ou une API localhost pour le développement. C'est également utile lorsque votre machine doit continuer à fonctionner sans accès Internet.
C'est un choix moins adapté lorsque vous avez besoin du modèle DeepSeek le plus puissant disponible mais que vous ne disposez que de matériel grand public, lorsque vous avez besoin d'un débit extrêmement élevé, ou lorsque votre charge de travail dépend d'informations web en direct. Les modèles locaux ne connaissent que ce qui se trouve dans leurs poids et le contexte que vous fournissez, à moins que vous ne connectiez délibérément des outils externes ou des sources de données.
Liste de contrôle rapide
Utilisez un système Windows 11 qui répond aux exigences de LM Studio ; les CPU x64 ont besoin d'AVX2.
Gardez l'accès Internet activé pour les téléchargements initiaux de LM Studio, du runtime et des modèles.
Commencez avec un modèle GGUF DeepSeek plus petit, en particulier un modèle distillé de classe 8B.
Choisissez une quantification de 4 bits ou supérieure si votre matériel peut la prendre en charge.
Chargez le modèle avec succès avant de déconnecter le réseau.
Désactivez le Wi-Fi/Ethernet et exécutez une nouvelle invite pour vérifier l'inférence hors ligne.
Réduisez la taille du modèle ou la longueur du contexte si vous rencontrez des erreurs de mémoire.
Utilisez le serveur localhost de LM Studio uniquement si vous avez besoin d'un accès API local.
En résumé
La façon la plus simple d'exécuter DeepSeek hors ligne sur Windows 11 est d'associer LM Studio à un modèle GGUF DeepSeek plus petit qui tient réellement sur votre matériel. Pour un PC normal, un modèle distillé R1 de classe 8B est un point de départ bien plus réaliste que DeepSeek V4 Flash. Terminez les téléchargements en ligne, chargez le modèle, déconnectez le réseau, et vérifiez qu'une nouvelle discussion répond toujours. Une fois que cela fonctionne, vous avez une configuration DeepSeek véritablement locale plutôt qu'une enveloppe de bureau autour d'une API cloud.