Accueil
» Domaines
»
Comment empêcher les agents CrewAI d'exécuter des tâches redondantes : un guide pratique de déduplication
Comment empêcher les agents CrewAI d'exécuter des tâches redondantes : un guide pratique de déduplication
Lorsque des agents CrewAI semblent exécuter deux fois la même tâche, la cause n'est généralement pas un simple paramètre de « tâche dupliquée ». La répétition peut provenir de descriptions de tâches qui se chevauchent, d'une délégation hiérarchique, d'un comportement de nouvelle tentative, de plusieurs déclencheurs de flux, de lancements d'équipe répétés ou d'outils ayant des effets secondaires non protégés par une clé d'idempotence.
Cette référence pratique a été vérifiée par rapport à la documentation officielle de CrewAI le 13 septembre 2026. La documentation actuelle correspond à CrewAI v1.15.14. La principale distinction est la suivante : empêcher les raisonnements redondants au sein d'une même exécution est différent d'empêcher la répétition d'une même action métier lors d'exécutions successives . CrewAI fournit le contexte des tâches, les tâches conditionnelles, les rappels, l'état du flux, la persistance et la mise en cache des outils, mais vous devez toujours définir explicitement les conditions d'exclusion pour les opérations qui ne doivent être effectuées qu'une seule fois.
Diagnostic rapide : pourquoi le même travail est-il effectué deux fois ?
Symptôme
Cause probable
Première solution à essayer
Deux agents font des recherches sur le même sujet.
Chevauchement des rôles ou des descriptions de tâches
Attribuez un responsable à chaque tâche et transmettez les résultats précédents.context
Un responsable demande un travail déjà effectué par un autre agent.
Délégation hiérarchique et responsabilités ambiguës
Clarifier les instructions du gestionnaire, les rôles des agents et la propriété des outils
La même tâche s'exécute plusieurs fois après un échec de validation.
nouvelles tentatives de garde-corps
Examinez l'erreur de la barrière de sécurité et réduisez-la guardrail_max_retrieslors du débogage.
Un agent appelle à plusieurs reprises le même outil
1. Commencez par un propriétaire par unité de travail.
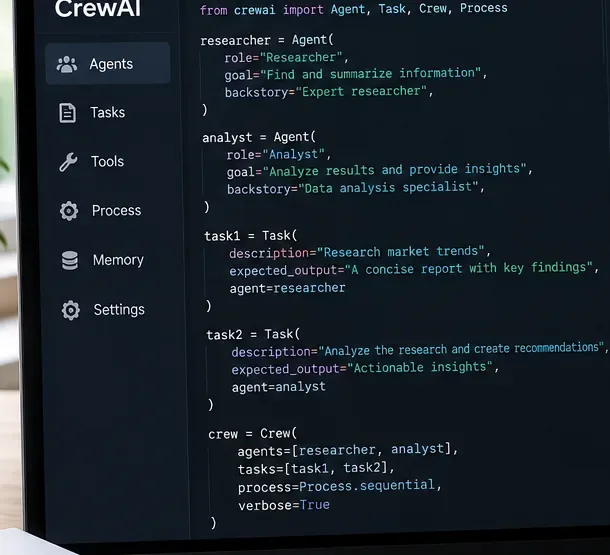
La règle anti-duplication la plus simple est aussi la plus efficace : chaque unité de travail significative doit avoir un seul responsable. Dans un processus CrewAI séquentiel, les tâches s'exécutent dans l'ordre de leur déclaration. Cet contextattribut permet à une tâche ultérieure d'utiliser le résultat d'une tâche précédente au lieu de redécouvrir indépendamment la même information.
Il est plus facile de raisonner sur la notion de propriété séparée : une tâche effectue des recherches, la tâche suivante analyse ces recherches au lieu de les répéter.
Un anti-modèle courant se présente conceptuellement comme suit :
research_task: "Research the customer and summarize findings"
analysis_task: "Research the customer, analyze findings, and recommend actions"
writer_task:   "Review the customer, research missing details, and write the report"
Les trois tâches autorisent la recherche, la répétition de cette recherche est donc prévisible. Privilégier une chaîne de recherche plus restreinte :
from crewai import Agent, Crew, Process, Task

research_task = Task(
    description="Research the customer once and return verified facts and sources.",
    expected_output="Structured research notes with sources.",
    agent=researcher,
)

analysis_task = Task(
    description="Analyze only the research provided in context. Do not perform new research.",
    expected_output="Prioritized findings and recommendations.",
    agent=analyst,
    context=[research_task],
)

crew = Crew(
    agents=[researcher, analyst],
    tasks=[research_task, analysis_task],
    process=Process.sequential,
)
Liste de contrôle pratique pour les limites des tâches
Attribuez à chaque tâche un verbe différent des autres : rechercher, normaliser, analyser, écrire, réviser.
Indiquez ce que la tâche ne doit pas faire lorsque le chevauchement est coûteux.
Rendez le résultat attendu suffisamment concret pour que la tâche suivante puisse l'utiliser directement.
Transmettez les résultats précédents au contextlieu de dire aux agents suivants de « faire des recherches si nécessaire ».
Limitez les outils au niveau de la tâche ou de l'agent lorsqu'un seul rôle doit être autorisé à effectuer des recherches, à écrire dans une base de données, à envoyer des messages ou à appeler une API externe.
2. Ignorer le travail déjà satisfait par ConditionalTask
Si une tâche n'est nécessaire que lorsqu'un résultat précédent est incomplet, évitez de laisser l'agent décider de manière informelle s'il doit répéter le travail. CrewAI propose ConditionalTaskune fonction qui reçoit le résultat de la tâche précédente et peut ignorer son exécution si la condition est fausse.
L'exemple officiel utilise une condition qui vérifie si suffisamment d'enregistrements d'événements ont été renvoyés ; si les données sont suffisantes, la tâche de récupération supplémentaire est ignorée. Voir Tâches conditionnelles de CrewAI .
from typing import List
from pydantic import BaseModel
from crewai import Agent, Crew, Task
from crewai.tasks.conditional_task import ConditionalTask
from crewai.tasks.task_output import TaskOutput

class ResearchOutput(BaseModel):
    sources: List[str]
    summary: str

def needs_more_sources(output: TaskOutput) -> bool:
    return len(output.pydantic.sources) < 5

research = Task(
    description="Find up to five authoritative sources about the topic.",
    expected_output="A structured research result.",
    agent=researcher,
    output_pydantic=ResearchOutput,
)

enrich = ConditionalTask(
    description="Find only the missing sources needed to reach five total.",
    expected_output="Additional authoritative sources only.",
    condition=needs_more_sources,
    agent=researcher,
)
Ce modèle est plus efficace que d'inciter un agent à « éviter les tâches en double », car la décision de passer à l'étape suivante repose sur une logique Python déterministe plutôt que sur un autre jugement de modèle de langage.
3. Savoir reconnaître les situations où la délégation engendre des doublons apparents
CrewAI prend en charge les processus séquentiels et hiérarchiques. Dans une équipe hiérarchique, un responsable attribue les tâches, délègue le travail, valide les résultats et détermine si l'exécution des tâches est satisfaisante. Cette flexibilité est utile lorsque l'attribution du travail doit être dynamique, mais elle implique également que les responsabilités sont moins clairement définies que dans une équipe séquentielle.
La documentation des agents de CrewAI indique actuellement que allow_delegationla valeur par défaut est «False . ». Conservez cette valeur par défaut pour les spécialistes, sauf si un agent a réellement besoin de déléguer une tâche à un autre agent. Dans un processus hiérarchique, le responsable de la délégation incombe au manager. Consultez le guide des processus hiérarchiques .
Un point de départ sûr pour une équipe qui effectue des appels redondants est :
researcher = Agent(
    role="Researcher",
    goal="Collect evidence once and return it in structured form.",
    backstory="You gather evidence; you do not write the final report.",
    allow_delegation=False,
    max_iter=8,
    max_retry_limit=1,
)

writer = Agent(
    role="Writer",
    goal="Write from supplied context without doing fresh research.",
    backstory="You synthesize existing evidence into a final answer.",
    allow_delegation=False,
    max_iter=6,
)
Réintroduisez ensuite la délégation uniquement lorsqu'elle apporte un bénéfice mesurable. Si une orchestration hiérarchique n'est pas nécessaire, Process.sequentialle débogage est facilité car l'ordre des tâches et la responsabilité sont clairement définis.
4. Ne confondez pas les nouvelles tentatives avec la planification en double.
Un traitement répétitif est normal. Les gardes de tâches de CrewAI permettent de valider une sortie et de renvoyer un retour à l'agent en cas d'échec de la validation. La documentation actuelle indique que guardrail_max_retriesla valeur par défaut est de 3, et qu'en cas d'échec d'un garde de tâches, la tâche est relancée jusqu'à cette limite.
Les agents signalent également max_retry_limitles erreurs d'exécution et max_iterle nombre maximal d'itérations avant de fournir la meilleure réponse disponible. La documentation actuelle indique une valeur par défaut max_iterde 20 pour le nombre d'itérations et de 2 pour le nombre de tentatives en cas d'erreur.
Ces mécanismes résolvent des problèmes différents :
Paramètre
Ce qu'il limite
Pourquoi cela peut paraître redondant
guardrail_max_retries
Nouvelles tentatives après l'échec de la validation de la sortie de la tâche
La même tâche est intentionnellement réexécutée avec un retour d'information de sécurité.
max_retry_limit
Nouvelles tentatives après des erreurs d'exécution
Une tentative infructueuse peut répéter un appel d'outil
max_iter
Itérations de raisonnement de l'agent/de l'outil
Un agent incertain peut effectuer plusieurs appels d'outils similaires avant de terminer.
Lors du débogage, réduisez temporairement ces limites. Si la répétition disparaît, examinez la raison de l'échec de validation de la tâche ou pourquoi l'agent a jugé nécessaire une nouvelle itération de l'outil. En production, ne définissez pas systématiquement toutes les valeurs de nouvelle tentative à zéro ; les nouvelles tentatives peuvent être appropriées en cas d'échecs transitoires.
5. Retracer ce qui a réellement été exécuté avant de réécrire les invites
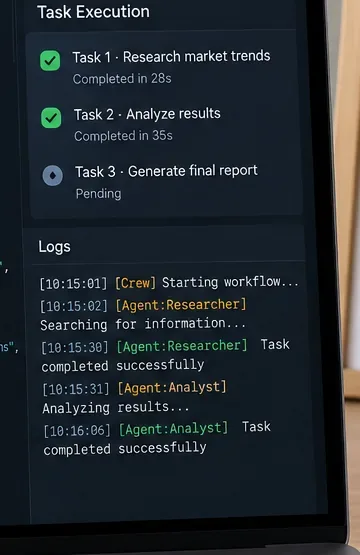
Les journaux d'exécution permettent de distinguer une véritable exécution de seconde tâche des multiples étapes, tentatives ou appels d'outils au sein d'une même tâche.
CrewAI expose plusieurs points d'accès à l'observabilité. Au niveau de l'équipage, la documentation actuelle inclut les contrôles suivantsverbose : [ step_callbackliste des contrôles]. Les agents prennent également en charge [liste des task_callbackcontrôles ]. Ces éléments sont utiles pour répondre à quatre questions :output_log_filestep_callback
Le planificateur a-t-il lancé la même tâche deux fois ?
Un agent a-t-il effectué plusieurs itérations au sein d'une même tâche ?
Un mécanisme de sécurité a-t-il rejeté la sortie et déclenché une nouvelle tentative ?
Un appel d'outil s'est-il répété alors que la tâche elle-même ne s'est exécutée qu'une seule fois ?
Pour un diagnostic initial, activez la sortie détaillée et un fichier journal JSON :
Les flux introduisent un autre type de répétition. La documentation actuelle de CrewAI indique que toutes @start()les méthodes satisfaites s'exécutent au démarrage ou à la reprise du flux. Si vous définissez plusieurs démarrages inconditionnels et que deux d'entre eux finissent par lancer la même équipe, la duplication se situe dans votre graphe, et non au sein de l'équipe.
De même, or_les écouteurs peuvent s'exécuter lorsqu'une méthode en amont émet un résultat. L'exemple de CrewAI montre l'écouteur s'activant une fois pour chaque émission en amont. Utilisez cette méthode and_lorsque l'opération en aval doit attendre que plusieurs prérequis soient remplis, ou @router()lorsqu'une seule branche doit être exécutée.
Avant d'en ajouter un deuxième @start(), demandez-vous s'il représente réellement un point d'entrée indépendant. Dans le cas contraire, utilisez une seule méthode de démarrage et des écouteurs explicites.
7. Ajouter une clé de complétion pour l'idempotence inter-exécutions
Il s'agit du modèle de production le plus important lorsqu'une tâche produit un effet secondaire externe, comme l'envoi d'un e-mail, la facturation d'un moyen de paiement, la création d'un enregistrement CRM, la publication d'un message ou le lancement d'une tâche.
Les flux CrewAI prennent en charge l'état structuré et le @persistdécorateur. La persistance permet à un flux de récupérer son état après un redémarrage. Cependant, l'état persistant seul ne détermine pas si une action métier doit être ignorée. Stockez votre propre clé d'opération déterministe et vérifiez-la avant d'appliquer l'effet de bord.
La persistance et la mémoire sont des éléments de base utiles, mais un flux de travail de production a toujours besoin d'une règle explicite « déjà terminé ? » pour les actions qui doivent se produire une seule fois.
from hashlib import sha256
import json
from pydantic import BaseModel
from crewai.flow.flow import Flow, start
from crewai.flow.persistence import persist

class JobState(BaseModel):
    completed_keys: list[str] = []
    report: str = ""

def operation_key(customer_id: str, period: str) -> str:
    payload = {"customer_id": customer_id, "period": period}
    raw = json.dumps(payload, sort_keys=True).encode()
    return sha256(raw).hexdigest()

@persist
class ReportFlow(Flow[JobState]):

    @start()
    def run_report(self):
        key = operation_key("customer-123", "2026-09")

        if key in self.state.completed_keys:
            return self.state.report

        result = reporting_crew.kickoff(
            inputs={"customer_id": "customer-123", "period": "2026-09"}
        )

        self.state.report = result.raw
        self.state.completed_keys.append(key)
        return self.state.report
CrewAI documente la @persistcapacité de conserver l'état de Flow entre les redémarrages et indique que la reprise avec le même ID d'état recharge le dernier instantané. Consultez la documentation sur la persistance de CrewAI Flow .
Avertissement important concernant la production : l’exemple ci-dessus est utile pour la déduplication des flux de travail classiques, mais insuffisant pour gérer un effet secondaire critique sur le plan financier ou juridique. Un processus peut planter après la réussite de l’action externe, mais avant l’enregistrement de la clé d’achèvement. Pour garantir un comportement « une seule fois », utilisez un système de stockage transactionnel externe ou la clé d’idempotence de l’API cible, et enregistrez l’opération de manière atomique lorsque cela est possible.
8. Mettez en cache les appels d'outils répétés, mais ne confondez pas la mise en cache avec l'idempotence des tâches.
Les agents et les équipes de CrewAI exposent des données cache, décrites dans la documentation officielle comme un système de mise en cache des résultats d'exécution des outils. La documentation actuelle des agents indique que la mise en cache est activée par défaut, et les recommandations de performance préconisent de la maintenir activée pour une utilisation répétée des outils.
Cela s'avère utile lorsqu'un agent effectue plusieurs fois la même recherche coûteuse ou le même appel à un outil déterministe. Toutefois, le fait d'appeler deux fois un outil ne signifie pascrew.kickoff() que les tâches de l'équipe seront automatiquement ignorées. La tâche reste inscrite dans le graphe d'exécution.
Utilisez le cache pour les lectures répétées. Utilisez une clé d'idempotence pour les écritures répétées.
Opération
Protection privilégiée
Rechercher la même documentation
Cache d'outils
Réutiliser les connaissances antérieures pour différentes tâches
Contexte de mémoire ou de tâche
Ignorez une tâche facultative lorsqu'il existe déjà suffisamment de données.
ConditionalTask
Empêcher une branche Flow de se déclencher incorrectement
Refonte du routeur, de l'état and_ou du graphe
Empêcher les écritures externes dupliquées lors des nouvelles tentatives/redémarrages
Clé d'idempotence persistante ou magasin transactionnel externe
9. La mémoire réduit la nécessité de redécouvrir, mais elle n'annule pas les tâches.
Le système de mémoire unifiée de CrewAI stocke les informations après l'exécution des tâches et rappelle le contexte pertinent avant celles-ci. La documentation actuelle indique qu'avec la mémoire CrewAI activée, des informations spécifiques sont extraites des résultats des tâches et les souvenirs pertinents sont intégrés aux invites des tâches suivantes.
Cela permet de réduire les redécouvertes inutiles, notamment lorsqu'un auteur doit connaître les résultats d'un chercheur. Cependant, la mémoire sert de contexte de recherche, et non d'indicateur d'exclusion. Une tâche explicitement planifiée s'exécute toujours, sauf si la logique de votre équipe ou de votre flux en décide autrement.
Utilisez la mémoire pour répondre à la question « Que savons-nous déjà ? ». Utilisez l’état ou une tâche conditionnelle pour répondre à la question « Cette opération doit-elle être exécutée ? ». Voir la mémoire de CrewAI .
10. Utilisez des résultats structurés pour rendre les décisions de saut fiables.
Le traitement du langage naturel est difficile à exploiter pour un contrôle déterministe des flux de travail. Les tâches CrewAI peuvent renvoyer des résultats Pydantic ou JSON output_pydantic. output_jsonUn résultat structuré permet de déterminer facilement si un enrichissement, une révision, une escalade ou une autre action est nécessaire.
Il est alors préférable d'acheminer les demandes en fonction des champs plutôt que de demander à un autre agent d'interpréter un paragraphe. Cela permet généralement de réduire le travail redondant et l'ambiguïté des instructions.
Configuration anti-redondance recommandée
Une liste de contrôle concise est utile avant d'augmenter la complexité du modèle : la plupart des problèmes de redondance sont plus faciles à résoudre d'abord dans la conception des tâches et le flux de contrôle.
Pour un processus classique de recherche et de publication, commencez par une approche prudente :
N'ajoutez de la complexité que lorsque les exigences le nécessitent :
Ajoutez de la mémoire lorsque des faits doivent être réutilisés entre plusieurs tâches ou exécutions.
Ajoutez une ConditionalTask lorsqu'une tâche ne doit s'exécuter que si la sortie précédente est incomplète.
Utilisez un processus hiérarchique lorsque l'affectation dynamique des responsables est réellement nécessaire.
N'activez la délégation que pour les agents qui doivent confier du travail à leurs collègues.
Mettre en place des garde-fous pour la qualité de la sortie, tout en acceptant qu'un garde-fou défaillant provoque intentionnellement des nouvelles tentatives.
Ajouter la persistance Flow lorsque l'état doit survivre aux redémarrages.
Ajoutez une couche d'idempotence externe lorsque les effets secondaires redondants sont inacceptables.
Liste de vérification finale pour le dépannage
La même tâche est-elle Taskmentionnée deux fois dans la liste des tâches de l'équipage ?
Deux descriptions de tâches autorisent-elles la même recherche ou le même appel d'outils ?
Une tâche ultérieure peut-elle consommer la tâche précédentecontext ?
La tâche répétée doit-elle être une ConditionalTask?
Utilisez-vous une orchestration hiérarchique alors qu'une orchestration séquentielle suffirait ?
Est-ce allow_delegationactivé sur les agents qui n'en ont pas besoin ?
Un rejet dû à une barrière de sécurité entraîne-t-il une nouvelle tentative ?
Est-elle max_itersuffisamment volumineuse pour qu'une seule tâche effectue de nombreux appels d'outils similaires ?
Plusieurs @start()méthodes ou or_auditeurs actionnent-ils la même équipe en aval ?
Une seconde exécution kickoff()représente-t-elle une nouvelle exécution intentionnelle ou une invocation dupliquée accidentelle ?
Vous vous fiez à la mémoire ou au cache comme s'il s'agissait de mécanismes de contrôle d'idempotence au niveau des tâches ?
Les écritures externes possèdent-elles une clé d'idempotence déterministe ?
Les journaux peuvent-ils prouver si le doublon s'est produit au niveau de la tâche, de l'étape de l'agent, de l'outil ou du flux ?
En résumé
L'arrêt des tâches CrewAI redondantes relève principalement d'un problème d'orchestration. Il est essentiel de définir clairement la responsabilité des tâches, d'enchaîner contextles tâches, d'ignorer conditionnellement les tâches déjà effectuées, de limiter la délégation, de comprendre quand les nouvelles tentatives sont intentionnelles et de suivre l'exécution avant de modifier les invites. Pour les flux et les effets de bord en production, il est recommandé d'aller plus loin : conserver une clé d'achèvement déterministe ou utiliser un mécanisme d'idempotence externe.
Le modèle mental utile est simple : le contexte empêche la redécouverte, les conditions évitent les tâches inutiles, le cache empêche les calculs redondants et l’idempotence empêche les effets secondaires répétés . Ces concepts résolvent des problèmes connexes, mais ne sont pas interchangeables.