Réduire une facture d'API LLM de 50 % est possible pour de nombreuses charges de travail, mais ce n'est pas une garantie universelle. Le résultat dépend de l'origine de vos dépenses : jetons d'entrée non mis en cache, jetons d'entrée mis en cache, jetons de sortie, jetons de raisonnement, appels d'outils ou tentatives. La compression de prompts fonctionne mieux lorsque les entrées longues ou répétitives représentent une part significative de la facture. L'objectif pratique n'est donc pas de « rendre chaque prompt deux fois plus court », mais de « supprimer les jetons qui ne changent pas la réponse, préserver ceux qui la changent, et vérifier les économies réalisées sur un trafic réel ».
Ce guide utilise quatre étapes de mise en œuvre : mesurer la référence, supprimer les entrées redondantes, organiser les prompts pour la réutilisation du cache, et déplacer les instructions de sortie verbales vers des contrôles structurés lorsque l'API les prend en charge. Les exemples sont illustratifs et ne constituent pas des affirmations de référence. Les prix des fournisseurs et le comportement du cache évoluent avec le temps ; vérifiez donc les tarifs actuels avant d'établir une estimation de production.
Que nécessite réellement une réduction de 50 % des coûts d'API ?
Commencez par l'équation de facturation de votre modèle. Pour une charge de travail textuelle simple, le coût total de la requête est approximativement égal au coût des entrées non mises en cache plus les entrées mises en cache plus les sorties. Certains modèles ou fonctionnalités ajoutent d'autres catégories facturables. Les réponses actuelles de l'API OpenAI exposent l'utilisation des jetons d'entrée et de sortie, y compris les détails des jetons mis en cache, et leurs pages de modèles publient des tarifs distincts pour l'entrée, l'entrée mise en cache et la sortie.
| Charge de travail illustrative | Jetons d'entrée | Jetons de sortie | Résultat relatif |
|---|
| Requête de référence | 10 000 | 1 000 | 100 % du coût de référence |
| Seule l'entrée est réduite de moitié | 5 000 | 1 000 | Moins de 50 % d'économies totales lorsque la sortie reste inchangée |
| L'entrée et la sortie sont réduites de moitié | 5 000 | 500 | Environ 50 % de réduction du coût basé sur les jetons lorsque les tarifs sont inchangés |
Pour un exemple concret actuel, la page officielle du modèle GPT-5.6 Sol indiquait, le 11 septembre 2026, 4 $ par million de jetons d'entrée, 0,40 $ par million de jetons d'entrée mis en cache et 20 $ par million de jetons de sortie. À ces tarifs, une requête de 10 000 entrées / 1 000 sorties coûte environ 0,06 $ avant les autres frais. Réduire uniquement l'entrée à 5 000 jetons ramène cet exemple à environ 0,04 $, soit une réduction de 33 %. Réduire l'entrée et la sortie de moitié ramène le coût à environ 0,03 $, soit une réduction de 50 %. Ces prix peuvent changer ; traitez donc ce calcul comme une méthode, et non comme un devis permanent. Consultez la page officielle du modèle GPT-5.6 Sol pour connaître les tarifs actuels.
Référence rapide : les quatre actions à plus forte valeur ajoutée
| Technique | Meilleure adéquation | Risque principal | À mesurer |
|---|
| Audit des jetons | Toute charge de travail de production | Optimiser le mauvais composant | Entrée, entrée mise en cache, sortie, tentatives, coût par tâche réussie |
| Suppression de la redondance | Prompts système longs, politiques répétées, exemples verbeux | Supprimer une contrainte qui compte réellement | Succès de la tâche et parité de suivi des instructions |
| Mise en page favorable au cache | Requêtes répétées partageant des instructions ou un contexte stables | Faible réutilisation du cache car le texte dynamique apparaît trop tôt | Ratio de jetons mis en cache et latence |
| Contrôles de sortie structurée | Extraction JSON, classification, formats de réponse fixes | Schéma trop rigide pour la tâche | Jetons de sortie, échecs d'analyse, tentatives |
Étape 1 : Mesurer la référence réelle des jetons avant de modifier les prompts
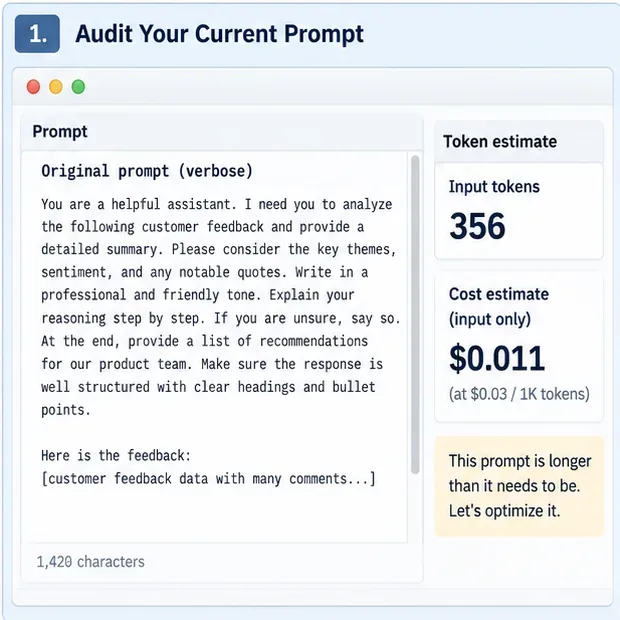
Légende : Une interface d'audit de jetons illustrative enregistre la taille du prompt original et une estimation de coût d'échantillon avant la compression ; les chiffres ne reflètent pas les tarifs actuels du fournisseur.
Collectez un échantillon représentatif de requêtes de production plutôt que d'optimiser un seul prompt choisi à la main. Enregistrez au minimum les jetons d'entrée, les jetons d'entrée mis en cache lorsqu'ils sont disponibles, les jetons de sortie, le nom du modèle, la latence, les tentatives et si la réponse finale a passé votre contrôle de qualité métier. Si votre fournisseur propose un point de terminaison de comptage des jetons d'entrée, utilisez-le avant d'envoyer les requêtes lorsque vous avez besoin d'une budgétisation déterministe. OpenAI documente actuellement un point de terminaison de comptage des jetons d'entrée des Réponses dans sa référence API officielle.
Calculez le coût par tâche réussie, et non seulement le coût par appel API. Un prompt compressé qui provoque plus de tentatives peut être plus coûteux même si chaque requête est plus courte. Segmentez également la référence par type de tâche : la synthèse, l'extraction, la réponse aux questions RAG, l'utilisation d'outils agentiques et les longues conversations ont généralement des profils de jetons différents.
Étape 2 : Supprimer la redondance sans supprimer les informations critiques pour la décision

Légende : Un prompt avant/après illustratif conserve les mêmes sorties demandées tout en supprimant les formulations répétées et les instructions de processus inutiles.
La première passe de compression la plus sûre est la déduplication sémantique. Supprimez les descriptions de rôle répétées, les contraintes dupliquées, les remplissages polis, les explications de formats évidents et les exemples qui enseignent le même modèle plus d'une fois. Fusionnez les règles qui se chevauchent en une seule instruction. Préférez une phrase précise à plusieurs phrases qui reformulent la même exigence.
Avant
Vous êtes un assistant utile qui est un expert en analyse de produits.
J'ai besoin que vous analysiez le retour client suivant et fournissiez
un résumé détaillé. Veuillez identifier les thèmes clés, le sentiment
général, les citations notables et les recommandations pour notre équipe
produit. Assurez-vous que votre réponse est professionnelle, claire,
concise et bien structurée.
Après
Analysez le retour client.
Retournez : thèmes clés, sentiment général, citations notables et
recommandations produit.
Soyez concis et factuel.
Ne compressez pas les exceptions, les limites de politique, les définitions de domaine, les règles de sécurité des outils ou les exigences de preuve simplement parce qu'ils sont longs. Ce sont souvent des jetons de haute valeur. Un test utile consiste à demander : « Si je supprime cette phrase, la sortie acceptable peut-elle changer ? » Si oui, conservez-la, sauf si un contrôle API ou un schéma peut appliquer le même comportement de manière plus fiable.
Étape 3 : Mettre le contenu stable en premier et le contenu dynamique en dernier
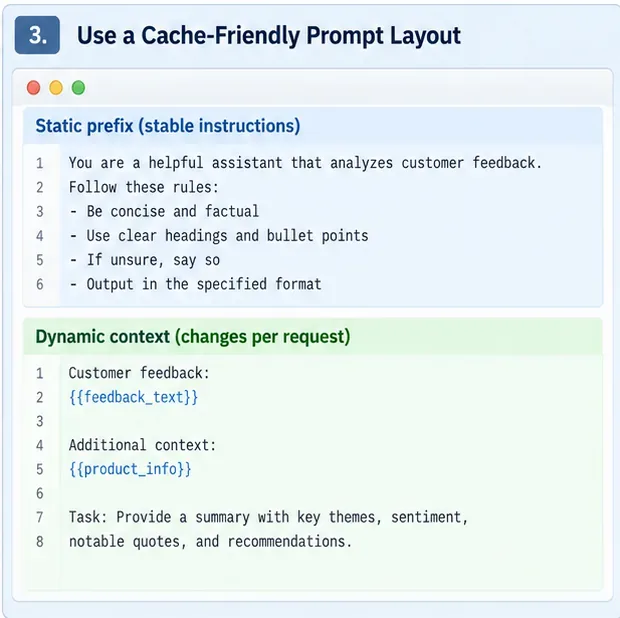
Légende : Une mise en page de prompt illustrative place les instructions stables dans un préfixe réutilisable et ajoute le contexte spécifique à la requête plus tard.
La mise en cache des prompts ne réduit pas le nombre brut de jetons, mais elle peut réduire le montant facturé au taux d'entrée normal et diminuer la latence de traitement du prompt. Cela fait de la mise en page du prompt une partie de l'optimisation des coûts. Regroupez les instructions système, les exemples partagés, les conseils sur les outils et les autres contenus stables ensemble. Placez les faits spécifiques à la requête, les passages récupérés, les données utilisateur et la question actuelle plus tard.
Les directives de modèle d'OpenAI recommandent explicitement de mettre le contenu statique en premier et le contenu dynamique en dernier pour améliorer la réutilisation du cache de prompts, et son objet d'utilisation de réponse expose les informations sur les jetons mis en cache pour la mesure. Consultez les directives officielles du modèle et la référence de l'API Responses.
Évitez de modifier les espaces blancs inoffensifs, l'ordre des exemples, les horodatages, les ID aléatoires ou le texte par utilisateur à l'intérieur d'un préfixe autrement réutilisable, sauf si la sémantique du cache du fournisseur indique que ces modifications sont sûres. Mesurez les hits de cache à partir de la réponse API au lieu de supposer qu'un prompt est réutilisé.
Étape 4 : Remplacer les descriptions de format par des contrôles de sortie structurée
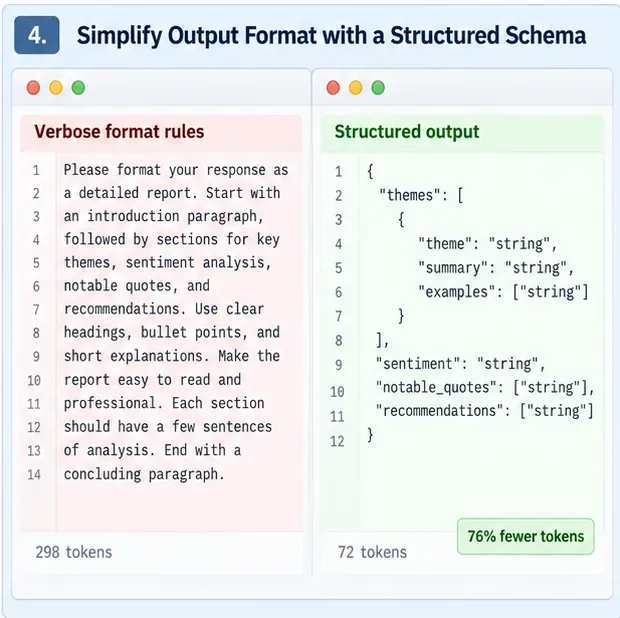
Légende : Une vue de sortie structurée illustrative montre comment un schéma peut remplacer de nombreuses lignes de prose qui décrivent à plusieurs reprises la même forme de réponse.
Les prompts d'extraction et de classification gaspillent souvent des jetons en décrivant les champs JSON, les valeurs autorisées, l'imbrication, l'ordre et les règles de validation en langage naturel. Lorsque l'API prend en charge les sorties structurées ou les arguments d'outils typés, déplacez autant de ce contrat que possible dans l'interface structurée et concentrez l'instruction en langage naturel sur le sens.
Les directives actuelles d'OpenAI recommandent spécifiquement de supprimer les définitions de schéma de sortie du prompt lorsque c'est possible et d'utiliser plutôt les Sorties Structurées. Cela peut réduire le texte du prompt et également réduire les tentatives dues à des sorties mal formées. Le mécanisme exact varie selon le fournisseur ; ne copiez donc pas un format de requête spécifique à OpenAI dans une autre API sans vérifier la documentation de ce fournisseur.
Compression avancée pour RAG, documents longs et conversations
Une fois les quatre étapes de base stables, les économies plus importantes proviennent généralement de la réduction du contexte plutôt que de l'affinage de la formulation des phrases. Dans les systèmes RAG, récupérez moins de passages mais plus pertinents, dédupliquez les chunks quasi identiques et évitez de joindre des documents qui ne peuvent pas affecter la réponse. Pour les longues conversations, conservez les faits durables et les décisions non résolues, mais résumez ou supprimez les tours qui n'influencent plus la tâche actuelle. Pour les systèmes agentiques, exposez uniquement les outils et les descriptions d'outils pertinents pour l'étape actuelle lorsque votre architecture le permet en toute sécurité.
Les compresseurs de prompts appris sont une autre option pour les contextes très longs. Le projet open source de Microsoft, LLMLingua, implémente la compression de prompts au niveau des jetons. L'article original LLMLingua a signalé des ratios de compression allant jusqu'à 20× avec une dégradation limitée des benchmarks dans ses paramètres évalués. LongLLMLingua cible les tâches à long contexte, tandis que LLMLingua-2 utilise un compresseur appris indépendant de la tâche. Ce sont des résultats de recherche, et non une promesse que les mêmes ratios préserveront la qualité sur vos données. Effectuez des tests de référence sur vos propres tâches, langues, modèles et types de prompts avant de déployer une compression agressive.
Comment prouver que l'optimisation est réellement meilleure
Exécutez une évaluation A/B sur les mêmes requêtes représentatives. Les versions de référence et compressées doivent utiliser le même modèle, les paramètres de raisonnement, les outils, les entrées de récupération et les critères de succès. Changez une technique de compression à la fois lorsque c'est possible afin d'identifier ce qui a causé une régression.
| Métrique | Pourquoi c'est important | Interprétation suggérée |
|---|
| Réduction des jetons d'entrée | Montre la réduction brute du prompt | Utile, mais pas suffisante à elle seule |
| Ratio de jetons mis en cache | Montre si les préfixes stables sont réutilisés | Plus élevé est généralement mieux lorsque la qualité est inchangée |
| Réduction des jetons de sortie | Peut changer matériellement le coût total | Vérifiez que la sortie concise complète toujours la tâche |
| Coût par tâche réussie | Inclut les tentatives et les échecs | C'est la métrique métier principale |
| Succès de la tâche / précision | Détecte la perte d'informations | Définissez un seuil de non-infériorité acceptable avant les tests |
| Latence p50 et p95 | Montre l'impact réel sur l'utilisateur | Le prétraitement de la compression peut compenser les gains d'inférence |
Ne déclarez pas victoire parce qu'un prompt est 50 % plus court. La condition d'acceptation plus forte est : la configuration compressée réduit le coût mesuré d'environ votre montant cible tout en restant dans vos tolérances prédéfinies de qualité, de latence et de fiabilité.
Quand devez-vous arrêter de compresser ?
Arrêtez ou revenez en arrière lorsque la réduction suivante supprime des faits nécessaires à des décisions correctes, augmente les hallucinations, provoque des erreurs d'appel d'outils, affaiblit la conformité aux politiques ou augmente les tentatives au point d'effacer les économies. La compression peut également ajouter de la latence si vous exécutez un modèle séparé pour compresser chaque prompt. Une étude de 2026 sur la compression de prompts dans des paramètres d'inférence réels a découvert que la surcharge de prétraitement peut annuler les gains d'inférence en dehors des régimes favorables de longueur de prompt et de matériel, ce qui est une autre raison de mesurer les performances de bout en bout plutôt que le seul nombre de jetons.
Pour les petits prompts, le nettoyage manuel et l'organisation favorable au cache sont généralement plus faciles à justifier que l'ajout d'un modèle de compression dédié. Pour les charges utiles RAG volumineuses ou les flux de travail multi-documents, la sélection de contexte et la compression apprise deviennent plus attrayantes car le volume de jetons supprimables est beaucoup plus important.
Liste de contrôle rapide de mise en œuvre
- Capturez une référence de production avec entrée, entrée mise en cache, sortie, latence, tentatives et succès de la tâche.
- Supprimez d'abord les instructions dupliquées, la prose de faible valeur et les exemples redondants.
- Préservez les définitions de domaine, les exceptions, les exigences de preuve et les contraintes de sécurité.
- Placez le contenu stable du prompt avant le contenu dynamique spécifique à la requête lorsque la sémantique du cache récompense les préfixes réutilisables.
- Utilisez des sorties structurées ou des schémas d'outils au lieu de décrire à plusieurs reprises des formats de réponse fixes en prose.
- Pour RAG, réduisez le contexte non pertinent et dupliqué avant d'essayer la compression au niveau des jetons.
- Limitez la longueur de sortie uniquement lorsque la tâche peut encore être complétée correctement.
- Comparez le coût par tâche réussie, et non seulement le nombre de jetons du prompt.
- Exécutez des tests de régression avant et après chaque changement de compression significatif.
- Vérifiez à nouveau les prix du fournisseur et les règles de cache chaque fois que vous changez de modèles ou de versions d'API.
En résumé
Une réduction de 50 % est un objectif d'ingénierie raisonnable pour certaines charges de travail verbeuses et lourdes en contexte, mais elle doit être traitée comme un résultat à valider, et non comme une attente par défaut. Le chemin le plus fiable consiste à mesurer d'abord, supprimer le texte sémantiquement redondant, maximiser la réutilisation sûre du cache, raccourcir les contrats de sortie avec des contrôles structurés, puis attaquer les plus grands blocs de contexte restants avec l'élagage de récupération, la synthèse ou un compresseur de prompts testé. Si le coût final par tâche réussie diminue tout en maintenant la qualité dans votre bande d'acceptation, la compression fonctionne. Si la qualité ou les tentatives se détériorent, restaurez les informations manquantes et optimisez une autre partie de la requête.
Références principales








