Accueil
» Domaines
»
Comment créer un pipeline gratuit de recyclage de contenu IA avec n8n et Claude (ce qui est réellement gratuit)
Comment créer un pipeline gratuit de recyclage de contenu IA avec n8n et Claude (ce qui est réellement gratuit)
Vous pouvez rendre la couche d'automatisation d'un pipeline de recyclage de contenu IA gratuite en auto-hébergeant l'édition communautaire de n8n, mais un workflow n8n alimenté par Claude n'est pas garanti d'être sans coût de bout en bout. Cette distinction est importante. n8n indique que son édition communautaire auto-hébergée peut être utilisée gratuitement indéfiniment, tandis que l'API Claude d'Anthropic est un service de développement facturé à l'usage. Le plan de chat Claude gratuit sur le site web de Claude n'est pas la même chose que l'utilisation de l'API dans n8n.
En date du 11 septembre 2026, n8n documente l'édition communautaire comme une édition auto-hébergée gratuite avec presque l'ensemble complet des fonctionnalités principales. La tarification API actuelle d'Anthropic liste Claude Sonnet 5 à 2 $ par million de tokens d'entrée et 10 $ par million de tokens de sortie, et Claude Haiku 4.5 à 1 $ par million de tokens d'entrée et 5 $ par million de tokens de sortie. Les prix et les modèles peuvent changer, alors vérifiez-les avant le déploiement. Consultez la documentation de l'édition communautaire de n8n et la page de tarification actuelle d'Anthropic.
La version pratique de « gratuit » est donc : logiciel n8n gratuit sur une infrastructure que vous contrôlez, plus toute utilisation de l'API Claude générée par votre workflow. Si vous disposez déjà d'une infrastructure et de crédits API, votre coût incrémental peut être temporairement nul. Sinon, attendez-vous à au moins un coût d'utilisation du modèle et éventuellement un coût d'hébergement.
Ce que fera ce pipeline
Le workflow ci-dessous prend un élément source—tel qu'un article de blog, un brouillon de newsletter, une transcription de podcast, une transcription de webinaire ou une note longue—et le transforme en plusieurs brouillons d'actifs structurés. Une sortie de démarrage utile est :
Un article de type LinkedIn
Trois publications sociales courtes
Un objet d'e-mail et une introduction
Un accroche vidéo courte et un script
Cinq points clés
Un drapeau de revue lorsque la source ne contient pas assez d'informations
Le pipeline produit intentionnellement des brouillons en premier. La publication automatique peut être ajoutée plus tard, mais il est généralement plus sûr de prouver la qualité du contenu, le formatage, la fidélité à la source et les permissions de destination avant de permettre à un workflow IA de publier sans revue.
Cette approche vous convient-elle ?
Situation
Recommandation
Pourquoi
Vous recyclez vos propres articles ou le contenu approuvé de l'entreprise
Bon choix
La source est contrôlée et l'objectif de transformation est prévisible.
Vous avez besoin de brouillons cohérents pour plusieurs canaux
Bon choix
n8n peut orchestrer la même transformation de manière répétée.
Vous voulez une API Claude définitivement sans coût
Ne convient pas tel quel
L'utilisation de l'API Claude est facturée à l'usage ; le plan de chat Claude gratuit ne rend pas l'automatisation API gratuite.
Vous avez besoin d'ajouter une recherche factuelle en direct à chaque brouillon
Utilisez une étape de recherche/vérification séparée
Le recyclage ne doit pas silencieusement se transformer en génération de faits.
Vous traitez des pages web non fiables ou des documents tiers
Ajoutez une isolation d'entrée plus forte et une revue
Le contenu externe peut contenir des instructions qui ne doivent pas contrôler le workflow.
Vous avez besoin d'une sélection complexe d'outils et de décisions autonomes
Envisagez un Agent IA
Une chaîne LLM de base est plus simple lorsque la tâche est une transformation de texte prévisible.
L'architecture recommandée
Pour une première version, ne commencez pas par un agent autonome. La Chaîne LLM de base de n8n est conçue pour transmettre une invite à un modèle de langage connecté et peut attacher un analyseur de sortie. Cela suffit pour un workflow déterministe « source en entrée, brouillons formatés en sortie ». Consultez la documentation de la Chaîne LLM de base de n8n.
Un pipeline propre ressemble à ceci :
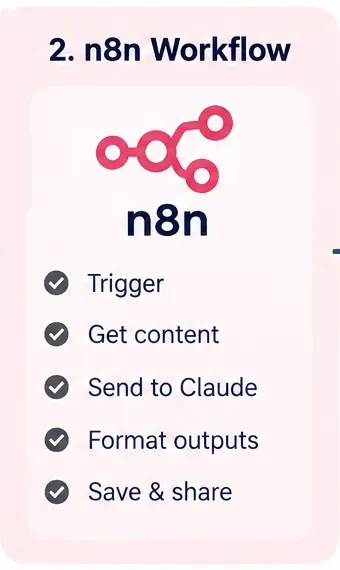
Déclencheur → Valider l'entrée → Normaliser la source → Chaîne LLM de base → Modèle de chat Anthropic → Analyseur de sortie structurée → Étape de revue → Sauvegarder les brouillons
Étape 1 : Auto-hébergez l'édition communautaire de n8n
Illustration générée par IA d'une étape de workflow n8n ; ce n'est pas une capture d'écran réelle de n8n.
La documentation actuelle de n8n prend en charge l'auto-hébergement avec Docker et décrit l'édition communautaire comme gratuite. Docker est un bon point de départ car il rend l'instance n8n facile à reproduire et vous donne un volume persistant pour les données de workflow et d'identifiants.
Le guide Docker officiel crée un volume n8n_data, expose le port 5678, définit des variables d'environnement liées au fuseau horaire et monte le répertoire de données persistant. Pour n8n 2.x, la documentation note que N8N_RUNNERS_ENABLED est obsolète et n'a plus besoin d'être défini. Utilisez la commande actuelle du guide d'installation Docker de n8n plutôt que de copier une ancienne commande d'un tutoriel.
Pour une preuve de concept locale, ouvrir http://localhost:5678 suffit. Pour une instance de production exposée sur Internet, n'exposez pas simplement le port local publiquement. Suivez les directives d'hébergement et de sécurité de n8n pour HTTPS, l'authentification, les sauvegardes et la configuration du proxy inverse.
Utilisez cette étape si : vous êtes à l'aise avec la maintenance de votre propre hôte Docker. Si vous ne voulez pas patcher, sécuriser, sauvegarder et surveiller un serveur, n8n Cloud est plus facile, mais ce n'est pas l'option définitivement gratuite décrite ici.
Étape 2 : Choisissez comment le workflow démarre
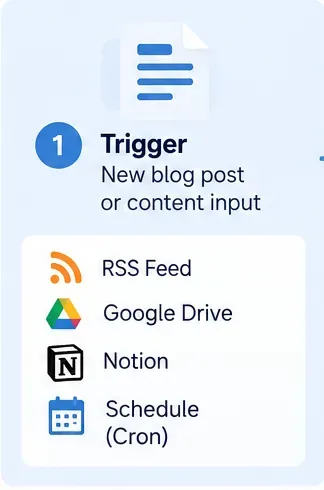
Illustration générée par IA des déclencheurs de workflow et sources de contenu possibles ; la disponibilité et la configuration réelles des nœuds n8n doivent être vérifiées dans votre instance.
Utilisez un Webhook lorsqu'une autre application doit envoyer du contenu à n8n à la demande. Utilisez un Déclencheur de planification lorsque n8n doit vérifier le contenu à une heure ou un intervalle fixe.
Le nœud Webhook de n8n fournit des URL de test et de production distinctes. L'URL de test est conçue pour le développement ; l'URL de production est enregistrée lorsque le workflow est publié. Le nœud Webhook prend également en charge les options d'authentification, y compris l'authentification Basic, l'authentification par en-tête et l'authentification JWT. Consultez la documentation du Webhook de n8n.
Pour le recyclage planifié, le Déclencheur de planification de n8n s'exécute à des heures ou des intervalles fixes, et n8n indique que le workflow doit être sauvegardé et publié pour le déclenchement planifié. Consultez la documentation du Déclencheur de planification de n8n.
Exemple : si votre CMS peut appeler un webhook après qu'un éditeur a approuvé un article, utilisez le webhook. Si vous conservez le contenu source approuvé dans un dossier et souhaitez un lot chaque matin de semaine, une planification peut être plus simple.
Étape 3 : Définissez un contrat d'entrée propre
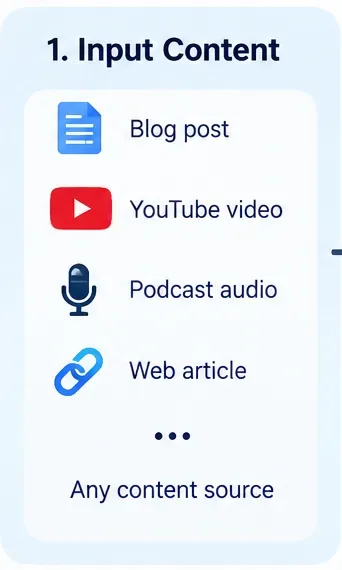
Illustration générée par IA des types de contenu source qui peuvent alimenter un workflow de recyclage ; elle ne représente pas un écran n8n réel.
Ne laissez pas chaque source arriver sous une forme différente. Normalisez les entrées en une seule structure interne avant d'appeler Claude. Une charge utile JSON pratique est :
{
  "source_id": "post-2026-0911-001",
  "title": "Titre de l'article original",
  "source_text": "Texte source approuvé complet...",
  "source_url": "https://example.com/original",
  "audience": "Propriétaires de petites entreprises aux États-Unis",
  "brand_voice": "clair, pratique, sans hype",
  "outputs": [
    "linkedin_post",
    "short_posts",
    "email_intro",
    "video_script"
  ]
}
Passez le texte source réel chaque fois que c'est pratique. Une URL seule n'est pas la même chose que du contenu source vérifié. Récupérer et analyser une page ajoute un autre point de défaillance et peut introduire de la navigation, des cookies, de la publicité ou du texte non lié dans l'invite.
Gardez également les instructions séparées du matériel source. Si vous ingérez des pages tierces, des e-mails ou des documents téléchargés, traitez leur contenu comme des données non fiables plutôt que comme des commandes de workflow. Les directives de sécurité d'Anthropic décrivent explicitement l'injection d'invite indirecte comme des instructions malveillantes intégrées dans le contenu que le modèle lit. Consultez les directives d'atténuation de l'injection d'invite d'Anthropic.
Étape 4 : Validez et normalisez avant l'appel au modèle
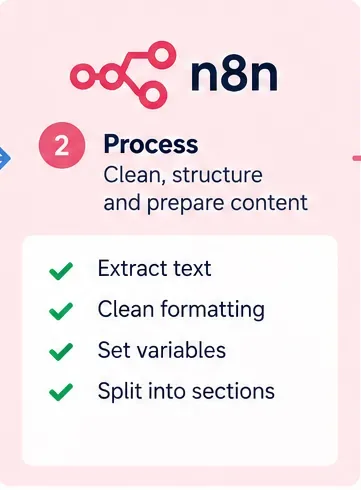
Illustration générée par IA d'une étape de prétraitement ; ce n'est pas une capture d'écran réelle d'un workflow n8n.
Avant de dépenser des tokens, rejetez les mauvaises entrées. Au minimum, vérifiez que source_id, title et source_text existent et que source_text n'est pas vide. Normalisez le bruit de formatage évident, mais préservez les faits, les citations, les URL, les titres et les autres détails de la source dont Claude pourrait avoir besoin.
Une étape de prétraitement utile peut :
Supprimer les espaces blancs de début et de fin
Convertir les lignes vides répétées en un format cohérent
Définir des valeurs par défaut pour l'audience et la voix
Rejeter le texte source en dessous d'une longueur utile minimale
Créer un source_id stable pour la déduplication
Enregistrer les types de sortie demandés
Ne divisez pas un article normal en plusieurs appels de modèle à moins que vous n'en ayez réellement besoin. Plusieurs appels augmentent la complexité de l'orchestration et peuvent produire un ton incohérent. Pour un matériel source volumineux, envisagez de résumer ou de découper délibérément plutôt que de tronquer accidentellement l'entrée.
Étape 5 : Connectez Claude correctement—et comprenez le coût
Illustration générée par IA du rôle de Claude dans le workflow ; ce n'est pas une capture d'écran de la Console Anthropic ou de n8n.
n8n fournit un nœud Modèle de chat Anthropic et des identifiants Anthropic qui utilisent une clé API. La documentation des identifiants de n8n dirige les utilisateurs vers la création d'une clé dans la Console Anthropic et son stockage dans l'identifiant n8n plutôt que de la coder en dur dans le texte du workflow. Consultez la documentation des identifiants Anthropic de n8n et la documentation du Modèle de chat Anthropic de n8n.
Pour ce pipeline, connectez le Modèle de chat Anthropic à une Chaîne LLM de base. Un choix de modèle pratique dépend de votre objectif de qualité et de coût :
Choix de modèle
Quand cela a du sens
Tarification API actuelle vérifiée le 11 sept. 2026
Claude Haiku 4.5
Réécritures simples à haut volume et premiers brouillons
1 $/MTok entrée ; 5 $/MTok sortie
Claude Sonnet 5
Par défaut plus fort pour le recyclage multi-format nuancé
2 $/MTok entrée ; 10 $/MTok sortie
Claude Opus 5
Uniquement lorsque la tâche nécessite réellement un raisonnement plus profond
5 $/MTok entrée ; 25 $/MTok sortie
Les prix ci-dessus proviennent de la page de tarification actuelle d'Anthropic et peuvent changer. Évitez également de copier d'anciens identifiants de modèles à partir de tutoriels plus anciens. Anthropic maintient une page de dépréciation des modèles car les modèles sont périodiquement dépréciés et retirés. Vérifiez la documentation de dépréciation des modèles d'Anthropic avant de coder en dur un nom de modèle.
Étape 6 : Utilisez une invite qui préserve la fidélité à la source
Illustration générée par IA de la génération de contenu multi-format ; les sorties listées sont des exemples, pas des fonctionnalités produit garanties.
L'invite doit rendre la limite de transformation explicite : Claude peut reformuler et compresser la source, mais ne doit pas inventer des faits qui ne sont pas présents. Les directives actuelles d'Anthropic sur l'ingénierie des invites recommandent des instructions claires et des balises structurées pour les entrées complexes. Consultez la documentation des meilleures pratiques d'Anthropic sur les invites.
Un message système pratique est :
Vous êtes un éditeur de recyclage de contenu.
Utilisez uniquement les affirmations factuelles soutenues par la source fournie.
N'inventez pas de statistiques, de citations, de résultats clients, de dates ou de capacités de produit.
Préservez le sens original tout en adaptant le format et le ton.
Si une sortie nécessite des informations non présentes dans la source, définissez needs_review sur true
et expliquez les informations manquantes dans review_notes.
Renvoyez uniquement les champs structurés demandés.
Ensuite, construisez le message utilisateur à partir des expressions n8n :
Exemple : si la source indique qu'un produit a été lancé en mai mais ne donne jamais de chiffres clients, Claude peut transformer le fait de lancement en un article plus court, mais ne doit pas ajouter « 10 000 clients » pour rendre l'article plus fort.
Étape 7 : Forcez une sortie structurée au lieu d'analyser de la prose
Illustration générée par IA des sorties de contenu structurées ; ce n'est pas une capture d'écran de la réponse de l'API Claude.
Le texte libre est difficile à router. Si Claude renvoie des titres qui changent d'une exécution à l'autre, les nœuds en aval deviennent fragiles. L'Analyseur de sortie structurée de n8n peut renvoyer des champs basés sur un schéma JSON, et la Chaîne LLM de base peut exiger un format de sortie spécifique. Consultez la documentation de l'Analyseur de sortie structurée de n8n.
Si vous choisissez d'appeler directement l'API Messages Claude avec le nœud Requête HTTP de n8n au lieu d'utiliser l'intégration du Modèle de chat Anthropic, Anthropic prend également en charge les sorties structurées natives via output_config.format sur les modèles pris en charge. Consultez la documentation des Sorties structurées d'Anthropic et la référence de l'API Messages Claude.
Étape 8 : Sauvegardez les brouillons, revoyez-les, puis automatisez la publication
Illustration générée par IA des destinations de brouillons ; ce n'est pas une capture d'écran d'une intégration en direct ni la preuve qu'un compte est connecté.
Pour la première version de production, stockez les champs générés dans un emplacement de revue plutôt que de les envoyer directement aux canaux publics. Les destinations courantes incluent une base de données, Google Drive, Google Sheets, Notion, un brouillon CMS ou un message de revue interne.
Utilisez needs_review comme une étape bloquante stricte. Envisagez également une étape de revue humaine pour tout ce qui envoie un message externe ou modifie un système de production. n8n prend actuellement en charge l'approbation humaine dans la boucle pour les appels d'outils IA, où un réviseur peut approuver ou refuser les actions sélectionnées. Consultez la documentation de n8n sur l'humain dans la boucle.
Déploiement recommandé :
Semaine 1 : générez uniquement des brouillons.
Semaine 2 : comparez les sorties avec la source et corrigez les échecs d'invite/schéma.
Semaine 3 : permettez aux brouillons approuvés de se déplacer automatiquement vers les dossiers de brouillons de destination.
Uniquement après que le workflow est stable : envisagez la publication automatique pour les formats à faible risque.
Un workflow n8n concret de bout en bout
Pour une version simple pilotée par webhook, créez ces nœuds dans l'ordre :
#
Nœud
Objectif
1
Webhook
Recevoir l'élément source approuvé.
2
Modifier les champs / Code
Normaliser les noms de champs et les valeurs par défaut.
3
Si
Rejeter le texte source manquant ou vide.
4
Chaîne LLM de base
Contenir les instructions de recyclage et le contenu source dynamique.
5
Modèle de chat Anthropic
Générer les brouillons recyclés.
6
Analyseur de sortie structurée
Imposer des champs JSON stables.
7
Si
Router needs_review=true vers une revue manuelle.
8
Nœud de destination
Sauvegarder la sortie approuvée comme brouillons.
9
Répondre au Webhook
Renvoyer le statut et l'ID d'enregistrement généré à l'appelant.
Si vous préférez un pipeline planifié, remplacez le Webhook par un Déclencheur de planification et ajoutez un nœud source qui récupère les éléments approuvés non traités.
Comment éviter de recycler la même source deux fois
Ajoutez un source_id immuable à chaque élément et stockez les ID traités. Avant que Claude ne s'exécute, vérifiez si cet ID a déjà été complété avec succès. C'est l'idempotence de base : répéter le même déclencheur ne doit pas créer de brouillons en double à moins que vous ne demandiez explicitement une nouvelle version.
Pour les révisions, utilisez une clé composée telle que source_id + source_revision. Cela permet à la version 2 d'un article de générer de nouveaux brouillons sans prétendre qu'il s'agit de la même source que la version 1.
Comment réduire le coût de l'API Claude
Le choix du modèle n'est qu'un levier. Le plus grand coût évitable est souvent l'envoi de texte inutile ou la génération de sorties inutilement longues.
Supprimez la navigation, le texte standard et le HTML non lié avant l'appel au modèle.
Ne demandez que les formats dont vous avez réellement besoin.
Définissez des contraintes de longueur de sortie raisonnables dans l'invite.
Utilisez Haiku 4.5 pour les transformations simples à haut volume lorsque la qualité est suffisante.
Utilisez Sonnet 5 lorsque la source nécessite plus de nuance ou une adaptation inter-format plus forte.
N'envoyez pas le même long guide de marque à chaque appel si vous pouvez le représenter par des instructions stables concises.
Mesurez l'utilisation des tokens et le coût plutôt que de supposer qu'un workflow court est bon marché.
Anthropic propose également la mise en cache des invites et le traitement par lots pour les charges de travail applicables, mais ces fonctionnalités ont leurs propres exigences et tarifications. Ne les ajoutez pas au premier workflow à moins que le contexte répété ou le traitement à haut volume non urgent ne rende la complexité supplémentaire worthwhile.
Trois modes de défaillance à tester avant la publication
1. Faits hallucinés
Nourrissez le workflow avec une source qui omet intentionnellement une statistique. Le comportement attendu est que la sortie n'en invente pas une. Si elle le fait, renforcez les instructions de fidélité à la source et l'étape de revue.
2. Sortie structurée cassée
Testez chaque champ requis, les tableaux vides, le texte source anormalement long et les caractères spéciaux. Un pipeline n'est pas fiable simplement parce qu'une sortie de démo attrayante semblait correcte.
3. Exécutions en double
Envoyez le même source_id deux fois. La deuxième exécution doit s'arrêter, mettre à jour l'enregistrement existant ou créer intentionnellement une révision selon votre conception—pas silencieusement dupliquer chaque brouillon.
Avez-vous besoin d'un Agent IA pour cela ?
Généralement, non. Un Agent IA est utile lorsque le modèle doit décider quels outils appeler ou prendre des actions différentes en fonction d'un objectif ouvert. Le recyclage de contenu est normalement une transformation prévisible, donc une chaîne est plus facile à inspecter, tester et contrôler.
Passez à un agent uniquement lorsque vous avez un besoin concret tel que choisir dynamiquement des outils de recherche, décider quelle destination reçoit un brouillon, ou demander à un humain des informations manquantes. Même dans ce cas, gardez les actions de publication irréversibles derrière une revue explicite jusqu'à ce que le workflow soit bien testé.
Liste de contrôle finale de construction
Auto-hébergez l'édition communautaire de n8n si vous voulez que la couche logicielle n8n reste gratuite.
Ne décrivez pas l'utilisation de l'API Claude comme définitivement gratuite.
Utilisez un Webhook pour le traitement à la demande ou un Déclencheur de planification pour les lots temporisés.
Normalisez chaque source en un seul contrat d'entrée.
Passez le texte source, pas seulement une URL.
Stockez la clé API Anthropic dans les identifiants n8n.
Utilisez un modèle Claude actif et vérifiez la page de dépréciation périodiquement.
Utilisez une Chaîne LLM de base pour un recyclage prévisible.
Exigez un schéma de sortie structurée.
Ajoutez needs_review et des notes de revue au schéma.
Dédupliquez avec un ID de source stable.
Sauvegardez les brouillons avant d'activer la publication automatique.
Testez les hallucinations, les entrées malformées, les déclencheurs en double et les chemins d'échec.
Surveillez l'utilisation des tokens et les coûts des services externes.
La meilleure première version est délibérément ennuyeuse : une entrée propre, un appel Claude contrôlé, une réponse JSON validée et une destination de brouillon. Cette architecture est facile à déboguer et peu coûteuse à exploiter. Une fois qu'elle fonctionne de manière fiable sur du matériel source réel, vous pouvez ajouter plus de canaux, de planification, d'approbations humaines, d'analyses ou d'intégrations de publication sans reconstruire le pipeline central.