Accueil
» Domaines
»
Comment corriger l'erreur « Délai d'attente de l'API » lors de l'exécution de flux de travail multi-agents ?
Comment corriger l'erreur « Délai d'attente de l'API » lors de l'exécution de flux de travail multi-agents ?
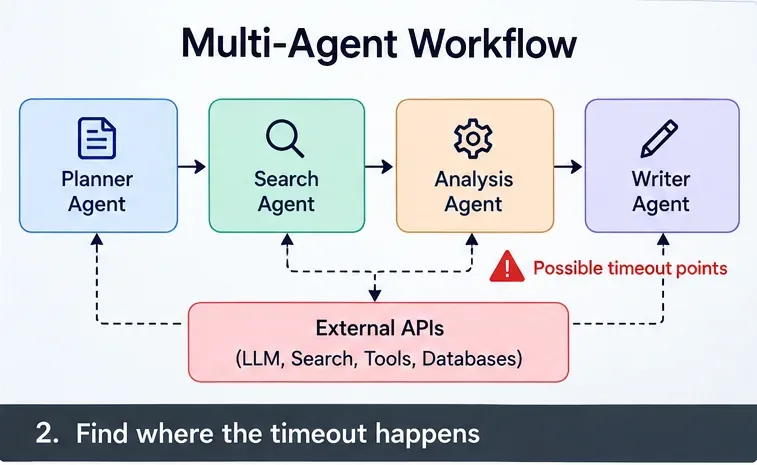
Dans un flux de travail multi-agents, une erreur de délai d'attente d'API est rarement résolue par la simple modification d'un paramètre. Un planificateur peut appeler trois agents, chacun pouvant solliciter une API LLM, un service de recherche, une base de données ou un outil. Chaque couche peut avoir son propre délai d'attente, sa politique de nouvelle tentative, son pool de connexions et sa limite de concurrence. La solution pratique consiste à identifier la couche qui expire en premier, puis à choisir entre des délais d'attente plus longs, une réduction du nombre d'appels simultanés, des nouvelles tentatives plus intelligentes, un chemin critique plus court ou une conception de tâche asynchrone.
Il est important de trouver un compromis : augmenter le délai d’attente est simple mais mobilise davantage de ressources ; des tentatives de relance trop fréquentes peuvent multiplier la charge et les coûts ; réduire la concurrence améliore la stabilité mais diminue le débit de pointe ; les agents parallèles ne réduisent la latence que si les services en aval peuvent absorber la charge supplémentaire. Il n’existe pas de configuration optimale unique pour tous les systèmes multi-agents.
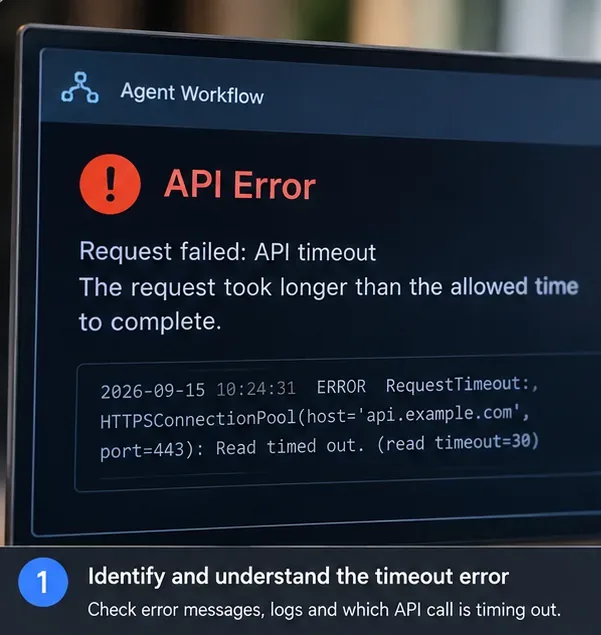
Quel délai d'attente atteignez-vous exactement ?
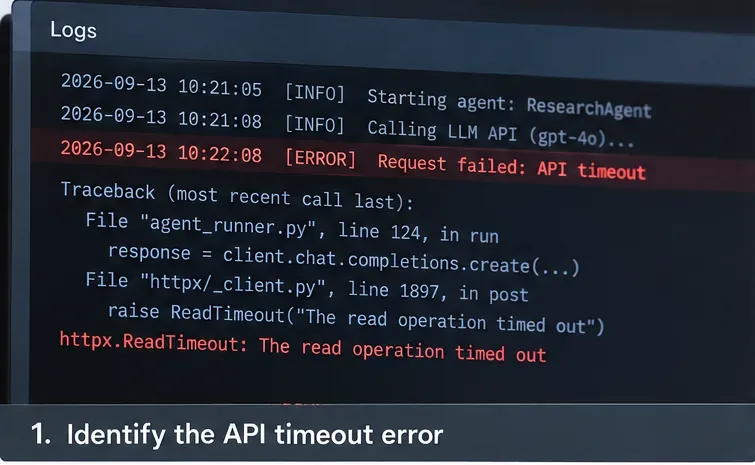
Commencez par classifier l'échec au lieu de traiter chaque délai d'attente comme un seul et même événement. Les clients HTTP peuvent expirer lors de la connexion, de la lecture, de l'écriture ou de l'attente d'une connexion depuis un pool. HTTPX, par exemple, documente quatre types de délais d'attente distincts : connexion, lecture, écriture et pool. Son comportement par défaut consiste à déclencher un délai d'attente après cinq secondes d'inactivité réseau, et non nécessairement après cinq secondes de durée totale de la requête. Consultez la documentation officielle sur les délais d'attente HTTPX .
Si vous utilisez le SDK Python d'OpenAI, sa documentation officielle indique que les requêtes sont par défaut soumises à un délai d'expiration client de 10 minutes et que les échecs de délai sont relancés deux fois par défaut. Le SDK relance également automatiquement les erreurs de connexion ainsi que les réponses HTTP 408, 409, 429 et 5xx avec un court délai exponentiel. Il s'agit des paramètres par défaut du SDK ; ils ne garantissent pas que chaque proxy, équilibreur de charge, passerelle ou orchestrateur en amont de la requête attendra 10 minutes. Consultez la documentation officielle du SDK Python d'OpenAI .
Étape 1 : capturer l’exception exacte ainsi que l’agent, le point de terminaison et la couche de transport qui ont expiré au lieu de consigner uniquement une défaillance générique du flux de travail.
Quelle solution choisir ?
Option
Meilleure adaptation
Principal avantage
Compromis principal
Augmentez le délai d'attente de la requête.
Appels de modèles/outils sains mais légitimement lents
Modifications minimales du code et de l'architecture
Les ressources de traitement et les connexions restent occupées plus longtemps ; une passerelle en amont peut toujours mettre fin à la requête en premier.
Réessayer avec un délai exponentiel
Erreurs réseau transitoires, limites de débit, erreurs 5xx sélectionnées
Se rétablit automatiquement après des pannes de courte durée.
Peut multiplier le trafic, la latence et les coûts ; dangereux pour les actions non idempotentes, sauf si elles sont conçues avec soin.
Concurrence des agents réduite
429, délais d'attente du pool, saturation en aval
Réduit les pics de consommation et les conflits de file d'attente
Débit de pointe plus faible et parfois temps d'exécution des flux de travail plus long
Paralléliser les agents indépendants
Flux de travail séquentiels avec branches indépendantes
Raccourcit le chemin critique
Augmente le nombre de requêtes simultanées et peut déclencher des limites de débit ou de connexion.
Sortie partielle du flux
Expérience utilisateur interactive où la latence du premier octet est cruciale
Les utilisateurs constatent les progrès plus rapidement.
Ne résout pas automatiquement un délai d'attente d'intégration trop long ou un service en aval surchargé.
Déplacer le travail vers une tâche/file d'attente asynchrone
Des flux de travail qui peuvent prendre des dizaines de secondes ou des minutes
Dissocie la durée de vie des requêtes HTTP de celle du flux de travail.
Nécessite la gestion de l'état des tâches, l'interrogation/les webhooks, l'idempotence, la persistance et la surveillance opérationnelle.
Étape 1 : Trouvez la première couche qui dépasse sa date limite.
Consignez un identifiant de corrélation pour le flux de travail complet et un identifiant de segment ou d'enfant pour chaque appel d'agent et d'outil. Enregistrez l'heure de début, l'heure de fin, le point de terminaison, le numéro de tentative, le type d'exception, l'état de la réponse (le cas échéant) et indiquez si l'annulation provient de l'appelant ou du service en aval.
La question essentielle est : « Qui a interrompu l'attente en premier ? » Si l'appel LLM se termine en 42 secondes, mais qu'une passerelle API abandonne au bout de 30 secondes, augmenter le délai d'expiration du client LLM de 60 à 120 secondes ne change rien. La documentation actuelle d'Amazon concernant les API HTTP d'API Gateway indique un délai d'expiration maximal d'intégration de 30 secondes, ce qui illustre bien pourquoi le délai le plus court dans la chaîne détermine souvent le résultat. Voir les quotas des API HTTP d'Amazon API Gateway .
Étape 2 : cartographiez le chemin de la requête et marquez chaque endroit susceptible de terminer ou de retarder un appel : orchestrateur, agent, passerelle, API de modèle, API de recherche, base de données et service d’outil.
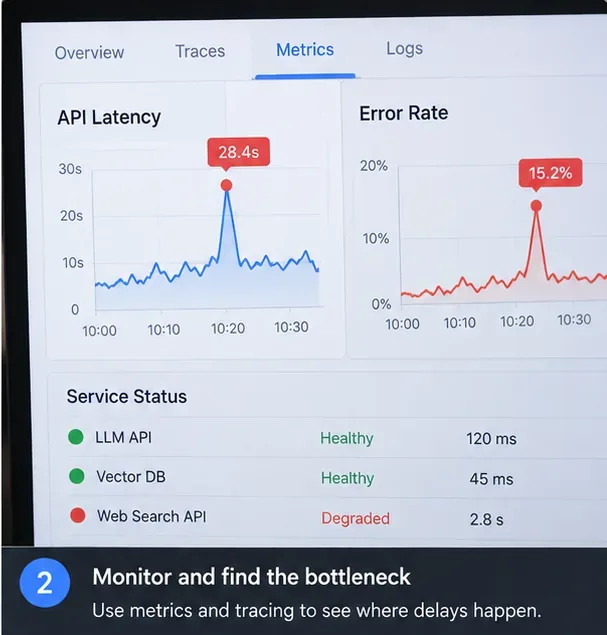
Étape 2 : Mesurer le chemin critique, et non seulement la latence moyenne
Une latence moyenne peut sembler acceptable, tandis qu'une petite quantité d'appels lents est à l'origine de la plupart des échecs de flux de travail. Il est donc essentiel de suivre au minimum le taux de réussite par dépendance, ainsi que les latences p50, p95 et p99. Lors de la distribution des requêtes, il convient également d'enregistrer le temps d'attente dans la file d'attente et le temps d'attente du pool de connexions, car une « API lente » peut en réalité correspondre à un client surchargé attendant une connexion disponible.
Utilisez les traces pour répondre à trois questions pratiques : quelle dépendance domine le chemin critique, si plusieurs agents lents s’exécutent séquentiellement alors qu’ils pourraient s’exécuter simultanément, et si les pics de concurrence correspondent aux erreurs 429, de délai d’attente du pool ou 5xx.
Étape 3 : comparer la latence, les erreurs et l’état des dépendances ; un pic de délai d’attente qui coïncide avec une dépendance dégradée suggère une solution différente de celle nécessaire pour un pic de concurrence à l’échelle du système.
Étape 3 : Établir un budget de temps de pause en partant de l’extérieur vers l’intérieur
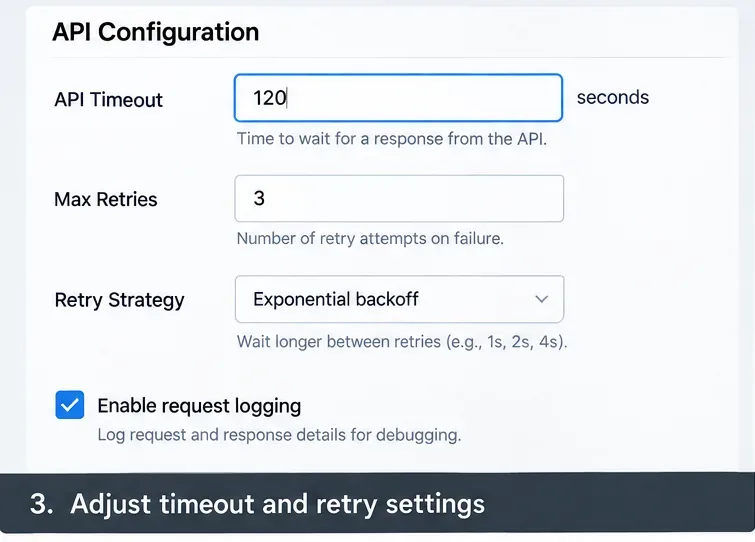
Définissez d'abord une échéance pour le flux de travail de bout en bout, puis raccourcissez les échéances intermédiaires afin que les couches inférieures échouent suffisamment tôt pour permettre à l'orchestrateur de se rétablir. Par exemple, une échéance de 120 secondes pour l'interface utilisateur pourrait réserver 10 secondes à l'orchestration et au traitement des réponses, laissant 110 secondes pour le traitement proprement dit. Un appel d'outil individuel pourrait bénéficier de 15 secondes, tandis qu'un appel de modèle pourrait bénéficier de 45 ou 60 secondes en fonction de la latence résiduelle observée.
Ne copiez pas ces valeurs aveuglément ; il s’agit d’un exemple de méthode de budgétisation, et non de valeurs par défaut universelles. Choisissez des valeurs en fonction de votre distribution de latence mesurée et de votre SLO produit. L’échéance externe doit être suffisamment longue pour inclure l’appel interne, ses tentatives autorisées, les délais d’attente et le temps de nettoyage.
Python 3.11 et versions ultérieures permettent asyncio.timeout()de définir une date limite pour les tâches asynchrones. Lorsque cette date limite est dépassée, la tâche est annulée et le gestionnaire de contexte affiche une notification TimeoutError. Consultez la documentation officielle de Python sur les délais d'expiration d'asyncio .
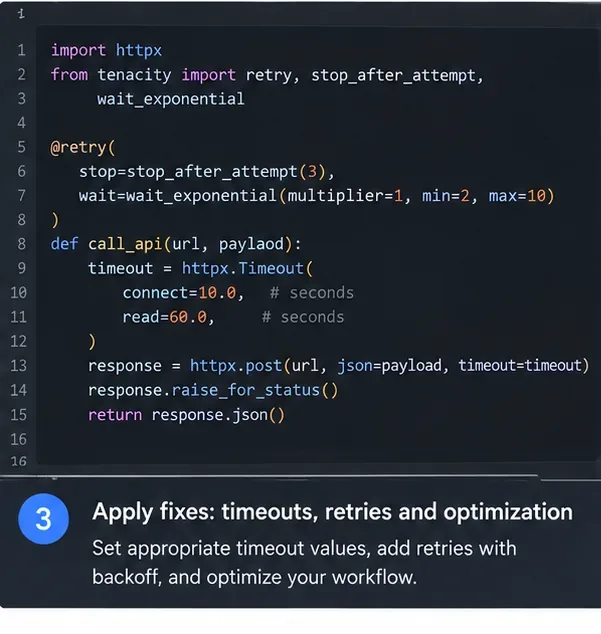
Étape 4 : configurez les valeurs de délai d’expiration et de nouvelle tentative sous forme de budget coordonné plutôt que d’augmenter chaque valeur indépendamment.
Étape 4 : Limitez la concurrence avant d’augmenter le nombre de tentatives.
Les systèmes multi-agents tombent souvent en panne car le nombre de requêtes augmente plus vite que prévu. Si 20 requêtes utilisateur lancent chacune cinq agents et que chaque agent lance deux outils, le système peut générer jusqu'à 200 appels en aval avant les nouvelles tentatives. Ajouter des nouvelles tentatives en premier lieu peut transformer la congestion en un véritable raz-de-marée de tentatives.
Limiter la concurrence est souvent la première solution à adopter face à des réponses 429, des délais d'attente de pool, une augmentation du temps d'attente ou une dépendance en aval saturée. Python asyncio.Semaphorepropose une méthode simple, basée sur un compteur, pour limiter le nombre de coroutines accédant simultanément à une section protégée. Consultez la documentation officielle sur les sémaphores Python .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
Ce compromis est délibéré : une limite inférieure protège les services en aval, mais peut augmenter la mise en file d'attente au sein de votre application. Optimisez-la en fonction du débit, de la latence p95, des limites de débit et de la capacité du pool de connexions, plutôt que de choisir la valeur maximale que votre machine peut gérer.
Étape 5 : associer une concurrence limitée à des paramètres de transport explicites afin qu’un pool de connexions complet ne se fasse pas passer pour un modèle ou un outil lent.
Étape 5 : Ne réessayez que les échecs susceptibles de réussir ultérieurement.
Les nouvelles tentatives sont utiles en cas d'échecs de connexion temporaires, de limitations de débit, d'erreurs serveur spécifiques et de délais d'attente de requête, lorsque la répétition de l'opération est sans risque. Elles constituent un mauvais comportement par défaut en cas d'erreurs de validation, d'échecs d'authentification, de bogues déterministes de l'outil ou d'actions à effets de bord sans protection contre l'idempotence.
Attention à la multiplication des tentatives de relance. Si un SDK effectue deux relances, cela représente jusqu'à trois tentatives pour un appel logique. Si votre couche agent relance également l'appel complet deux fois, le maximum théorique passe à neuf tentatives pour cette opération logique : trois tentatives externes multipliées par trois tentatives du SDK. Si l'orchestrateur relance ensuite une étape complète impliquant cinq agents, le volume de requêtes peut croître rapidement.
Centralisez la gestion des nouvelles tentatives autant que possible. Pour les appels LLM utilisant le SDK Python d'OpenAI, n'oubliez pas que le SDK actuel effectue déjà deux tentatives par défaut pour certaines classes d'échecs. N'ajoutez une nouvelle tentative externe que si vous avez une raison spécifique et que vous pouvez limiter le budget total des tentatives. citeturn212133view0turn212133view1
Étape 6 : classifier l’erreur avant de réessayer ; un délai d’attente de lecture peut justifier une nouvelle tentative limitée, alors qu’une erreur de configuration permanente ne le justifie généralement pas.
Étape 6 : Raccourcir le chemin critique sans créer de problème de dispersion
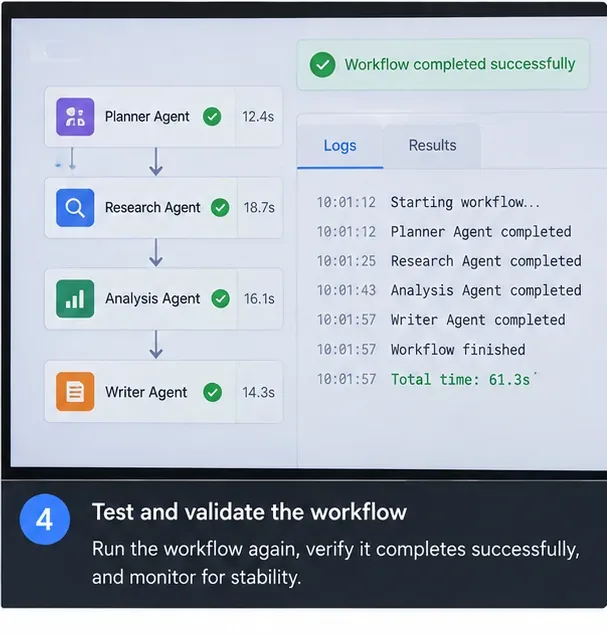
Si les agents planificateur, chercheur, évaluateur et rédacteur s'exécutent strictement l'un après l'autre, la latence totale est approximativement égale à la somme de leurs durées. Des branches indépendantes peuvent parfois s'exécuter simultanément, réduisant ainsi le temps d'exécution réel à la branche la plus lente plutôt qu'à la somme de toutes les branches.
En Python, TaskGroup asyncio.TaskGroupoffre une méthode structurée pour exécuter des tâches connexes en parallèle. La documentation Python actuelle indique que TaskGroup attend la fin des tâches du groupe et annule les tâches restantes lorsqu'une tâche échoue avec une exception autre qu'une exception d'annulation, ce qui garantit une sécurité accrue par rapport à une création de tâches non structurée. Consultez la documentation officielle de Python sur TaskGroup .
La parallélisation a un coût. Si le fournisseur impose une limite stricte de requêtes par minute ou de requêtes simultanées, l'exécution simultanée de quatre agents peut transformer un flux de travail lent mais efficace en une succession rapide d'erreurs 429. Parallélisez uniquement les tâches véritablement indépendantes et conservez la limite globale de concurrence.
Étape 7 : Quand faut-il cesser d’utiliser une requête HTTP synchrone ?
Si les flux de travail classiques dépassent régulièrement le délai d'expiration le plus court de votre réseau, passer à un modèle de tâches asynchrones est généralement plus propre que d'allonger constamment ce délai. La requête HTTP initiale permet de valider les données d'entrée, de créer une tâche persistante et de renvoyer immédiatement un identifiant de tâche. Les agents exécutent ensuite le graphe multi-agents en dehors du cycle de vie de la requête, tandis que le client reçoit la progression par interrogation, événements envoyés par le serveur, WebSockets ou webhook.
Le streaming est utile lorsque le serveur peut commencer à envoyer des données pertinentes rapidement. Le kit de développement logiciel (SDK) Python d'OpenAI, par exemple, prend en charge le streaming d'événements envoyés par le serveur pour les appels à l'API Responses. Le streaming améliore la réactivité perçue et permet de maintenir une connexion active produisant des données, mais il ne résout pas automatiquement le problème de la durée de vie maximale des requêtes de chaque proxy. Consultez la documentation officielle d'OpenAI sur le streaming d'événements .
Optez pour une tâche asynchrone lorsque la durabilité prime sur la simplicité immédiate : tâches de recherche de longue durée, flux de travail d’agents nécessitant une validation humaine, nombreux appels d’outils, opérations coûteuses à éviter, ou charges de travail devant survivre aux déconnexions client. Ce mode asynchrone implique une gestion d’état supplémentaire : statut de la tâche, points de contrôle, clés d’idempotence, annulation, stockage des résultats et gestion des nouvelles tentatives.
Étape 7 : pour les flux de travail longs, suivez l’achèvement des agents comme un état de flux de travail durable au lieu de dépendre d’une seule connexion client pour rester ouverte jusqu’à ce que chaque agent ait terminé.
Étape 8 : Valider la correction sous une charge réaliste
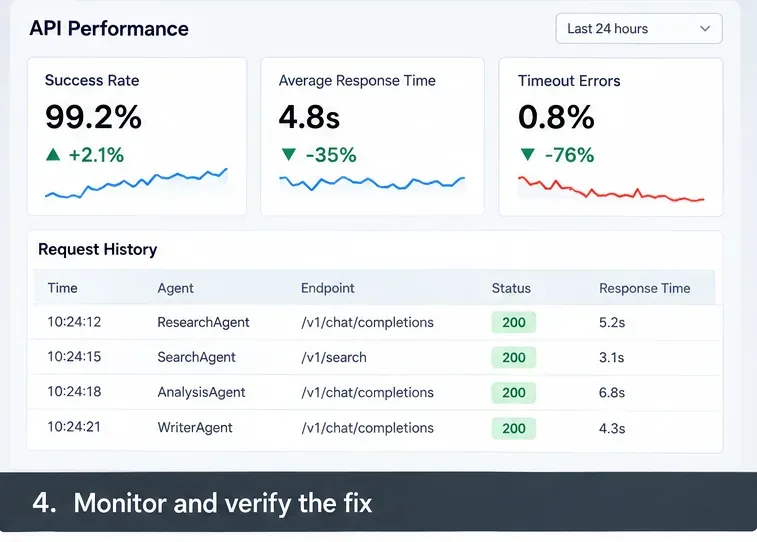
La réussite d'une seule requête ne suffit pas à prouver l'efficacité d'un correctif. Il est essentiel de tester avec la concurrence prévue en production et de mesurer le taux de réussite, le taux de délai d'attente, le nombre de tentatives de nouvelle requête par tâche logique, la latence P95 et P99, le délai d'attente dans la file d'attente, le temps d'attente du pool de connexions, les taux d'erreurs 429/5xx en aval et le coût par flux de travail exécuté.
Si vous exécutez des agents dans Kubernetes, utilisez les indicateurs de disponibilité et de vivacité à des fins différentes. La documentation Kubernetes décrit les sondes de disponibilité comme le mécanisme qui détermine si un pod doit recevoir du trafic, tandis que les sondes de vivacité déterminent quand un conteneur doit être redémarré. Sa documentation avertit explicitement que des contrôles de vivacité mal implémentés peuvent entraîner des défaillances en cascade en cas de forte charge. Consultez la documentation officielle de Kubernetes sur les sondes .
En cas de surcharge temporaire, il est souvent plus sûr de se retrouver « non prêt » que de mettre en danger à répétition des travailleurs en bonne santé mais surchargés de travail. Réservez les interruptions de service aux situations où la reprise du processus constitue véritablement la meilleure solution.
Étape 8 : vérifiez la modification avec un trafic et des métriques de latence de queue similaires à ceux de la production, et non pas seulement avec un seul test réussi.
Comment déterminer quelle solution convient à votre type de défaillance ?
Modèle observé
Premier changement le plus utile
Ce qu'il ne faut pas faire en premier
Les appels se terminent juste après la date limite du client ; le flux en aval est sain
Augmentez le délai d'expiration interne spécifique et redéfinissez le délai d'expiration externe.
Augmenter les tentatives
Les erreurs 429 et les délais d'expiration du pool augmentent avec la concurrence.
Réduire la concurrence et ajouter une mise en file d'attente/une contre-pression
Lancez davantage d'agents en parallèle
Erreurs 408/5xx ou pannes réseau occasionnelles
Utilisez des tentatives de nouvelle exécution avec un délai exponentiel borné pour les opérations idempotentes
Réessayer indéfiniment pour chaque exception
Le flux de travail prend régulièrement plus de temps que les limites de la passerelle.
Utilisez une architecture de tâches asynchrones ou une conception de flux prise en charge.
Augmentez uniquement le délai d'expiration du SDK.
Une dépendance lente domine la latence de p99
Optimisez, mettez en cache, remplacez ou isolez cette dépendance ; envisagez une solution de repli.
Ajuster les délais d'expiration des agents non liés
Les défaillances n'apparaissent qu'après l'ajout d'agents parallèles.
Conservez le parallélisme utile, mais ajoutez un sémaphore global et des limites par fournisseur.
Supposons que le traitement parallèle soit toujours plus rapide.
Une base de production pratique
Pour une API multi-agents classique, une base solide consiste à attribuer à chaque flux de travail un ID de corrélation, à tracer chaque appel d'agent et d'outil, à définir une échéance de bout en bout, à attribuer des échéances plus courtes par appel à l'intérieur de celle-ci, à imposer une limite de concurrence globale par fournisseur en aval, à maintenir les tentatives de nouvelle exécution limitées et idempotentes, et à conserver suffisamment d'état pour reprendre ou signaler une exécution partielle.
Ensuite, optimisez le système en fonction des mesures. Si le système est stable mais trop lent, parallélisez sélectivement les tâches indépendantes. S'il est rapide à faible charge mais instable en période de forte charge, réduisez le nombre de connexions et augmentez la pression. Si les flux de travail optimaux prennent naturellement plus de temps que ne le permet le chemin de requête synchrone, changez d'architecture plutôt que d'allonger le temps d'attente de chaque proxy.