Accueil
» Domaines
»
Comment créer des GPT personnalisés qui n'oublient pas leurs fichiers de connaissances
Comment créer des GPT personnalisés qui n'oublient pas leurs fichiers de connaissances
État actuel (vérifié le 13 septembre 2026) : OpenAI indique que les comptes ChatGPT personnels (Free, Go, Plus et Pro inclus) ne peuvent ni créer ni publier de nouveaux GPT. Les GPT existants restent utilisables et, le cas échéant, modifiables. Dans les espaces de travail Business, Enterprise et Edu, la création de GPT dépend des paramètres et des autorisations de l’espace de travail. OpenAI précise également que les flux de travail des GPT personnalisés sont progressivement migrés vers les plugins, avec une migration prévue pour le 17 septembre 2026 et la mise hors service des GPT Enterprise concernés prévue pour le 11 décembre 2026. Si vous consultez ce document ultérieurement, veuillez vérifier l’état actuel des GPT dans la documentation d’OpenAI « Création et modification de GPT » avant de créer un nouveau flux de travail.
Un GPT personnalisé qui semble « oublier » un fichier de connaissances n'a généralement pas perdu ce fichier. La FAQ d'OpenAI sur le chargement de fichiers indique que les fichiers chargés comme connaissances GPT sont conservés jusqu'à la suppression du GPT personnalisé. Le problème le plus fréquent concerne la récupération : le modèle ne lit pas nécessairement l'intégralité de chaque fichier chargé pour chaque question. Il récupère les éléments qui semblent pertinents par rapport à la question posée ; la qualité de la source, la structure du fichier, les instructions et les tests effectués influent donc sur la pertinence du passage trouvé.
Il est également important de distinguer les « connaissances » de la « mémoire ». La documentation ChatGPT d'OpenAI indique que les GPT n'utilisent ni mémoire enregistrée, ni instructions personnalisées, ni conversations précédentes ; chaque conversation est immuable. Les connaissances importées constituent donc une source de référence configurée, et non une mémoire conversationnelle accumulée au fil des échanges.
À quoi devrait ressembler un résultat fiable
L'objectif n'est pas d'obliger un GPT à mentionner un fichier à chaque tour. Il s'agit plutôt de garantir que les réponses dépendant de la source soient systématiquement étayées par le bon contenu, tout en faisant en sorte que les questions non étayées échouent de manière appropriée au lieu de produire une supposition hâtive.
Signal de qualité
À quoi ressemble le « bien »
Quand modifier la configuration
Exactitude
La réponse correspond au fichier de référence pour la question testée.
Si la réponse est fausse malgré la présence du fait, simplifiez la source ou précisez la question.
Mise à la terre
Le GPT peut nommer le fichier ou la section de support sur demande.
Si la réponse repose plutôt sur des connaissances générales, renforcez les instructions relatives à la priorité des sources et effectuez un nouveau test.
Abstention
Lorsque les fichiers ne contiennent pas la réponse, GPT l'indique clairement.
Si elle invente une politique, un prix, une date ou une procédure, ajoutez une règle explicite interdisant toute supposition.
Cohérence
Des formulations équivalentes produisent des réponses matériellement cohérentes.
Si de petites modifications de formulation entraînent des dérives importantes, réduisez l'ambiguïté tant dans les fichiers que dans les instructions.
Intégrité de la mise à jour
Après une révision du code source, les mêmes questions d'évaluation reflètent le nouveau contenu.
Si les anciennes réponses persistent, vérifiez que le fichier mis à jour est bien joint, enregistrez le fichier GPT et relancez les tests.
Huit étapes pour rendre l'utilisation des fichiers de connaissances plus fiable
1. Vérifiez que votre compte ou espace de travail peut toujours créer ou modifier le GPT.
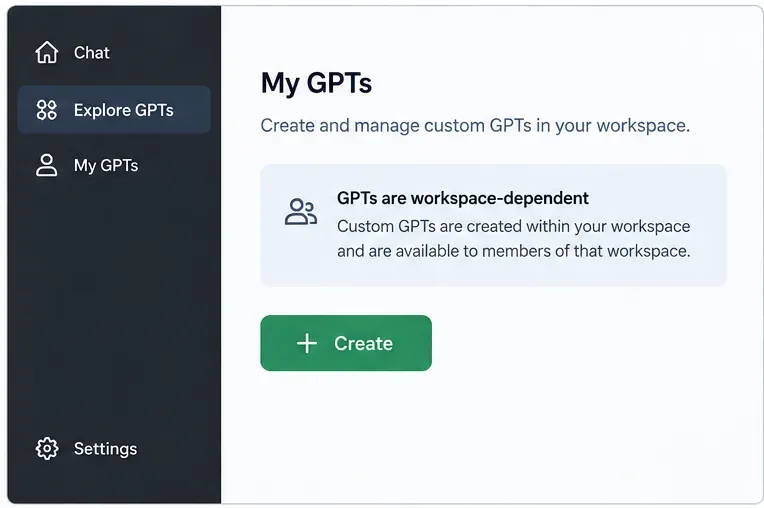
Commencez par vérifier les conditions d'éligibilité, car l'absence du bouton « Créer » peut désormais être un comportement normal et non plus un problème de navigateur. Selon les directives actuelles d'OpenAI concernant les GPT dans ChatGPT , la création de nouveaux GPT n'est pas disponible pour les comptes personnels. Les espaces de travail gérés peuvent toutefois permettre la création de GPT en fonction des politiques d'administration et des autorisations liées aux rôles. Si vous possédez déjà un GPT, vérifiez si vous pouvez toujours le modifier depuis votre compte.
Dans les espaces de travail gérés éligibles, commencez par la zone GPT ; la disponibilité dépend des autorisations de l’espace de travail.
Ne perdez pas de temps à résoudre les problèmes de récupération des connaissances tant que vous n'êtes pas certain d'utiliser un éditeur compatible. Si votre organisation migre déjà vers les plugins, considérez le GPT personnalisé restant comme un candidat à la migration plutôt que comme une nouvelle dépendance à long terme.
2. Dissocier les consignes comportementales des connaissances
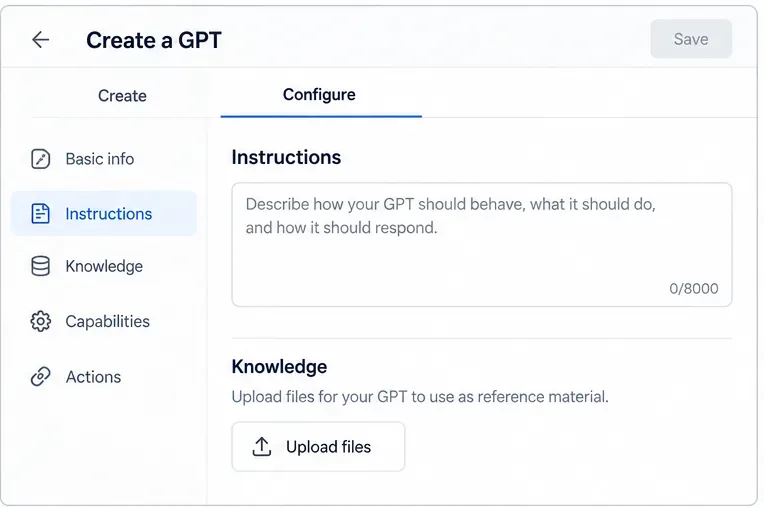
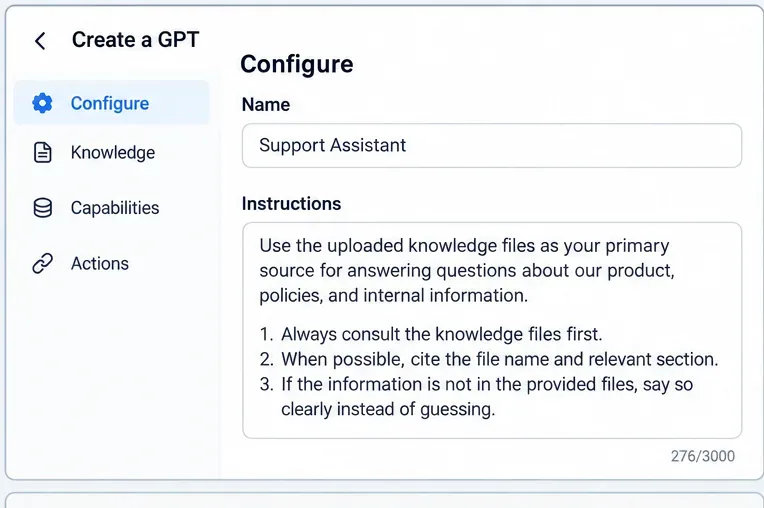
Utilisez le champ « Instructions » pour les règles telles que le ton, l’ordre de décision, le format de citation, le comportement en cas d’escalade et les actions que le GPT doit entreprendre lorsqu’une source est muette. Utilisez le champ « Connaissances » pour les documents de référence : manuels, documentation produit, politiques, FAQ, spécifications ou guides internes. OpenAI recommande explicitement cette séparation, car les connaissances sont plus efficaces lorsqu’elles servent de source, tandis que les instructions définissent le comportement.
Conservez les règles de comportement dans les Instructions et les documents de référence dans la section Connaissances.
Cette distinction est essentielle pour la fiabilité. Une phrase comme « Ne jamais indiquer un prix périmé » doit figurer dans les instructions. Le tableau des prix proprement dit doit être inclus dans la section « Connaissances ». Intégrer des règles dans un volumineux document PDF de référence complique le contrôle et le test du comportement.
3. Préparez les fichiers en vue de leur récupération, et non seulement de leur lecture humaine.
Privilégiez les fichiers clairs, privilégiant le texte, avec des titres descriptifs, des sections courtes, une terminologie stable et des dates de version sans ambiguïté. Une brochure, même magnifiquement conçue, peut s'avérer moins lisible qu'un simple fichier Markdown ou texte si les informations essentielles sont dispersées dans des colonnes, des encadrés, des captures d'écran ou des mises en page décoratives.
Les fichiers texte avec des noms clairs et une structure simple sont plus faciles à récupérer de manière fiable.
Ceci est particulièrement important pour les PDF. La FAQ d'OpenAI sur la recherche visuelle avec les PDF indique que les PDF importés en tant que connaissances GPT sont traités par une recherche textuelle uniquement. Autrement dit, un graphique, un diagramme ou une capture d'écran dans le PDF ne doit pas être le seul endroit où figure une règle essentielle. Il est recommandé d'ajouter une explication textuelle ou un fichier d'accompagnement textuel.
Supprimez également les doublons obsolètes. Si un fichier indique un délai de retour de 14 jours et un autre de 30 jours, la recherche peut faire apparaître l'un ou l'autre. Des noms de fichiers tels que returns-policy-2026.md et la mention visible de la « date d'effet » facilitent l'audit du versionnage.
4. Téléchargez un petit ensemble de connaissances cohérent et vérifiez-le.
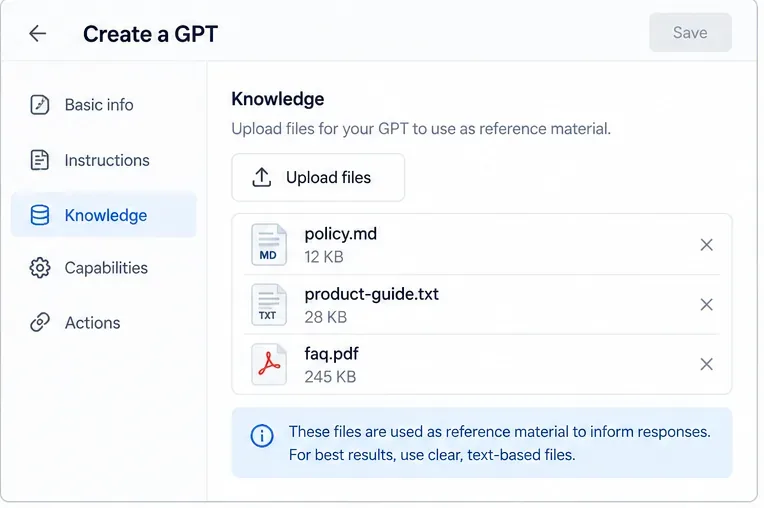
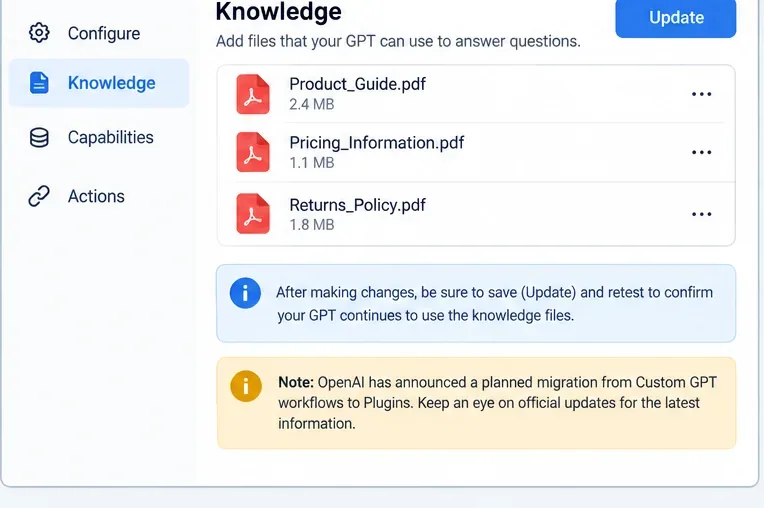
Téléversez uniquement les fichiers dont GPT a réellement besoin. Les recommandations d'OpenAI concernant la gestion des fichiers pour les entreprises indiquent que des documents moins nombreux et plus ciblés améliorent généralement la précision de la recherche par fichier. Après le téléversement, vérifiez que chaque fichier attendu figure bien dans la liste de connaissances avant de poursuivre.
Téléchargez le jeu de référence, puis vérifiez que chaque fichier attendu apparaît avant de procéder aux tests.
Il existe actuellement une incohérence dans la documentation concernant le nombre de fichiers autorisés. Le guide de l'éditeur GPT indique qu'il est possible d'ajouter jusqu'à 20 fichiers à un GPT, tandis que la FAQ sur le chargement de fichiers limite à 10 le nombre de fichiers autorisés par GPT pour toute la durée de vie de ce dernier. Les deux documents mentionnent une limite stricte de 512 Mo par fichier, et la FAQ sur le chargement de fichiers indique un plafond de 2 millions de jetons pour les fichiers texte et les documents. Compte tenu de cette divergence entre les pages officielles, il est recommandé de ne pas baser un flux de travail critique sur la limite la plus élevée sans avoir consulté l'éditeur et la documentation en vigueur pour votre compte.
5. Ajouter des instructions axées sur la récupération
Ne vous fiez pas à une instruction vague comme « Utilisez les fichiers téléchargés ». Indiquez la procédure à suivre lorsqu'une question porte sur un domaine de connaissances spécifique. Voici une démarche pratique : consulter d'abord les connaissances téléchargées ; privilégier ces connaissances aux connaissances générales pour les faits propres à l'entreprise ; identifier le fichier ou la section pertinente lorsque cela est possible ; et préciser que l'information est indisponible si les fichiers ne permettent pas de répondre à la question.
Les instructions axées sur la recherche doivent définir la priorité de la source, le comportement en matière de citation et une solution de repli sans ambiguïté.
Les recommandations de dépannage d'OpenAI préconisent des invites plus précises, renvoyant plus directement aux documents joints, lorsque les connaissances ne sont pas correctement exploitées. Elles recommandent également de conserver les règles et le comportement du flux de travail dans les instructions plutôt que de les dissimuler dans les fichiers téléchargés. Voir Dépannage des GPT .
Évitez les instructions contradictoires. « Toujours répondre à l’utilisateur » est incompatible avec « Ne jamais répondre sauf si le fichier le permet ». Remplacez cette contradiction par une solution de repli explicite, telle que : « Si les fichiers de connaissances ne contiennent pas l’information requise, indiquez que les sources fournies ne permettent pas d’établir la réponse et suggérez la prochaine étape approuvée. »
6. Effectuez des tests de mise à la terre positifs en mode aperçu.
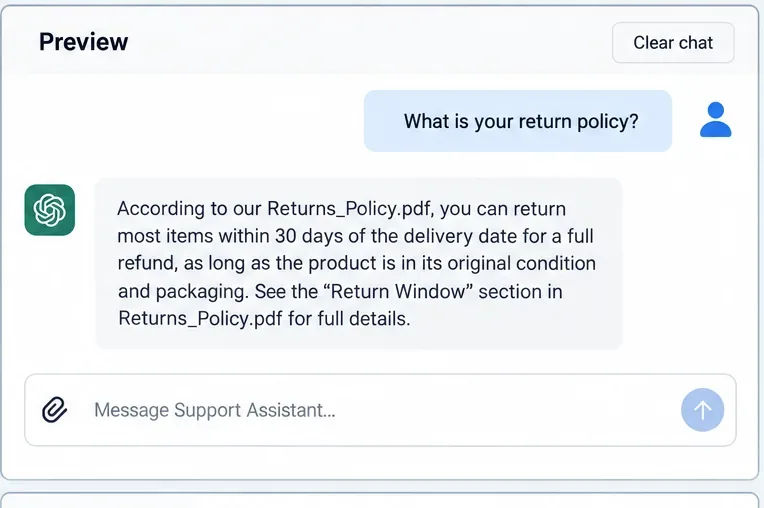
Posez des questions dont les réponses correctes figurent assurément dans les fichiers. Ne vous contentez pas de tester la phrase la plus simple de la première page. Incluez des questions qui exigent de consulter différentes sections, de reconnaître des formulations alternatives et de distinguer des politiques similaires.
Un test positif concluant donne la bonne réponse et identifie le fichier ou la section correspondante.
Pour chaque test, notez la réponse attendue, le fichier source attendu et si le GPT a cité ou identifié cette source lorsqu'il l'a demandé. Les recommandations personnalisées de l'OpenAI Academy concernant les GPT préconisent de constituer un ensemble d'évaluation d'environ 10 à 15 questions représentatives avec des réponses correctes. Cet ensemble est suffisamment important pour mettre en évidence les erreurs récurrentes sans transformer chaque modification en un projet de test majeur.
Évaluez la qualité d'une réponse en fonction de sa pertinence, et non de sa fluidité. Une réponse soignée, mais erronée, est un échec. Une réponse plus concise, citant correctement le document de référence, donne généralement de meilleurs résultats.
7. Effectuer des tests négatifs et reformuler les tests
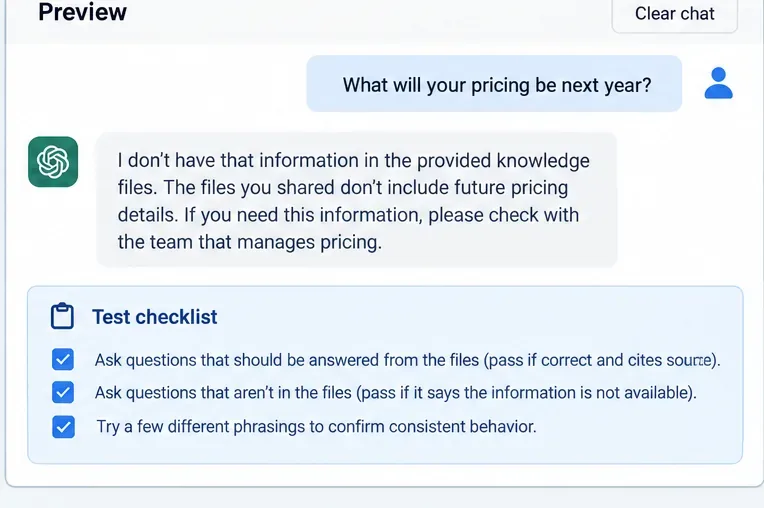
Un assistant de connaissances fiable doit reconnaître ses lacunes. Posez des questions qui ne figurent pas intentionnellement dans les documents : un prix futur, une fonctionnalité non encore disponible, une politique applicable à un pays non couvert par le manuel, ou une date hors du champ d’application du document. L’objectif est d’identifier une limitation claire, et non de proposer une solution plausible.
Les tests négatifs sont importants : le GPT doit admettre lorsqu’une réponse n’est pas présente dans les fichiers et rester cohérent malgré les reformulations.
Reformulez ensuite quelques questions, positives et négatives, de différentes manières. Si « Quel est le délai de remboursement ? » fonctionne, mais que « Combien de temps ai-je pour renvoyer l'article ? » ne fonctionne pas, le problème réside peut-être dans la couverture de récupération plutôt que dans un manque d'informations. Améliorez les titres, la terminologie ou les instructions avant d'ajouter d'autres fichiers.
8. Mises à jour de version, nouveaux tests et savoir quand les connaissances statiques ne constituent pas l'outil adéquat
Chaque fois que vous modifiez une source, supprimez la version obsolète, chargez la version actuelle, enregistrez ou mettez à jour la table de traitement global (GPT) et relancez le même ensemble d'évaluation. Conserver un journal des modifications succinct en dehors de la GPT peut vous aider à identifier si une régression provient de nouvelles instructions, d'une source remplacée ou d'un changement de plateforme.
Après avoir modifié les fichiers sources ou les instructions, enregistrez la mise à jour et relancez le même ensemble d'évaluation.
Les connaissances statiques ont leurs limites. Si la source évolue constamment, si l'accès doit respecter les permissions de chaque utilisateur ou si l'assistant a besoin de données opérationnelles en temps réel, le chargement répété de fichiers s'avère risqué. La documentation des applications OpenAI avec synchronisation décrit des sources connectées indexées qui restent à jour tout en respectant les permissions. OpenAI oriente également les flux de travail GPT personnalisés vers les plugins ; ainsi, une base de connaissances en constante évolution est une candidate idéale pour une architecture connectée ou migrée plutôt que pour un amas croissant de fichiers statiques.
Comment diagnostiquer une table de partition GPT qui « oublie » encore un fichier
Si une information connue est omise, commencez par vérifier sa présence dans un fichier joint et à jour. Ensuite, posez une question plus précise, en nommant le document ou le sujet. Si cette question précise fonctionne, améliorez les indices de recherche en simplifiant les titres, en divisant un document trop général ou en supprimant les versions redondantes. Si la question précise ne donne toujours pas de résultats, convertissez le texte essentiel en un format plus concis et réessayez.
Ne corrigez pas systématiquement chaque erreur en ajoutant des instructions. Un excès de règles ou des contradictions peuvent rendre le comportement imprévisible. De même, n'ajoutez pas de fichiers tant que vous n'êtes pas certain que l'ensemble existant est correct. Le critère de qualité recherché est la reproductibilité : le même petit ensemble d'évaluations doit réussir après chaque modification, notamment pour les questions à haut risque liées aux politiques, aux aspects juridiques, à la tarification ou aux opérations.
La limite pratique : on peut améliorer la récupération, mais pas la garantir.
Aucune invite ne peut garantir qu'un modèle génératif consulte systématiquement tous les fichiers de connaissances pour chaque réponse. Un GPT personnalisé fiable repose donc sur un flux de travail structuré, et non sur un simple chargement ponctuel : fichiers sources ciblés, instructions explicites de priorité des sources, comportement d'abstention défini et évaluation reproductible. Si ces contrôles ne permettent toujours pas d'atteindre le niveau de précision ou de mise à jour souhaité, il est préférable de modifier l'architecture plutôt que de s'obstiner à optimiser une configuration statique.
Pour les GPT éligibles, ce processus peut réduire considérablement le problème des fichiers manquants. Toutefois, pour les nouveaux projets entamés fin 2026, la décision à plus long terme devra également tenir compte de la transition annoncée par OpenAI des flux de travail GPT personnalisés vers les plugins et de la disponibilité de sources de connaissances connectées.