Accueil
» Domaines
»
Comment créer un agent de traitement automatisé des factures à l'aide d'une IA open source
Comment créer un agent de traitement automatisé des factures à l'aide d'une IA open source
Un agent de traitement automatisé des factures ne doit pas nécessairement être un vaste système d'IA autonome. Pour une première version fonctionnelle, il peut s'agir d' un flux de travail logiciel contrôlé qui reçoit une facture, sollicite les outils de traitement de documents et d'IA appropriés, valide le résultat, détermine si une intervention humaine est nécessaire, et n'enregistre ou n'exporte les données approuvées qu'ensuite.
Cette distinction est importante en finance. Un modèle de langage peut aider à transformer des factures à la mise en page complexe en champs structurés, mais il ne doit pas être le seul critère déterminant la validité d'une facture ou sa comptabilisation. La conception intuitive de ce guide garantit une extraction probabiliste des données et des contrôles comptables essentiels déterministes.
Au final, vous disposerez d'un prototype local qui accepte les factures au format PDF ou image, extrait des champs tels que le fournisseur, le numéro de facture, les dates, la devise, les totaux et les lignes de commande, valide ces champs par rapport à des règles, achemine les documents douteux vers la vérification, stocke une piste d'audit et expose le processus via une API.
Que devez-vous comprendre avant de commencer ?
Il y a quatre termes qu'il est bon de connaître :
La ROC (reconnaissance optique de caractères) transforme le texte visible dans une image ou un scan en texte lisible par machine.
L'analyse syntaxique des documents préserve davantage la structure que la simple reconnaissance optique de caractères (OCR), notamment l'ordre de lecture, les tableaux, les titres et les zones de mise en page.
LLM (Large Language Model) permet de convertir le texte variable des factures en une structure JSON cohérente.
L'intervention humaine dans la boucle signifie que le système s'arrête et demande à une personne d'examiner les cas qui échouent aux contrôles au lieu de prétendre que chaque résultat est correct.
En septembre 2026, plusieurs projets open source activement maintenus couvraient ces différentes couches. Docling prenait en charge les formats PDF, image, document bureautique et autres ; PaddleOCR fournissait des pipelines de reconnaissance optique de caractères (OCR) et de compréhension de documents et était distribué sous licence Apache 2.0 ; et le projet Tesseract documentait sa version 5.x actuelle en tant que moteur OCR open source dans le manuel officiel de Tesseract .
Pour l'inférence de modèles locaux, la documentation du serveur llama.cpp décrit des points d'accès compatibles avec OpenAI et une sortie JSON avec schéma contraint. Cela le rend utile pour un service d'extraction, car il permet de demander à un modèle hébergé localement de renvoyer un objet défini plutôt qu'un texte non structuré.
Un avertissement important concernant les licences : un moteur d’inférence open source ne rend pas automatiquement tous les poids des modèles open source. Vérifiez la licence du modèle précis que vous utilisez, notamment pour un usage commercial.
Quelle pile technologique un débutant devrait-il utiliser ?
Couche
choix pratique
Pourquoi est-ce ici ?
Conversion de documents
Docling
Convertit les fichiers PDF et les images en une représentation structurée du document et en texte exportable.
solution de repli OCR
PaddleOCR ou Tesseract
Utile lorsque la facture est un scan ou une photo et que l'extraction de texte nécessite une reconnaissance optique de caractères (OCR).
Extraction locale d'IA
llama.cpp + un modèle d'instructions approprié
Associe le texte variable des factures à un schéma JSON stable tout en conservant l'inférence en local.
Validation du schéma
Pydantique
Valide les données Python par rapport aux types de champs et aux contraintes déclarés.
API
FastAPI
Accepte les téléchargements de factures et renvoie les résultats de traitement.
Stockage
SQLite pour un prototype ; PostgreSQL pour un service partagé
Stocke les données normalisées, l'état de révision, l'identité du fichier source et les événements d'audit.
Orchestration
Python pur d'abord ; LangGraph optionnel plus tard
Une fonction déterministe est plus facile à déboguer. Ajoutez un framework d'agents avec état lorsque la gestion des embranchements et la validation humaine deviennent plus complexes.
La documentation officielle de Pydantic explique que les modèles héritent de `Model` BaseModel, valident les données entrantes et peuvent générer du JSON Schema via `JSONSchema` model_json_schema(). Voir la validation des modèles Pydantic . Si vous avez ultérieurement besoin d'une gestion durable des branches avec état, la documentation de LangGraph décrit la prise en charge des agents avec état de longue durée, de la persistance et des flux de travail avec intervention humaine.
Étape 1 : Mettre en place le projet et définir un premier objectif précis
Ne commencez pas par « automatiser la comptabilité fournisseurs ». Commencez par une seule catégorie de documents et un seul contrat de sortie. Un bon MVP comprend : des factures fournisseurs en anglais, l'importation de fichiers PDF ou d'images, une seule entité juridique, une seule devise et aucun paiement automatique.
Installez votre moteur OCR séparément si nécessaire. Le guide d'installation actuel de Docling utilise [nom du logiciel pip install docling/outil manquant] ; la documentation d'installation actuelle de PaddleOCR distingue son module OCR de base des groupes de dépendances optionnels pour l'analyse de documents et l'extraction d'informations. Utilisez le guide d'installation de Docling ou celui de PaddleOCR 3.x plutôt que de copier une ancienne liste de dépendances.
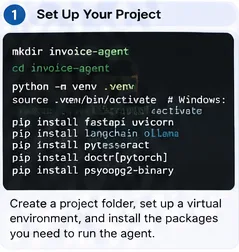
Étape 1 : Commencez par créer un petit projet Python isolé. Limitez le type de facture initial et le schéma de sortie à des fonctionnalités suffisamment restreintes pour permettre des tests approfondis.
Étape 2 : Convertir les factures en texte et en données de mise en page
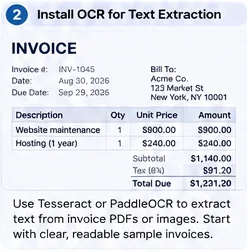
Les PDF natifs peuvent déjà contenir du texte exploitable. Les PDF et photos numérisés nécessitent une reconnaissance optique de caractères (OCR). Votre analyseur syntaxique doit masquer cette différence pour le reste du processus : les étapes suivantes recevront le texte normalisé du document ainsi que toute information utile concernant la mise en page ou les tableaux.
Voici à quoi ressemble une conversion Docling minimale :
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
Le guide de démarrage rapide officiel de Docling utilise le même modèle de conversion puis d'exportation. Pour les collections nécessitant une reconnaissance optique de caractères (OCR), testez PaddleOCR ou Tesseract sur vos propres numérisations. La documentation de PaddleOCR recommande la famille PP-StructureV3, plus récente, pour l'analyse de documents, tandis que Tesseract peut être utilisé en ligne de commande ou via une API pour l'OCR de textes imprimés.
Étape 2 : Commencez par des exemples de factures lisibles contenant les champs que vous prévoyez d’extraire, puis ajoutez des analyses plus poussées seulement une fois que le processus de base fonctionne.
Étape 3 : Déterminer précisément les données que l’agent est autorisé à produire
Le schéma d'extraction définit le contrat entre l'IA et la logique comptable. Évitez un schéma trop complexe incluant toutes les informations susceptibles de figurer sur une facture. Privilégiez les champs validables.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"Cette méthode est utile dans ce contexte car des champs LLM inattendus ne doivent pas être intégrés silencieusement à votre comptabilité. Notez également que la validation Pydantic confirme la structure et les types ; elle ne garantit pas que le fournisseur ou le montant extraits correspondent à l’image de la facture.
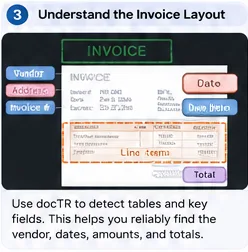
Étape 3 : Définissez les champs cibles en fonction des besoins de l’entreprise, puis utilisez la mise en page et les informations de table pour préserver la provenance de ces valeurs.
Étape 4 : Utiliser un modèle local pour convertir le texte du document en JSON structuré
Exécutez un modèle d'instructions adapté derrière le serveur HTTP de llama.cpp. La taille exacte du modèle dépend de votre matériel et de la complexité des factures. Un modèle plus volumineux n'est pas forcément meilleur ; évaluez la précision des champs, la latence et la consommation de mémoire sur votre propre jeu de factures.
llama.cpp prend actuellement en charge les réponses JSON à schéma contraint. Vous pouvez extraire ce schéma de Pydantic et l'envoyer avec la requête d'extraction :
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
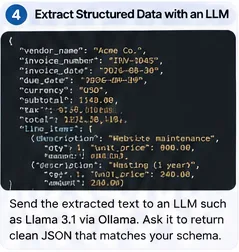
La génération contrainte par un schéma facilite l'obtention d'une structure valide, mais ne garantit pas la véracité sémantique. Un objet JSON parfaitement valide peut néanmoins contenir un total erroné. C'est pourquoi l'étape suivante est indispensable.
Étape 4 : Demandez au modèle local un objet structuré strict, et non une prose libre, afin que la validation en aval reçoive des champs prévisibles.
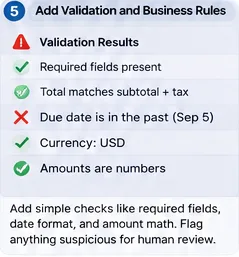
Étape 5 : Ajouter des contrôles comptables déterministes et examiner les règles
Ne demandez pas au responsable du modèle « Êtes-vous confiant ? » et ne vous fiez pas à sa réponse. La confiance déclarée dans le modèle ne constitue pas un contrôle calibré. Mettez en place des mécanismes de vérification qui peuvent être recalculés à partir des données extraites et de vos systèmes.
Voici quelques règles initiales utiles :
Les champs obligatoires sont présents ;
Le numéro de facture n'est pas déjà enregistré pour ce fournisseur ;
La devise est autorisée pour ce fournisseur ou cette entité ;
Les montants des lignes de commande correspondent approximativement au sous-total ;
sous-total plus taxes égale approximativement le total ;
La date de facturation et la date d'échéance sont plausibles ;
Le fournisseur existe dans votre base de données fournisseurs ou est en cours d'intégration ;
Les références des bons de commande correspondent lorsque la correspondance des bons de commande est requise.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Chaque contrôle ayant échoué doit être dirigé vers une file d'attente de révision. Lors d'un premier déploiement, il est judicieux d'acheminer toutes les factures vers la vérification afin d'évaluer la qualité de l'extraction. Les seuils d'automatisation doivent être basés sur des données recueillies sur vos propres factures étiquetées, et non sur un pourcentage générique copié d'un autre système.
Étape 5 : Traiter les règles arithmétiques, de détection des doublons, de correspondance des fournisseurs et de dates comme des contrôles déterministes ; acheminer les exceptions vers une personne.
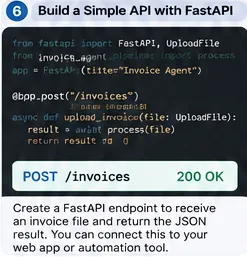
Étape 6 : Encapsuler le processeur dans une petite API
Une API permet à un formulaire de téléchargement, un système de messagerie, un observateur de dossier partagé ou une intégration comptable d'appeler la même fonction de traitement. Le guide officiel de FastAPI UploadFilesur le téléchargement de fichiers recommande l'utilisation d'un fichier spoulé, plus adapté que le chargement complet de fichiers volumineux en mémoire.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Consultez la documentation FastAPI relative aux requêtes de fichiers pour connaître les modèles de chargement pris en charge. En production, appliquez également des limites de taille de fichier, effectuez des analyses antivirus le cas échéant, exigez l'authentification des appelants, utilisez les identifiants de requête et assurez le nettoyage sécurisé des fichiers temporaires.
Étape 6 : Exposez un point de terminaison de traitement une fois que le pipeline local fonctionne, afin que plusieurs canaux d'entrée puissent réutiliser le même chemin de validation.
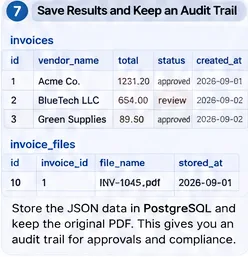
Étape 7 : Stocker les preuves originales, le résultat normalisé et les événements d’audit
Ne stockez jamais uniquement le JSON final. Conservez suffisamment d'éléments pour reconstituer le déroulement des opérations : identité du fichier d'origine, hachage, version de l'analyseur syntaxique, identifiant du modèle, version de l'invite, JSON extrait, résultats de la validation, décision de révision, horodatages et utilisateur ou service ayant approuvé la modification.
Un prototype simple peut utiliser SQLite. Un service multi-utilisateurs peut utiliser PostgreSQL avec des contraintes d'unicité et de clés étrangères. La documentation actuelle de PostgreSQL traite des contraintes de table , utiles pour protéger les clés et les relations indépendamment du pipeline d'IA.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
Le hachage source offre une seconde méthode pour détecter les soumissions accidentelles. Il est recommandé de restreindre les autorisations de stockage des fichiers par rapport aux journaux d'applications généraux, car les factures contiennent souvent des adresses, des coordonnées bancaires, des numéros d'identification fiscale et d'autres données confidentielles.
Étape 7 : Conserver à la fois les données normalisées des factures et les métadonnées du fichier source afin que les approbations, les doublons et les corrections ultérieures restent vérifiables.
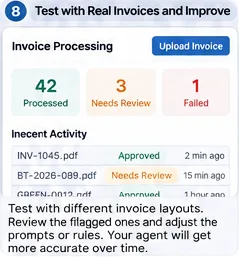
Étape 8 : Tester avec une véritable variante de facture avant d’automatiser les actions suivantes
Un prototype fonctionnel sur cinq PDF vierges n'est pas prêt pour la production. Constituez un ensemble d'évaluation étiqueté représentatif des données que vous recevez réellement : fournisseurs différents, numérisations, pages pivotées, polices de petite taille, factures multipages, remises, lignes négatives, taxes, frais de port, devises multiples, bons de commande manquants et doublons.
Suivez séparément les indicateurs au niveau des champs. L’« exactitude des factures » peut masquer le fait que le nom du fournisseur est facile à vérifier, tandis que la quantité par ligne est peu fiable. Mesurez au minimum :
correspondance exacte pour le numéro de facture, la devise et les dates ;
précision de tolérance numérique pour le sous-total, la taxe et le total ;
précision et rappel des lignes de commande si les lignes de commande ont une importance en aval ;
pourcentage transmis à un examinateur humain ;
taux d'approbation automatique erroné ;
latence de traitement et taux d'échec ;
précision de la détection des doublons.
Consignez les échecs comme cas de test. À chaque correction d'une règle d'analyse syntaxique, d'une invite, d'un schéma ou d'un modèle, relancez l'ensemble de l'évaluation. Cela évite qu'une amélioration apportée par un fournisseur ne perturbe discrètement la mise en page d'un autre fournisseur.
Étape 8 : Mesurer la file d'attente de révision et les cas d'échec sur des factures représentatives avant d'autoriser l'agent à automatiser les actions comptables en aval.
Comment l'agent doit-il décider de la suite des événements ?
Conservez la machine à états explicite. L’« agent » peut initialement être une simple fonction Python :
Ce système fonctionne déjà comme un agent, car il coordonne les outils et choisit une branche. Vous n'avez pas besoin d'un LLM pour choisir chaque étape suivante. Ajoutez LangGraph ou un autre framework d'orchestration lorsque vous avez besoin de revues multi-étapes persistantes, de nouvelles tentatives, de rappels asynchrones ou de plusieurs outils spécialisés dont l'ordre d'exécution varie selon les cas.
Quelles erreurs les débutants doivent-ils éviter ?
Laisser le LLM exercer le contrôle comptable
Le modèle doit extraire et normaliser les données ; le code et les données du système de confiance doivent les vérifier. Les opérations arithmétiques, la vérification des doublons, le statut des fournisseurs, la concordance des commandes et les limites d’approbation relèvent d’une logique déterministe.
Suppression du document source après extraction
Conservez la facture originale ou une référence contrôlée à celle-ci. Les examinateurs ont besoin de preuves, et vous devez pouvoir reproduire les erreurs après les mises à jour du modèle ou de l'analyseur syntaxique.
Utilisation d'une seule invite sans version
Consignez la version et l'identifiant du modèle de chaque facture traitée. Sans cela, vous ne pourrez pas expliquer pourquoi deux factures traitées à plusieurs mois d'intervalle ont présenté un comportement différent.
Publication automatique de chaque résultat conforme au schéma
La validité du JSON ne garantit pas celle de la facture. Commencez par une vérification humaine, puis automatisez uniquement les cas à faible risque une fois que votre évaluation aura démontré des performances acceptables.
Ignorer les licences de modèles et de données
Les bibliothèques et les poids des modèles peuvent avoir des licences différentes. PaddleOCR et Tesseract publient des licences open source, tandis que la licence du modèle exécuté via llama.cpp dépend du point de contrôle spécifique. Vérifiez-la avant le déploiement.
Création de l'interface utilisateur avant de prouver la qualité de l'extraction
Un tableau de bord soigné ne peut compenser des montants erronés. Testez d'abord l'analyse des documents, l'extraction du schéma et la validation ; ajoutez une interface de révision une fois que vous savez précisément ce que les réviseurs doivent voir.
Quand faut-il utiliser uniquement la reconnaissance optique de caractères (OCR), des modèles de mise en page ou un modèle de conception linéaire (LLM) ?
Approche
Meilleure adaptation
Principale limitation
OCR + règles
Un petit nombre de modèles de fournisseurs très stables
Les règles deviennent fragiles lorsque les configurations varient.
Modèle de mise en page de document
Tableaux, formulaires et champs où la position compte
Peut nécessiter une formation spécifique à la tâche ou un post-traitement.
OCR/analyseur de documents + LLM local
De nombreux formats de factures avec un schéma cible commun
Doit être contraint et validé ; l'inférence coûte plus de ressources de calcul.
Modèle vision-langage
Documents complexes où le texte et la mise en page visuelle sont étroitement liés.
Exigences matérielles plus élevées et complexité d'évaluation accrue.
La documentation actuelle de LayoutLMv3 de Hugging Face décrit un modèle d'IA documentaire qui combine informations textuelles et visuelles de mise en page. De même, la documentation de PP-StructureV3 de PaddleOCR se concentre sur la mise en page, les tableaux et l'analyse structurée des documents. Ces solutions sont envisageables lorsque le texte brut associé à un modèle de mise en page (LLM) ne suffit pas.
Quel est le chemin le plus judicieux pour passer du prototype à la production ?
Procédez par étapes. Commencez par un test local sur un dossier de factures étiquetées. Ensuite, ajoutez l'API et le stockage persistant. Troisièmement, mettez en place une file d'attente pour la vérification humaine. Quatrièmement, intégrez des recherches en lecture seule, comme les données de base des fournisseurs ou les bons de commande. Cinquièmement, autorisez l'exportation contrôlée vers une zone de transit comptable. Ce n'est qu'après validation des contrôles par la surveillance que vous pourrez envisager la comptabilisation automatique pour des cas à faible risque strictement définis.
À chaque étape, préservez trois éléments : les preuves (le document original et la source extraite), le déterminisme (les règles métier qui peuvent être réexécutées) et la traçabilité (quel analyseur, quel modèle, quelle invite et quel réviseur ont produit l’enregistrement final).
Liste de vérification finale
Le logiciel d'analyse de factures fonctionne aussi bien avec les fichiers PDF numériques natifs qu'avec les documents numérisés que vous recevez.
Le résultat de l'extraction est contraint à un schéma Pydantic versionné.
Le modèle n'est pas autorisé à inventer des valeurs manquantes.
Les totaux, les dates, les doublons, l'identité du fournisseur et les règles des bons de commande sont validés en dehors du LLM.
Les règles défaillantes entraînent une procédure de révision humaine au lieu d'une correction silencieuse.
Le document original, le hachage source, le modèle, la version de l'invite et le résultat de la validation sont enregistrés.
L'API restreint le type et la taille des fichiers et une authentification est requise avant toute utilisation en production.
Votre ensemble de tests contient de véritables variations de mise en page et des cas limites.
Les licences des modèles et des bibliothèques ont été vérifiées pour le déploiement prévu.
Les écritures comptables en aval sont introduites progressivement et restent auditables.
Si ces contrôles sont en place, vous disposez de bien plus qu'une simple démonstration d'OCR : vous avez les fondements d'un système de traitement de factures fiable. Les composants open source peuvent évoluer, mais l'architecture reste robuste : analyser les données, les extraire dans un schéma, les valider par le code, gérer les incertitudes et consigner chaque décision.