Accueil
» Domaines
»
Comment mesurer la qualité des réponses LLM à l'aide des cadres d'évaluation
Comment mesurer la qualité des réponses LLM à l'aide des cadres d'évaluation
La méthode la plus fiable pour évaluer la qualité des réponses LLM consiste à considérer l'évaluation comme un système de test reproductible, et non comme une simple note. Définissez ce que signifie « bon » pour votre application, constituez un ensemble de données d'évaluation représentatif, combinez des contrôles déterministes avec des modèles et l'expertise humaine, comparez chaque modification proposée à une valeur de référence et analysez les défaillances par catégorie avant la livraison.
C’est important car un LLM peut fournir une réponse apparemment impeccable tout en étant erronée, non étayée, incomplète, dangereuse ou non conforme à vos instructions. Un cadre d’évaluation efficace transforme ces préoccupations vagues en critères explicites, permettant une nouvelle exécution après une modification rapide, une mise à niveau du modèle, une modification de la récupération, une mise à jour de l’outil ou une révision de la politique de sécurité.
Note de documentation : les fonctionnalités du framework décrites ci-dessous ont été vérifiées par rapport à la documentation officielle disponible le 13 septembre 2026. Ces outils évoluent rapidement, il est donc important de vérifier les API actuelles avant de copier du code spécifique au framework en production.
Que faut-il mesurer en premier ?
Commencez par identifier l'échec le plus problématique pour vos utilisateurs. Pour un chatbot d'assistance factuelle, l'exactitude et la conformité aux politiques de confidentialité sont primordiales. Pour la génération assistée par ordinateur (GAO), la pertinence et la qualité de la recherche sont essentielles, car une réponse fluide peut inventer des faits non étayés par le contexte. Pour un agent, la qualité de la réponse finale ne suffit pas ; il est également nécessaire d'évaluer le choix des outils, leurs arguments, l'exécution complète de la tâche et les étapes superflues.
Dimension de la qualité
Ce qu'il demande
Bon type d'évaluateur
Exactitude
La réponse est-elle factuellement ou logiquement correcte ?
Comparaison des références, vérification du code, évaluation par un expert juridique ou examen humain
Instructions suivant
Le modèle a-t-il respecté les contraintes requises ?
Règles du code plus juge basé sur une grille d'évaluation
Enracinement
Les affirmations sont-elles étayées par le contexte fourni ?
Vérifications spécifiques au juge ou au niveau de la réclamation propres au RAG
Pertinence
La réponse répond-elle à la question posée sans s'en écarter ?
Juge LLM ou examen humain
Conformité au format
Le résultat est-il un JSON valide, conforme au schéma ou utilisable par une machine ?
Code déterministe
Sécurité et politique
La réponse enfreint-elle les règles de votre application ?
Vérifications des politiques, juge LLM et examen humain ciblé
Efficacité
Quels ont été le délai de réponse, l'utilisation des jetons et le coût ?
Télémétrie et traçage
Ne faites pas la moyenne de ces éléments trop tôt. Un modèle candidat qui gagne deux points en termes de style, mais qui présente même quelques graves lacunes en matière de politique, pourrait s'avérer moins performant. Conservez les dimensions critiques visibles sous forme de points d'entrée distincts.
Un flux de travail d'évaluation en quatre étapes qui fonctionne dans différents cadres de référence.
1. Constituer un ensemble de données d'évaluation représentatif
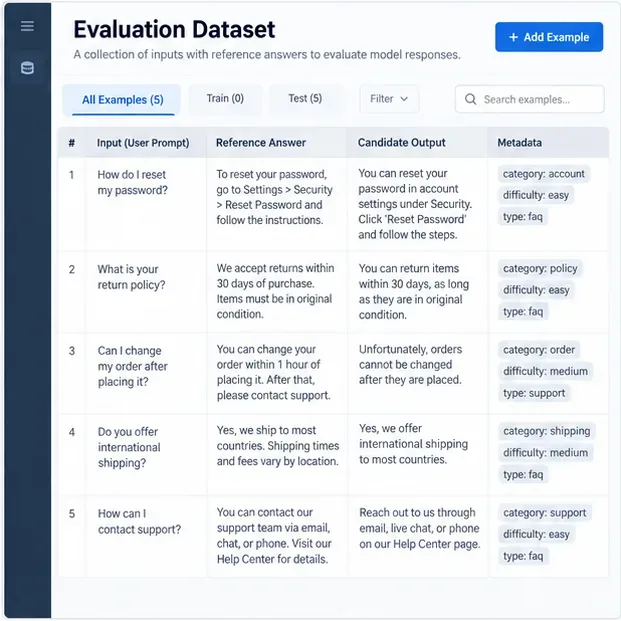
Votre jeu de données doit contenir des entrées réalistes et, si possible, les comportements attendus. Certaines lignes peuvent comporter des réponses de référence exactes ; d’autres peuvent nécessiter une grille d’évaluation plutôt qu’une seule phrase type. Ajoutez des métadonnées telles que le type de tâche, le segment de clientèle, la langue, la difficulté, les conditions de recherche ou la catégorie de sécurité afin de pouvoir segmenter les résultats ultérieurement.
Prenons l'exemple d'un assistant de support client. Un ensemble d'évaluation pertinent ne se limiterait pas aux questions fréquentes les plus simples. Il devrait également inclure des demandes ambiguës, des exceptions aux politiques de l'entreprise, des cas où le contexte est manquant, des invites contradictoires, des relances en plusieurs étapes et des exemples où le comportement approprié consiste à indiquer que la réponse est indéterminée.
Les recommandations d'évaluation actuelles de LangSmith préconisent de commencer par des exemples sélectionnés manuellement illustrant un comportement optimal, puis d'enrichir l'ensemble de données avec des traces historiques et des défaillances rencontrées en production. Son système d'évaluation prend en charge les ensembles de données comprenant des entrées, des sorties de référence optionnelles et des métadonnées. Consultez la documentation relative aux concepts d'évaluation de LangSmith .
Un jeu de données d'évaluation doit associer des invites réalistes à des références ou à un comportement attendu et préserver les métadonnées pour une analyse ultérieure des défaillances.
Quand cette approche est-elle appropriée ? Presque toujours. Même en cas d’évaluation en production, un ensemble de tests hors ligne stable reste indispensable pour les tests de régression. Si vous ne disposez pas de réponse de référence pour les tâches ouvertes, stockez plutôt une grille d’évaluation, les informations requises, les comportements interdits ou les préférences par paires.
2. Associer chaque dimension de qualité à l'évaluateur approprié.
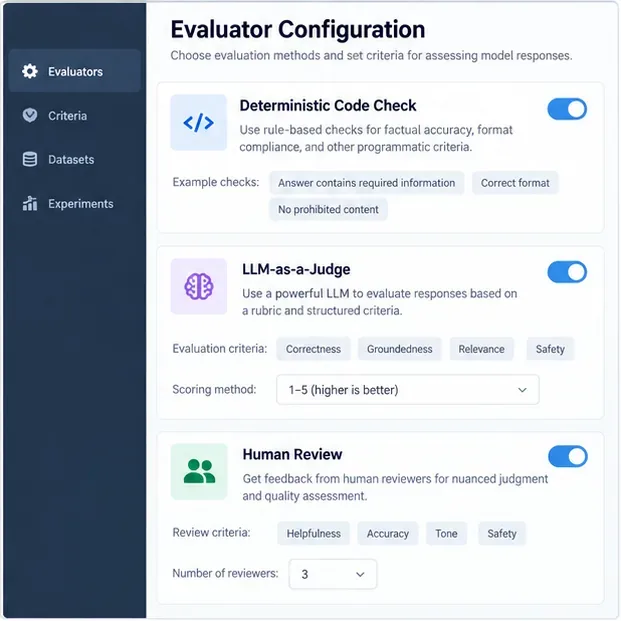
Les systèmes d'évaluation les plus performants mélangent différents types d'évaluateurs, car aucun correcteur n'est idéal pour toutes les questions.
Les contrôles déterministes sont optimaux lorsque l'exigence est sans ambiguïté : JSON valide, étiquettes exactes, clés obligatoires, tolérance numérique, règles d'expression régulière ou utilisation d'arguments approuvés par un appel d'outil.
Les métriques basées sur des références peuvent être utiles lorsqu'une réponse connue existe, mais la similarité de chaînes de caractères à elle seule est souvent trop fragile pour des paraphrases valides et trop indulgente envers un texte sémantiquement incorrect qui partage le même vocabulaire.
Le recours à un LLM en tant que juge est utile pour des critères tels que l'exhaustivité, la pertinence, le ton, la fidélité, ou pour déterminer si une réponse ouverte satisfait à une grille d'évaluation.
L'évaluation par paires est utile lorsqu'il est plus facile de décider si le candidat A ou la référence B est meilleur que d'attribuer un score absolu significatif.
L’intervention humaine reste importante pour calibrer les systèmes de notation automatisés, résoudre les cas subjectifs ou à forts enjeux et vérifier si la mesure elle-même reflète la valeur pour l’utilisateur.
L'API Evals d'OpenAI définit une évaluation comme un ensemble de critères de test et un schéma de source de données, et prend en charge les évaluateurs réutilisables. Son API d'évaluation inclut des vérifications déterministes de chaînes de caractères, des évaluateurs de similarité textuelle et des évaluateurs basés sur des modèles ; consultez la documentation de référence de l'API Evals d'OpenAI et celle des évaluateurs d'OpenAI . Le service d'évaluation Gen AI de Vertex AI de Google Cloud prend en charge les métriques ponctuelles et par paires basées sur des modèles, ainsi que les métriques basées sur le calcul ; ses résultats peuvent inclure des scores par instance, des explications, des moyennes agrégées, des écarts types et des taux de victoire par paires. Consultez la documentation relative aux résultats d'évaluation de Vertex AI .
Utilisez des règles déterministes lorsque cela est possible, ajoutez des juges LLM basés sur une grille d'évaluation pour la qualité sémantique et gardez la possibilité d'un examen humain pour l'étalonnage et les cas nuancés.
Lorsque cette approche est pertinente : utiliser des contrôles déterministes pour les exigences vérifiables par machine, des juges LLM pour les qualités sémantiques et faire appel à des humains en cas de désaccord ayant des conséquences importantes pour l’activité ou la sécurité. Pour un système RAG, Ragas propose des métriques telles que la précision du contexte, le rappel du contexte, la pertinence et la fidélité des réponses, ainsi que des métriques d’utilisation des agents et des outils, notamment la précision des appels d’outils et la précision des objectifs des agents. Consultez la documentation sur les métriques de Ragas . DeepEval fournit également des métriques spécifiques aux tâches et une évaluation personnalisée par juge LLM, incluant un système de notation de type G-Eval ; consultez la documentation sur les métriques de DeepEval .
3. Analyser le même ensemble de données par rapport à une référence et à un candidat
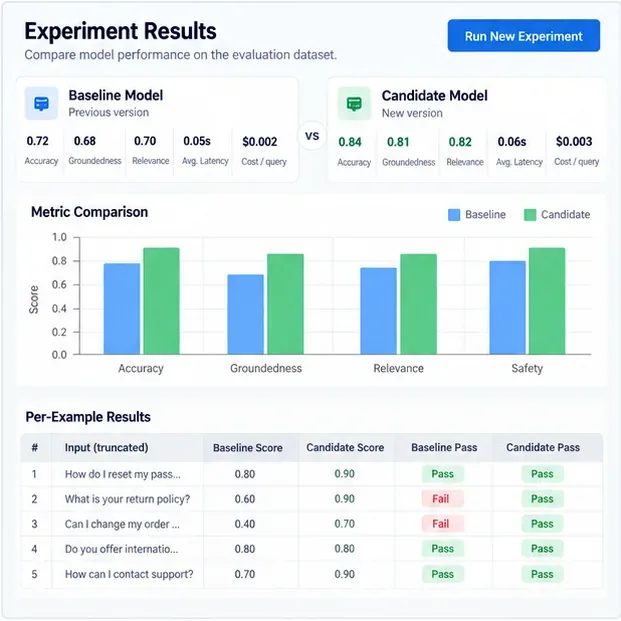
Les scores absolus sont utiles, mais les décisions de publication sont généralement plus claires lorsque la nouvelle configuration est testée par rapport à la version de référence. Veillez à ce que l'ensemble de données, les définitions des évaluateurs, les paramètres du modèle et les paramètres d'échantillonnage restent aussi stables que possible. Comparez ensuite les mêmes exemples côte à côte.
Suivre au moins trois niveaux de résultats :
Résultats par exemple : Quelles invites précises se sont améliorées ou ont régressé ?
Résultats par tranche : Les performances ont-elles changé pour les questions à contexte long, une certaine langue, les cas difficiles, une catégorie de produits ou les entrées adverses ?
Résultats agrégés : Qu’est-il advenu du taux de réussite, du score moyen, de la latence, de l’utilisation des jetons, du coût et du nombre d’échecs graves ?
Pour les systèmes non déterministes, il est essentiel de répéter les tests importants suffisamment de fois pour comprendre la variabilité, plutôt que de supposer qu'une seule exécution représente le modèle. Si la décision de mise en production est cruciale, il convient d'effectuer des comparaisons par paires sur les mêmes exemples et de rendre compte de l'incertitude au lieu de se fier uniquement à une infime variation de la moyenne.
LangSmith prend en charge les expériences hors ligne pour la comparaison de versions et l'évaluation par paires, tandis que la suite d'évaluation GenAI actuelle de MLflow prend en charge les jeux de données d'évaluation, les systèmes de notation intégrés et personnalisés, les juges LLM, les retours humains, le traçage et la surveillance en production. Voir Évaluation LangSmith et Évaluation MLflow LLM et Agent .
Comparez un candidat avec la référence actuelle sur les mêmes exemples, puis examinez à la fois les métriques agrégées et les résultats de réussite ou d'échec par exemple.
Cette approche s'applique à chaque modification apportée à un modèle, une invite système, un pipeline de récupération, l'implémentation d'un outil ou les paramètres de décodage. Une version candidate ne doit pas être promue uniquement en raison de l'augmentation d'une métrique globale ; elle doit respecter les seuils de publication sur les dimensions critiques et éviter toute régression inacceptable au niveau des segments.
4. Analyser les échecs, calibrer le système de notation et transformer les régressions en nouveaux tests.
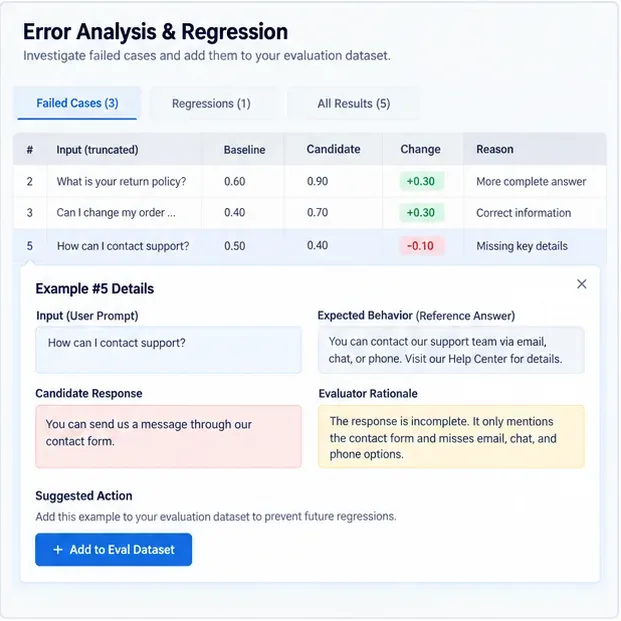
Une évaluation n'est utile que si elle influence vos actions futures. Classez les échecs par gravité et par cause profonde. Un faible score de pertinence peut être dû à une mauvaise récupération des informations, à une consigne incitant à deviner, à une grille d'évaluation trop vague ou à une réponse de référence incorrecte. Consultez les exemples sous-jacents avant de modifier le modèle.
Ensuite, transformez les défaillances importantes en cas de régression permanents. Cela crée un cercle vertueux : la production révèle une défaillance, elle est confirmée par un humain, le cas est ajouté à l’ensemble de données hors ligne, le correctif est testé sur l’ensemble des tests et les versions ultérieures sont ainsi protégées contre la réintroduction du même problème.
Les jurés des LLM doivent également être évalués. La documentation de Google décrit explicitement la comparaison des résultats des métriques basées sur un modèle avec les évaluations humaines afin de déterminer si le juré est suffisamment compétent pour un cas d'utilisation particulier. De même, le projet GDPval d'OpenAI utilise l'évaluation par paires d'experts comme critère principal et décrit l'évaluation automatisée comme une approximation plutôt qu'un substitut au jugement d'experts. Consultez les recommandations de Vertex AI sur l'évaluation d'un modèle de juré et la méthodologie GDPval d'OpenAI .
Examinez les exemples ayant échoué, vérifiez que l'évaluateur porte un jugement correct et ajoutez les régressions importantes à l'ensemble de tests permanent.
Quand cette approche est-elle pertinente ? Toujours pour les erreurs majeures et lorsqu’un juge de master en droit influence la décision de publication. Si les évaluateurs humains sont en désaccord persistant avec le juge, il convient de corriger la grille d’évaluation, de fournir des références plus claires, de modifier le modèle de juge ou de confier à nouveau ce critère à une évaluation humaine.
Dans quelle mesure un LLM est-il fiable en tant que juge ?
Les évaluateurs LLM sont performants car ils peuvent évaluer des productions ouvertes à une échelle qu'une évaluation exclusivement humaine ne peut égaler. L'étude G-Eval initiale a révélé une corrélation nettement supérieure avec le jugement humain par rapport aux métriques automatiques traditionnelles dans le contexte de résumé étudié. Cependant, cette même étude mettait en garde contre le risque que les évaluateurs LLM privilégient les textes générés par LLM. Voir l' article G-Eval original .
Des recherches distinctes menées sur MT-Bench et Chatbot Arena ont révélé que les évaluateurs LLM performants peuvent bien correspondre aux préférences humaines, tout en mettant en évidence des biais liés à la position, à la verbosité, à l'auto-valorisation et au raisonnement. Voir l' étude originale sur les LLM en tant qu'évaluateurs .
La conclusion pratique n'est pas de « ne jamais recourir à des juges LLM », mais plutôt de les calibrer. Il convient de constituer un échantillon étiqueté par des humains, de mesurer le degré de concordance, d'examiner les catégories de désaccord, de randomiser ou d'inverser l'ordre des réponses dans les tests par paires lorsque des effets de position sont plausibles, et d'éviter que la même consigne vague du juge détermine silencieusement chaque décision de publication.
Quel framework d'évaluation choisir ?
Cadre
Meilleure adaptation
Force remarquable
Évaluations et notateurs OpenAI
Les équipes utilisant déjà les API d'OpenAI et souhaitant des évaluations natives de l'API
Définitions d'évaluation réutilisables avec des évaluateurs déterministes et basés sur des modèles
LangSmith
Applications LLM nécessitant le traçage, des ensembles de données, des tests de régression hors ligne et une évaluation en ligne
Boucle de rétroaction robuste entre les expériences et la production
Ragas
Pipelines RAG et évaluation de l'utilisation des agents/outils
Métriques de récupération, de fidélité, de pertinence et d'outils conçues à cet effet
DeepEval
Équipes centrées sur Python qui souhaitent des évaluations de type test et des juges LLM personnalisables
Catalogue de métriques étendu, évaluation des composants/de bout en bout et métriques de trajectoire des agents
Évaluation MLflow GenAI
Les équipes qui utilisent déjà MLflow ou qui souhaitent lier les évaluations au traçage et à la gestion du cycle de vie
Ensembles de données, évaluateurs, retours humains, suivi des expériences et surveillance de la production
Évaluation de l'IA générale de Vertex AI
Déploiements Google Cloud
Flux de travail d'évaluation ponctuels, par paires, basés sur des modèles et basés sur le calcul
Le choix du framework importe moins que la conception de l'évaluation. On peut créer une suite d'évaluation basique sur une plateforme sophistiquée ou une suite robuste avec quelques scripts. Privilégiez l'outil qui rend vos tests reproductibles, versionnés, faciles à inspecter et faciles à exécuter avant chaque modification significative.
Tableau de bord pratique de la publication
Pour un assistant de production, une décision de mise en production pertinente peut être exprimée par une série de critères plutôt que par une note globale. Par exemple, exiger zéro défaillance critique de sécurité dans l'ensemble de sécurité validé, aucune régression statistiquement significative de l'exactitude des tâches, un taux de réussite minimal aux questions RAG (Réponse, Aspect, Questionnaire), une sortie structurée valide pour chaque cas de schéma, et une latence ou un coût respectant le budget opérationnel. Les seuils exacts doivent être définis en fonction de votre tolérance au risque et des exigences des utilisateurs ; il n'existe pas de pourcentage universel qui rende un LLM « suffisant ».
Il est également important de conserver les exemples bruts qui sous-tendent le score. Si une version fait passer le score de 0,84 à 0,86, il faut identifier les deux cas qui ont évolué et déterminer si ces changements sont significatifs. En pratique, les équipes apprennent davantage d'un petit nombre d'échecs clairement catégorisés que d'une moyenne impressionnante affichée sur un tableau de bord, sans aucune traçabilité.
erreurs d'évaluation courantes
Tests basés uniquement sur les scénarios nominaux : ajout d’ambiguïté, de cas limites, de tentatives d’injection de dépendances, de contexte manquant et de défaillances historiques connues.
Utiliser la correspondance exacte pour les réponses ouvertes : réserver la correspondance exacte aux résultats où l’exactitude est véritablement requise.
Faire confiance à un juge de LLM sans étalonnage : comparer son évaluation avec des avis humains et examiner les désaccords.
Optimiser la moyenne tout en masquant les défaillances graves : faire de la sécurité, des politiques et d’autres dimensions critiques des critères explicites.
Modification de l'ensemble de données pendant une comparaison de modèles : figer l'ensemble de comparaison ou le versionner afin que les résultats restent interprétables.
Ignorer la dérive de production : les évaluations hors ligne protègent les versions ; l’évaluation en ligne et l’examen humain par échantillonnage révèlent de nouveaux comportements des utilisateurs et de nouveaux modes de défaillance.
En résumé
Mesurer la qualité des réponses LLM relève de l'ingénierie, et non d'une simple intuition. Commencez par un jeu de données représentatif, définissez des dimensions de qualité spécifiques à la tâche, privilégiez les contrôles déterministes lorsque l'exigence peut être calculée, utilisez des juges LLM lorsqu'un jugement sémantique est nécessaire, étalonnez ces juges avec des experts et comparez les modifications envisagées à une base de référence stable. Enfin, transformez chaque défaillance importante en un test de régression ultérieur.
Si vous suivez ce cycle, le cadre d'évaluation devient plus qu'un simple tableau de bord de reporting : il devient le système de contrôle qualité qui vous indique si une modification d'invite, de modèle, de récupération ou d'agent a réellement amélioré le produit.