Accueil
» Domaines
»
Guide étape par étape : automatiser la veille concurrentielle hebdomadaire à l'aide d'agents IA
Guide étape par étape : automatiser la veille concurrentielle hebdomadaire à l'aide d'agents IA
La veille concurrentielle échoue souvent pour une raison simple : la recherche est dispersée entre trop d'onglets, trop de personnes et trop de définitions de ce qui constitue un changement significatif. Une personne vérifie les pages de tarification, une autre surveille les notes de version, quelqu'un d'autre scanne les actualités du secteur, et d'ici vendredi, l'équipe a une pile de liens mais aucune réponse fiable à la question qui compte : qu'est-ce qui a changé cette semaine, et est-ce important ?
Un agent IA peut réduire ce travail manuel, mais l'agent n'est qu'une partie du système. Un flux de travail hebdomadaire fiable nécessite également une liste de sources, un format de preuve, une référence de la semaine précédente, un planificateur et une étape de revue humaine. Si vous omettez ces éléments, vous pouvez automatiser le bruit aussi efficacement que l'information pertinente.
Ce guide construit le flux de travail des décisions les plus simples aux plus techniques. L'implémentation concrète utilise le SDK Agents actuel d'OpenAI et GitHub Actions, car leur documentation officielle prend en charge la recherche web, les sorties structurées, le traçage et les flux de travail planifiés. L'architecture elle-même est neutre vis-à-vis des fournisseurs : vous pouvez remplacer l'un ou l'autre composant si un autre environnement d'exécution d'agents ou un autre planificateur convient mieux à votre stack.
Que doit réellement faire un agent de veille concurrentielle hebdomadaire ?
Au minimum, le système doit répondre à quatre questions : qu'est-ce qui a changé, d'où provient la preuve, comment le changement diffère de l'état connu précédent, et si une personne doit s'en soucier. « Agent IA » désigne ici un flux de travail basé sur un LLM qui dispose d'instructions et d'outils et peut exécuter une séquence d'actions vers un objectif. Le SDK Agents actuel d'OpenAI décrit les agents de la même manière générale : un modèle configuré avec des instructions, des outils et un comportement d'exécution optionnel tel que des garde-fous et des sorties structurées. Consultez la documentation officielle du SDK Agents d'OpenAI.
Ne concevez pas la première version pour « tout surveiller ». Commencez par un périmètre restreint que vous pouvez encore auditer manuellement. Une fois que vous faites confiance au pipeline, élargissez-le.
Étape 1 : Définir les concurrents, les signaux et les questions hebdomadaires
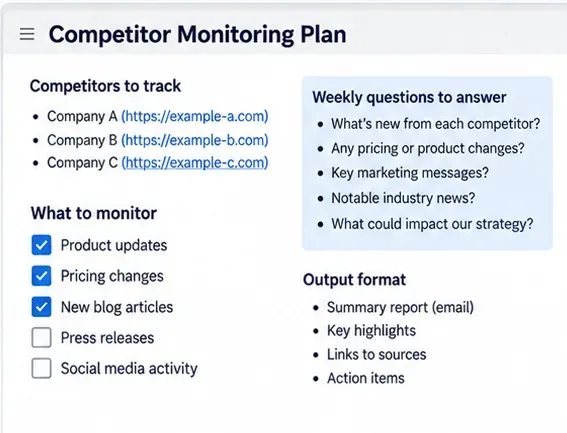
Créez un cahier des charges de veille avant d'écrire du code d'agent. Pour chaque concurrent, décidez quels changements méritent d'être signalés. Les signaux typiques incluent les changements de tarification publique, les lancements de produits, les notes de version, les nouvelles intégrations, les changements de positionnement, les mises à jour importantes de la documentation, les partenariats publics, les annonces de dirigeants et les tendances majeures de recrutement. La liste exacte doit correspondre aux décisions que votre équipe prend réellement.
Un cahier des charges utile sépare les signaux des questions. « La page de tarification a changé » est un signal. « Le nouveau plan rend-il le concurrent plus attractif pour les petites équipes ? » est une question analytique. L'agent doit collecter le premier et raisonner sur le second uniquement après avoir obtenu des preuves.
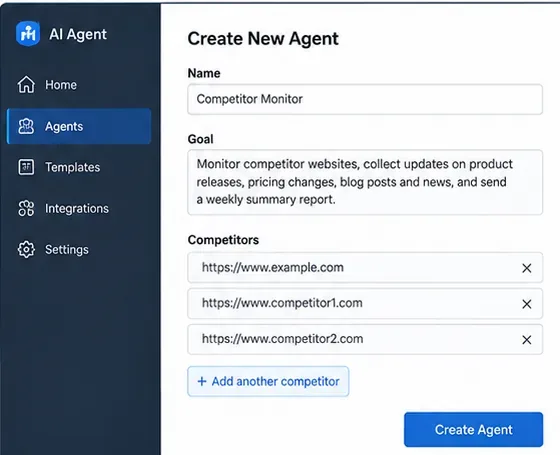
Illustration conceptuelle générée par IA d'un cahier des charges de veille ; il ne s'agit pas d'une capture d'écran d'un produit réel.
Pour une première exécution hebdomadaire, écrivez une phrase qui définit le succès. Par exemple : « D'ici lundi matin, produire un résumé lié aux sources des changements matériels des sept jours précédents pour cinq concurrents nommés, sans affirmations non étayées. » Cette phrase devient un test d'acceptation pratique plus tard.
Étape 2 : Construire un registre de sources au lieu de compter sur une recherche ouverte
La recherche web est utile pour la découverte, mais un système de veille ne doit pas dépendre uniquement des classements de recherche. Construisez un petit registre de sources avec des champs tels que le concurrent, le type de source, l'URL, la priorité, la fréquence de mise à jour attendue et la question à laquelle la source peut répondre.
Signal
Source préférée
Pourquoi c'est utile
Tarification
Pages officielles de tarification et de plans
Source la plus proche de l'offre commerciale actuelle
Changements de produit
Notes de version, journal des modifications, blog produit
Fournit généralement des dates et le contexte des fonctionnalités
Positionnement
Page d'accueil, pages produits, pages de campagne
Montre comment l'entreprise présente le produit
Actualités d'entreprise
Salle de presse et blog d'entreprise
Utile pour les partenariats, le financement, le leadership et les lancements
Contexte du marché
Sources d'actualités publiques réputées
Ajoute un contexte indépendant aux affirmations de première main
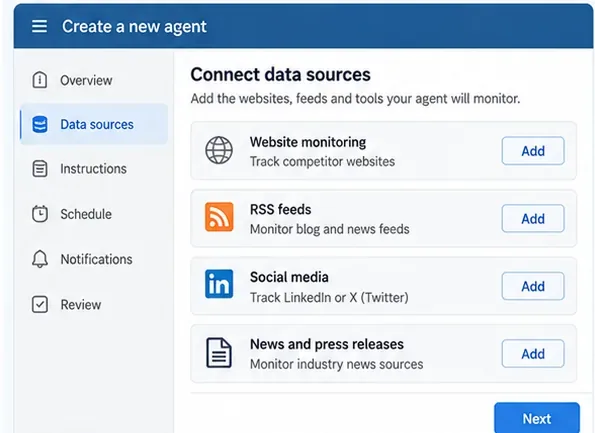
Privilégiez les pages publiques, les flux officiels, les API documentées et les sources auxquelles vous êtes autorisé à accéder. Ne concevez pas l'agent pour contourner les connexions, les paywalls, les restrictions robots ou les contrôles d'accès. Pour les plateformes sociales, privilégiez les API officielles ou les flux publics lorsqu'ils sont disponibles plutôt que le scraping fragile.
Illustration conceptuelle générée par IA d'un registre de sources ; utilisez uniquement les sources auxquelles vous êtes autorisé à accéder.
Le SDK Agents actuel d'OpenAI inclut un WebSearchTool hébergé pour les agents utilisant les modèles OpenAI Responses. La documentation officielle de l'outil distingue également la recherche web hébergée des outils de fonction locaux, ce qui est utile si vous souhaitez que l'agent appelle votre propre récupérateur d'URL, votre base de données, votre lecteur RSS ou votre service de détection de changements. Consultez le guide officiel des outils du SDK Agents.
Étape 3 : Définir le schéma de preuve avant de demander au modèle de résumer
Le moyen le plus simple d'obtenir des rapports hebdomadaires incohérents est de demander « un résumé des actualités concurrentielles ». Définissez plutôt une découverte structurée. Au minimum, chaque découverte doit contenir le concurrent, la catégorie, la date d'observation, un court résumé, l'URL de la source, un extrait de preuve ou une note de source, et un indicateur de confiance ou de revue.
Ajoutez des champs pour previous_state et current_state lorsque le signal peut être comparé directement, comme le prix d'un plan, la disponibilité d'une fonctionnalité, un titre ou une intégration documentée. Cela fait du rapport un document sur le changement plutôt que sur ce que le modèle a trouvé cette semaine.
La sortie structurée rend également le flux de travail plus facile à tester. Le SDK Agents prend actuellement en charge un output_type sur un agent, et la documentation officielle recommande des types Python normaux tels que les modèles Pydantic ou les dataclasses pour les résultats structurés. Consultez le guide officiel de configuration des agents.
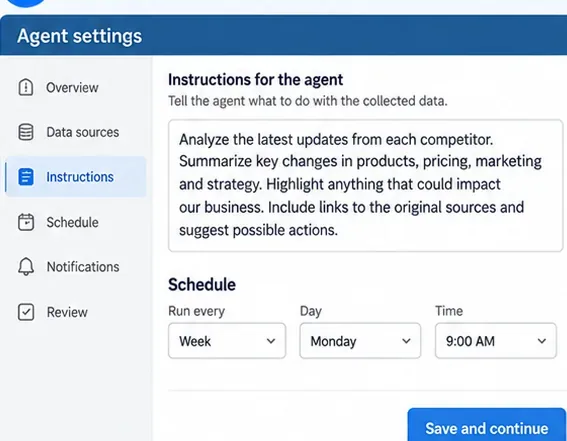
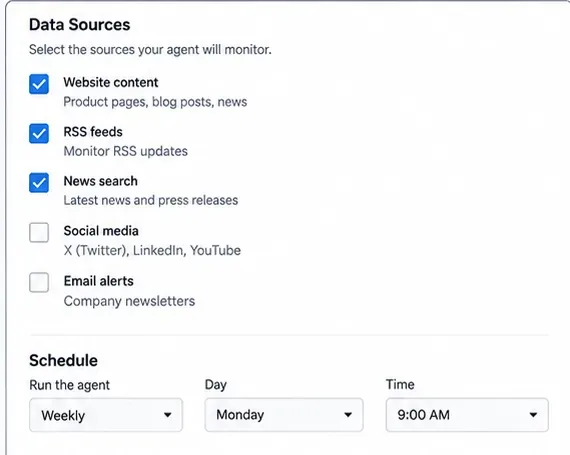
Illustration conceptuelle générée par IA des instructions d'agent et de la planification ; il ne s'agit pas d'une interface de produit réelle.
Le dernier champ est important. Un bon système de veille doit pouvoir dire « aucun changement matériel trouvé » au lieu de fabriquer une mise à jour pour remplir l'espace.
Étape 4 : Exécuter un pilote manuel avant d'automatiser quoi que ce soit
Exécutez le flux de travail manuellement pour une période de reporting et comparez le résultat avec votre propre revue des mêmes sources. Ce pilote révèle des problèmes plus difficiles à remarquer après la planification : résultats de recherche obsolètes, histoires en double, taxonomie de catégorie floue, inférences non étayées, URL de sources manquantes et découvertes techniquement nouvelles mais stratégiquement non pertinentes.
Pour chaque découverte proposée, demandez-vous : la source est-elle de première main ou indépendamment réputée, le changement est-il dans la fenêtre de date prévue, puis-je pointer vers la preuve exacte, et le même élément serait-il signalé à nouveau la semaine prochaine si rien ne change ? Si la réponse à la dernière question est oui, vous avez encore besoin d'une référence ou d'une règle de déduplication.
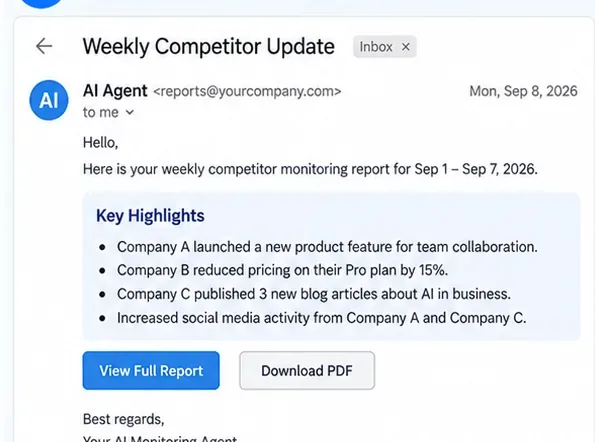
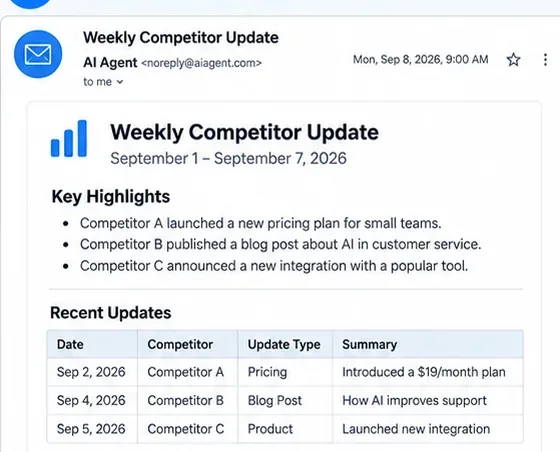
Illustration conceptuelle générée par IA d'un rapport de pilote manuel avec des liens de preuve.
Ne traitez pas les extraits de recherche comme le registre de preuve. Stockez l'URL de la source et, si vos conditions et droits d'accès le permettent, un instantané normalisé ou un texte extrait utilisé pour la comparaison. La recherche doit aider à localiser la preuve ; elle ne doit pas devenir un substitut de la preuve.
Étape 5 : Implémenter l'agent avec la recherche web, la sortie structurée et une référence
Une fois que le pilote manuel produit des découvertes utiles, intégrez l'agent dans le code. En septembre 2026, le SDK Agents Python d'OpenAI peut combiner un Agent, un WebSearchTool hébergé et un output_type structuré. L'exemple suivant est intentionnellement petit : il démontre la couche d'agent, pas la couche de stockage.
from pydantic import BaseModel
from agents import Agent, Runner, WebSearchTool

class Finding(BaseModel):
    competitor: str
    category: str
    summary: str
    source_url: str
    evidence: str
    observed_at: str
    needs_human_review: bool

class WeeklyReport(BaseModel):
    findings: list[Finding]
    executive_summary: str

agent = Agent(
    name="Weekly competitor monitor",
    instructions=(
        "Monitor only the competitors and topics in the input. "
        "Use public web sources. Every finding must include a source URL "
        "and evidence. Prefer first-party sources for product and pricing claims. "
        "Do not invent a change when no material change is supported."
    ),
    tools=[WebSearchTool()],
    output_type=WeeklyReport,
)

result = Runner.run_sync(
    agent,
    "Review the configured competitors for the reporting window and return the report."
)

report = result.final_output
L'installation du paquet et le modèle d'exécution sont documentés dans le guide de démarrage rapide officiel du SDK Agents. Le SDK documente également Runner.run_sync() comme l'encapsulation synchrone autour de l'exécution normale de l'agent.
Illustration conceptuelle générée par IA d'un flux de travail d'agent ; les détails d'implémentation dépendent de votre stack.
Ajouter une détection de changements déterministe là où c'est possible
Ne demandez pas au modèle de redécouvrir chaque ancien état à partir de la mémoire. Persistez une référence. Pour chaque source, stockez la dernière observation réussie : texte normalisé, empreinte de contenu, champs sélectionnés tels que le prix ou le nom du plan, l'horodatage de l'observation et l'URL de la source. Lors de la prochaine exécution, comparez d'abord la nouvelle observation avec la référence. Donnez ensuite à l'agent la différence à interpréter.
Cette conception hybride est plus fiable que « l'IA compare deux sites web entiers » car le code déterministe gère la comparaison exacte tandis que le modèle gère la classification, la pertinence et l'explication. Si une page ne change que son pied de page ou ses paramètres de suivi, votre normaliseur peut supprimer ce bruit avant que l'agent ne le voie.
Étape 6 : Planifier le flux de travail chaque semaine et garder les identifiants hors du code
Vous pouvez exécuter le moniteur depuis n'importe quel planificateur qui convient à votre environnement. GitHub Actions est une option pratique pour un flux de travail basé sur un dépôt. La documentation actuelle de GitHub indique que les flux de travail planifiés utilisent la syntaxe cron POSIX, s'exécutent sur la branche par défaut, sont par défaut en UTC et peuvent spécifier en option un fuseau horaire IANA. GitHub avertit également que les exécutions peuvent être retardées pendant les périodes de forte charge, surtout autour du début de l'heure, donc une minute comme 17 est préférable à 00 lorsque l'exécution exacte au début de l'heure n'est pas nécessaire. Consultez la documentation officielle de la planification GitHub Actions.
Stockez les clés API comme secrets chiffrés plutôt que de les committer dans le dépôt. Le guide officiel des secrets de GitHub explique les secrets de dépôt, d'environnement et d'organisation et recommande d'éviter la divulgation accidentelle dans les journaux de flux de travail.
Illustration conceptuelle générée par IA d'une couche de planification ; l'article utilise GitHub Actions comme exemple concret.
Un détail opérationnel est facile à manquer : GitHub indique que les flux de travail planifiés dans les dépôts publics sont automatiquement désactivés après 60 jours sans activité dans le dépôt. Si ce flux de travail est critique, surveillez le moniteur — enregistrez l'heure de la dernière exécution réussie et alertez lorsque le travail hebdomadaire attendu ne se termine pas.
Étape 7 : Placer une porte de revue humaine entre la « découverte » et la « décision »
La veille concurrentielle hebdomadaire est un flux de travail de lecture et de résumé, elle ne doit donc pas automatiquement modifier les prix, publier du contenu ou altérer une feuille de route produit. Une personne doit examiner les affirmations matérielles avant qu'elles n'influencent une décision. La revue peut être légère : approuver, rejeter, fusionner avec une autre découverte ou marquer comme « à surveiller la semaine prochaine ».
Exigez une revue plus stricte pour les catégories à fort impact telles que la tarification, les affirmations légales, les incidents de sécurité, les licenciements, les acquisitions ou les déclarations qui reposent sur des rapports tiers. Pour les changements de produit et de tarification, préférez la page propre du concurrent comme preuve principale même si une histoire d'actualité vous a aidé à la découvrir.
Illustration conceptuelle générée par IA de l'étape de revue humaine avant que les découvertes ne soient partagées ou prises en compte.
Si votre implémentation ajoute plus tard des outils capables de prendre des actions, le SDK Agents inclut des garde-fous et des mécanismes d'approbation avec intervention humaine. La documentation officielle des garde-fous décrit les garde-fous d'entrée, de sortie et d'outil, tandis que le guide sur l'intervention humaine explique comment mettre en pause les appels d'outils sensibles pour approbation.
Étape 8 : Suivre les tendances, tracer les échecs et auto-vérifier le système
Un rapport hebdomadaire utile devient plus précieux après plusieurs exécutions car vous pouvez distinguer les événements isolés des tendances. Stockez chaque découverte approuvée dans un tableau simple ou une base de données avec le concurrent, la catégorie, la date, la source et le statut de revue. Ensuite, vous pouvez répondre à des questions telles que quel concurrent a le plus souvent changé de tarification, quels thèmes reviennent dans les notes de version, ou quelles sources surveillées ne produisent plus de signaux utiles.
Illustration conceptuelle générée par IA du suivi des tendances et de l'auto-vérification sur plusieurs exécutions hebdomadaires.
Pour l'agent lui-même, maintenez l'observabilité. Le SDK Agents d'OpenAI inclut un traçage intégré qui enregistre les générations de modèles, les appels d'outils, les transferts, les garde-fous et les événements personnalisés. Le guide officiel du traçage décrit comment les traces et les spans peuvent être utilisés pour déboguer et surveiller les flux de travail. Soyez délibéré concernant les données sensibles car les charges utiles de trace peuvent inclure les entrées/sorties des modèles et des outils selon la configuration.
Auto-vérification avant de faire confiance au rapport hebdomadaire
Chaque découverte matérielle a une URL de source fonctionnelle et une date dans la fenêtre de reporting.
Les affirmations de produit et de tarification de première main sont soutenues par des preuves de première main chaque fois que possible.
Le système compare avec l'état connu précédent au lieu de simplement répéter les anciennes nouvelles.
« Aucun changement matériel » est un résultat acceptable pour n'importe quel concurrent.
Les histoires en double provenant de plusieurs médias sont fusionnées plutôt que comptées comme des changements séparés.
Le travail planifié a un horodatage de succès enregistré, et les exécutions manquées sont détectables.
Les clés API et autres identifiants sont stockés comme secrets et n'apparaissent pas dans les journaux ou les rapports.
Un humain examine les découvertes à fort impact avant que l'équipe n'agisse en conséquence.
Erreurs courantes qui rendent la veille concurrentielle par IA peu fiable
Surveiller uniquement via des requêtes de recherche
La recherche est excellente pour la découverte mais instable comme référence historique. Conservez des URL de sources explicites et persistez les observations antérieures.
Demander au modèle les « actualités importantes » sans schéma
L'importance est subjective. Définissez des catégories, des exigences de preuve et un indicateur de revue pour que la sortie puisse être auditée.
Laisser l'agent résumer sans dates
Un résultat peut être pertinent mais ancien. Incluez toujours la fenêtre de reporting et exigez une date d'observation ou de publication lorsque la source en fournit une.
Envoyer chaque élément découvert aux parties prenantes
Séparez la collecte du reporting. La couche de collecte peut trouver de nombreux éléments candidats ; le rapport final ne doit contenir que des changements soutenus par des preuves, dédupliqués et répondant à vos règles de pertinence.
Automatiser les actions trop tôt
La première version la plus sûre est en lecture seule : collecter, comparer, résumer et demander une revue. Ajoutez des actions d'écriture seulement après avoir pu mesurer les faux positifs et comprendre les modes d'échec.
Une architecture simple que vous pouvez réutiliser
Le modèle durable est : registre de sources → collecte → normalisation → comparaison de référence → analyse d'agent → découvertes structurées → revue humaine → rapport hebdomadaire → magasin de tendances. L'agent IA est le plus fort dans les étapes d'interprétation, tandis que le code ordinaire est généralement meilleur pour la planification exacte, le stockage d'état, le hachage, les nouvelles tentatives et les comparaisons déterministes.
Si le flux de travail réussit l'auto-vérification pendant plusieurs exécutions consécutives, vous pouvez vous développer avec prudence : ajouter plus de concurrents, ajouter des agents spécialisés pour les changements de tarification ou de produit, ajouter une base de données, ou router les rapports approuvés vers l'e-mail, Slack ou votre base de connaissances interne. L'objectif n'est pas de créer l'agent le plus autonome. C'est de créer le plus petit système répétable qui donne à votre équipe des changements concurrentiels opportuns et soutenus par des sources chaque semaine.