Accueil
» Domaines
»
How to Fix Lip-Sync Lag in AI Video Generators (HeyGen & ElevenLabs)
How to Fix Lip-Sync Lag in AI Video Generators (HeyGen & ElevenLabs)
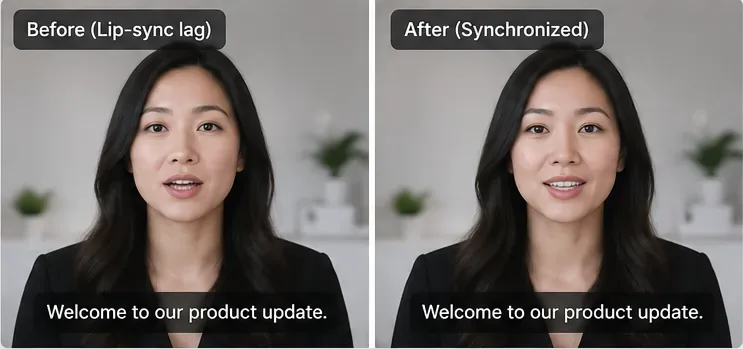
A useful 2026 clarification comes before any troubleshooting: ElevenLabs Dubbing does not currently perform lip sync by itself. ElevenLabs says lip sync is available separately in Image & Video, Flows, and Studio through dedicated third-party models. HeyGen, meanwhile, currently separates translation into Audio Only, Speed lip sync, and Precision lip sync. That means the right fix depends on where your workflow actually creates the mouth animation.
If you generate speech in ElevenLabs and then animate an avatar in HeyGen, treat the ElevenLabs file as the audio source and HeyGen as the lip-sync stage. If you use ElevenLabs Dubbing for translation, do not expect the Dubbing step alone to change mouth movements; route the finished speech into a lip-sync tool afterward. If you are translating an existing video in HeyGen, choose the lip-sync engine based on the footage rather than assuming the more expensive mode is always necessary.
This guide was checked against current HeyGen and ElevenLabs documentation on September 13, 2026. Product controls and credit rates can change, so the linked official pages are the source of truth.
First diagnose the type of lip-sync problem
“Lip-sync lag” can mean several different things. Fixing the wrong layer wastes generations and credits.
What you see
Likely problem
Best first move
The mouth is late by roughly the same amount from beginning to end
Constant audio/video offset or leading silence
Trim or shift the audio before regenerating the entire video
The first sentence matches, but drift gets worse over time
Speech duration and video timing are diverging
Regenerate at a better pace, split the scene, or use duration adaptation
Only certain words look wrong
Phoneme/articulation mismatch
Regenerate the affected sentence or use a higher-fidelity lip-sync pass
Front-facing shots work but side profiles fail
Visual tracking difficulty
Use HeyGen Precision or simplify the source shot
ElevenLabs dub sounds well timed but the original mouth never changes
Dubbing was mistaken for lip sync
Send the dubbed audio into a dedicated lip-sync model or HeyGen
Before changing settings, decide whether you have a constant offset, progressive drift, or only a few bad mouth shapes; each problem calls for a different fix.
1. Pick one audio source of truth before generating video
A common workflow mistake is generating a voice in ElevenLabs, then also letting the video tool synthesize or reinterpret the script. That creates two timing decisions instead of one. If the ElevenLabs performance is the one you want, finish that audio first and use it consistently as the source for the avatar scene.
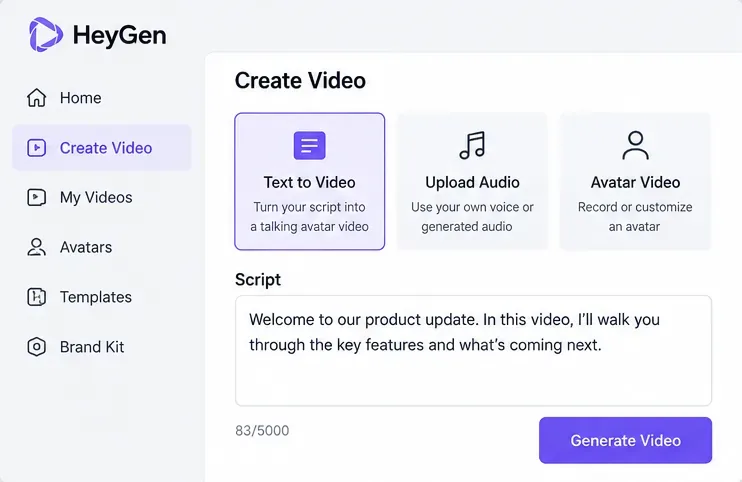
HeyGen’s current Studio documentation says custom audio can be added by uploading a prerecorded file or recording audio directly. The Studio is script-focused, and HeyGen notes that full animated-avatar previews are not available while editing because the avatar must be generated; you can preview audio before submission.
Recommendation: for expensive or long scenes, generate a short test scene first. Confirm the audio, face, and mouth behavior before committing the full runtime.
Choose one speech source for the scene. If you already approved the ElevenLabs audio, upload that audio rather than independently recreating the delivery.
2. Fix the ElevenLabs pacing before blaming the lip-sync engine
If the speech itself is rushed, unusually slow, or full of awkward pauses, the video generator has to animate that timing. Clean audio is easier to sync than audio you plan to repair after the mouth animation has already been generated.
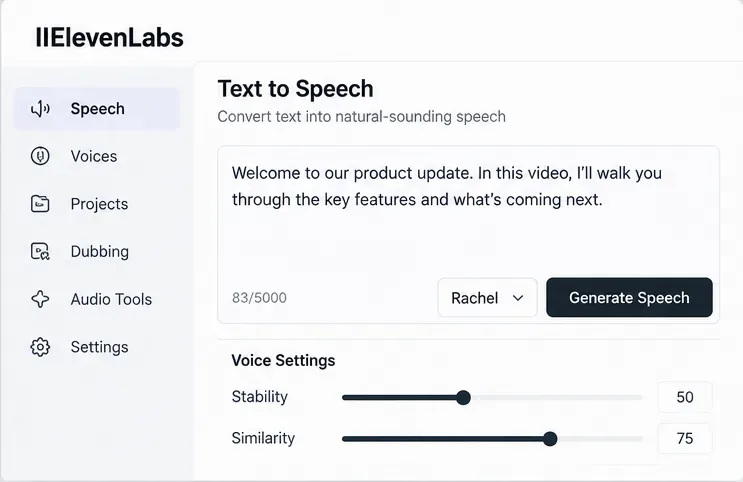
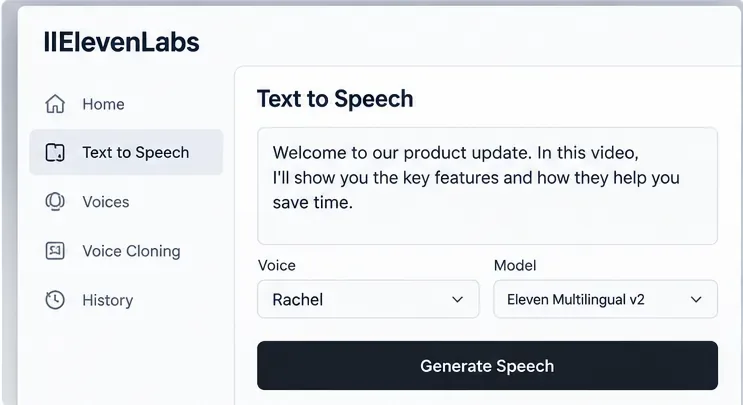
ElevenLabs currently documents a voice Speed control from 0.7 to 1.2 in Text to Speech, with 1.0 as the normal rate. The company warns that extreme values can reduce quality. Its best-practices documentation also notes that excessive pause markup can create instability or unexpected pacing.
Tradeoff: changing speed can help a sentence fit a target duration, but it also changes the performance. If the voice starts sounding rushed or unnaturally stretched, rewriting the line is usually better than pushing the speed control further.
Generate and approve the speech first. Listen for pacing problems, uneven pauses, or rushed phrases before using the file for lip sync.
ElevenLabs’ official documentation is currently inconsistent on one detail: the Help Center says the Speed setting is available for all voices and models, while the Text to Speech product guide contains a model-specific note saying Speed is not available for Eleven v3. Because both statements are official, check the controls actually shown for the model you select rather than assuming a speed slider will always be present.
Action: if the selected model does not expose Speed, control timing through wording, punctuation, model-specific audio tags, or a different supported model instead of relying on a nonexistent control.
3. Remove avoidable silence and check for a constant offset
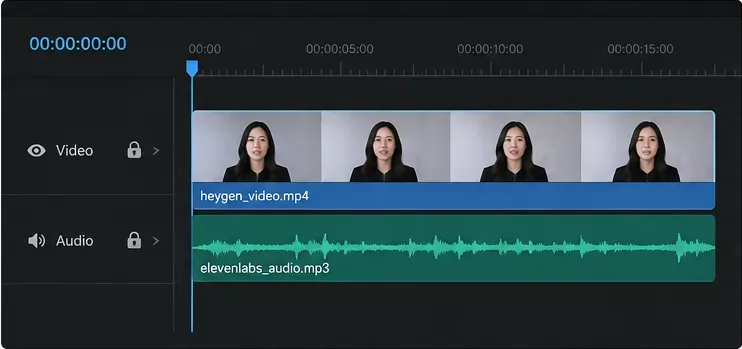
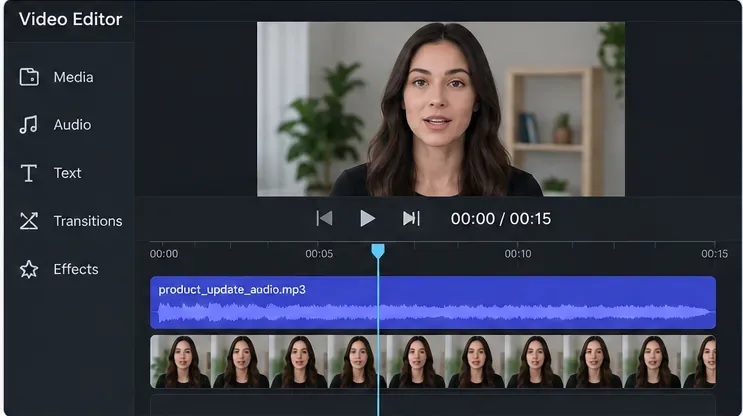
If the mouth is consistently late or early by the same amount, changing the AI model may be unnecessary. Inspect the audio file in a timeline. A small lead-in before the first spoken consonant, or an audio clip placed a few frames away from the intended start, can create the appearance of a failed lip-sync generation.
Par exemple, un décalage de quatre images à 30 images par seconde correspond à environ 133 millisecondes. C'est suffisamment long pour paraître incorrect lors de la prononciation en gros plan, même si l'animation de la bouche est cohérente.
Action : alignez le premier signal vocal clair avec le début visuel attendu. Si le décalage persiste après la génération, modifiez la position audio dans un logiciel de montage vidéo au lieu de régénérer chaque élément.
Pour un décalage constant, examinez la forme d'onde et les points de départ de l'écrêtage avant de dépenser des crédits pour une nouvelle génération d'avatar.
4. Utilisez des segments plus courts lorsque la dérive augmente avec le temps.
Un décalage progressif diffère d'un décalage fixe. Si les premières secondes semblent correctes et que la bouche se décale progressivement, la durée de la parole ne correspond pas suffisamment au rythme visuel. Les scènes longues et continues amplifient les petits décalages temporels.
Découpez un long récit en phrases ou séquences logiques plus courtes, générez-les séparément, puis assemblez-les. Vous obtenez ainsi une unité plus petite à régénérer si une seule section est erronée. Le guide Voice Mirror de HeyGen recommande également de commencer par de courts segments pour apprivoiser le rythme et le comportement de traitement souhaités.
Compromis : des segments plus courts facilitent les corrections, mais trop de coupes peuvent nuire à l’homogénéité du ton et de l’ambiance. Conservez les mêmes réglages vocaux et évitez de changer de style d’interprétation entre les segments, sauf si le script l’exige.
Commencez par tester une courte phrase. Une fois le timing validé, étendez le processus à des scènes plus longues au lieu de déboguer une vidéo entière d'un coup.
5. Dans HeyGen Video Translation, choisissez Vitesse ou Précision en fonction de la prise de vue.
Le système de traduction vidéo actuel de HeyGen propose trois moteurs de traduction :
Audio uniquement : traduit et redouble sans synchronisation labiale.
Vitesse : synchronisation labiale optimisée pour la vidéo frontale, l’occlusion faciale limitée et les conversations plus simples.
Précision : synchronisation labiale de meilleure qualité conçue pour les profils latéraux, les changements d'angle de caméra, les occlusions faciales, les changements d'interlocuteur et les conversations plus complexes.
Au 13 septembre 2026, le centre d'aide de HeyGen indique un tarif de 6 crédits par minute pour la vitesse et de 10 crédits par minute pour la précision, selon son système de crédits actuel. Ce tarif permet de comprendre le compromis entre les deux, mais il est conseillé de vérifier le produit avant de générer un document, car les prix peuvent évoluer.
Recommandation : utilisez le mode Vitesse pour une seule personne qui reste à environ 45 degrés de la caméra et dont le visage est bien visible. Passez au mode Précision si le suivi de la séquence est plus difficile. Dépenser plus de crédits ne corrigera pas un mauvais son source ; commencez donc par régler le rythme.
HeyGen recommande également des gros plans, un minimum de changements de plan, une réduction du bruit de fond et une seule personne parlant à la fois pour une meilleure synchronisation labiale de la traduction.
6. Utilisez la durée dynamique lorsque le discours traduit nécessite plus d'espace.
Il arrive que différentes langues mettent exactement le même temps à exprimer la même idée. Les paramètres avancés de HeyGen incluent l'option « Durée dynamique » , qui permet d'étirer ou de compresser la durée des segments jusqu'à ±20 % afin d'obtenir une traduction plus naturelle. HeyGen précise que cela peut modifier la durée totale de la vidéo.
Choisissez Durée dynamique lorsque : le déroulement naturel du spectacle prime sur le respect de la durée d'exécution originale exacte.
Évitez de vous y fier lorsque la vidéo doit être parfaitement synchronisée avec la musique, des éléments graphiques fixes, des séquences de diffusion ou des repères temporels externes. Dans ce cas, réécrivez la traduction ou ajustez d'abord le minutage vocal d'ElevenLabs.
Lorsque le temps d'exécution est important, régénérez la ligne de dialogue jusqu'à ce que sa durée naturelle corresponde à la scène au lieu d'imposer une correction de synchronisation importante en aval.
7. Ne vous attendez pas à ce que le doublage d'ElevenLabs se charge à lui seul de l'animation de la bouche.
Il s'agit de la principale différence de flux de travail entre les deux plateformes. La documentation actuelle d'ElevenLabs concernant le doublage indique clairement que celui-ci n'inclut pas la synchronisation labiale. Les outils de synchronisation labiale sont disponibles séparément dans ElevenLabs Image & Video, Flows et Studio, via des modèles spécialisés.
ElevenLabs Dubbing v2 est actuellement décrit comme une version alpha. Il préserve le timing, le ton et les caractéristiques des locuteurs, mais le flux de travail web par défaut de la v2 est automatique et ne propose pas d'édition de transcription intégrée. L'édition de transcription et la régénération audio via l'API v2 sont actuellement réservées aux entreprises. Dubbing Studio, basé sur la v1, reste disponible mais est en mode maintenance et ne reçoit que des correctifs pour les bogues critiques.
Pour un flux de travail HeyGen + ElevenLabs : générez ou doublez le discours final dans ElevenLabs, puis téléchargez cet audio approuvé sur HeyGen pour l’animation de la bouche.
Lorsque ElevenLabs fournit la piste vocale finale, utilisez ce fichier approuvé comme entrée pour l'étape de synchronisation labiale plutôt que de vous attendre à ce que l'étape de doublage modifie les mouvements de la bouche.
Et si vous vouliez rester entièrement à l'intérieur d'ElevenLabs ?
ElevenLabs Image & Video propose actuellement des modèles de synchronisation labiale dédiés aux images ou vidéos sources, ainsi qu'à l'audio vocal. La documentation mentionne des options telles que HeyGen Avatar 4, Sync 3, Sync Lipsync 2 Pro, Veed Lipsync, et d'autres. La disponibilité peut varier selon le modèle et la région ; par exemple, la documentation indique qu'OmniHuman 1.5 n'est pas disponible aux États-Unis.
Compromis : travailler dans un seul espace simplifie la gestion des ressources, mais il s’agit de post-traitements ou de modèles d’avatars distincts, avec leurs propres coûts et contraintes. À ne pas confondre avec la fonction de doublage.
8. S'il ne reste qu'un décalage constant résiduel, corrigez-le une seule fois dans l'éditeur final.
Une fois le rythme, la source audio et le mode de synchronisation labiale corrigés, un léger décalage constant peut subsister. Si la bouche est en avance ou en retard de la même valeur tout au long du clip, un dernier ajustement de la timeline est souvent plus économique et plus fiable qu'une nouvelle génération complète.
Déplacez la piste audio de quelques images, prévisualisez les consonnes occlusives comme p , b et m , et vérifiez au moins trois points : le début, le milieu et la fin. Si le décalage varie, n’ajustez pas la piste entière ; revenez au rythme ou à la durée des segments, car il s’agit d’une dérive et non d’un décalage fixe.
Un éditeur final est préférable pour un léger décalage constant. La dérive progressive doit être corrigée plus tôt en modifiant la durée de la parole ou en régénérant le segment affecté.
Comment contrôler les pauses dans ElevenLabs ?
La gestion des pauses dépend du modèle. ElevenLabs indique qu'Eleven v3 utilise des balises audio et la ponctuation plutôt que les balises de coupure SSML. Multilingual v2, Flash v2 et Flash v2.5 prennent en charge <break time="1.5s" />les pauses de type SSML jusqu'à trois secondes. L'entreprise prévient qu'un nombre excessif de balises de coupure peut entraîner des variations de vitesse, du bruit ou d'autres artefacts.
Recommandation : utilisez le minimum de pauses nécessaire pour que le texte reste naturel. Si une phrase traduite nécessite de nombreuses pauses artificielles pour s’adapter au rythme visuel, reformulez-la ou divisez le plan.
Que se passe-t-il si l'avatar HeyGen personnalisé lui-même a une mauvaise synchronisation labiale ?
Si toutes les répliques générées sont incohérentes, même avec un son clair, le problème peut provenir de la vidéo d'entraînement de l'avatar plutôt que du fichier vocal actuel. Selon les recommandations de HeyGen concernant les jumeaux numériques, la vidéo d'entraînement doit inclure la personne qui parle, car l'audio et la vidéo sont essentiels à la synchronisation labiale du système. L'entreprise recommande une résolution d'au moins 1080p à 30 images par seconde, un éclairage uniforme et lumineux, ainsi qu'un son clair sans écho important ni bruits parasites.
Action : si l’avatar rencontre systématiquement des difficultés sur plusieurs scripts propres, envisagez de le réentraîner avec de meilleures séquences sources avant de passer du temps à micro-ajuster chaque clip généré.
Vidéo à tête parlante rapide avec narration approuvée par ElevenLabs
Générez d'abord l'audio pour ElevenLabs, puis téléchargez-le sur HeyGen Studio.
Flux de travail simple, mais l'avatar final nécessite tout de même une étape de génération.
Traduire une simple vidéo source frontale
Traduction vidéo rapide avec HeyGen
Coût en crédits inférieur à celui de Precision, mais moins adapté aux prises de vue complexes.
Traduire des profils latéraux, des occlusions ou des séquences multi-intervenants
Traduction vidéo HeyGen avec précision
Utilisation accrue du crédit en échange d'une meilleure fidélité de la synchronisation labiale
Audio traduit de haute qualité sans animation de la bouche
Doublage ElevenLabs
Le doublage préserve le rythme et les caractéristiques vocales, mais ne réalise pas de synchronisation labiale.
Conservez la parole et la synchronisation labiale dans ElevenLabs
ElevenLabs Image & Vidéo avec un modèle de synchronisation labiale dédié
La disponibilité des modèles, leur coût et les restrictions régionales varient.
Il ne reste plus qu'un petit décalage fixe.
Décaler l'audio dans un éditeur vidéo normal
Rapide et économique, mais adapté uniquement à un décalage constant, et non à une dérive.
Liste de vérification finale pour le dépannage
Vérifiez si l'erreur est due à un décalage constant, à une dérive progressive ou à une inadéquation au niveau des mots.
Approuvez l'audio d'ElevenLabs avant de générer la vidéo de l'avatar.
Évitez les changements extrêmes de débit de parole dans le seul but de contraindre la phrase à une durée donnée.
Utilisez les commandes de pause appropriées au modèle et évitez les balises de pause excessives.
Supprimez les silences initiaux évidents et vérifiez la première consonne prononcée.
Utilisez des scènes plus courtes lorsque la dérive augmente avec le temps.
Choisissez HeyGen Speed pour les prises de vue frontales simples et Precision pour les angles difficiles ou en cas d'occlusion.
N'utilisez la durée dynamique que lorsque la modification de la durée d'exécution totale est acceptable.
N'oubliez pas que le doublage d'ElevenLabs ne comprend pas à lui seul l'animation de la bouche.
Utilisez un dernier décalage de la timeline uniquement pour un décalage constant qui ne s'étend pas sur toute la longueur du clip.
En résumé
La meilleure solution pour corriger le décalage labial ne réside pas dans un simple réglage, mais dans un diagnostic. Si l'ensemble du clip présente le même décalage, corrigez-le. Si le décalage s'accentue avec le temps, ajustez le rythme ou la durée des segments. Si seuls les angles difficiles posent problème, utilisez un mode de synchronisation labiale plus fort. Si vous utilisez ElevenLabs Dubbing, ajoutez une étape de synchronisation labiale distincte, car le logiciel de doublage lui-même n'anime pas la bouche.
Pour la plupart des flux de travail HeyGen + ElevenLabs, la méthode la plus simple consiste à finaliser la parole propre dans ElevenLabs, à tester un court segment dans HeyGen, à choisir la vitesse ou la précision en fonction du métrage source et à réserver la correction externe de la timeline aux petits décalages constants qui subsistent après la génération.