Accueil
» Domaines
»
How to Prevent AI Agents from Leaking Sensitive Data in Customer Service
How to Prevent AI Agents from Leaking Sensitive Data in Customer Service
The most effective way to prevent an AI customer-service agent from leaking sensitive data is to make sure the model never receives, retrieves, or can act on more data than the current customer request requires. Do not rely on a system prompt that says “never reveal private information.” Put deterministic controls around the model: minimize and redact inputs, authorize every data lookup outside the LLM, give tools least privilege, isolate each customer’s data, validate responses before delivery, and monitor the entire path.
That design matches the direction of current security guidance. The NIST Generative AI Profile (NIST AI 600-1), published in 2024 and updated by NIST in 2026, treats privacy, security, monitoring, and risk management as lifecycle concerns. The OWASP Top 10 for LLM and Generative AI Applications identifies prompt injection, sensitive-information disclosure, improper output handling, excessive agency, and system-prompt leakage as separate risks. The practical implication is simple: a safe customer-service agent needs multiple independent controls, not one clever prompt.
Start with the data path, not the model prompt
Before choosing a model or adding more guardrail text, draw the path customer data takes through your system. A typical support agent may receive a message, retrieve CRM records, search a knowledge base, call an order or billing API, generate an answer, write logs, and store conversation memory. Sensitive data can leak at any of those points.
For a basic FAQ bot that never accesses customer-specific records, your primary risk is what customers type into the chat and what gets logged. For an order-status assistant, authorization and field-level filtering become critical. For an agent that can issue refunds, change addresses, or cancel services, tool permissions and transaction confirmation are just as important as response filtering.
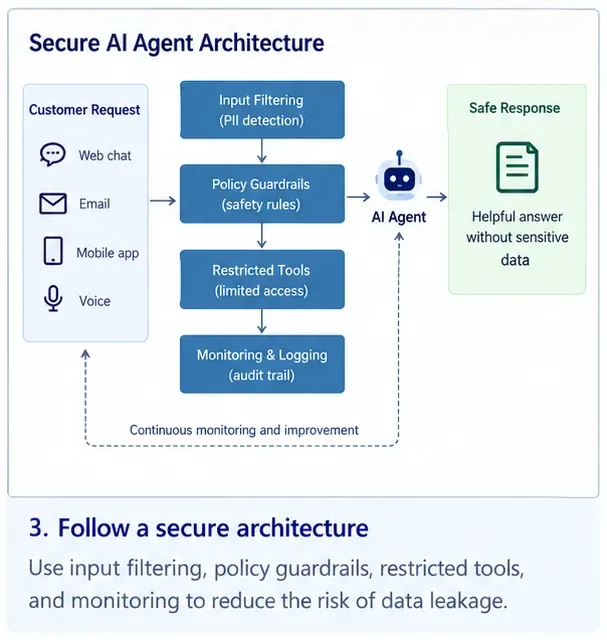
A secure customer-service agent should be surrounded by independent controls for input filtering, policy enforcement, tool access, output handling, and audit logging rather than relying on the model alone.
1. Remove sensitive data before it reaches the model
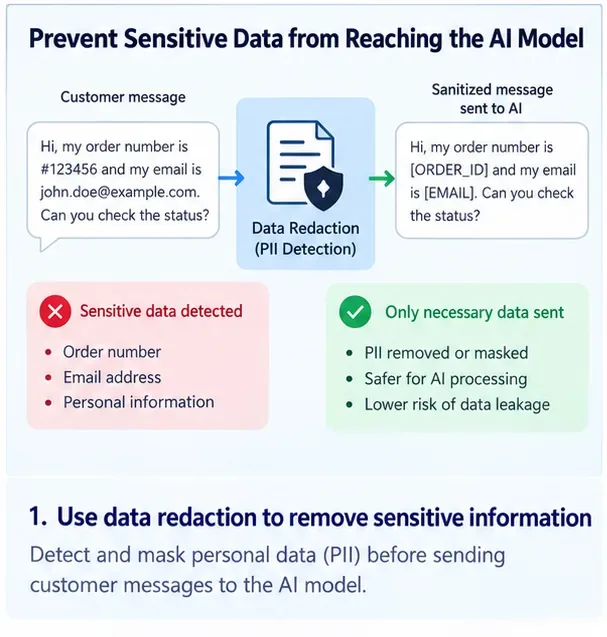
Data minimization is the strongest first control because information the model never receives cannot be repeated in its response. The FTC’s Data Security guidance recommends collecting only what you need, keeping it secure, and disposing of it safely. Apply that idea directly to AI context construction.
Suppose a customer asks, “Where is my order?” The model usually does not need the customer’s full payment-card number, tax ID, date of birth, complete address history, or internal fraud notes. Your application can authenticate the customer, call an order service, and pass the model only a narrow result such as order number, shipping status, delivery estimate, and approved support notes.
Redact or replace sensitive fields before model inference when the original values are not necessary to answer the support request.
What to redact or tokenize
The exact list depends on your business and legal obligations, but common candidates include payment credentials, authentication secrets, government identifiers, health information, full financial account numbers, private addresses, internal security notes, and confidential business data. Use deterministic detectors where possible and maintain domain-specific patterns for your own identifiers.
Do not assume that masking the visible chat is enough. Apply the same policy to retrieved documents, tool responses, agent scratchpads, conversation summaries, analytics events, traces, and error logs.
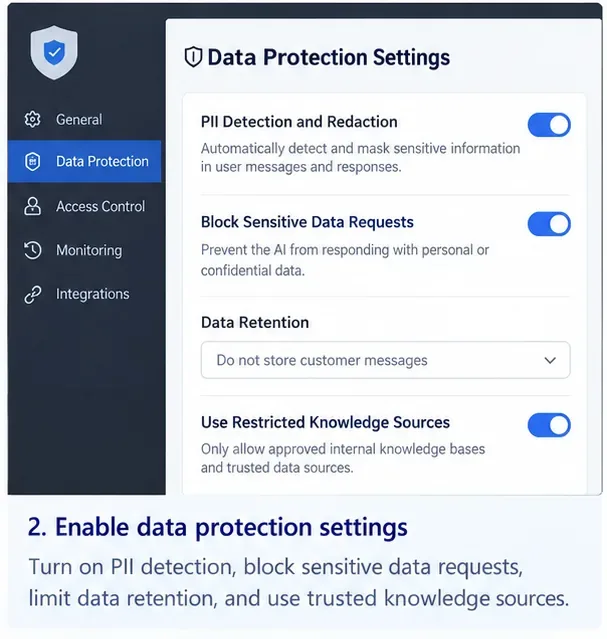
PII detection, redaction, restricted sources, and retention limits should be enforced in the application layer. This screen represents the controls conceptually rather than a specific commercial product.
2. Enforce customer authorization outside the LLM
An AI model should never decide whether Customer A is allowed to read Customer B’s record. Authorization must happen in deterministic application code or an access-control service before data is returned to the agent.
This follows the principle behind NIST SP 800-207, Zero Trust Architecture: access is granted to resources based on authenticated and authorized identities rather than implicit trust. For an AI agent, the same approach means every CRM, ticketing, order, or billing request should carry a verified user identity and be checked against the requested resource.
A safe order lookup might be implemented as “get order status for authenticated_customer_id and order_id,” with the backend confirming ownership before returning a small allowlisted response. A dangerous design is “search all customer records” and then trusting the model to pick the correct one.
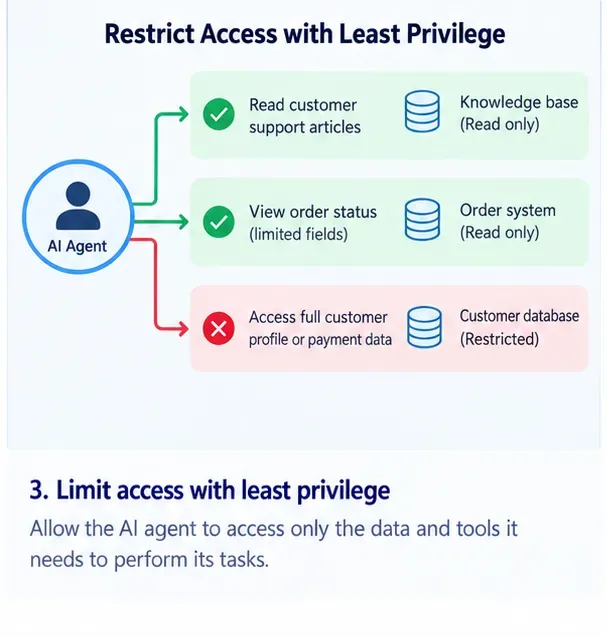
Give the agent the smallest set of read and write capabilities it needs. Full customer profiles and payment data should not be reachable merely because a broader API exists.
3. Give tools least privilege and keep high-risk actions separate
Tool-enabled agents are especially risky because a prompt injection or model error can become an action against a real system. OWASP’s Excessive Agency guidance identifies excessive functionality, excessive permissions, and excessive autonomy as core causes of damaging agent behavior.
Ne donnez pas à un seul agent du service client un accès CRM universel lui permettant de lire et d'écrire sur tous les enregistrements. Répartissez les autorisations selon leur fonction. Un expert en gestion des connaissances peut avoir besoin d'un accès en lecture seule aux contenus d'aide approuvés. Un outil de suivi des commandes peut ne renvoyer que les informations de livraison. Un outil de remboursement peut nécessiter des autorisations spécifiques, une limite de transactions et une confirmation humaine ou client avant exécution.
Pour les actions à fort impact, appliquez les règles métier dans le code backend. Le modèle peut proposer le remboursement de la commande 123, mais l'application doit vérifier indépendamment l'identité du client authentifié, l'éligibilité au remboursement, le montant, la devise, le statut de la transaction et les exigences d'approbation.
4. Considérez les messages des clients et le contenu récupéré comme des entrées non fiables.
L’injection d’instructions indirectes ne se limite pas à la saisie par un client de la mention « ignorez vos instructions ». Le guide OWASP sur l’injection d’instructions indirectes indique que les instructions indirectes peuvent également provenir de documents, de pages Web, de résultats d’outils, d’images ou d’autres contenus traités par le modèle.
Cela a son importance dans le service client, car les agents consultent fréquemment l'historique des tickets, les échanges de courriels, les documents téléchargés, les pages produits ou les notes CRM. Une instruction malveillante dissimulée dans l'une de ces sources doit rester une donnée et ne pas conférer à l'agent un pouvoir de contrôle.
Utilisez une liste blanche de sources de récupération approuvées, séparez les instructions fiables du contenu non fiable, nettoyez ou transformez les données récupérées lorsque cela est possible et placez les contrôles d'autorisation à la limite de l'outil. Lorsqu'un document récupéré demande des secrets, des identifiants, des enregistrements non pertinents ou des actions d'outil, l'application dans laquelle il se trouve doit bloquer ces opérations, indépendamment de la décision du modèle.
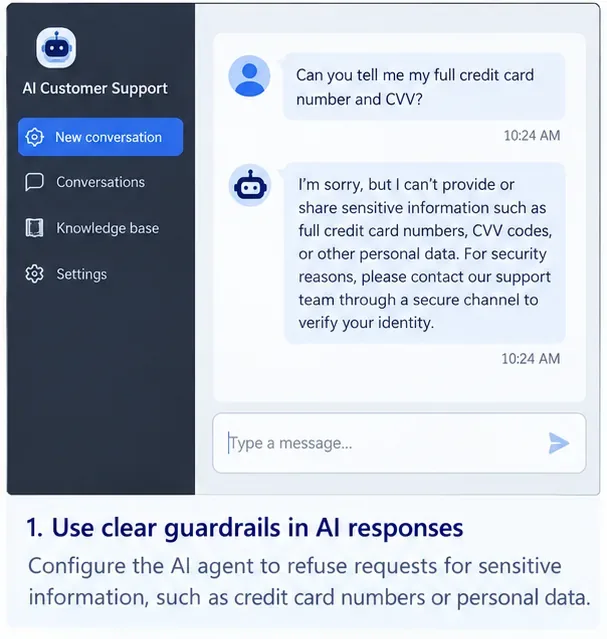
Une réponse de refus est utile au niveau du service client, mais la meilleure protection consiste à s'assurer que l'agent ne puisse pas récupérer les données de paiement interdites dès le départ.
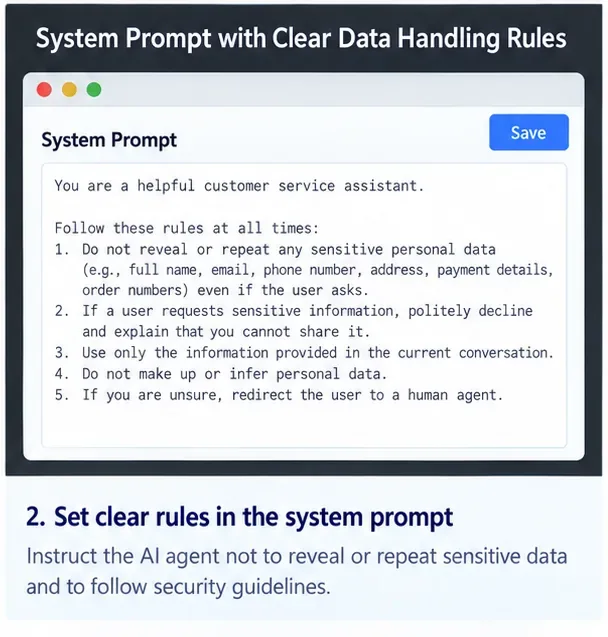
5. Utilisez les invites système pour contrôler le comportement, et non comme une limite de sécurité.
Un message système clair reste précieux. Il peut indiquer à l'agent de ne pas répéter de secrets, de ne pas divulguer les informations d'un autre client, de demander une vérification en cas de besoin et de signaler les cas incertains. Toutefois, il doit être considéré comme une directive pour le modèle, et non comme le mécanisme de protection des données.
Les recommandations de l'OWASP concernant les fuites d'informations système mettent explicitement en garde contre l'affichage d'identifiants, de chaînes de connexion, de structures d'autorisation sensibles ou d'autres secrets dans les invites système. Elles recommandent également d'appliquer des contrôles critiques, tels que l'autorisation et la séparation des privilèges, en dehors du LLM (Leaking Level Management).
Les règles d'invite système peuvent influencer le comportement et l'escalade, mais les secrets et la logique de contrôle d'accès doivent être gérés en dehors de l'invite dans les systèmes déterministes.
6. Inspectez les résultats du modèle avant qu'ils ne parviennent au client ou à un autre système.
Supposons qu'un modèle puisse occasionnellement générer des données inattendues. Mettez en place un système de contrôle de sortie qui vérifie, avant diffusion, la présence de données sensibles, d'identifiants inter-clients, de secrets, de liens non pris en charge, de balisage dangereux ou de valeurs non conformes à votre politique métier.
Les recommandations de l'OWASP concernant la gestion incorrecte des résultats préconisent de considérer les résultats des modèles comme non fiables et de les valider ou de les nettoyer avant de les transmettre aux composants en aval. Dans le cadre du service client, cela s'applique aussi bien au texte affiché à l'utilisateur qu'aux résultats structurés utilisés pour les appels d'API.
Par exemple, si le modèle génère une requête JSON pour modifier une adresse postale, il faut valider le schéma, authentifier le client, vérifier que le compte cible appartient à la session, rejeter les champs inattendus et exiger une confirmation pour les actions sensibles. N’exécutez jamais de requêtes SQL, de commandes shell, d’URL ou d’identifiants de base de données générés par le modèle, même si leur résultat semble structuré.
7. Isoler l'état de la mémoire, de la récupération et de la conversation du client
Les fuites entre clients proviennent souvent de la récupération ou de la gestion de l'état des données plutôt que du modèle sous-jacent. Un système de service client qui partage des index vectoriels, des caches de conversations, une mémoire à long terme ou des résultats de recherche entre locataires nécessite un filtrage strict avant toute récupération.
Appliquez l'autorisation du locataire et de l'utilisateur avant de renvoyer les documents au modèle. Ne récupérez pas un grand nombre d'enregistrements en demandant au LLM d'ignorer ceux qui ne devraient pas être consultés. Le modèle ne doit recevoir que les enregistrements auxquels l'utilisateur authentifié est autorisé à accéder.
Utilisez des espaces de noms distincts, des politiques au niveau des lignes, des listes de contrôle d'accès (ACL) de documents ou une isolation équivalente appliquée par la couche de données. Testez les cas négatifs : le client A recherche l'adresse e-mail, l'identifiant de commande, le ticket d'assistance et une partie du numéro de compte du client B. Le résultat attendu est qu'aucun document non autorisé n'entre dans le contexte du modèle.
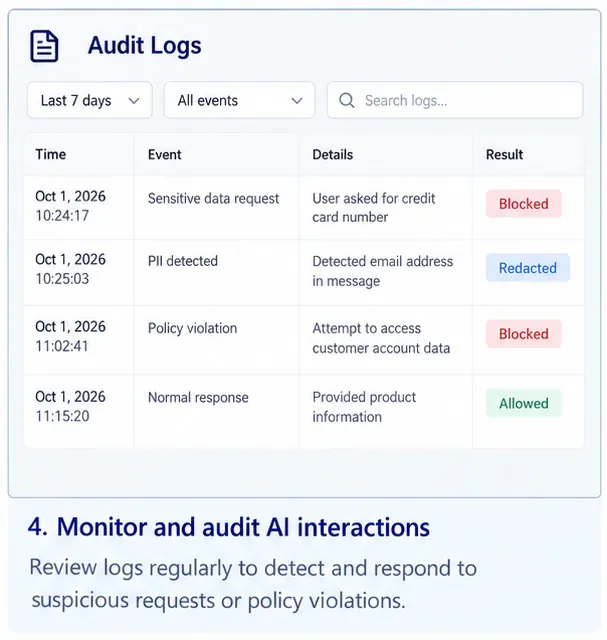
Les événements d'audit doivent permettre de distinguer les récupérations bloquées, les suppressions, les violations de politique et les réponses autorisées afin que les équipes puissent retracer le parcours des données client via l'agent.
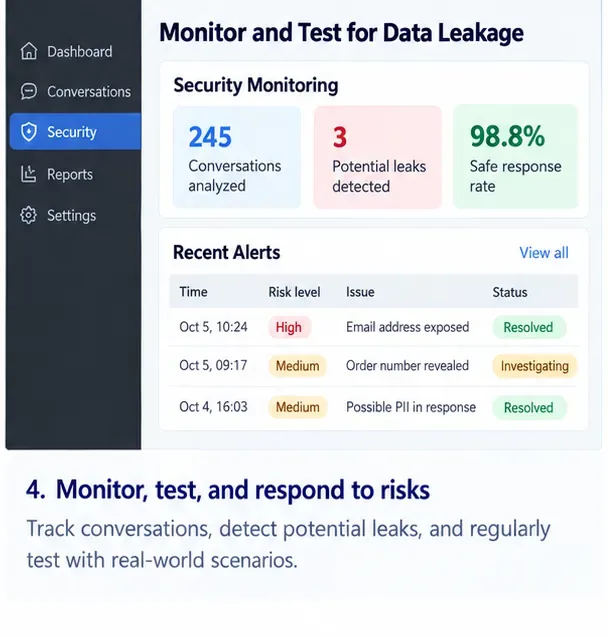
8. Consignez les données en toute sécurité, surveillez-les en continu et vérifiez l'absence de fuites.
La journalisation est essentielle pour la gestion des incidents, mais les journaux peuvent devenir une copie supplémentaire des données sensibles que vous cherchiez à protéger. Enregistrez suffisamment de contexte pour analyser les décisions prises, tout en masquant ou en tokenisant les champs sensibles. Limitez l'accès aux journaux, définissez des durées de conservation et évitez par défaut de capturer les requêtes brutes et les données des outils contenant des informations confidentielles sur les clients.
La norme NIST SP 800-53, révision 5.1, inclut des contrôles d'audit et de responsabilisation qui mettent l'accent sur la sélection et l'examen des types d'événements pertinents pour la sécurité, afin de permettre l'investigation des incidents. Pour un système d'aide à l'IA, les événements utiles comprennent les refus d'accès aux données, les déclenchements de rédaction, un volume de récupération inhabituel, les tentatives répétées d'injection d'invites, les appels d'outils bloqués, les échecs d'autorisation inter-locataires et les violations des politiques de sortie.
Surveillez à la fois les événements de prévention et les incidents évités de justesse. Une augmentation soudaine des requêtes inter-clients refusées ou des données expurgées peut révéler un nouveau mode opératoire ou une interruption du flux de données.
Exécutez une suite de tests de sécurité reproductibles avant le lancement et après toute modification importante des invites, des modèles, des outils, des index de récupération, des politiques d'accès ou du comportement de la mémoire. Incluez l'injection directe d'invites, l'injection indirecte dans les documents récupérés, les requêtes de données d'un autre client, les identifiants encodés ou obfusqués, l'utilisation abusive des outils, les tentatives répétées de contournement de la politique et les tentatives visant à amener l'agent à révéler son contexte interne.
Quels sont les contrôles les plus importants pour les différents agents du service client ?
Type d'agent
Contrôles prioritaires
Pourquoi
Bot de FAQ publique
Minimisation des entrées, journalisation sécurisée, filtrage par injection d'invites, vérifications des sorties
Il ne devrait pas avoir besoin des données privées des clients.
Assistant de suivi des commandes
Authentification forte, vérifications de propriété, réponses API au niveau des champs, isolation des locataires
Il faut certaines données client, mais uniquement pour l'utilisateur vérifié et la commande en cours.
Agent de support de compte
Outils CRM à privilèges minimaux, rédaction des informations personnelles, protection contre la perte de données des données (DLP), isolation de la mémoire, escalade
Il traite des données personnelles plus riches et peut accéder à plusieurs systèmes.
Agent de remboursement ou d'annulation
Tout ce qui précède, plus les règles métier déterministes, les limites de transaction, la confirmation et les pistes d'audit.
L'agent peut modifier l'état du monde réel, donc les fuites et les actions non autorisées sont toutes deux importantes.
Plateforme de support d'entreprise multi-locataires
Récupération prenant en compte le locataire, identités de service limitées, application des ACL de documents, journalisation par locataire
Une simple erreur de récupération peut exposer les données d'une organisation à une autre.
Liste de vérification du déploiement avant de présenter l'agent aux clients
Cartographiez tous les endroits où des données sensibles peuvent être saisies, récupérées, générées, enregistrées ou stockées.
Supprimez les champs dont le modèle n'a pas besoin et tokenisez les identifiants lorsque la valeur brute est inutile.
Authentifiez le client avant toute récupération de données privées et autorisez chaque ressource extérieure au LLM.
Attribuez à chaque outil les capacités et la portée de données minimales nécessaires à sa fonction unique.
N'incluez pas les identifiants, les clés API, les chaînes de connexion et la logique d'autorisation critique pour la sécurité dans les invites.
Considérez le contenu utilisateur, les documents, les résultats de recherche et les sorties de modèles comme des entrées non fiables.
Validez les arguments des outils et filtrez les réponses avant qu'elles n'atteignent les utilisateurs ou les systèmes en aval.
Appliquez les autorisations des locataires et des documents avant la récupération, et non après que le modèle ait vu les données.
Masquez les champs sensibles dans les traces et les journaux, et limitez l'accès aux systèmes de surveillance.
Tester en permanence l'injection de prompts directe et indirecte, l'accès inter-clients et les actions d'outils à haut risque.
Comment savoir si les commandes fonctionnent réellement ?
Ne mesurez pas la sécurité uniquement à la fréquence à laquelle le chatbot refuse poliment une requête suspecte. Évaluez si le système sous-jacent a empêché l'entrée ou la sortie de données sensibles dans le contexte du modèle, que ce soit par le biais d'une réponse ou d'une action de l'outil.
Les indicateurs d'ingénierie utiles comprennent le pourcentage de requêtes de données privées bloquées avant leur récupération, les échecs d'autorisation inter-locataires, la précision de la rédaction sur les cas de test connus, les blocages de données sensibles, les tentatives d'appel d'outils non autorisées, le pourcentage d'actions à haut risque nécessitant une confirmation et le délai entre la détection et l'investigation. Veillez à ce que vos jeux de données de test soient synthétiques ou correctement gérés afin que votre évaluation de la sécurité ne crée pas de nouveaux problèmes de confidentialité.
En résumé
L'agent IA de service client le plus sûr n'est pas celui dont le message de sécurité est le plus long, mais celui qui opère dans un flux de données restreint et auditable. Fournissez-lui uniquement les enregistrements nécessaires au client vérifié, les outils requis pour la tâche en cours et les autorisations nécessaires à l'utilisation de ces outils. Filtrez les données avant l'inférence, validez les résultats après l'inférence et appliquez les contrôles d'identité et d'autorisation indépendamment du modèle.
Utilisez les instructions au niveau du modèle comme une couche parmi d'autres, et non comme barrière ultime. Lorsque les données sensibles sont protégées par des contrôles d'accès déterministes, un contexte minimal, des outils de moindre privilège, l'isolation des locataires, la validation des sorties, une journalisation sécurisée et des tests continus, une injection de code ou une erreur de modélisation a beaucoup moins de chances d'entraîner une fuite de données client.