Accueil
» Domaines
»
Ollama vs LM Studio: Which Is Better for Local AI Agent Development in 2026?
Ollama vs LM Studio: Which Is Better for Local AI Agent Development in 2026?
The answer changed in 2026. Ollama is no longer just a small command-line model runner, and LM Studio is no longer just a desktop GUI for chatting with local models. Ollama added Anthropic-compatible APIs and a one-command ollama launch workflow for coding tools such as Claude Code, Codex, and OpenCode. LM Studio 0.4.0 introduced llmster for true headless deployment, a stateful REST API, parallel serving, and MCP access through the API. For local AI agent development, both are now serious developer platforms.
Short answer: choose Ollama when you want the shortest path from terminal to local model server, already have your own agent framework, or want easy integration with coding agents and automation scripts. Choose LM Studio when you want built-in model discovery plus a developer server with stateful chats, MCP integrations, first-party Python/TypeScript SDKs, and an automatic multi-round agent API. Neither is universally better; the right choice depends on which layer of the agent stack you want the runtime to manage.
This comparison was checked against current Ollama and LM Studio documentation on September 13, 2026.
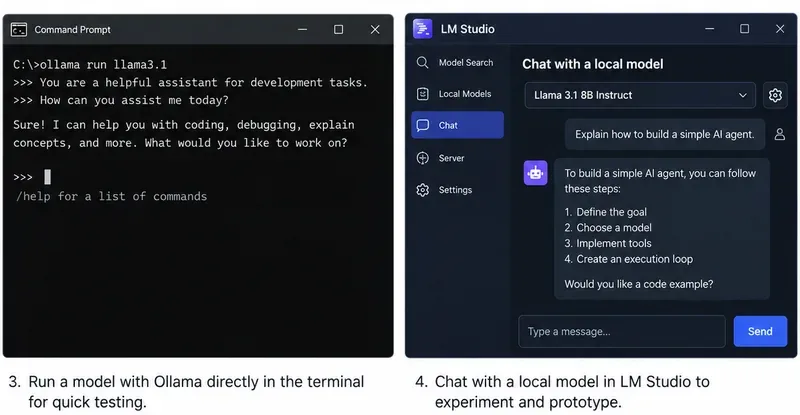
Ollama remains naturally terminal-first, while LM Studio combines a desktop workflow with a full developer server. The image is a workflow illustration rather than a version-specific benchmark.
What changed enough in 2026 to affect the decision?
Two updates narrowed the gap substantially.
First, Ollama added Anthropic Messages API compatibility in January 2026 and then introduced ollama launch, which can configure and start supported coding tools with Ollama models without manually editing environment variables or configuration files. Ollama’s current integrations documentation includes Claude Code, Codex, OpenCode, Copilot CLI, Cline, Roo Code, JetBrains, VS Code, n8n, and other tools. See Ollama’s announcement of ollama launch, Ollama’s Anthropic compatibility documentation, and Ollama integrations.
Second, LM Studio 0.4.0 separated the core runtime from the desktop app through llmster, making headless use on servers and CI a first-class option. Its native v1 REST API now supports stateful conversations, authentication, model download/load/unload operations, and MCP integrations. LM Studio also exposes OpenAI-compatible and Anthropic-compatible endpoints. See LM Studio 0.4.0 release notes and LM Studio v1 REST API documentation.
Practical consequence: “CLI versus GUI” is no longer an adequate comparison. The more useful question is whether you want a lean inference runtime that plugs into an existing agent stack, or a local AI development environment that also provides agent-oriented orchestration features.
Which is easier if you already have an agent framework?
Ollama usually wins for simplicity. Its native API runs at http://localhost:11434, and it also implements OpenAI-compatible and Anthropic-compatible endpoints. If your code already uses an OpenAI client, a framework that accepts a configurable base URL, or a coding tool supported by Ollama, switching the backend can be a small configuration change.
Ollama’s tool-calling API supports single tool calls, parallel tool calls, streaming tool calls, and multi-turn tool-calling loops. The documentation shows an agent loop where your Python or JavaScript code executes the requested function, returns the result to the model, and repeats until the model stops asking for tools. See Ollama tool-calling documentation.
A minimal OpenAI-compatible connection looks like this:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"
)
Best fit: LangChain-style applications, your own Python agent loop, coding assistants, CI jobs, shell automation, or any project where you mainly need a dependable local model endpoint and prefer to own the orchestration logic yourself.
Which is better if you want agent orchestration built into the local stack?
LM Studio has the clearer advantage here. Its Python and TypeScript SDKs include an .act() API specifically designed for multi-round tool use. You give the model a task and tools; the SDK can execute requested tools, pass results back to the model, and continue for additional rounds until the model returns a final response or the process ends.
LM Studio’s documentation describes this as an automatic multi-round tool-calling API and provides hooks for progress, invalid tool requests, and parallel tool execution. The Python SDK can also accept ordinary type-annotated Python functions as tool definitions. See LM Studio .act() documentation.
That does not automatically make an LM Studio agent more capable. Tool-use quality still depends heavily on the model, tool descriptions, context length, and your safety controls. It does reduce the amount of agent-loop plumbing you have to write yourself.
Best fit: prototypes where you want to define Python or TypeScript functions and immediately test autonomous multi-step behavior without bringing in a separate agent framework.
Do you need MCP as a first-class part of the agent architecture?
If Model Context Protocol is central to your project, LM Studio is currently the stronger native choice. LM Studio can act as an MCP host in the app, and its API supports both configured MCP servers and per-request remote MCP servers. Its current v1 REST API and OpenAI-compatible Responses endpoint can expose MCP integrations to calling applications.
For example, LM Studio can define an ephemeral remote MCP server in a request or call MCP servers configured in mcp.json. The server settings include explicit permissions for per-request MCPs and locally configured MCP servers. See LM Studio MCP via API.
Ollama has extensive integrations with agent applications that may themselves support MCP, but Ollama’s current core documentation emphasizes function/tool calling and external integrations rather than presenting Ollama itself as an MCP host equivalent to LM Studio.
Choose LM Studio if: you want your local inference server to be the place where MCP tools are configured and exposed to agent requests.
Choose Ollama if: your higher-level agent application already owns the MCP layer and you only need Ollama to supply inference and tool-call outputs.
Which has the better API surface for stateful agents?
LM Studio currently offers more built-in state management. Its native /api/v1/chat endpoint can store a response and continue the conversation with a previous_response_id. Its OpenAI-compatible Responses API also supports stateful continuation. That can reduce how much conversation history your application has to resend for long-running workflows.
Ollama supports the OpenAI Responses API, but its current compatibility documentation states that only the non-stateful flavor is supported and that previous_response_id and conversation-based state are not supported. Your application can still maintain state by keeping the message history and sending it with later requests.
Recommendation: if server-managed conversational state is important to your architecture, LM Studio has an edge. If you already persist agent memory in your own database, message store, or framework, Ollama’s stateless approach is not a major disadvantage.
Which is better for coding agents such as Claude Code or Codex?
Ollama is especially convenient if your main goal is running existing coding agents. The current quickstart exposes ollama launch shortcuts for supported tools, and Ollama has dedicated integration documentation for Claude Code, Codex, OpenCode, Cline, Roo Code, and others. Its Anthropic-compatible Messages API supports streaming, tools, tool results, vision, and thinking-related fields for supported models.
LM Studio prend également en charge Claude Code via son point de terminaison compatible avec Anthropic /v1/messageset Codex via son point de terminaison Responses compatible avec OpenAI. En janvier 2026, la version 0.4.1 de LM Studio a ajouté le point de terminaison compatible avec Anthropic afin de permettre l'utilisation de modèles locaux avec Claude Code.
Besoin
Meilleure valeur par défaut
Raison
Configuration en une seule commande pour plusieurs agents de codage
Ollama
ollama launchest conçu autour des intégrations d'agents prises en charge.
Claude Code avec un backend local
Soit
Les deux exposent des API de messagerie compatibles avec Anthropic.
Codex avec un backend local
Soit
Les deux prennent en charge les API compatibles avec OpenAI et adaptées aux flux de travail Codex.
Agent et outils MCP gérés par le serveur local
LM Studio
MCP est intégré à l'architecture serveur/API actuelle de LM Studio.
Lequel est le plus facile à trouver, à tester et à échanger pour les modèles ?
LM Studio est plus adapté à l'exploration visuelle. Son application de bureau inclut la découverte de modèles et permet de rechercher les modèles compatibles sur Hugging Face. Son interface en ligne de commande permet également de rechercher et de télécharger des modèles lms get, notamment aux formats GGUF et MLX lorsqu'ils sont pris en charge. Vous pouvez choisir la quantification, inspecter les modèles locaux, estimer les besoins en mémoire avant le chargement et configurer les paramètres de chargement de chaque modèle, tels que la longueur du contexte, le déchargement GPU et l'attention Flash.
Ceci est utile lorsque vous testez plusieurs petits modèles d'agents et que vous souhaitez les comparer de manière interactive avant d'en intégrer un dans le code.
Le flux de travail de modélisation d'Ollama est plus structuré et scriptable : utilisez des commandes telles que `model` ollama pull, ollama list`build` ollama run, `build` et ` ollama createbuild`. Un modèle Modelfilepeut définir un modèle de base et des paramètres pour des variantes réutilisables. Ceci est pratique pour les architectures de type « infrastructure en tant que code », car la préparation du modèle peut être effectuée via des scripts shell, des workflows Docker ou l'automatisation du déploiement.
Recommandation : LM Studio pour la navigation et l’expérimentation interactive ; Ollama pour un flux de travail de modélisation reproductible piloté par terminal.
Les deux peuvent-ils fonctionner en mode sans interface graphique sur un serveur ou dans un environnement d'intégration continue ?
Oui. Auparavant, Ollama bénéficiait d'un avantage plus net, mais LM Studio 0.4.0 a changé la donne.
Ollama est par nature orienté services. Sous Linux, le guide d'installation officiel recommande de l'exécuter en tant que service systemd et ollama serveexpose l'API locale. Il prend également en charge Docker et les variables d'environnement pour le comportement du serveur.
LM Studio propose désormais llmsterun démon autonome qui ne dépend pas de l'interface graphique. La documentation actuelle le destine explicitement aux serveurs Linux, aux instances cloud, aux machines GPU et à l'intégration continue. Démarrez-le avec la commande `lss` lms daemon upet lancez le serveur API avec `lss` lms server start.
Recommandation : si vous recherchez une architecture conceptuelle minimale, Ollama reste la solution la plus simple. En revanche, si vous souhaitez un déploiement sans interface graphique tout en conservant l’API de gestion de modèles, le chat avec état, l’authentification, la prise en charge de MCP et l’écosystème SDK de LM Studio, llmsterLM Studio devient une option tout à fait viable.
Il n'existe pas de solution universellement performante. Les performances dépendent du format du modèle, de la quantification, de la longueur du contexte, du processeur/GPU, de la pile de pilotes, du traitement par lots, de la charge mémoire et des paramètres d'exécution.
Ollama propose des commandes de planification pour les requêtes parallèles et les modèles chargés, et son développement pour Apple Silicon (2026) inclut un moteur basé sur MLX en avant-première. LM Studio 0.4.0 introduit le traitement par lots continu pour les requêtes parallèles et prend en charge à la fois les environnements d'exécution llama.cpp et MLX sur Apple Silicon. LM Studio propose également des commandes de chargement explicites telles que le déchargement GPU, la longueur du contexte, l'attention Flash et le placement du cache KV pour les environnements d'exécution compatibles.
Action : évaluez précisément le modèle et la taille du contexte utilisés par votre agent. Mesurez au minimum le temps d’obtention du premier jeton, le nombre de jetons par seconde, la consommation de mémoire et le débit des requêtes multiples. Ne choisissez pas l’environnement d’exécution en vous basant sur un test de performance générique utilisant des paramètres de quantification ou de contexte différents.
Qu'en est-il de la compatibilité matérielle ?
Les deux logiciels prennent en charge les principales plateformes d'IA locale, mais leurs spécificités diffèrent. Ollama est compatible avec macOS, Windows et Linux, et propose des options d'accélération native documentées pour NVIDIA, AMD, Apple Metal et Vulkan (voie expérimentale). LM Studio est compatible avec les Mac Apple Silicon, les systèmes Windows x64/ARM et les configurations Linux x64/ARM64 ; sa configuration macOS actuelle ne prend pas en charge les Mac Intel.
Si votre matériel est inhabituel, vérifiez la combinaison exacte de GPU et de système d'exploitation avant de choisir l'un ou l'autre environnement d'exécution.
Quel outil est le plus sûr pour les agents locaux, qu'il s'agisse d'outils de fichiers ou d'outils de navigateur ?
L'environnement d'exécution de l'inférence ne représente qu'une partie du périmètre de sécurité. Dès lors qu'un agent reçoit des outils capables d'écrire des fichiers, d'exécuter des commandes, de naviguer sur des sites web authentifiés ou d'appeler des API internes, le risque provient autant des autorisations de ces outils que du serveur de modèles.
LM Studio signale explicitement que les serveurs MCP peuvent exécuter du code arbitraire, accéder aux fichiers locaux et utiliser le réseau, et propose des paramètres serveur pour l'authentification et les permissions MCP. L'API d'Ollama laisse l'exécution des fonctions à votre application, ce qui vous permet de contrôler directement les actions autorisées pour chaque fonction.
Recommandation : utilisez des schémas d'outils restreints, validez les arguments, séparez les outils en lecture seule et les outils destructifs, exigez une confirmation pour les actions à fort impact et n'exposez pas une API de modèle local ou un serveur MCP à un réseau non fiable sans contrôles d'accès appropriés.
Lequel un développeur Python doit-il choisir ?
Choisissez Ollama si votre application Python possède déjà une boucle d'agents ou utilise un framework compatible avec les API d'OpenAI. Le SDK Python accepte également directement les fonctions Python comme outils, ce qui simplifie le flux de travail d'appel d'outils de base.
Choisissez LM Studio si vous souhaitez utiliser le SDK natif de l'environnement d'exécution pour gérer l'exécution d'outils en plusieurs étapes. Ce lmstudio-pythonSDK inclut le chargement/déchargement de modèles, les embeddings, les réponses structurées, les flux d'agents et les définitions d'outils dans un seul et même package.
Une règle utile est :
Votre propre orchestration : Ollama est généralement plus propre.
Vous souhaitez utiliser les outils d'orchestration du SDK d'exécution : LM Studio est généralement plus productif.
Quel choix faire pour un premier projet d'agent local ?
Votre situation
Point de départ recommandé
Vous souhaitez une API locale opérationnelle en quelques minutes et préférez les flux de travail en terminal.
Ollama
Vous souhaitez parcourir visuellement les modèles avant d'en choisir un.
LM Studio
Vous utilisez déjà LangChain, LlamaIndex, votre propre boucle ou une autre couche d'orchestration.
Ollama
Vous souhaitez intégrer les outils MCP directement dans le flux de travail du serveur local/API
LM Studio
Vous souhaitez un assistant d'agent multi-tours natif en Python/TypeScript
LM Studio
Vous souhaitez principalement des intégrations avec Claude Code, Codex, OpenCode ou des agents de codage similaires.
Ollama, avec LM Studio également viable
Vous devez effectuer des tests d'interface graphique en local, mais le déploiement sans interface graphique sera lancé ultérieurement.
LM Studio
Vous préférez un service minimal, facile à scripter et à déployer.
Ollama
En résumé
Ollama est la solution idéale pour les développeurs recherchant un environnement d'exécution de modèles minimaliste, privilégiant le terminal et s'intégrant à un écosystème d'agents existant. Son API, ses appels de fonctions, sa compatibilité avec OpenAI/Anthropic et ses intégrations avec 2026 agents de codage le rendent particulièrement pratique lorsque votre application ou framework externe gère déjà la mémoire, le MCP, la planification, les tentatives de recalcul et l'exécution des outils.
LM Studio est la solution par défaut idéale lorsque vous souhaitez intégrer un maximum d'éléments de développement d'agents dans un environnement local unique. Son démon sans interface graphique (version 2026) élimine les limitations de l'ancienne interface graphique uniquement, tandis que son API REST avec état, sa compatibilité avec MCP, ses points de terminaison de gestion des modèles, sa compatibilité avec OpenAI/Anthropic et .act()son SDK lui confèrent un avantage considérable pour les développeurs qui recherchent une orchestration intégrée et l'expérimentation interactive de modèles.
Si vous hésitez encore, le choix pratique est simple : prototypez la même tâche d’appel d’outil sur les deux plateformes en utilisant le même modèle et la même quantification. Si le framework d’agents répond déjà à tous vos besoins, conservez l’environnement d’exécution simplifié d’Ollama. En revanche, si vous devez développer vous-même la gestion d’état, l’infrastructure MCP, les contrôles de gestion de modèles et les boucles d’outils multi-itérations, LM Studio pourrait vous faire gagner un temps précieux en développement.