Home
» domini
»
Come configurare una base di conoscenza locale privata basata sull'intelligenza artificiale per documenti personali
Come configurare una base di conoscenza locale privata basata sull'intelligenza artificiale per documenti personali
La risposta pratica più semplice: esegui il modello linguistico, il modello di embedding, l'indice dei documenti e l'interfaccia di chat sul tuo computer. Una soluzione semplice è Ollama per la distribuzione locale del modello, abbinato ad AnythingLLM self-hosted per l'acquisizione dei documenti, la generazione aumentata tramite recupero (RAG) e la chat. Mantieni il database vettoriale in locale, utilizza l'archiviazione persistente, evita i provider di modelli cloud e verifica che le risposte siano effettivamente basate sui tuoi file.
Esempio illustrativo: immaginate che Jordan stia organizzando una collezione privata che include manuali per la casa, PDF di assicurazioni, appunti di riunioni, un manuale di finanza personale e alcuni report di progetto. Jordan è un personaggio di fantasia. I file, le domande, le risposte e i risultati descritti di seguito sono esempi per illustrare il flusso di lavoro, non risultati di test o una testimonianza.
Questa guida utilizza una configurazione in quattro fasi per mantenere comprensibile il confine della privacy. È adatta a una singola persona o a un piccolo nucleo familiare fidato che desidera effettuare ricerche locali di documenti e ottenere risposte a domande. Se hai bisogno di controlli di identità aziendali, disponibilità multi-nodo, audit centralizzati o garanzie normative, dovresti considerare questa come un'architettura di partenza piuttosto che una soluzione completa per la conformità.
Cosa significa effettivamente "base di conoscenza locale privata per l'IA"
Una base di conoscenza locale non è la stessa cosa di addestrare un modello sui propri documenti. In un tipico flusso di lavoro RAG, il sistema estrae il testo dai file, lo suddivide in blocchi, converte questi blocchi in embedding numerici, li memorizza in un database vettoriale, recupera i blocchi pertinenti per ogni domanda e invia solo questi blocchi al modello linguistico come contesto.
La documentazione attuale di AnythingLLM descrive sia i flussi di lavoro con documenti allegati che quelli con documenti incorporati. I documenti allegati possono inserire il testo completo in una chat quando la finestra di contesto lo consente, mentre RAG recupera frammenti più piccoli e rilevanti dai documenti incorporati. La documentazione locale di LanceDB afferma inoltre che il database LanceDB predefinito sull'istanza mantiene il testo e gli elementi incorporati dei documenti all'interno dell'applicazione AnythingLLM. Consultare la documentazione sui flussi di lavoro dei documenti di AnythingLLM e la documentazione di AnythingLLM su LanceDB .
Componente
Ruolo nello stack locale
Scelta rispettosa della privacy
Ollama
Esegue il modello di chat e, facoltativamente, un modello di embedding sulla tua macchina
Utilizzare un modello locale, non un endpoint di modello ospitato nel cloud.
AnythingLLM
Fornisce l'interfaccia utente, la gestione dei documenti, la suddivisione in blocchi, il sistema RAG e l'organizzazione dello spazio di lavoro.
Eseguilo localmente e mantieni persistente la sua directory di archiviazione
Modello di incorporamento
Trasforma frammenti di documenti e query in vettori per il recupero semantico.
Utilizzare un sistema di incorporamento locale se i documenti non devono essere inviati a un servizio esterno.
LanceDB
Memorizza i vettori utilizzati per trovare i passaggi pertinenti
Mantieni l'istanza locale predefinita a meno che tu non abbia intenzionalmente bisogno di un database remoto.
File originali e backup
Rimanere la fonte autorevole
Proteggili con i normali controlli di accesso del sistema operativo, la crittografia e i backup.
Prima di iniziare: definire i confini della privacy
La domanda chiave non è "L'app è locale?", bensì "Quali componenti possono inviare testo o prompt del documento al di fuori del computer?". Un'interfaccia utente locale può comunque essere configurata per richiamare un LLM cloud, un'API di incorporamento cloud, una ricerca web o strumenti remoti. Per una configurazione privata, è consigliabile mantenere LLM, l'embedder e il database vettoriale in locale, a meno che non si siano accettate esplicitamente le implicazioni di condivisione dei dati di un provider esterno.
AnythingLLM documenta la telemetria anonima e fornisce un modo per disabilitarla. La sua documentazione sulla privacy distingue inoltre tra la rimozione di un documento da un'area di lavoro e la sua eliminazione completa dalla libreria documenti. Per la cancellazione completa all'interno di AnythingLLM, la documentazione attuale indica di eliminare il documento da " Documenti personali" , operazione che rimuove anche il codice sorgente analizzato, gli embedding memorizzati nella cache e i riferimenti all'area di lavoro. Prima di aggiungere materiale sensibile, si consiglia di consultare la documentazione di AnythingLLM relativa alla privacy e alla gestione dei dati .
È inoltre necessaria memoria sufficiente per il modello locale scelto. Non esiste una dimensione del modello univoca e corretta, poiché la velocità utilizzabile dipende da CPU, GPU, RAM o VRAM, quantizzazione, lunghezza del contesto e numero di documenti recuperati. Iniziate con un modello che si adatti comodamente, piuttosto che scegliere il modello più grande che il vostro computer riesce a caricare a fatica.
Passaggio 1: Installa Ollam e prepara la chat locale e i modelli di integrazione
Installa Ollama seguendo le istruzioni aggiornate per il tuo sistema operativo. Ollama è disponibile per macOS, Windows e Linux e la sua API locale è disponibile di default sulla porta 11434. La guida rapida ufficiale di Ollama è la fonte migliore per informazioni aggiornate sull'installazione e sulla sintassi dei comandi.
Dopo l'installazione, scarica un modello di chat adatto al tuo hardware. Il modello esatto non è specificato qui perché il catalogo dei modelli cambia e i requisiti hardware variano. Un comando tipico ha questa forma:
ollama pull <chat-model-name>
Per RAG, è necessario anche un modello di embedding. La documentazione sugli embedding di Ollama, aggiornata a settembre 2026, elenca modelli come embeddinggemma, qwen3-embedding, e all-minilmcome scelte di embedding consigliate. È possibile consultare l'elenco aggiornato nella documentazione sugli embedding di Ollama . Ad esempio:
ollama pull embeddinggemma
Non utilizzare un normale modello di chat come modello di embedding solo perché compare in un menu a tendina dei modelli. La documentazione attuale di AnythingLLM sull'embedding Ollama avverte esplicitamente che Ollama può esporre sia modelli di chat che modelli di embedding nello stesso elenco. Utilizza un modello di embedding effettivo per l'indicizzazione dei documenti. Consulta la configurazione dell'embedder Ollama di AnythingLLM .
Schema illustrativo del flusso di lavoro da terminale per il download di un modello locale con Ollama. Il numero di versione visualizzato in questo esempio non rappresenta la versione attualmente consigliata; verificare la versione installata consultando la documentazione ufficiale di Ollama.
Per la configurazione fittizia di Jordan, l'obiettivo in questa fase è semplice: sia la generazione che l'incorporamento dovrebbero essere possibili senza inviare i documenti relativi al nucleo familiare a un'API remota.
Passaggio 2: Esegui AnythingLLM localmente con archiviazione persistente e connettilo a Ollam
AnythingLLM offre opzioni desktop e self-hosted. Questa guida utilizza Docker perché i limiti di archiviazione sono espliciti e facili da sottoporre a backup. La documentazione Docker locale attuale indica agli utenti di scaricare l'immagine e sottolinea che è necessario uno storage persistente, altrimenti i dati dell'applicazione potrebbero andare persi quando il container viene ricreato. Indica inoltre che l'applicazione web è disponibile all'indirizzo [indirizzo web] http://localhost:3001. Si consiglia di utilizzare la guida Docker locale ufficiale di AnythingLLM anziché copiare un vecchio comando da un forum.
docker pull mintplexlabs/anythingllm:latest
Quando esegui il container, preserva lo spazio di archiviazione di AnythingLLM montando una directory host su /app/server/storage. La documentazione del fornitore specifica espressamente che il montaggio persistente è necessario. Mantieni questa directory di archiviazione su un disco incluso nel tuo piano di backup.
Configurare quindi il provider LLM come Ollama. Se AnythingLLM è in esecuzione direttamente sull'host, l'indirizzo Ollama predefinito documentato è http://127.0.0.1:11434. Se AnythingLLM è in esecuzione all'interno di Docker mentre Ollama è in esecuzione sull'host, non utilizzare localhostdall'interno del container. La documentazione di rete di AnythingLLM per Docker indica di utilizzare http://host.docker.internal:11434sulle piattaforme desktop supportate; su Linux documenta 172.17.0.1per questo modello di connessione host. Consultare la nota di rete localhost di AnythingLLM e la configurazione LLM di Ollama .
Nelle impostazioni, scegli Ollama sia come provider LLM che, se lo desideri, come provider di embedding. Seleziona il modello di chat per la generazione e il modello di embedding per l'indicizzazione. Mantenere separati questi ruoli previene un errore di configurazione comune.
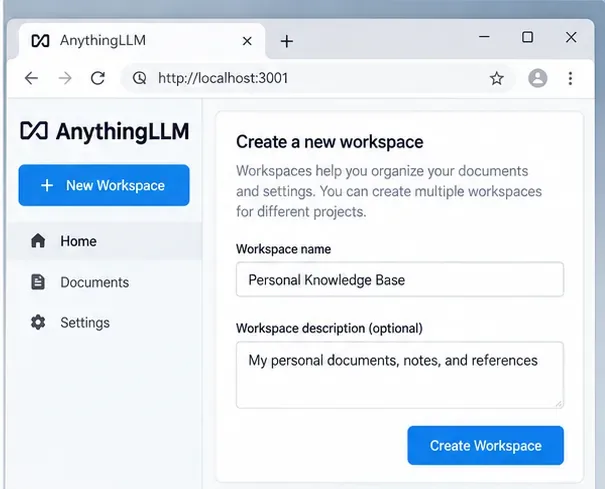
AnythingLLM in versione self-hosted è documentato per funzionare su localhost:3001. Un'area di lavoro dedicata conferisce a una raccolta di documenti uno scopo ben definito e impedisce che materiale non pertinente venga incluso nel pool di recupero.
Jordan crea uno spazio di lavoro chiamato "Base di conoscenza personale" ed evita di connettersi a provider di modelli cloud. Questo rende più semplice, in un secondo momento, verificare i confini previsti: interfaccia utente locale, LLM locale, embedding locali, vettori locali.
Passaggio 3: Aggiungere i documenti, scegliere tra allegato RAG o allegato a testo completo e verificare l'acquisizione.
Non iniziare caricando l'intero disco rigido. Inizia con un piccolo set rappresentativo di documenti di cui conosci bene il contenuto. Questo ti permette di individuare in modo controllato eventuali problemi di estrazione o recupero prima che l'indice cresca eccessivamente.
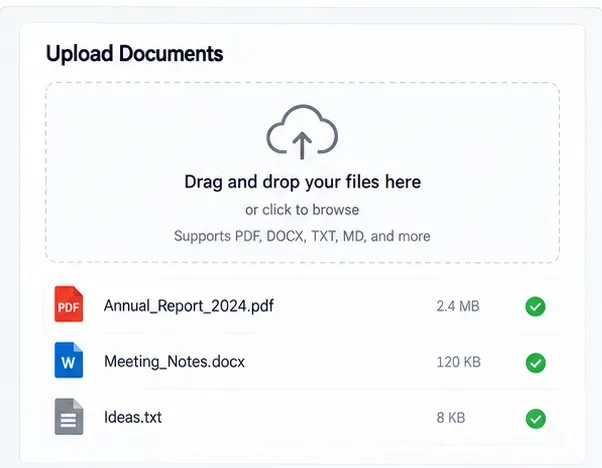
Per l'esempio di Jordan, un primo gruppo utile potrebbe includere un PDF ricercabile, un file DOCX e una nota in testo semplice o Markdown. Se i PDF scansionati contengono immagini anziché testo selezionabile, verifica che il percorso di elaborazione dei documenti scelto estragga effettivamente il testo necessario; un file che ti sembra leggibile potrebbe comunque produrre una rappresentazione testuale vuota o di scarsa qualità per RAG.
AnythingLLM attualmente supporta due principali comportamenti relativi ai documenti:
Documenti allegati: utili quando il testo completo rientra nella finestra di contesto del modello e si desidera che il modello visualizzi il file completo per quella discussione.
Documenti incorporati con RAG: utili per raccolte di grandi dimensioni o riutilizzabili. Il sistema suddivide il contenuto in blocchi, lo incorpora e recupera le parti rilevanti per una domanda.
La guida alla documentazione di AnythingLLM attualmente in vigore indica che i documenti incorporati in un'area di lavoro diventano disponibili tra i thread all'interno di tale area. Questo è comodo, ma significa anche che l'appartenenza all'area di lavoro è parte integrante del modello di privacy nelle implementazioni multiutente. È importante mantenere le aree di lavoro personali separate da qualsiasi area di lavoro condivisa.
Esempio di visualizzazione dell'acquisizione con diversi tipi di documenti. Utilizzare prima un piccolo batch di documenti funzionanti, quindi verificare l'estrazione e l'indicizzazione prima di aggiungere un archivio di grandi dimensioni.
Dopo l'incorporamento, poni una domanda la cui risposta compare in un solo file. Poi chiedi un dettaglio che non compare in nessun file. La prima domanda verifica la capacità di recupero delle informazioni; la seconda verifica se il modello ammette l'incertezza invece di inventare una risposta.
Cosa regolare se il recupero è debole
AnythingLLM espone controlli RAG a livello di spazio di lavoro, come le preferenze di ricerca, il numero massimo di snippet di contesto e la soglia di similarità dei documenti. La sua documentazione consiglia di iniziare dalle impostazioni dello spazio di lavoro piuttosto che presumere che il problema risieda nel modello di base. Aumentare il contesto recuperato può essere utile quando la risposta si estende su più sezioni, ma l'invio di troppi chunk può anche aggiungere testo irrilevante e consumare la capacità della finestra di contesto.
Se si modificano i modelli di embedding dopo l'indicizzazione, è necessario reincorporare i documenti interessati in modo che i vettori memorizzati e i vettori di query provengano dallo stesso spazio di embedding. Mescolare embedding provenienti da modelli diversi non rappresenta una strategia di recupero efficace.
Passaggio 4: Verifica le risposte fondate, proteggi la privacy ed esegui il backup della base di conoscenza
Una base di conoscenza è utile solo se si è in grado di individuare gli errori. Crea un piccolo elenco di valutazione basato su fatti che puoi verificare direttamente. Ad esempio:
Richiedete una data, un importo, un modello di prodotto o una clausola di polizza che compaia testualmente in un documento.
Poni una domanda che implichi il confronto tra documenti e che richieda informazioni provenienti da due file diversi.
Poni una domanda volutamente senza risposta e verifica che la risposta non inventi una fonte.
Poni la stessa domanda con una formulazione diversa per verificare se il recupero delle informazioni è stabile.
Apri il documento originale e verifica manualmente ogni affermazione di particolare rilevanza.
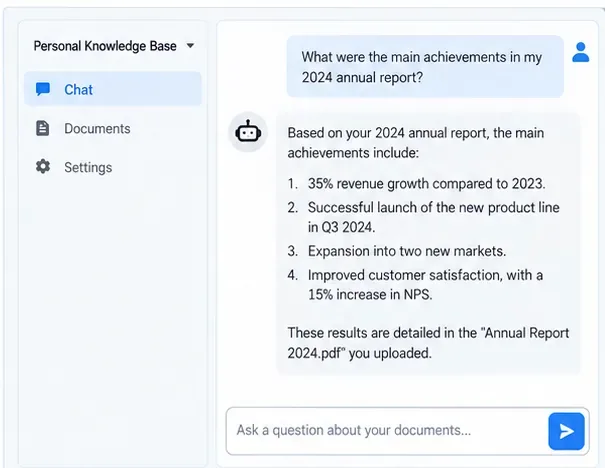
Risposta ipotetica basata su documenti, utilizzata per illustrare la fase di verifica. Le cifre mostrate sono esempi fittizi; in una base di conoscenza reale, verificare le affermazioni importanti confrontandole con il file originale.
Per Jordan, una buona regola di accettazione non è "la risposta sembra giusta", bensì "la risposta corrisponde alla fonte, include il contesto necessario e fallisce in modo sicuro quando la fonte non contiene le informazioni". Questa regola è particolarmente importante per tasse, assicurazioni, documenti legali, cartelle cliniche o decisioni finanziarie.
Mantieni la configurazione privata dopo che ha funzionato
L'inferenza locale riduce l'esposizione dei dati, ma la privacy dipende comunque dalla configurazione. Utilizzate questi controlli come una pratica lista di controllo:
Mantieni il servizio AnythingLLM connesso alla macchina locale o a una rete privata fidata, a meno che l'accesso remoto non sia intenzionalmente protetto.
Non aggiungere integrazioni LLM cloud, incorporamento cloud, ricerca web, browser o agenti a un'area di lavoro contenente materiale sensibile a meno che tu non comprenda cosa trasmettono tali integrazioni.
Disattiva la telemetria anonima se la tua politica sulla privacy non prevede la raccolta di dati telemetrici sui prodotti.
Utilizza la crittografia del disco e le autorizzazioni dell'account del tuo sistema operativo. Un database vettoriale locale contiene comunque dati leggibili anche se un utente malintenzionato riesce ad accedere al computer.
Se si desidera eliminare completamente i file sensibili all'interno di AnythingLLM, è necessario eliminarli dall'intera raccolta documenti, non solo da una singola area di lavoro.
Applica patch a Ollama, AnythingLLM, Docker e al sistema operativo host. "Offline" non deve significare "mai aggiornato".
Esegui il backup delle parti che sono difficili da ricreare
I documenti originali rimangono la fonte di riferimento, ma la directory di archiviazione di AnythingLLM contiene il database dell'applicazione, i documenti analizzati, i dati vettoriali e la configurazione necessari per evitare di dover ricostruire tutto in caso di guasto del disco. Eseguire il backup sia della cartella dei documenti originali che della memoria persistente di AnythingLLM. Se si utilizzano volumi Docker anziché una directory host montata tramite bind, seguire la documentazione ufficiale di Docker relativa al backup e al ripristino dei volumi .
Verifica il ripristino, non solo la creazione del backup. Un backup è valido solo quando è possibile ripristinarlo in un'altra directory o macchina, avviare lo stack locale, aprire l'area di lavoro e recuperare correttamente un dato noto.
Quando questa configurazione è adatta e quando non lo è
Questa architettura è ideale quando la priorità è conservare i documenti personali su hardware sotto il proprio controllo, si ha familiarità con l'utilizzo di software locale e si desidera una ricerca semantica e risposte in linguaggio naturale all'interno di una libreria di documenti di dimensioni contenute. È inoltre utile quando la connessione a Internet è inaffidabile o quando si desiderano costi locali prevedibili dopo il download dei modelli.
È meno adatto se il computer non è in grado di eseguire un modello locale adeguato, se è necessario un accesso senza interruzioni da molti dispositivi al di fuori della rete domestica o se si richiedono funzionalità di identità, audit, blocco legale, gestione centralizzata delle chiavi o supporto garantito di livello aziendale. In questi casi, la soluzione ideale potrebbe essere una distribuzione privata gestita o una piattaforma RAG aziendale, piuttosto che una configurazione con un singolo PC.
Una lista di controllo per l'installazione compatta
Installa Ollam e verifica l'inferenza del modello locale.
Installa un modello di embedding dedicato, come uno di quelli elencati nella documentazione sugli embedding attualmente disponibile su Ollama.
Esegui AnythingLLM in locale con archiviazione persistente.
Collega AnythingLLM all'endpoint locale di Ollam utilizzando l'indirizzo host corretto per il tuo metodo di distribuzione.
Quando l'obiettivo è il recupero di documenti esclusivamente in locale, utilizzare un database vettoriale locale, come ad esempio LanceDB, il database predefinito di AnythingLLM.
Crea un'area di lavoro circoscritta.
Iniziate con alcuni documenti noti e verificate l'estrazione.
Utilizza RAG per raccolte di grandi dimensioni riutilizzabili e allega il testo completo solo quando il documento si adatta perfettamente al contesto del modello.
Prima di fidarsi del sistema, è necessario testare sia le domande a cui è possibile rispondere sia quelle a cui non è possibile rispondere.
Disattiva le integrazioni esterne e la telemetria non necessarie in base alle tue esigenze di privacy.
Esegui il backup sia dei documenti di origine che della memoria persistente dell'applicazione, quindi prova a eseguire un ripristino.