Home
» domini
»
Come risolvere l'errore "Finestra di contesto superata" nell'analisi di documenti lunghi senza perdere prove fondamentali
Come risolvere l'errore "Finestra di contesto superata" nell'analisi di documenti lunghi senza perdere prove fondamentali
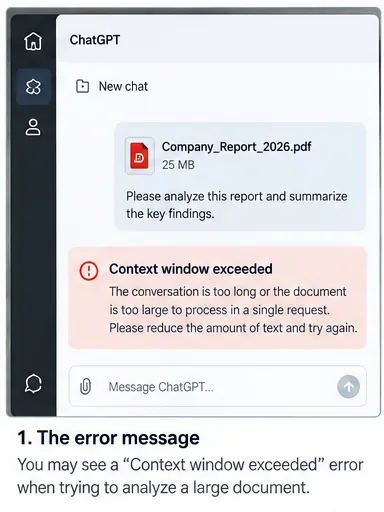
Caricate un report lungo, richiedete un'analisi approfondita e, invece di una risposta, ricevete un messaggio come "Finestra di contesto superata", "Lunghezza massima del contesto superata" o un altro avviso che la richiesta è troppo grande. La cosa frustrante è che il file potrebbe essere stato caricato correttamente e lo stesso documento potrebbe anche aver funzionato per una domanda più specifica.
Il motivo è semplice ma facile da trascurare: un limite di caricamento e la finestra di contesto di un modello non sono la stessa cosa. Un modello deve far rientrare il materiale che sta attivamente considerando in un budget di token finito. Tale budget può includere le istruzioni, la cronologia delle conversazioni, il testo estratto dai file, le definizioni degli strumenti, i passaggi recuperati, i token di ragionamento e lo spazio per la risposta. Un documento può quindi essere legalmente caricabile ma comunque troppo grande per essere analizzato in un'unica passata.
Di solito, la soluzione migliore è evitare di riprovare continuamente con lo stesso prompt gigante. Iniziate con le modifiche meno invasive, poi passate alla suddivisione in blocchi, al recupero delle informazioni o a un flusso di lavoro con un contesto più ampio solo se l'approccio più semplice continua a fallire.
Innanzitutto, conferma che l'errore sia effettivamente un problema di finestra di contesto.
Prima di modificare il documento, è importante distinguere un errore di contesto da un limite di caricamento o di archiviazione. Le attuali linee guida di OpenAI per il caricamento dei file indicano che i file caricati su ChatGPT o GPT hanno un limite massimo di 512 MB per file, mentre i file di testo e i documenti sono limitati a 2 milioni di token per file. Si tratta di limiti di caricamento, non di una garanzia che tutto il testo verrà inserito contemporaneamente nel contesto attivo di un modello.
La sezione FAQ di OpenAI relativa al caricamento dei file è la fonte autorevole per verificare i limiti di caricamento attuali. I limiti esatti variano in base al prodotto, al piano, al modello e al fornitore, quindi non dare per scontato che un valore copiato da un vecchio articolo sia ancora valido.
Ciò che vedi
Probabile collo di bottiglia
La migliore prima mossa
Il file viene rifiutato prima dell'inizio dell'analisi.
Dimensione del file, tipo di file, spazio di archiviazione o quota di caricamento
Verifica le regole di caricamento in vigore
Il file viene caricato, ma una lunga richiesta di informazioni fallisce con un errore di contesto.
La richiesta attiva supera il budget di contesto del modello.
Accorcia la richiesta e riduci il contesto attivo
La risposta copre le prime pagine ma tralascia le sezioni successive.
Non tutto il materiale è stato collocato direttamente nel contesto, oppure il recupero ha omesso passaggi rilevanti.
Poni domande più specifiche o suddividi per sezione
Una conversazione ha funzionato prima, ma fallisce dopo molti tentativi
La cronologia delle chat accumulata consuma il contesto
Avvia una nuova discussione di analisi con un riepilogo conciso del passaggio di consegne.
Un errore di finestra di contesto può verificarsi dopo il caricamento corretto di un documento perché la richiesta attiva deve ancora rientrare nel budget di token del modello.
Passaggio 1: Misura il documento prima di modificarlo
Il numero di pagine e i megabyte sono indizi utili, ma i token sono la misura che conta per il contesto del testo. La tokenizzazione dipende dalla lingua, dalla formattazione, dalla punteggiatura e dalla codifica del modello, quindi un manuale tecnico di 100 pagine può consumare un numero di token molto diverso da una presentazione di 100 pagine.
Le linee guida di OpenAI per il conteggio dei token raccomandano di controllare la finestra di contesto del modello di destinazione e di lasciare spazio per l'output e, per i modelli di ragionamento, per i token di ragionamento. Sottolineano inoltre che la struttura del messaggio, gli strumenti, i file, le immagini e gli schemi possono aggiungere token oltre al testo semplice che viene conteggiato.
Per una rapida valutazione, annota il numero di pagine del file, il numero approssimativo di parole, il numero di sezioni principali e se contiene appendici, linguaggio giuridico ripetitivo, registri grezzi, trascrizioni, tabelle o riferimenti che non ti servono effettivamente per il compito.
Prima di procedere alla risoluzione dei problemi, verifica le dimensioni del documento. Le dimensioni del file e il numero di pagine sono solo indicatori indiretti; il limite più rilevante per l'analisi del testo è l'utilizzo dei token.
Passaggio 2: Riduci la conversazione attiva prima di modificare il file
Se il documento non è particolarmente voluminoso, la soluzione più economica potrebbe essere quella di rimuovere il contesto accumulato anziché dividere il file. Avvia una nuova chat o richiesta e riporta solo le istruzioni essenziali. Sostituisci una lunga conversazione con un breve passaggio di consegne, ad esempio: "Analizza il report allegato per individuare i fattori che influenzano i ricavi, i rischi significativi e le indicazioni per il management. Riporta cinque conclusioni con i relativi riferimenti di pagina o sezione."
Rimuovi anche il materiale di sfondo ripetuto, gli esempi non più necessari, il testo duplicato incollato e le bozze precedenti. Se utilizzi un flusso di lavoro API, considera l'intera richiesta anziché il solo documento. Una richiesta che si adatta a malapena lascia poco spazio per la risposta e potrebbe fallire in modo imprevedibile man mano che le istruzioni o gli schemi degli strumenti si evolvono.
Segno di successo: lo stesso file funziona in un nuovo thread con un prompt focalizzato. In tal caso, il problema era dovuto almeno in parte al contesto accumulato, non al documento in sé.
Passaggio 3: Restringere la domanda e l'output richiesto
"Analizza tutto il contenuto di questo documento di 400 pagine e redigi una relazione esaustiva" costringe il sistema a considerare molti argomenti contemporaneamente. Poni invece una domanda alla volta. Ad esempio, richiedi prima i principali rischi del documento, poi le ipotesi finanziarie, infine le contraddizioni tra le affermazioni del management e i dati a supporto.
Mantieni il formato della risposta entro limiti precisi. Una richiesta di output di 20 pagine consuma molto più budget di output rispetto a una richiesta di una tabella di prove di 10 righe. Puoi sempre ampliare la risposta finale dopo aver raccolto le prove.
Un utile suggerimento mirato è il seguente: "Utilizzando solo questo documento, individua fino a otto affermazioni rilevanti per l'abbandono dei clienti. Per ogni affermazione, indica la sezione o la pagina di riferimento, una spiegazione di una frase e qualsiasi limitazione specificata. Se il documento non contiene prove sufficienti, specificalo."
Quando procedere: se una domanda mirata continua a generare lo stesso errore, o se è necessaria una copertura affidabile dell'intero documento anziché di un singolo argomento, è opportuno suddividere il codice sorgente.
Passaggio 4: Dividere il documento in base al significato, non solo in base al numero di pagine.
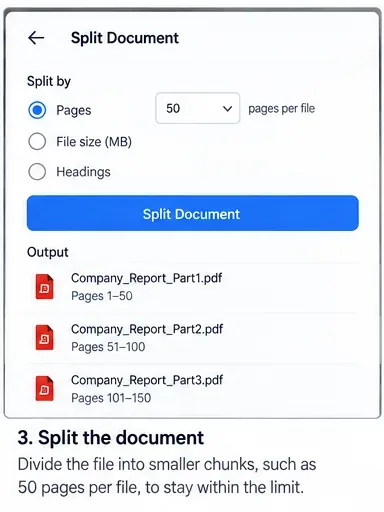
La suddivisione in blocchi è la soluzione più affidabile e versatile per documenti molto lunghi. Dividete il file in base a confini naturali come capitoli, sezioni di report, contratti, appendici, intervalli di date o turni di parola. I blocchi logici preservano meglio il contesto rispetto a tagli arbitrari ogni 50 pagine.
Se una sezione dipende fortemente dalla precedente, includete una piccola sovrapposizione o una breve nota introduttiva che descriva la sezione precedente. Denominate le parti in modo chiaro, ad esempio 01_Executive_Summary.pdf, 02_Financial_Results.pdf, e 03_Risk_Factors.pdf. Mantenete, quando possibile, i numeri di pagina originali in modo che la sintesi finale possa essere verificata.
Suddividete un testo molto lungo in sezioni logiche e chiaramente denominate. Conservate i riferimenti originali alla pagina o alla sezione, in modo che la successiva sintesi possa essere verificata rispetto al testo di partenza.
Passaggio 5: Analizzare ogni blocco con lo stesso schema di evidenza
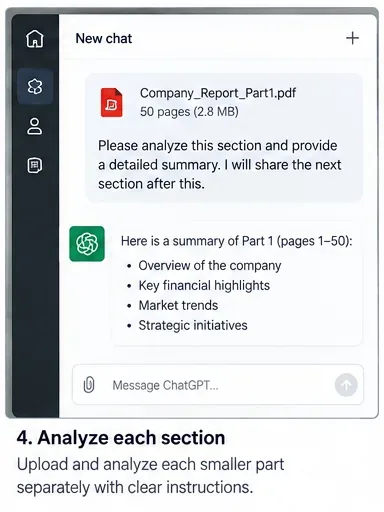
Non limitarti a chiedere un riassunto libero di ogni parte. Utilizza la stessa struttura per ogni sezione, in modo che i risultati possano essere uniti senza perdere differenze importanti. Uno schema pratico potrebbe includere il nome della sezione, i risultati principali, le prove a supporto, il riferimento alla pagina o al titolo, le incertezze e le questioni aperte.
Ad esempio: “Analizzare solo la Parte 3. Riportare: (1) cinque o meno risultati rilevanti, (2) le prove a supporto di ciascun risultato, (3) il riferimento alla pagina o alla sezione originale, (4) eventuali avvertenze indicate dall'autore e (5) le domande che devono essere verificate in un'altra sezione. Non dedurre fatti che non sono presenti in questa parte.”
Questo approccio semplifica anche la valutazione della qualità. Se un riassunto di un blocco di testo contiene affermazioni prive di fonti, è opportuno correggere tale blocco prima di procedere, anziché sperare che la sintesi finale lo risolva.
Analizza una sezione alla volta con un formato di output fisso, in modo che ogni risultato parziale possa essere successivamente combinato e ricondotto alla fonte.
Passaggio 6: crea un riepilogo dei riepiloghi invece di ricaricare ogni blocco completo
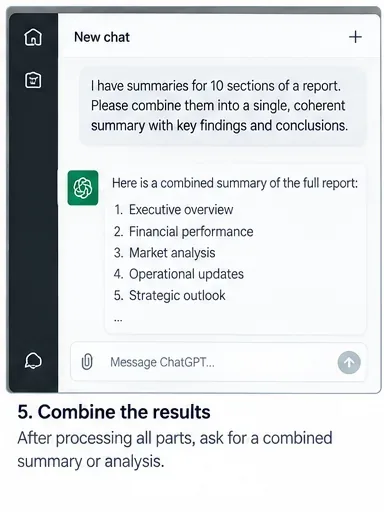
Una volta analizzate le parti, create un pacchetto di prove compatto a partire dai risultati dei singoli blocchi e sintetizzatelo. Non inviate automaticamente ogni blocco originale e ogni riepilogo in un'unica richiesta finale; ciò potrebbe ricreare lo stesso problema di contesto.
Il prompt di sintesi dovrebbe indicare al modello di preservare le discrepanze e le lacune. Ad esempio: "Unisci le analisi di queste sezioni in un unico report. Unisci i risultati duplicati, mantieni le prove contrastanti come punti separati, conserva tutti i riferimenti alle fonti e segnala qualsiasi quesito che non può essere risolto dai riepiloghi."
Questo metodo gerarchico è particolarmente utile per libri, documenti normativi, insiemi di prove, lunghe raccolte di interviste e ricerche multi-documento. Il suo limite principale è la compressione delle informazioni: i dettagli omessi durante un riepilogo di blocco non possono magicamente ricomparire in seguito. Ecco perché lo schema delle prove e i riferimenti alle fonti sono importanti.
Combina analisi di sezioni compatte anziché ricaricare l'intero testo di origine. Conserva citazioni, divergenze e questioni irrisolte durante la sintesi.
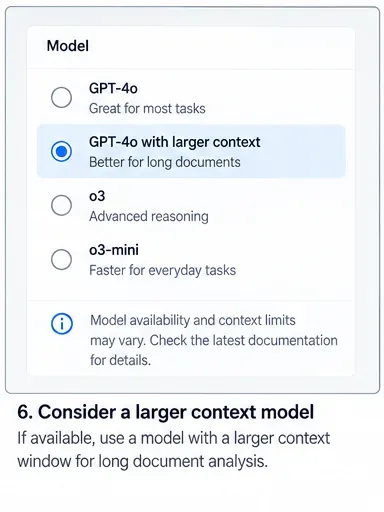
Passo 7: Considera un modello di contesto più ampio, ma non considerarlo una soluzione completa.
Un modello con una finestra di contesto più ampia può ridurre la necessità di suddividere i dati in blocchi in modo più aggressivo. La documentazione attuale dei modelli OpenAI elenca i limiti della finestra di contesto e dell'output massimo per i modelli API, e questi valori possono cambiare con l'aggiornamento dei modelli.
Tuttavia, la dimensione del contesto del titolo di un modello non corrisponde necessariamente alla quantità di un file caricato che un prodotto inserisce direttamente nel prompt. Le linee guida di OpenAI specifiche per le aziende descrivono attualmente un processo separato di "inserimento del contesto" per i documenti di testo caricati: fino a 110.000 token dai documenti caricati possono essere inseriti direttamente nel contesto, con materiale aggiuntivo disponibile tramite un indice di ricerca privato. OpenAI afferma esplicitamente che questo comportamento è in fase di sviluppo attivo e soggetto a modifiche. Vedere Ottimizzazione del caricamento dei file in ChatGPT Enterprise .
La lezione pratica è quella di scegliere un modello di contesto più ampio quando semplifica significativamente il flusso di lavoro, ma è comunque necessario verificare che le sezioni pertinenti vengano effettivamente prese in considerazione. Un contesto più ampio non elimina la necessità di una buona definizione dell'ambito, di riferimenti alle fonti o di verifiche.
Un modello di contesto più ampio può essere d'aiuto, ma è fondamentale verificare i limiti specifici per il modello e la superficie del prodotto che si stanno utilizzando, anziché affidarsi a un valore generico.
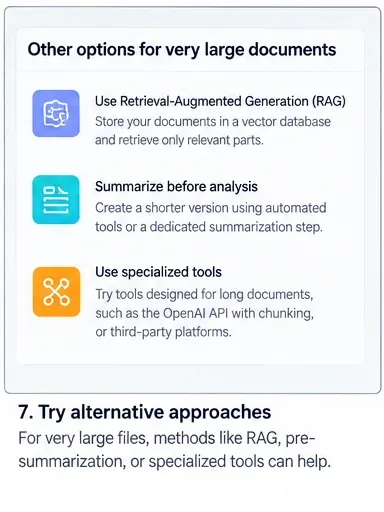
Passaggio 8: Per corpus molto grandi, passare da "inserisci tutto" al recupero
Se il compito coinvolge centinaia o migliaia di pagine, il recupero delle informazioni è solitamente un'architettura migliore rispetto al tentativo di adattare l'intero corpus a un singolo prompt. I sistemi di recupero indicizzano la fonte, cercano i passaggi pertinenti alla domanda corrente e inseriscono nel contesto attivo solo quei passaggi.
La documentazione di OpenAI File Search descrive uno strumento ospitato per la ricerca di file caricati tramite archivi vettoriali. Il recupero funziona particolarmente bene per domande specifiche come "Quali sezioni definiscono la terminazione per comodità?" o "Dove il report tratta della concentrazione della catena di fornitura?".
Il recupero delle informazioni è meno affidabile quando l'attività richiede effettivamente la conoscenza simultanea di ogni passaggio, come ad esempio dimostrare che un argomento non compare mai, confrontare ogni cella di una tabella in una raccolta di grandi dimensioni o produrre una trasformazione esaustiva riga per riga. In questi casi, è consigliabile utilizzare l'elaborazione batch sistematica o la preelaborazione basata su codice in aggiunta al recupero delle informazioni.
Per i corpora che rimangono troppo grandi dopo la suddivisione in blocchi, il recupero può inserire nel contesto attivo per ciascuna domanda solo i passaggi più rilevanti.
Correzione API avanzata: controllo deliberato del troncamento
Gli sviluppatori che utilizzano l'API OpenAI Responses hanno un'opzione aggiuntiva. La documentazione dell'API descrive un'impostazione truncation: con disabled, che è l'impostazione predefinita, una richiesta che supererebbe la finestra di contesto del modello fallisce; con auto, gli elementi della conversazione precedenti possono essere eliminati per far rientrare la richiesta. Consultare la documentazione dell'API Responses .
Il troncamento automatico può prevenire un errore irreversibile, ma modifica le informazioni disponibili al modello. Nell'analisi dei documenti, l'eliminazione silenziosa del contesto iniziale può essere peggiore della ricezione di un errore. Utilizzatelo solo se la vostra applicazione è progettata in modo tale che gli elementi di conversazione più vecchi siano superflui o già riassunti altrove.
Come verificare che la soluzione abbia effettivamente funzionato
Una richiesta accolta non è sufficiente. L'obiettivo è un'analisi difendibile che prenda in esame il materiale necessario senza trascurare prove. Verificate il risultato prima di considerare il problema risolto.
Verifica della copertura: accertarsi che ogni capitolo, intervallo di date o file sorgente richiesto compaia nel piano di analisi o nella tabella finale delle prove.
Controllo di tracciabilità: seleziona un campione delle affermazioni più importanti e verifica i riferimenti a pagine, sezioni o file confrontandoli con la fonte originale.
Verifica dei confini: esaminare i risultati in prossimità dei confini tra le sezioni per assicurarsi che un concetto non sia stato suddiviso o contraddetto tra le diverse parti.
Controllo negativo: porre una domanda la cui risposta è notoriamente assente. Un buon flusso di lavoro dovrebbe affermare che la prova non è presente, piuttosto che inventarla.
Verifica della ripetibilità: riproporre alcune domande rappresentative. Ampie variazioni nelle prove citate potrebbero indicare una scarsa capacità di recupero delle informazioni o una domanda troppo generica.
Controllo del budget: se si utilizza un'API, è opportuno verificare l'effettivo utilizzo dei token di input e output anziché basarsi solo su stime approssimative del numero di parole.
Il passaggio finale è la verifica: prima di dare credito all'analisi combinata, controllare la copertura, i riferimenti alle fonti, i confini dei segmenti e le affermazioni non supportate da prove.
Cosa non fare
Non continuare a inviare la stessa richiesta sovradimensionata aspettandoti un limite di token diverso. Non eliminare i riferimenti alla sorgente durante la suddivisione in blocchi. Non presumere che l'accettazione di un file implichi che ogni pagina sia attiva nel contesto. E non risolvere l'errore accorciando la risposta in modo così drastico da impedire all'analisi di soddisfare il compito.
Evitate inoltre di considerare la troncatura automatica come una magia invisibile. Se il sistema elimina gli elementi più vecchi, la richiesta potrebbe andare a buon fine ma perdere istruzioni o prove importanti. Per analisi di grande rilevanza, la suddivisione e il recupero espliciti dei dati sono generalmente più facili da verificare.
Una regola decisionale pratica
Se una nuova discussione e una domanda più specifica funzionano, mantieni il flusso di lavoro semplice. Se l'attività richiede un'ampia analisi di un documento lungo, suddividilo in sezioni logiche e sintetizza analisi strutturate di blocchi. Se interroghi ripetutamente una raccolta di documenti molto ampia, usa il recupero. Se controlli l'API e ti avvicini comunque al limite, misura i token, riserva spazio di output, seleziona un modello appropriato e rendi il comportamento di troncamento una decisione di progettazione esplicita.
Il risultato migliore non è quello che condensa la maggior quantità di testo in un'unica richiesta, bensì quello che include tutte le prove necessarie, preserva la tracciabilità e rende evidente quando le informazioni non erano disponibili.