Home
» domini
»
Come generare automaticamente meta titoli e descrizioni SEO utilizzando Local Ollam
Come generare automaticamente meta titoli e descrizioni SEO utilizzando Local Ollam
Hai 300 pagine di prodotti, documentazione o blog pronte per la pubblicazione, ma la colonna dei metadati è ancora vuota. Scrivere a mano ogni titolo e meta descrizione è lento; copiare lo stesso schema in tutto il sito produce risultati ripetitivi; e chiedere a un modello di lingua locale "un titolo SEO" spesso restituisce commenti superflui, affermazioni inventate o formattazioni incoerenti.
Un approccio migliore consiste nel trattare la generazione dei metadati come una piccola pipeline di dati: fornire al modello solo informazioni specifiche per la pagina, richiedere un output strutturato, convalidarlo nel codice e quindi esaminare le eccezioni prima della pubblicazione. Ollama è particolarmente adatto a questo flusso di lavoro perché la sua API locale è disponibile dopo http://localhost:11434/apil'installazione e supporta output strutturati in formato JSON-schema. La documentazione di Ollama e Google Search qui citata è stata verificata il 13 settembre 2026.
Perché i metadati SEO automatici non funzionano correttamente
La maggior parte degli errori deriva dal flusso di lavoro relativo al modello, piuttosto che da un singolo "comando errato". Le cause più comuni includono l'inserimento di una quantità insufficiente di contenuti nella pagina, la possibilità per il modello di rispondere in forma libera, l'applicazione della stessa formula di parole chiave a ogni URL e la pubblicazione dell'output senza controlli di duplicazione a livello di sito.
Esiste anche un equivoco persistente sui limiti di caratteri. Google afferma che non esiste un limite di lunghezza fisso per <title>gli elementi o le meta descrizioni di una pagina; i link del titolo e gli snippet vengono troncati secondo necessità, in genere in base alla larghezza del dispositivo. Google può anche generare un link del titolo o uno snippet diverso dal contenuto della pagina quando i suoi sistemi ritengono un'altra rappresentazione più utile. Consulta le linee guida ufficiali di Google per i link del titolo , gli snippet e le meta descrizioni .
Ciò significa che uno script può imporre limiti di lunghezza editoriali per garantire la coerenza, ma non deve indicare tali limiti come requisiti di Google. Nell'esempio seguente, 65 caratteri per il titolo e 165 per la descrizione sono solo limiti interni. Modificali in base al tuo CMS, al tuo marchio, alle esigenze di localizzazione e al processo di revisione.
Passaggio 1: Installa Ollama e verifica che l'API locale funzioni
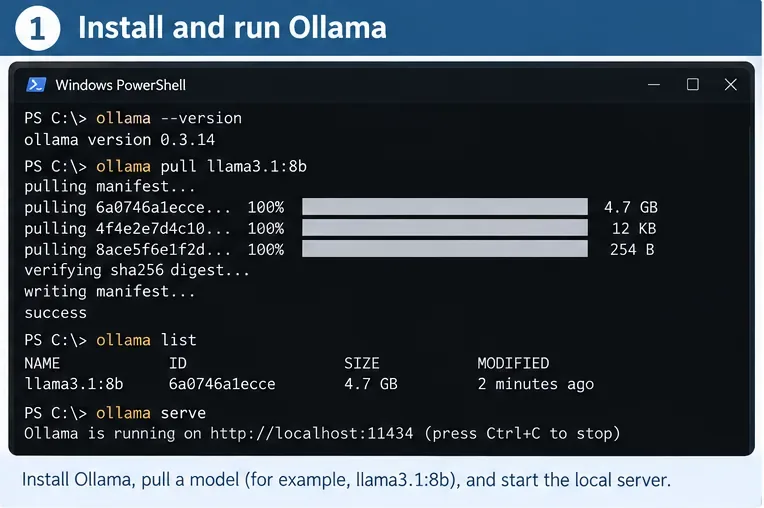
La guida rapida ufficiale di Ollama elenca il supporto per macOS, Windows e Linux. Dopo l'installazione, scarica un modello locale. La documentazione attuale di Ollama utilizza spesso gemma3negli esempi API, quindi è un esempio neutro e conveniente per questo tutorial:
ollama pull gemma3
Quindi testa l'endpoint locale:
curl http://localhost:11434/api/generate -d '{"model":"gemma3","prompt":"Reply with the word ready.","stream":false}'
La documentazione dell'API di Ollama afferma che l'API locale è disponibile all'indirizzo http://localhost:11434/api. Ollama afferma inoltre che l'accesso locale a questo indirizzo non richiede autenticazione. Se il servizio locale non è in esecuzione, ollama serveè il comando CLI documentato per avviarlo. Evita di sostituire un -cloudmodello se il tuo obiettivo è l'inferenza locale.
Flusso di lavoro da terminale per la fase di configurazione: verifica Ollama, scarica un modello locale, conferma che appaia nell'elenco dei modelli locali e assicurati che il servizio sia disponibile su localhost. Il nome del modello e la lunghezza indicati sono valori di esempio del flusso di lavoro e non requisiti SEO.
Scegli un modello in base al tuo hardware
Questo articolo non intende affermare che un modello sia universalmente il migliore per i metadati SEO. La disponibilità dei modelli e l'idoneità dell'hardware cambiano nel tempo, e i modelli più complessi richiedono più memoria e in genere rispondono più lentamente. Iniziate con un modello che il vostro computer può eseguire senza problemi, generate un piccolo set di dati di prova, quindi confrontate l'accuratezza dei dati, l'unicità, la latenza e la coerenza prima di elaborare migliaia di pagine.
Passaggio 2: Forzare l'output strutturato anziché analizzare la prosa
Il testo libero è fragile per l'automazione. Una risposta come "Ecco tre ottime opzioni..." costringe il programma a indovinare dove inizia il titolo effettivo. La documentazione sugli output strutturati di Ollama supporta il passaggio di uno schema JSON nel formatcampo. La documentazione raccomanda anche schemi riutilizzabili tramite Pydantic in Python e osserva che una bassa temperatura, come 0, può migliorare il determinismo.
Installa i due pacchetti Python utilizzati in questo esempio:
python -m pip install -U ollama pydantic
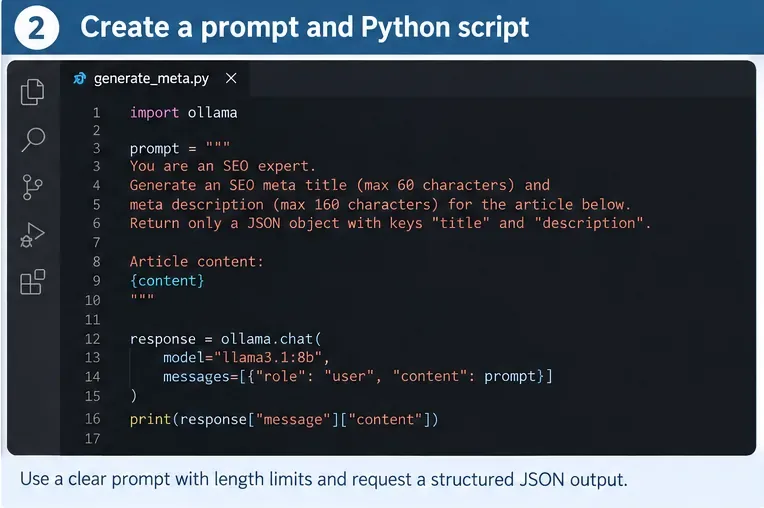
Quindi crea generate_meta.py:
from ollama import Client
from pydantic import BaseModel, Field

MODEL = "gemma3"
client = Client(host="http://localhost:11434")

class SeoMeta(BaseModel):
    title: str = Field(min_length=10, max_length=65)
    description: str = Field(min_length=70, max_length=165)

SYSTEM = """
You create SEO metadata from the page content supplied by the user.

Rules:
- Accurately describe only what is present in the page content.
- Write a concise, descriptive title.
- Write a useful meta description that distinguishes this page from other pages.
- Do not repeat keywords unnaturally.
- Keep the same primary language as the page.
- Do not invent prices, dates, features, guarantees, statistics, or claims.
- The length bounds in the JSON schema are our editorial limits, not Google rules.
- Return only the structured result required by the schema.
"""

def generate_meta(url: str, source_title: str, h1: str, body_text: str) -> SeoMeta:
    prompt = f"""
URL: {url}
Current title: {source_title}
H1: {h1}

Page text:
{body_text[:12000]}

Create one meta title and one meta description for this page.
"""
    response = client.chat(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        format=SeoMeta.model_json_schema(),
        options={"temperature": 0},
    )
    return SeoMeta.model_validate_json(response.message.content)

if __name__ == "__main__":
    result = generate_meta(
        url="https://example.com/guides/clean-cast-iron",
        source_title="Cast Iron Guide",
        h1="How to Clean a Cast-Iron Skillet Without Damaging the Seasoning",
        body_text=(
            "This guide explains how to remove stuck food, wash a cast-iron "
            "skillet, dry it thoroughly, and apply a thin layer of oil..."
        ),
    )
    print(result.model_dump_json(indent=2))
Il generatore dovrebbe essere esplicito riguardo alle prove presenti nella pagina, ai campi di output e ai vincoli editoriali. In produzione, è preferibile utilizzare l'output strutturato in JSON-schema di Ollama e la convalida lato applicazione piuttosto che affidarsi esclusivamente alla formulazione del prompt.
Perché il prompt include il titolo corrente e H1
Google afferma che il suo sistema di collegamento tra titoli e pagine può prendere in considerazione il titolo visivo principale della pagina <title>, intestazioni come <h1><h1>, og:title<h2>, testo prominente, testo di ancoraggio e altri segnali. Il generatore locale non deve necessariamente riprodurre il sistema di Google, ma fornirgli il titolo sorgente, l'H1, l'URL e il testo del corpo rappresentativo aiuta a mantenere i metadati proposti allineati con la pagina che i lettori visualizzeranno effettivamente.
Non inserire elenchi di parole chiave non correlate e non chiedere al modello di "inserirle". Google raccomanda esplicitamente titoli descrittivi e concisi e mette in guardia contro il keyword stuffing e la ripetizione di testi standard. Per quanto riguarda le descrizioni, Google afferma che la generazione programmatica specifica per pagina è appropriata per siti web di grandi dimensioni basati su database, a condizione che le descrizioni siano accurate, leggibili e diversificate.
Passaggio 3: Esegui una pagina, quindi convalidala prima di scalare
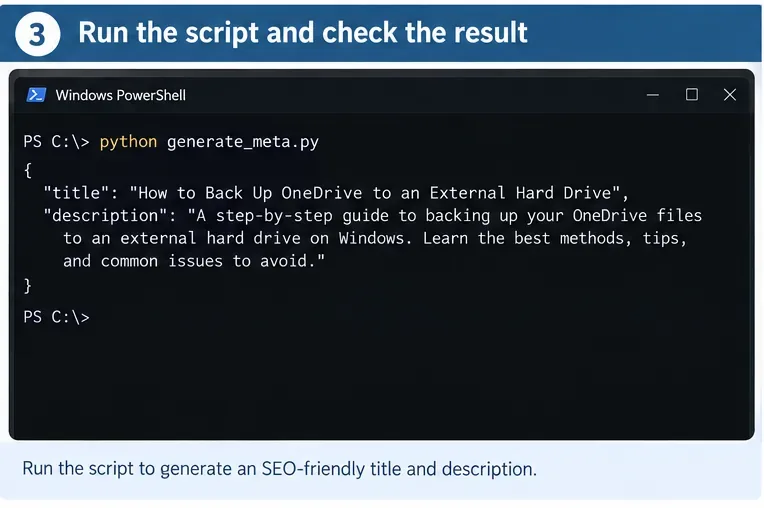
Esegui lo script:
python generate_meta.py
Un risultato positivo dovrebbe essere un oggetto JSON che Pydantic sia in grado di validare. Ancora più importante, un revisore umano dovrebbe essere in grado di confrontarlo con la pagina sorgente e rispondere rapidamente a quattro domande:
Il titolo si riferisce a questa pagina specifica o all'intero sito web?
La descrizione evita affermazioni, date, prezzi o caratteristiche assenti nel contenuto originale?
Questi metadati avrebbero ancora senso se letti senza il corpo della pagina?
Si distingue dai metadati già utilizzati nelle pagine vicine?
Prima di avviare un'elaborazione batch, testate una pagina rappresentativa e verificate la struttura del risultato. È necessaria una risposta JSON analizzabile, ma l'accuratezza dei dati e la pertinenza a livello di pagina richiedono comunque una convalida.
Aggiungi tentativi di ripetizione anche in caso di errori editoriali, non solo in caso di errori API.
Uno schema può limitare i tipi e la lunghezza dei dati, ma non può garantire che una frase sia veritiera o sufficientemente specifica. Implementa una logica di ripetizione basata su controlli misurabili. Ad esempio, rifiuta un campo vuoto, un titolo duplicato, un testo standard non consentito o una descrizione che ripete il titolo quasi parola per parola. Se la pagina contiene affermazioni regolamentate o di particolare rilevanza, richiedi una revisione umana anziché tentare di automatizzare la verifica dell'affidabilità.
Limita i suggerimenti per i tentativi successivi. Invece di rigenerare tutto con "migliora", indica al modello cosa non ha funzionato: "Il titolo proposto duplica un'altra pagina. Riscrivilo utilizzando l'argomento univoco nell'H1, mantenendo ogni affermazione basata sul contenuto fornito". In questo modo, è più facile verificare gli errori.
Passaggio 4: Elaborare le pagine in formato CSV per la revisione e la pubblicazione
Una volta che il test di una pagina è affidabile, salva i tuoi input in un file CSV con colonne come url, source_title, h1, e content. Il campo contenuto dovrebbe contenere testo della pagina ripulito, non menu di navigazione, avvisi sui cookie o migliaia di link non correlati nel piè di pagina.
Aggiungi questa logica batch sotto la funzione generatrice oppure inseriscila in uno script separato:
import csv

rows = []
seen_titles = set()

with open("pages.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        meta = generate_meta(
            url=row["url"],
            source_title=row.get("source_title", ""),
            h1=row.get("h1", ""),
            body_text=row["content"],
        )

        flags = []
        normalized = meta.title.casefold().strip()
        if normalized in seen_titles:
            flags.append("duplicate_title")
        seen_titles.add(normalized)

        rows.append({
            **row,
            "generated_title": meta.title,
            "generated_description": meta.description,
            "title_length": len(meta.title),
            "description_length": len(meta.description),
            "qa_flags": ",".join(flags),
        })

with open("seo_meta_output.csv", "w", newline="", encoding="utf-8") as f:
    fieldnames = list(rows[0].keys())
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(rows)
Il file CSV di output può essere esaminato in Excel, LibreOffice, uno strumento di importazione da database o nel flusso di lavoro del tuo CMS. Non sovrascrivere automaticamente i metadati attivi alla prima esecuzione. Mantieni il titolo e la descrizione originali accanto alla proposta generata in modo che i revisori possano confrontarli e per semplificare il ripristino.
Una coda di revisione tramite foglio di calcolo semplifica il controllo della generazione in blocco: conserva l'identificativo della pagina sorgente, il titolo generato, la descrizione generata, la lunghezza e i flag di controllo qualità prima di pubblicare le modifiche.
Rendere più sicura la pipeline batch
Controllo
Cosa segnalare
Perché è importante
Validazione dello schema
Campi mancanti o non validi
Impedisce che output non validi vengano inseriti nel CMS.
Controllo del titolo duplicato
Lo stesso titolo normalizzato su due URL
Aiuta a rendere le pagine distinguibili.
Controllo linguistico
Il linguaggio dei metadati è diverso dal linguaggio della pagina.
Google consiglia di utilizzare la stessa lingua e lo stesso sistema di scrittura della pagina.
Verifica delle prove
Numeri, prezzi, date, marchi o garanzie assenti dalla fonte
Riduce le denunce basate su allucinazioni.
Controllo standard
Frasi lunghe ripetute in tutto il sito
Google sconsiglia di utilizzare titoli ripetitivi e standardizzati.
Controllo della lunghezza editoriale
Al di fuori del raggio di abitazione da te scelto
Mantiene coerente l'output del CMS; non si tratta di una regola di Google relativa al limite di caratteri.
Revisione umana
Pagine strategiche, sensibili, ad alto traffico o ambigue
L'automazione dovrebbe evidenziare le eccezioni, non nasconderle.
Problemi comuni, dalla soluzione più semplice alla più difficile
La connessione API non riesce
Innanzitutto, verifica che Ollam sia in esecuzione e http://localhost:11434raggiungibile. La documentazione ufficiale sull'autenticazione afferma che l'autenticazione non è richiesta per l'API locale. Se il tuo script punta accidentalmente a https://ollama.com/api, si tratta di un endpoint ospitato diverso e richiede l'autenticazione.
La risposta contiene testo che circonda il JSON
Utilizza lo schema completo format=SeoMeta.model_json_schema()anziché richiedere solo JSON in linguaggio naturale. L'output strutturato è il livello di controllo ideale per una pipeline di produzione.
I titoli suonano tutti uguali
Inserisci testo H1 specifico per la pagina e contenuti significativi nel corpo del testo, rimuovi il rumore di navigazione globale e richiedi esplicitamente una descrizione specifica per la pagina. Quindi esegui un controllo di duplicati e similarità tra le pagine. La ripetizione è spesso un problema di input prima ancora di essere un problema di modello.
Il modello inventa caratteristiche o statistiche
Riduci l'input al testo autorevole della pagina e rafforza la regola di base: nessuna affermazione fattuale al di là del contenuto fornito. Per le pagine importanti, confronta le asserzioni generate con i campi strutturati della fonte prima dell'approvazione. Se la fonte stessa è ambigua, invia la riga a una revisione umana invece di chiedere ripetutamente al modello di fare delle supposizioni.
Il modello è troppo lento per migliaia di pagine
Prima di modificare l'architettura, effettuate delle misurazioni. Registrate il tempo di generazione per pagina, la dimensione dell'input, il nome del modello e il tasso di errore. Troncate il testo del corpo non pertinente, elaborate le sezioni di pagina stabili e, se la qualità rimane accettabile, testate un modello locale più piccolo. Il modello più veloce non è utile se i suoi metadati comportano più lavoro di revisione di quanto ne risparmino.
Opzionale: utilizzare un'integrazione esistente in stile OpenAI
Se disponete già di codice scritto per un client compatibile con OpenAI, Ollama documenta la compatibilità parziale con l'API OpenAI all'indirizzo [link] http://localhost:11434/v1/. Questo può ridurre il lavoro di migrazione. Per un nuovo strumento di metadati utilizzabile solo localmente, il client Python nativo di Ollama è più semplice ed espone esempi di output strutturato direttamente nella documentazione di Ollama.
Come effettuare un'autoverifica del sistema finito
Prima di considerare completata l'automazione, crea un set di revisione contenente diversi tipi di contenuto: un breve articolo, una guida lunga, una pagina prodotto, una pagina di categoria, una pagina con dati numerici e una pagina in ogni lingua supportata. Esegui lo stesso modello e la stessa richiesta di informazioni su tutti i set, quindi verifica la seguente checklist.
L'endpoint locale è localhoste il modello selezionato è un modello locale, non un modello con tag cloud.
Ogni risposta viene convalidata rispetto allo schema senza necessità di pulizia manuale del JSON.
Nessun titolo generato è duplicato nell'insieme delle recensioni.
Ogni affermazione di fatto è presente nel contenuto della pagina fornita.
I metadati utilizzano la stessa lingua principale e lo stesso sistema di scrittura della pagina.
Il titolo è descrittivo e conciso, senza parole chiave ripetute.
La descrizione riassume la pagina specifica, non l'intero sito.
Le tue linee guida sulla lunghezza interna sono etichettate come regole editoriali, non come requisiti di Google.
I vecchi metadati, la proposta generata, i flag di controllo qualità, il nome del modello e la versione del prompt vengono salvati per scopi di verifica e ripristino.
Un revisore sa quali flag richiedono l'approvazione manuale prima della pubblicazione.
Infine, ricordate cosa l'automazione può e non può controllare. Una buona <title>meta descrizione fornisce ai motori di ricerca segnali utili a livello di pagina, ma Google può generare link e snippet dal titolo di altri contenuti della pagina. L'obiettivo, quindi, non è quello di imporre una particolare visualizzazione dei risultati di ricerca. L'obiettivo è produrre metadati accurati, distinti e utili su larga scala, preservando al contempo sufficienti processi di validazione e revisione per individuare gli errori prima che raggiungano la produzione.