Home
» domini
»
Come ridurre i tempi di rendering in ComfyUI per un flusso di lavoro SDXL
Come ridurre i tempi di rendering in ComfyUI per un flusso di lavoro SDXL
Il modo più rapido per ridurre i tempi di rendering in un flusso di lavoro ComfyUI SDXL è solitamente quello di ridurre la quantità di lavoro di diffusione prima di modificare i flag di avvio di basso livello: eseguire i test a una risoluzione SDXL appropriata, mantenere la dimensione del batch a 1 durante l'ottimizzazione, utilizzare meno passaggi di campionamento quando la qualità rimane elevata e disabilitare temporaneamente le operazioni aggiuntive dispendiose in termini di risorse come i raffinatori, i rami ControlNet, i passaggi di upscaling o i preprocessori. Solo dopo aver fatto ciò si dovrebbe ottimizzare la VRAM, l'attenzione, l'anteprima e il comportamento della cache.
Quest'ordine è importante perché i flag di avvio non possono compensare un flusso di lavoro che richiede alla GPU di svolgere un lavoro due o tre volte superiore al necessario. La documentazione attuale di ComfyUI raccomanda inoltre di ridurre prima la risoluzione o la dimensione del batch quando la generazione è lenta, per poi utilizzare ottimizzazioni di memoria e di attenzione secondo necessità. Le indicazioni seguenti sono state verificate rispetto alla documentazione attuale di ComfyUI e PyTorch il 13 settembre 2026.
Perché i flussi di lavoro SDXL rallentano in ComfyUI
Un rendering SDXL può impiegare tempo in diverse fasi: caricamento o spostamento dei pesi del modello, codifica del testo CLIP, denoising ripetuto all'interno di KSampler, ControlNet o altri processi di condizionamento, decodifica VAE, upscaling e qualsiasi fase di secondo passaggio o di affinamento. Se la VRAM è limitata, ulteriori trasferimenti dalla CPU alla GPU possono aumentare ulteriormente la latenza.
Ciò significa che due utenti con la stessa GPU possono riscontrare tempi di rendering molto diversi. Un semplice grafico di conversione testo-immagine a 1024 bit non è paragonabile a un flusso di lavoro che include un raffinatore, due ControlNet, un secondo passaggio ad alta risoluzione e un batch di grandi dimensioni. L'obiettivo è identificare la parte del grafico che incide maggiormente sul calcolo, quindi rimuovere o ottimizzare tale parte senza sacrificare la qualità dell'output che effettivamente interessa.
1. Misura una linea di base pulita prima di modificare qualsiasi cosa
Utilizzare un prompt fisso, un seed fisso, una dimensione batch pari a 1 e la stessa risoluzione di output. Eseguire il flusso di lavoro almeno due volte. La prima esecuzione può includere il caricamento dei checkpoint, la compilazione, l'I/O su disco o il trasferimento dei modelli; un'esecuzione successiva fornisce una misura migliore della velocità di generazione a regime.
Verificate inoltre se la GPU sta effettivamente svolgendo il lavoro. Sui sistemi NVIDIA, nvidia-smiè possibile visualizzare l'utilizzo della VRAM e dell'utilizzo della GPU. Se l'utilizzo della GPU rimane basso mentre il sistema trasferisce costantemente dati o carica modelli, il collo di bottiglia potrebbe essere dovuto alla pressione sulla memoria o all'I/O, piuttosto che al campionatore stesso.
Prima di ottimizzare ComfyUI, verifica il comportamento di GPU e VRAM. Considera i valori qui riportati come un esempio di layout, non come un obiettivo di riferimento.
2. Parti dal grafico SDXL più piccolo che produce il risultato di cui hai bisogno
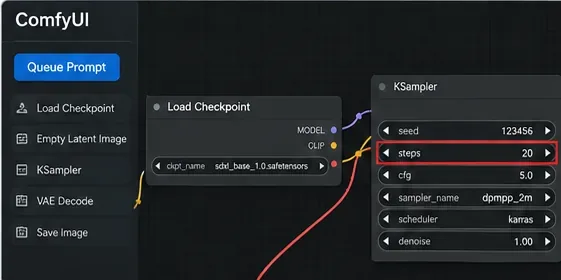
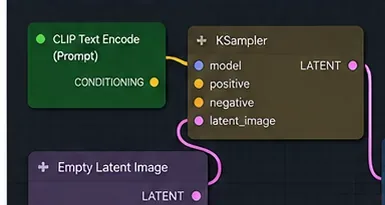
Prima di ottimizzare un flusso di lavoro complesso, confrontatelo con un percorso minimo: caricamento del checkpoint, condizionamento del prompt, un'immagine latente vuota, KSampler, decodifica VAE e salvataggio dell'immagine. Gli esempi ufficiali di ComfyUI mostrano che il checkpoint di base SDXL può essere utilizzato come un normale checkpoint. Se questo grafico di base è veloce ma il grafico di produzione è lento, il problema risiede nei rami aggiuntivi.
In fase di bozza, disabilitare temporaneamente i componenti non essenziali per la decisione corrente. Esempi includono un raffinatore, una seconda fase di upscaling, pre-processori di immagine, più ControlNet o rami di stile opzionali. Riattivarli uno alla volta dopo aver ottenuto un risultato accettabile per l'immagine di base.
Un piccolo grafico SDXL rappresenta il punto di partenza ideale. Aggiungete rami dispendiosi in termini di tempo solo dopo aver verificato quanto tempo richiede ciascuno di essi.
3. Riduci il numero di passaggi di KSampler prima di tentare impostazioni di velocità insolite.
Il numero di passaggi di campionamento è uno dei parametri più evidenti, poiché ogni passaggio aggiuntivo di denoising comporta un carico di lavoro maggiore. Riducendo il numero di passaggi da un valore più alto a uno più basso, la fase di campionamento del rendering dovrebbe diminuire, sebbene il tempo totale di elaborazione non si riduca esattamente della stessa percentuale, poiché il caricamento del modello, la codifica dei prompt, la decodifica VAE e altri nodi richiedono comunque tempo.
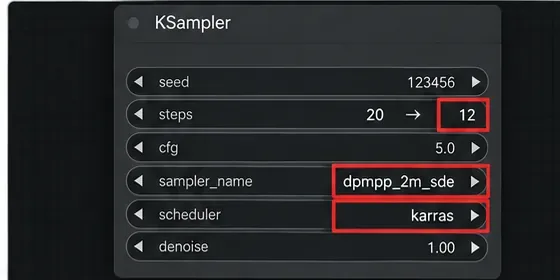
Non copiare un conteggio di passaggi "ottimale" universale da qualcun altro. Il numero giusto dipende dal checkpoint, dal campionatore, dallo scheduler, dal prompt, dal CFG e dall'obiettivo di qualità. Un metodo pratico è quello di mantenere il seed fisso e testare una piccola scala: ad esempio, l'impostazione corrente, poi una modesta riduzione, poi un'ulteriore riduzione. Fermati quando le texture, l'anatomia, la tipografia o la fedeltà del prompt si degradano più di quanto tu sia disposto ad accettare.
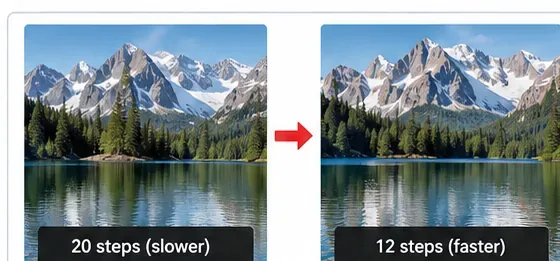
Ridurre il numero di passaggi di KSampler può diminuire i tempi di denoising. I valori mostrati sono a scopo illustrativo; verificare la qualità con un proprio checkpoint e un seed fisso.
4. Mantenere sotto controllo la risoluzione del test e la dimensione del batch.
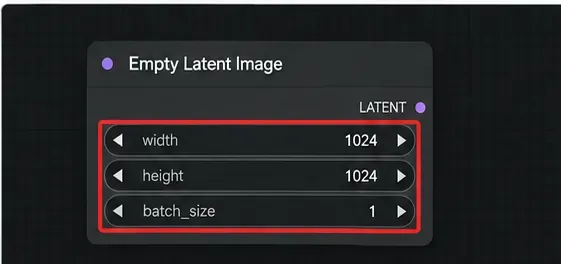
Per SDXL, gli esempi ufficiali di ComfyUI raccomandano 1024×1024 o altri rapporti di aspetto con un numero di pixel pressoché identico, come 896×1152 o 1536×640, per un comportamento ottimale del modello base. Superare significativamente questo limite di pixel aumenta le dimensioni latenti e, di conseguenza, il consumo di risorse di calcolo e di memoria.
Durante la messa a punto dei prompt e del flusso di lavoro, mantieni il valore batch_sizea 1 a meno che tu non abbia bisogno specificamente di testare la velocità di elaborazione. Un batch di quattro richiede alla pipeline di produrre quattro immagini in un'unica esecuzione; questo può migliorare la velocità di elaborazione in alcune configurazioni, ma non è il modo per ridurre al minimo il tempo di acquisizione della prima immagine e aumenta i requisiti di memoria.
Se il risultato finale deve essere di dimensioni superiori alla normale risoluzione di base di SDXL, valuta la possibilità di separare la fase di "test della composizione" dalla fase finale di elaborazione ad alta risoluzione. Assicurati prima di tutto di impostare correttamente prompt, seed, condizionamento e composizione, e poi paga per il costoso upscaling o la seconda fase solo per i candidati selezionati.
Un latente di 1024 classi con dimensione del batch pari a 1 rappresenta una valida base di riferimento per la messa a punto di SDXL prima di passare a risoluzioni più elevate o a elaborazioni multi-immagine.
5. Esegui test comparativi sui campionatori e sugli scheduler invece di presumere che uno sia sempre il più veloce.
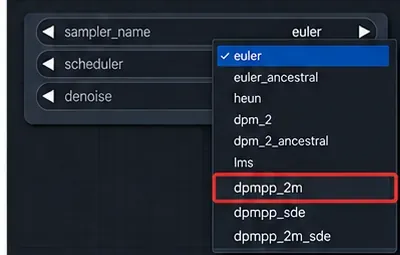
ComfyUI mette a disposizione diverse opzioni di campionatore e scheduler in KSampler. Combinazioni diverse possono raggiungere una qualità accettabile con un numero diverso di passaggi, quindi "più veloce" dovrebbe significare il più veloce alla qualità desiderata , non semplicemente la singola esecuzione più breve.
Utilizza lo stesso checkpoint, prompt, seed, risoluzione e CFG per il confronto. Modifica solo il campionatore o lo scheduler, quindi confronta sia il tempo di rendering che la qualità visibile. Se una combinazione richiede un numero di passaggi significativamente inferiore per il checkpoint, pur mantenendo il risultato desiderato, si tratta di un reale vantaggio in termini di velocità. Se invece richiede passaggi aggiuntivi per recuperare i dettagli, il vantaggio apparente potrebbe svanire.
Modificate una sola variabile del campionatore alla volta e confrontate i risultati con un seed fisso. Non date per scontato che un campionatore sia più veloce per ogni checkpoint o obiettivo di qualità di SDXL.
6. Elimina il lavoro ridondante sui grafici e sfrutta a tuo vantaggio il modello di esecuzione di ComfyUI.
ComfyUI è progettato per eseguire solo le parti del grafico necessarie. La documentazione del progetto afferma che le porzioni non modificate possono essere riutilizzate tra le esecuzioni e il backend attuale include una cache configurabile per i risultati dei nodi. Questo è utile quando si modifica solo un valore a valle anziché ricostruire l'intero flusso di lavoro.
Quando possibile, mantieni stabili i nodi di caricamento e le costose elaborazioni a monte. Se cambi continuamente i checkpoint, ridimensioni ripetutamente immagini di grandi dimensioni o invalidi i nodi a monte, perdi il vantaggio del lavoro memorizzato nella cache.
ComfyUI dispone anche di una funzionalità di esecuzione parziale documentata che consente di eseguire solo la parte di un flusso di lavoro necessaria per un nodo di output selezionato. Utilizzatela quando state testando un ramo a valle e non avete bisogno di rigenerare ogni output in un grafico di grandi dimensioni.
Un grafico snello rende più facile individuare i colli di bottiglia. Utilizza la cache e l'esecuzione parziale in modo che il lavoro a monte, che non è cambiato, non venga ripetuto inutilmente.
7. Regola le anteprime, la cache, la modalità VRAM e l'attenzione solo dopo che il grafico è efficiente
Le attuali opzioni della riga di comando di ComfyUI offrono diversi controlli per le prestazioni. I loro effetti dipendono dall'hardware e dalla memoria disponibile, quindi è consigliabile considerarli come potenziali parametri di riferimento piuttosto che come opzioni obbligatorie.
Collocamento
Quando può essere d'aiuto
Principale compromesso
--preview-method none
Se le anteprime del campionatore sono abilitate e ti interessa solo l'output finale
Si perdono le anteprime latenti in tempo reale. L'attuale interfaccia a riga di comando non utilizza già anteprime come impostazione predefinita.
--highvram
Se hai abbastanza VRAM e il ripetuto scaricamento/ricaricamento del modello sta costando tempo
Mantiene i modelli nella memoria della GPU e può causare errori di memoria insufficiente su schede con risorse limitate.
--lowvram
Se il flusso di lavoro non rientra nella VRAM
Questa è principalmente una modalità di risparmio di memoria, non una modalità di velocità; l'utilizzo della CPU o i trasferimenti possono aumentare la latenza.
--use-pytorch-cross-attention
Vale la pena eseguire un benchmark sulle moderne combinazioni PyTorch/GPU.
Non combinare alla cieca flag di modalità attenzione che si escludono a vicenda.
--use-flash-attention
Vale la pena testare se il tuo stack hardware/software supporta il percorso ottimizzato
La disponibilità e i vantaggi dipendono dagli input e dai kernel supportati.
--cache-classicO--cache-lru N
Flussi di lavoro ripetitivi in cui è accettabile una maggiore quantità di memoria cache.
Può utilizzare più RAM/VRAM.
--cache-none
Solo quando ridurre la memoria cache è più importante della velocità
La CLI di ComfyUI afferma che ogni nodo verrà eseguito per ogni ciclo di rendering, il che solitamente peggiora i tempi di rendering.
L'attuale interfaccia a riga di comando (CLI) espone anche l'offload asincrono dei pesi e il relativo testo di aiuto indica che è abilitato di default su NVIDIA. Ciò significa che l'aggiunta di ulteriori flag non si traduce automaticamente in un'ottimizzazione; prima di procedere, verifica il comando di avvio corrente e i relativi log.
L'attenzione scalata basata sul prodotto scalare di PyTorch può selezionare automaticamente implementazioni CUDA ottimizzate, come FlashAttention o l'attenzione a basso consumo di memoria, quando gli input e l'hardware lo consentono. Questo è il motivo per cui i moderni percorsi di attenzione possono essere importanti, ma il guadagno esatto dipende dall'hardware. Evitate di citare una percentuale generica come se fosse applicabile al vostro flusso di lavoro SDXL.
8. Mantieni il comportamento della coda e del batch allineato al tuo obiettivo
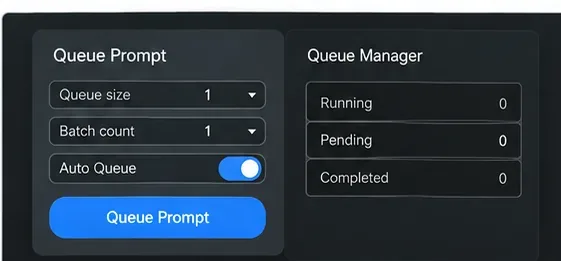
Se la priorità è ottenere il feedback più rapido possibile, durante la fase di ottimizzazione è consigliabile mettere in coda un'immagine alla volta. Un numero elevato di immagini in coda e di batch è utile quando si conoscono già le impostazioni e si desidera la massima velocità di elaborazione, ma non velocizza l'arrivo della prima immagine.
Una volta finalizzato il flusso di lavoro, è possibile eseguire un test di velocità di elaborazione separatamente. A quel punto, un batch più grande potrebbe essere opportuno se la VRAM lo consente e se il numero di immagini al minuto è più importante della latenza per immagine.
Per la messa a punto interattiva, utilizzare un'immagine in coda e una dimensione del batch pari a 1; in seguito, quando l'obiettivo è la velocità di elaborazione, testare batch più grandi.
Come capire se l'ottimizzazione ha funzionato davvero
Un'esecuzione più veloce è utile solo se l'immagine raggiunge comunque l'obiettivo prefissato. Confronta il prima e il dopo con lo stesso seed e lo stesso prompt. Verifica innanzitutto le aree che presentano problemi quando le impostazioni sono troppo aggressive: testo piccolo, mani e volti, motivi ripetuti, materiali fini, dettagli dei bordi e aderenza agli attributi specifici del prompt.
Registra almeno questi quattro elementi per ogni test: tempo totale di esecuzione, passaggi di campionamento, risoluzione e se si è verificato il caricamento del modello. Se la prima esecuzione richiede 30 secondi e la seconda 12 secondi, non attribuire automaticamente un cambio di campionatore: la prima esecuzione potrebbe aver semplicemente coperto il costo del caricamento del checkpoint.
Utilizzare confronti affiancati con seed fisso per decidere se un numero inferiore di passaggi è accettabile. Le etichette nell'immagine illustrano il metodo e non rappresentano risultati di riferimento.
Un ordine di ottimizzazione pratico
Eseguire un benchmark di una corsa preriscaldata. Mantenere fissi seed, prompt, risoluzione e batch.
Rimuovi i rami non necessari. Testa il percorso SDXL di base senza raffinatore, ControlNet, upscale o preprocessori opzionali.
Riduci i passaggi. Trova il numero minimo di passaggi che soddisfi comunque i tuoi standard di qualità.
Mantieni una risoluzione ragionevole. Regola la risoluzione tenendo conto del budget di pixel di classe 1024 dello SDXL prima di procedere alla finalizzazione ad alta risoluzione.
Mantieni il batch a 1 durante l'iterazione. Ottimizza la produttività solo dopo che il flusso di lavoro si è stabilizzato.
Confronta le diverse opzioni di campionatore/programmatore. Valuta la velocità a parità di qualità accettabile.
Utilizzare la cache e l'esecuzione parziale. Evitare di rieseguire operazioni precedenti non modificate.
Quindi esegui il benchmark dei flag di avvio. Testa l'anteprima, la VRAM, la cache e le modifiche all'attenzione una alla volta.
Quando è opportuno cambiare strategia anziché concentrarsi maggiormente sull'ottimizzazione.
Se, anche dopo queste modifiche, un flusso di lavoro SDXL continua a richiedere troppo tempo, è necessario esaminare le operazioni effettivamente eseguite. Un grafico di produzione multi-ControlNet, con raffinatore e upscaling, potrebbe essere intrinsecamente oneroso dal punto di vista computazionale. A questo punto, si hanno tre opzioni valide: accettare un rendering più lungo per le immagini finali, utilizzare un flusso di lavoro di bozza più semplice per le iterazioni, oppure spostare il carico di lavoro su hardware più performante.
Allo stesso modo, se la VRAM si esaurisce costantemente, forzare una modalità residente sulla GPU "più veloce" non è la soluzione giusta. Un'esecuzione stabile con la gestione dinamica della memoria predefinita o con una configurazione a VRAM inferiore è preferibile a ripetuti errori di memoria insufficiente. Le impostazioni di risparmio di memoria possono aumentare i tempi di rendering, ma un rendering più lento ma comunque riuscito è più utile di un crash immediato.