Home
» domini
»
Come creare GPT personalizzati che non dimenticano i propri file di conoscenza
Come creare GPT personalizzati che non dimenticano i propri file di conoscenza
Stato attuale, verificato il 13 settembre 2026: OpenAI afferma che gli account personali ChatGPT, inclusi Free, Go, Plus e Pro, non possono creare o pubblicare nuovi GPT. I GPT esistenti possono ancora essere utilizzati e, ove possibile, modificati. Negli spazi di lavoro Business, Enterprise ed Edu, la creazione dipende dalle impostazioni e dalle autorizzazioni dello spazio di lavoro. OpenAI afferma inoltre che i flussi di lavoro GPT personalizzati verranno migrati verso i plugin, con un flusso di migrazione previsto per il 17 settembre 2026 e la dismissione pianificata per i GPT Enterprise interessati l'11 dicembre 2026. Se stai leggendo questo messaggio in un secondo momento, verifica lo stato più recente nella documentazione di OpenAI sulla creazione e modifica dei GPT prima di creare un nuovo flusso di lavoro.
Un GPT personalizzato che sembra "dimenticare" un file di conoscenza in genere non ha perso il file. Le FAQ di OpenAI sul caricamento dei file affermano che i file caricati come conoscenza GPT vengono conservati finché il GPT personalizzato non viene eliminato. Il problema più comune è il recupero: il modello non legge necessariamente per intero ogni file caricato per ogni domanda. Recupera il materiale che sembra pertinente al prompt, quindi la qualità della fonte, la struttura del file, le istruzioni e i test influiscono sulla probabilità che venga visualizzato il passaggio corretto.
È inoltre importante distinguere tra "conoscenza" e "memoria". La documentazione di OpenAI relativa ai GPT (Group Process Tables) in ChatGPT afferma che i GPT non utilizzano la memoria salvata, le istruzioni personalizzate o le conversazioni precedenti; ogni conversazione inizia da zero. La conoscenza caricata è quindi una fonte di riferimento configurata, non una memoria conversazionale che si accumula dalle chat precedenti.
Come dovrebbe apparire un risultato affidabile
L'obiettivo non è costringere un GPT a citare un file a ogni turno. L'obiettivo è fare in modo che le risposte dipendenti dalla fonte siano costantemente basate sul materiale corretto, mentre le domande non supportate da prove falliscono in modo sicuro invece di produrre una supposizione azzardata.
Segnale di qualità
Che aspetto ha la “buona”
Quando modificare la configurazione
Correttezza
La risposta corrisponde al file autorevole relativo alla domanda sottoposta a verifica.
Se la risposta è errata nonostante la presenza dell'informazione, semplifica la fonte o restringi il campo della richiesta.
Messa a terra
Il GPT può specificare il nome del file o della sezione di supporto su richiesta.
Se la risposta si basa su conoscenze generali, rafforzare le istruzioni relative alla priorità della fonte e ripetere il test.
Astensione
Quando i file non contengono la risposta, GPT lo indica chiaramente.
Se inventa una politica, un prezzo, una data o una procedura, aggiungi una regola esplicita che vieti di fare supposizioni.
Se piccole modifiche alla formulazione causano deviazioni significative, è necessario ridurre l'ambiguità sia nei file che nelle istruzioni.
Integrità dell'aggiornamento
Dopo la revisione del testo, le stesse domande di valutazione riflettono il nuovo contenuto.
Se le vecchie risposte persistono, verificare che il file aggiornato sia allegato, salvare il file GPT ed eseguire nuovamente i test.
Otto passaggi per rendere più affidabile l'utilizzo dei file di conoscenza
1. Conferma che il tuo account o spazio di lavoro può ancora creare o modificare il GPT
Iniziate verificando l'idoneità, perché la mancanza del pulsante "Crea" potrebbe essere un comportamento previsto e non un problema del browser. Le attuali linee guida di OpenAI sui GPT in ChatGPT indicano che la creazione di nuovi GPT non è disponibile per gli account personali. Gli spazi di lavoro gestiti possono comunque consentire la creazione di GPT in base alle policy amministrative e alle autorizzazioni di ruolo. Se possedete già un GPT esistente, verificate se la modifica è ancora disponibile per il vostro account.
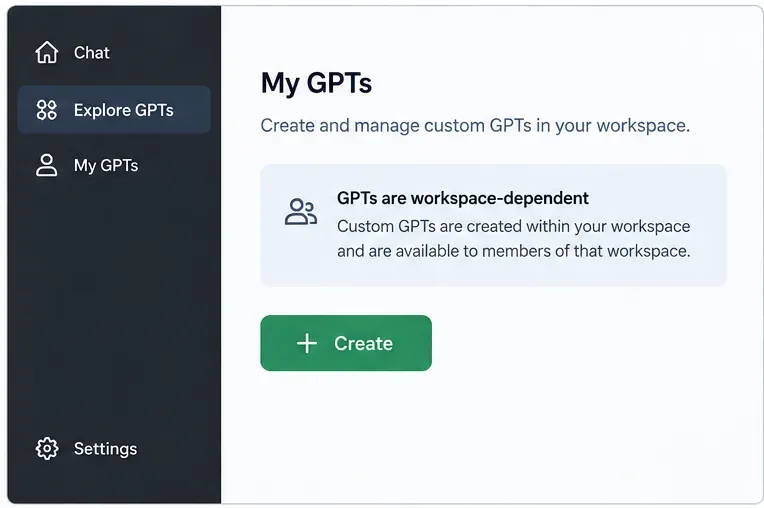
Negli spazi di lavoro gestiti idonei, iniziare dall'area GPT; la disponibilità dipende dalle autorizzazioni dello spazio di lavoro.
Non perdere tempo a risolvere i problemi di recupero delle informazioni finché non hai la certezza di lavorare in un editor supportato. Se la tua organizzazione sta già passando ai plugin, considera la parte restante di GPT personalizzata come un candidato per la migrazione piuttosto che come una nuova dipendenza a lungo termine.
2. Separare le istruzioni comportamentali dalla conoscenza
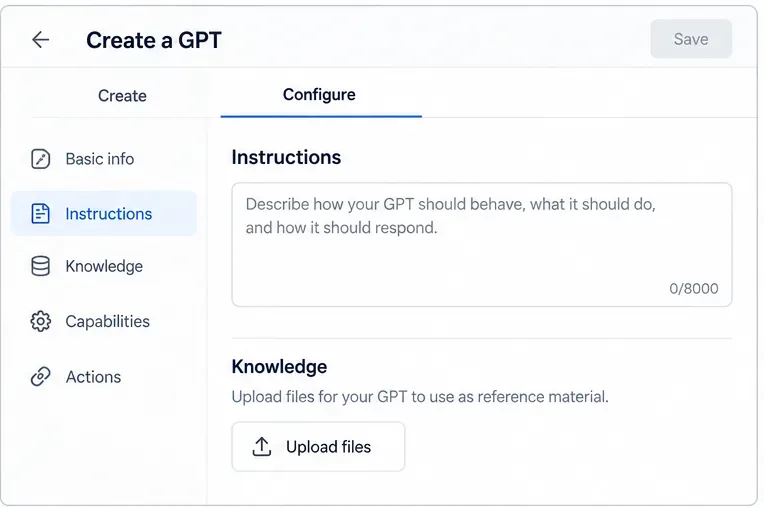
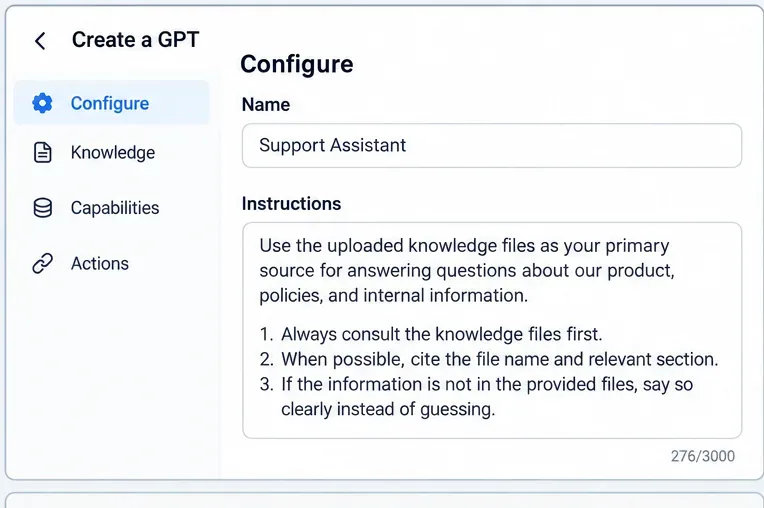
Utilizza il campo Istruzioni per regole quali tono, ordine decisionale, formato di citazione, comportamento di escalation e cosa deve fare il GPT quando una fonte non fornisce informazioni. Utilizza il campo Conoscenza per il materiale di riferimento: manuali, documentazione di prodotto, politiche, FAQ, specifiche o guide interne. OpenAI raccomanda esplicitamente questa separazione perché la conoscenza funziona meglio come materiale di origine, mentre le istruzioni definiscono il comportamento.
Conserva le regole di comportamento nella sezione Istruzioni e il materiale di riferimento nella sezione Conoscenze.
Questa distinzione è importante per l'affidabilità. Una frase come "Non citare mai un prezzo scaduto" appartiene alle Istruzioni. La tabella dei prezzi vera e propria appartiene alla sezione Conoscenze. Mescolare le regole in un voluminoso PDF di riferimento rende il comportamento più difficile da controllare e da testare.
3. Preparare i file per il recupero, non solo per la lettura umana.
Preferite file chiari e incentrati sul testo, con titoli descrittivi, sezioni brevi, terminologia coerente e date di versione inequivocabili. Una brochure dal design accattivante può rivelarsi meno efficace di un semplice file di testo o Markdown se le informazioni cruciali sono disperse tra colonne, riquadri, screenshot o layout decorativi.
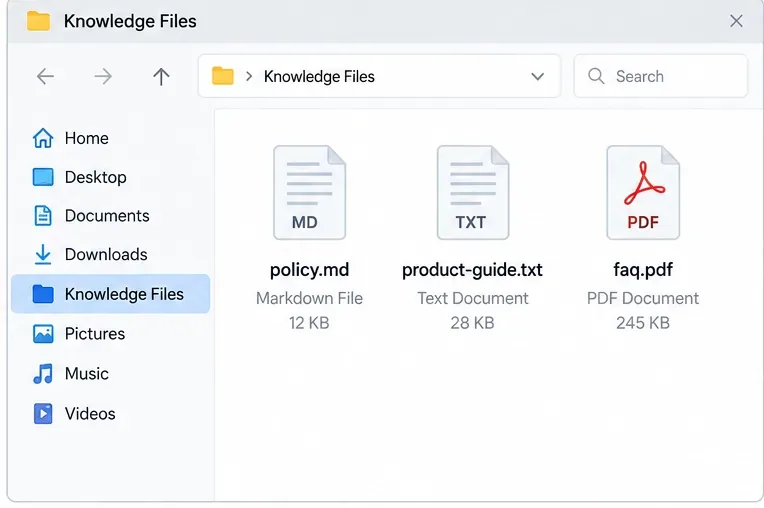
I file con struttura semplice e nomi chiari, che non necessitano di formattazione, sono più facili da recuperare in modo affidabile.
Questo è particolarmente importante per i PDF. Le FAQ di OpenAI sul recupero visivo con i PDF affermano che i PDF caricati come GPT Knowledge vengono elaborati con recupero solo testuale. In altre parole, un grafico, un diagramma o uno screenshot all'interno del PDF non dovrebbe essere l'unico punto in cui è presente una regola critica. Aggiungi una spiegazione testuale o un file di accompagnamento basato su testo.
Elimina anche i duplicati obsoleti. Se un file indica un periodo di reso di 14 giorni e un altro di 30, la ricerca può mostrare entrambi i passaggi. Nomi di file come returns-policy-2026-09.md e la presenza di testo visibile con la "data di entrata in vigore" semplificano la verifica delle versioni.
4. Carica un piccolo insieme di conoscenze coerenti e verificalo
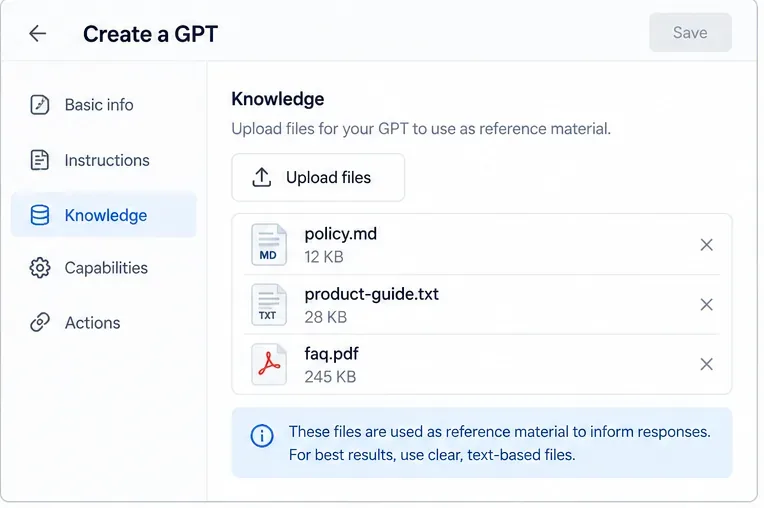
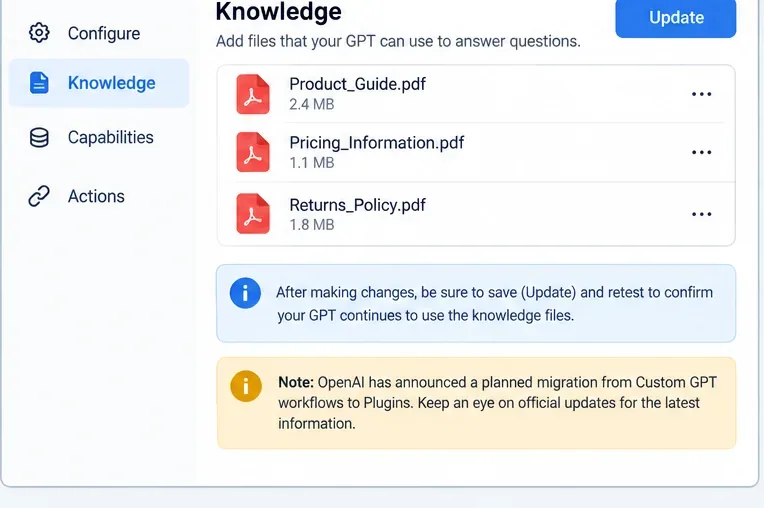
Carica solo i file effettivamente necessari a GPT. Le linee guida di OpenAI per i file aziendali indicano che un numero inferiore di documenti, ma più specifici, generalmente migliora la precisione del recupero basato su file. Dopo il caricamento, verifica che tutti i file previsti siano presenti nell'elenco della Knowledge Base prima di procedere.
Carica il set di riferimento, quindi verifica che tutti i file previsti siano presenti prima di eseguire il test.
Attualmente, la documentazione presenta delle incongruenze riguardo al numero di file consentiti. Le linee guida dell'editor GPT indicano che è possibile allegare fino a 20 file a un GPT, mentre le FAQ sul caricamento dei file indicano un limite massimo di 10 file per GPT per tutta la durata di validità del GPT stesso. Entrambi i documenti riportano un limite massimo di 512 MB per file, e le FAQ sul caricamento dei file indicano un limite di 2 milioni di token per i file di testo e di documento. Poiché le pagine ufficiali non concordano sul numero di file, si sconsiglia di progettare flussi di lavoro critici basandosi sul numero più elevato senza prima consultare l'editor e la documentazione aggiornati per il proprio account.
5. Aggiungere istruzioni orientate al recupero
Non affidatevi a istruzioni vaghe come "Utilizzate i file caricati". Specificate cosa deve succedere quando una domanda riguarda un ambito supportato da conoscenze. Un modello pratico è il seguente: consultate prima le conoscenze caricate; preferitele alle conoscenze generali del modello per i fatti specifici dell'azienda; identificate il file o la sezione di supporto quando possibile; e specificate che le informazioni non sono disponibili quando i file non supportano una risposta.
Le istruzioni orientate al recupero delle informazioni dovrebbero definire la priorità delle fonti, il comportamento di citazione e un meccanismo di fallback senza possibilità di improvvisazione.
La guida alla risoluzione dei problemi di OpenAI raccomanda di utilizzare prompt più specifici che facciano riferimento più direttamente ai documenti allegati quando le conoscenze non vengono utilizzate correttamente. Raccomanda inoltre di mantenere le regole e il comportamento del flusso di lavoro nelle Istruzioni anziché inserirli nei file caricati. Vedere Risoluzione dei problemi dei GPT .
Evitate istruzioni contraddittorie. "Rispondere sempre all'utente" è in conflitto con "Non rispondere mai se il file non lo supporta". Sostituite tale conflitto con un'alternativa esplicita, ad esempio: "Se i file di conoscenza non contengono l'informazione richiesta, specificate che le fonti fornite non stabiliscono la risposta e suggerite il passo successivo approvato".
6. Eseguire test di messa a terra positivi in Anteprima
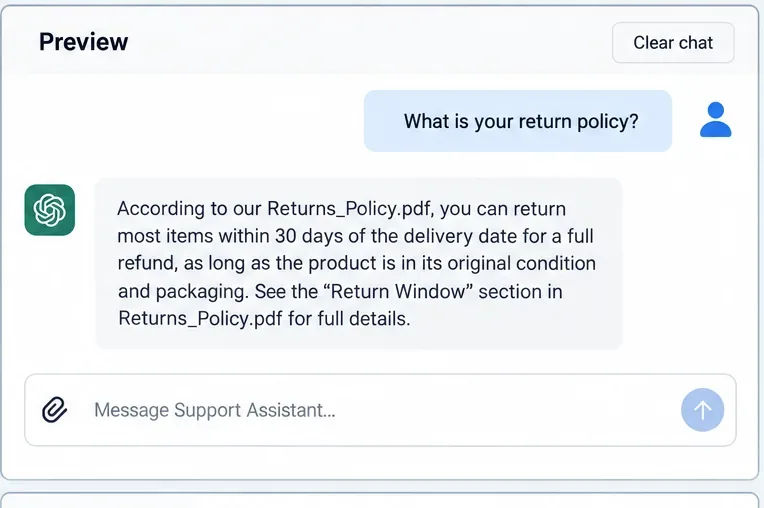
Domande di verifica le cui risposte corrette sono sicuramente presenti nei file. Non limitarti a testare solo la frase più semplice della prima pagina. Includi domande che richiedano di recuperare sezioni diverse, riconoscere formulazioni alternative e distinguere politiche simili.
Un test positivo superato fornisce la risposta corretta e identifica il file o la sezione di supporto.
Per ogni test, registra la risposta prevista, il file sorgente previsto e se il GPT ha citato o identificato tale sorgente quando richiesto. Le linee guida di OpenAI Academy per i GPT personalizzati raccomandano di creare un set di valutazione di circa 10-15 domande rappresentative con risposte corrette. Questo numero è sufficiente per individuare schemi di errore ricorrenti senza trasformare ogni modifica in un progetto di test complesso.
Valutate la qualità della risposta in base alla sua fondatezza, non solo alla sua fluidità. Una risposta impeccabile, ma con una politica errata, è un fallimento. Una risposta più breve, che citi correttamente il documento di riferimento, è solitamente un risultato migliore.
7. Eseguire test negativi e riformulare i test
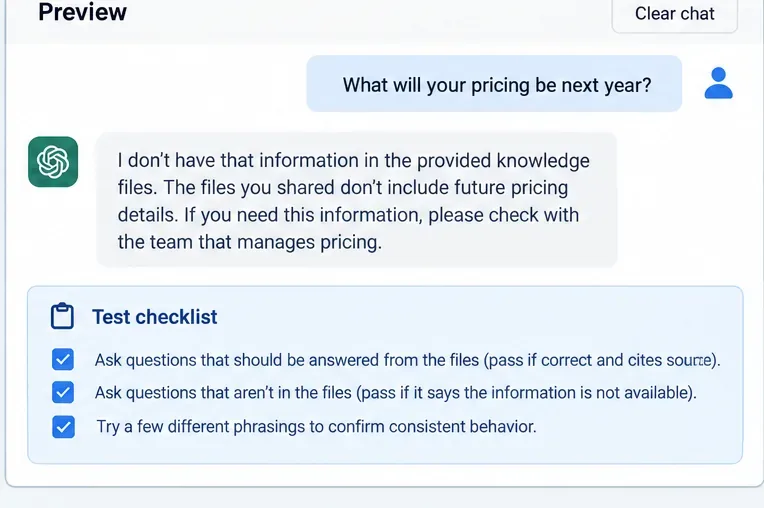
Un assistente di conoscenza affidabile deve sapere cosa non sa. Poni domande che sono intenzionalmente assenti dai file: un prezzo futuro, una funzionalità non ancora rilasciata, una politica per un paese non coperto dal manuale o una data al di fuori dell'ambito del documento. Il risultato desiderato è una chiara limitazione, non un'invenzione plausibile.
I test negativi sono importanti: il GPT dovrebbe ammettere quando una risposta non è presente nei file e rimanere coerente nelle diverse riformulazioni.
Quindi riformula alcune domande, sia positive che negative, in diversi modi. Se "Qual è il periodo di tempo per il rimborso?" funziona ma "Quanto tempo ho per restituirlo?" non funziona, il problema potrebbe essere la copertura del recupero piuttosto che la mancanza di informazioni. Migliora i titoli, la terminologia o le istruzioni prima di aggiungere altri file.
8. Aggiornamenti di versione, nuovi test e consapevolezza di quando la conoscenza statica non è lo strumento giusto
Ogni volta che si modifica una sorgente, rimuovere la versione obsoleta, collegare quella corrente, salvare o aggiornare il GPT e rieseguire lo stesso set di valutazione. Tenere un piccolo registro delle modifiche al di fuori del GPT può aiutare a identificare se una regressione è dovuta a nuove istruzioni, a una sorgente sostituita o a un cambio di piattaforma.
Dopo aver modificato i file sorgente o le istruzioni, salvare l'aggiornamento ed eseguire nuovamente lo stesso set di valutazione.
La conoscenza statica ha dei limiti. Se la fonte cambia costantemente, l'accesso deve riflettere le autorizzazioni per singolo utente o l'assistente necessita di dati operativi in tempo reale, il caricamento ripetuto di file risulta inefficace. Le app di OpenAI con documentazione sincronizzata descrivono fonti connesse indicizzate che rimangono aggiornate nel rispetto delle autorizzazioni della fonte. OpenAI sta inoltre orientando i flussi di lavoro GPT personalizzati verso i plugin, pertanto una base di conoscenza in continua evoluzione rappresenta un valido candidato per un'architettura connessa o migrata, piuttosto che per un crescente accumulo di file statici.
Come diagnosticare un GPT che continua a "dimenticare" un file
Se un dato noto non viene trovato, innanzitutto verificate che sia effettivamente presente in un file allegato e aggiornato. Quindi, formulate una domanda più specifica che indichi il documento o l'argomento. Se la domanda specifica funziona, migliorate gli indizi di ricerca semplificando i titoli, suddividendo un documento troppo ampio o rimuovendo le versioni concorrenti. Se anche con la domanda specifica il problema persiste, convertite il materiale critico in un testo più chiaro e riprovate.
Non cercare di risolvere immediatamente ogni errore aggiungendo altre istruzioni. Regole eccessive o contraddittorie possono rendere il comportamento meno prevedibile. Allo stesso modo, non aggiungere altri file finché non sei sicuro che il set esistente sia corretto. Il segnale di qualità che desideri è la ripetibilità: la stessa piccola suite di valutazione dovrebbe superare i test dopo ogni modifica, soprattutto per questioni ad alto rischio relative a politiche, aspetti legali, prezzi o aspetti operativi.
Il limite pratico: puoi migliorare il recupero, ma non garantirlo
Nessun prompt può far sì che un modello generativo consulti ogni file di conoscenza per ogni risposta con assoluta certezza. Un GPT personalizzato affidabile è quindi un flusso di lavoro progettato, non un caricamento una tantum: file sorgente mirati, istruzioni esplicite sulla priorità delle sorgenti, un comportamento di astensione definito e una valutazione ripetibile. Se questi controlli non raggiungono ancora l'accuratezza o l'aggiornamento necessari, è meglio modificare l'architettura piuttosto che continuare a ottimizzare la stessa configurazione statica.
Per i GPT idonei, tale processo può ridurre sostanzialmente il problema del "file dimenticato". Tuttavia, per i nuovi progetti avviati alla fine del 2026, la decisione a lungo termine dovrebbe tenere conto anche della transizione annunciata da OpenAI dai flussi di lavoro GPT personalizzati ai plugin e della disponibilità di fonti di conoscenza connesse.