Home
» domini
»
Come creare un agente automatizzato per l'elaborazione delle fatture utilizzando l'intelligenza artificiale open-source
Come creare un agente automatizzato per l'elaborazione delle fatture utilizzando l'intelligenza artificiale open-source
Un agente automatizzato per l'elaborazione delle fatture non deve necessariamente nascere come un grande sistema autonomo basato sull'intelligenza artificiale. Per una prima versione utile, si può pensare a un agente come a un flusso di lavoro software controllato che riceve una fattura, richiama i documenti e gli strumenti di intelligenza artificiale appropriati, convalida il risultato, decide se è necessaria una revisione umana e solo successivamente salva o esporta i dati approvati.
Questa distinzione è importante in ambito finanziario. Un modello linguistico può aiutare a trasformare layout di fatture disordinati in campi strutturati, ma non dovrebbe essere l'unico elemento a determinare se una fattura è valida o può essere contabilizzata in sicurezza. La struttura intuitiva di questa guida, pensata per i principianti, mantiene l'estrazione dei dati probabilistica e i controlli contabili fondamentali deterministici.
Al termine del processo, avrai un prototipo locale in grado di accettare fatture in formato PDF o immagine, estrarre campi come fornitore, numero di fattura, date, valuta, totali e voci di dettaglio, convalidare tali campi in base a regole predefinite, inoltrare i documenti sospetti per una revisione, memorizzare una traccia di controllo ed esporre il processo tramite un'API.
Cosa devi sapere prima di iniziare?
Ci sono quattro termini che vale la pena conoscere:
La tecnologia OCR (riconoscimento ottico dei caratteri) trasforma il testo visibile in un'immagine o in una scansione in testo leggibile dalla macchina.
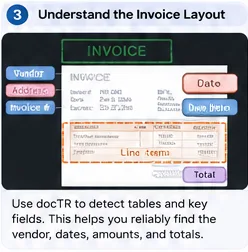
L'analisi sintattica dei documenti preserva una struttura più ricca rispetto al semplice OCR, come l'ordine di lettura, le tabelle, le intestazioni e le aree di impaginazione.
LLM (Large Language Model) è in grado di mappare il testo variabile delle fatture in una struttura JSON coerente.
Il concetto di "intervento umano" prevede che il sistema si fermi e chieda a una persona di esaminare i casi che non superano i controlli, invece di considerare ogni risultato come corretto.
A settembre 2026, diversi progetti open-source attivamente mantenuti coprivano questi livelli. Docling supporta PDF, immagini, documenti Office e altri formati di documento; PaddleOCR fornisce pipeline OCR e di comprensione dei documenti ed è rilasciato sotto licenza Apache 2.0; e il progetto Tesseract documenta la sua attuale versione 5.x come motore OCR open-source nel manuale ufficiale di Tesseract .
Per l'inferenza di modelli locali, la documentazione del server llama.cpp descrive endpoint compatibili con OpenAI e output JSON con vincoli di schema. Ciò lo rende utile per un servizio di estrazione, poiché consente di richiedere a un modello ospitato localmente di restituire un oggetto definito anziché testo non vincolato.
Un avvertimento importante riguardo alle licenze: un motore di inferenza open source non rende automaticamente open source tutti i pesi del modello. Verificate la licenza specifica del checkpoint del modello che intendete utilizzare, soprattutto in caso di uso commerciale.
Quale stack dovrebbe usare un principiante?
Strato
Scelta pratica
Perché si trova qui
Conversione di documenti
Documentazione
Converte PDF e immagini in una rappresentazione strutturata del documento e in un testo esportabile.
fallback OCR
PaddleOCR o Tesseract
Utile quando la fattura è una scansione o una foto e l'estrazione del testo richiede la tecnologia OCR.
Estrazione di IA locale
llama.cpp + un modello di istruzioni appropriato
Mappa il testo variabile della fattura a uno schema JSON stabile, mantenendo l'inferenza locale.
Validazione dello schema
Pidantico
Convalida i dati Python rispetto ai tipi di campo e ai vincoli dichiarati.
API
API veloce
Accetta il caricamento delle fatture e restituisce i risultati dell'elaborazione.
Magazzinaggio
SQLite per un prototipo; PostgreSQL per un servizio condiviso
Memorizza dati normalizzati, stato di revisione, identità del file sorgente ed eventi di controllo.
Orchestrazione
Prima Python puro; LangGraph sarà facoltativo in seguito.
Una funzione deterministica è più facile da sottoporre a debug. Aggiungi un framework di agenti con stato quando la ramificazione e la revisione umana diventano più complesse.
La documentazione ufficiale di Pydantic spiega che i modelli ereditano da BaseModel, convalidano i dati in ingresso e possono emettere JSON Schema tramite model_json_schema(). Vedi la convalida dei modelli Pydantic . Se in seguito hai bisogno di ramificazioni persistenti e con stato, la documentazione di LangGraph descrive il supporto per agenti con stato a lunga esecuzione, persistenza e flussi di lavoro con intervento umano.
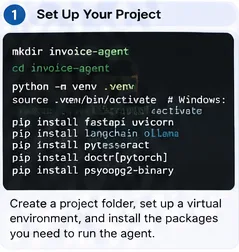
Fase 1: Impostare il progetto e definire un primo obiettivo circoscritto.
Non iniziate con "automatizzare la contabilità fornitori". Iniziate con una sola classe di documenti e un solo contratto di output. Un buon MVP (Minimum Viable Product) è: fatture dei fornitori in lingua inglese, input in formato PDF o immagine, un'unica entità legale, un solo set di valute e nessuna esecuzione automatica dei pagamenti.
Installa il tuo motore OCR separatamente, se necessario. La guida di installazione corrente di Docling utilizza pip install docling; la documentazione di installazione corrente di PaddleOCR distingue il suo pacchetto OCR di base dai gruppi di dipendenze opzionali per l'analisi dei documenti e l'estrazione delle informazioni. Utilizza la guida di installazione di Docling o la guida di installazione di PaddleOCR 3.x anziché copiare un vecchio elenco di dipendenze.
Passaggio 1: Innanzitutto, crea un piccolo progetto Python isolato. Mantieni il primo tipo di fattura e lo schema di output sufficientemente ristretti da consentire test approfonditi.
Passaggio 2: Convertire le fatture in testo e impaginare i dati
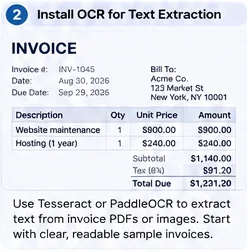
I PDF nativi digitali possono già contenere testo utilizzabile. I PDF scansionati e le foto richiedono l'OCR. Il parser dovrebbe nascondere questa differenza al resto del flusso di lavoro: le fasi successive dovrebbero ricevere il testo del documento normalizzato, oltre a qualsiasi informazione utile relativa al layout o alle tabelle.
Una conversione minima della documentazione si presenta così:
from docling.document_converter import DocumentConverter

converter = DocumentConverter()

def parse_document(path: str) -> str:
    result = converter.convert(path)
    return result.document.export_to_markdown()
La guida rapida ufficiale di Docling utilizza lo stesso schema di conversione ed esportazione. Per le raccolte che richiedono un'elevata elaborazione OCR, è consigliabile testare PaddleOCR o Tesseract sulle proprie scansioni. La documentazione del progetto PaddleOCR raccomanda la sua più recente famiglia PP-StructureV3 per l'analisi dei documenti, mentre Tesseract può essere richiamato da riga di comando o tramite API per l'OCR del testo stampato.
Fase 2: Iniziate con fatture campione leggibili che contengano i campi che intendete estrarre, quindi aggiungete scansioni più complesse solo dopo che il processo di base ha funzionato correttamente.
Passaggio 3: Decidere esattamente quali dati l'agente è autorizzato a produrre
Lo schema di estrazione è il contratto tra l'IA e la logica contabile. Evitate uno schema mastodontico che includa "tutto ciò che potrebbe comparire in una fattura". Iniziate con i campi che potete validare.
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ConfigDict

class LineItem(BaseModel):
    description: str
    quantity: Decimal | None = None
    unit_price: Decimal | None = None
    amount: Decimal

class Invoice(BaseModel):
    model_config = ConfigDict(extra="forbid")

    vendor_name: str
    invoice_number: str
    invoice_date: date
    due_date: date | None = None
    currency: str = Field(min_length=3, max_length=3)
    subtotal: Decimal | None = None
    tax: Decimal | None = None
    total: Decimal
    line_items: list[LineItem] = []
extra="forbid"È utile in questo contesto perché i campi LLM imprevisti non dovrebbero entrare a far parte silenziosamente della registrazione contabile. Si noti inoltre che la convalida di Pydantic conferma la struttura e i tipi; non dimostra che il fornitore o l'importo estratti corrispondano all'immagine della fattura.
Passaggio 3: Definisci i campi di destinazione in base alle esigenze aziendali, quindi utilizza le informazioni di layout e tabella per preservare la provenienza di tali valori.
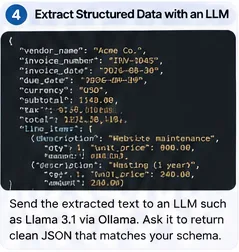
Passaggio 4: Utilizzare un modello locale per mappare il testo del documento in JSON strutturato
Esegui un modello di istruzioni appropriato dietro il server HTTP di llama.cpp. La dimensione esatta del modello dipende dall'hardware e dalla complessità delle fatture. Non dare per scontato che un modello più grande sia automaticamente migliore; esegui dei benchmark su accuratezza dei campi, latenza e memoria con il tuo set di fatture.
Attualmente llama.cpp supporta risposte JSON con schema vincolato. È possibile derivare tale schema da Pydantic e inviarlo con la richiesta di estrazione:
import json
import httpx

def extract_invoice(document_text: str) -> Invoice:
    schema = Invoice.model_json_schema()

    prompt = f"""
Extract one supplier invoice from the text below.
Do not invent values. If an optional field is absent, use null.
Currency must be a three-letter code.
Return only data that fits the required schema.

DOCUMENT:
{document_text}
"""

    payload = {
        "model": "local-model",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0,
        "response_format": {
            "type": "json_schema",
            "schema": schema
        }
    }

    r = httpx.post(
        "http://127.0.0.1:8080/v1/chat/completions",
        json=payload,
        timeout=120
    )
    r.raise_for_status()

    content = r.json()["choices"][0]["message"]["content"]
    return Invoice.model_validate_json(content)
La generazione vincolata allo schema aiuta a ottenere una struttura valida, ma non garantisce la veridicità semantica. Un oggetto JSON perfettamente valido può comunque contenere un totale errato. Ecco perché il passaggio successivo è obbligatorio.
Passaggio 4: Richiedi al modello locale un oggetto strutturato in modo rigoroso, non una prosa a formato libero, in modo che la convalida successiva riceva campi prevedibili.
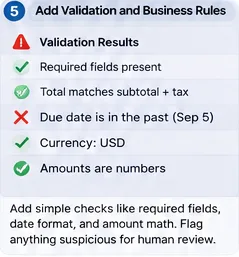
Passaggio 5: Aggiungere controlli contabili deterministici e regole di revisione
Non chiedere al modello LLM "Sei sicuro?" e non fidarti della risposta. La fiducia nel modello autodichiarata non è un controllo calibrato. Crea dei controlli che possano essere ricalcolati a partire dai dati estratti e dai tuoi sistemi.
Tra le prime regole utili figurano:
I campi obbligatori sono presenti;
Il numero di fattura non è già registrato per lo stesso fornitore;
La valuta è consentita per quel venditore o entità;
la somma approssimativa delle singole voci è pari al subtotale;
Il subtotale più le tasse corrispondono approssimativamente al totale;
La data della fattura e la data di scadenza sono plausibili;
Il fornitore è presente nell'anagrafica fornitori oppure è stato indirizzato per l'inserimento;
I riferimenti degli ordini di acquisto corrispondono quando è richiesto l'abbinamento con l'ordine di acquisto.
from decimal import Decimal

def validate_business_rules(inv: Invoice) -> list[str]:
    errors = []

    if inv.subtotal is not None and inv.tax is not None:
        expected = inv.subtotal + inv.tax
        if abs(expected - inv.total) > Decimal("0.02"):
            errors.append("subtotal_plus_tax_does_not_match_total")

    line_sum = sum((x.amount for x in inv.line_items), Decimal("0"))
    if inv.subtotal is not None and abs(line_sum - inv.subtotal) > Decimal("0.02"):
        errors.append("line_items_do_not_match_subtotal")

    if inv.due_date and inv.due_date < inv.invoice_date:
        errors.append("due_date_before_invoice_date")

    return errors
Indirizza ogni verifica non andata a buon fine a una coda di revisione. Per una prima implementazione, è ragionevole instradare tutte le fatture in fase di revisione mentre si misura la qualità dell'estrazione. Le soglie di automazione dovrebbero essere basate su dati raccolti dalle fatture etichettate in modo specifico, non su una percentuale generica copiata da un altro sistema.
Passaggio 5: Trattare le operazioni aritmetiche, il rilevamento dei duplicati, la corrispondenza dei fornitori e le regole relative alle date come controlli deterministici; inoltrare le eccezioni a una persona.
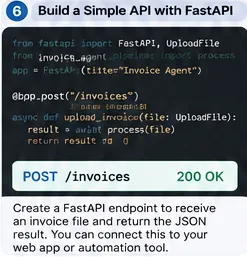
Passaggio 6: racchiudere il processore in una piccola API
Un'API consente a un modulo di caricamento, a un gestore di email, a un sistema di monitoraggio di cartelle condivise o a un'integrazione con un sistema contabile di richiamare la stessa funzione di elaborazione. La guida ufficiale di FastAPI UploadFileper il caricamento dei file consiglia di utilizzare un file di spool, che è più adatto rispetto al caricamento di file di grandi dimensioni interamente in memoria.
from pathlib import Path
from tempfile import NamedTemporaryFile
from fastapi import FastAPI, UploadFile, HTTPException

app = FastAPI()

@app.post("/invoices")
async def process_upload(file: UploadFile):
    if file.content_type not in {
        "application/pdf",
        "image/png",
        "image/jpeg"
    }:
        raise HTTPException(415, "Unsupported file type")

    suffix = Path(file.filename or "").suffix

    with NamedTemporaryFile(suffix=suffix, delete=False) as tmp:
        tmp.write(await file.read())
        path = tmp.name

    result = process_invoice(path)
    return result
Consultare la documentazione aggiornata di FastAPI relativa ai file di richiesta per i modelli di caricamento supportati. In ambiente di produzione, è inoltre necessario imporre limiti di dimensione dei file, eseguire scansioni antimalware ove opportuno, autenticare i chiamanti, utilizzare ID di richiesta e garantire la pulizia sicura dei file temporanei.
Passaggio 6: Esporre un endpoint di elaborazione dopo che la pipeline locale ha funzionato, in modo che più canali di input possano riutilizzare lo stesso percorso di convalida.
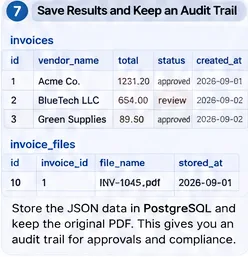
Passaggio 7: Archiviare le prove originali, il risultato normalizzato e gli eventi di audit
Non memorizzare mai solo il JSON finale. Conserva sempre prove sufficienti per ricostruire l'accaduto: identità del file originale, hash, versione del parser, identificativo del modello, versione del prompt, JSON estratto, risultati della convalida, decisione di revisione, timestamp e l'utente o il servizio che ha approvato la modifica.
Un prototipo semplice può utilizzare SQLite. Un servizio multiutente può utilizzare PostgreSQL con vincoli di unicità e di chiave esterna. La documentazione attuale di PostgreSQL tratta i vincoli di tabella , utili per proteggere chiavi e relazioni indipendentemente dalla pipeline di intelligenza artificiale.
CREATE TABLE invoices (
    id BIGSERIAL PRIMARY KEY,
    vendor_id BIGINT NOT NULL,
    invoice_number TEXT NOT NULL,
    invoice_date DATE NOT NULL,
    currency CHAR(3) NOT NULL,
    total NUMERIC(18,2) NOT NULL,
    status TEXT NOT NULL,
    source_sha256 TEXT NOT NULL,
    extracted_json JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    UNIQUE (vendor_id, invoice_number)
);
L'hash di origine offre un secondo metodo per rilevare l'invio accidentale di un nuovo file. È consigliabile impostare autorizzazioni di archiviazione più restrittive rispetto ai log generali delle applicazioni, poiché le fatture spesso contengono indirizzi, coordinate bancarie, codici fiscali e altri dati aziendali sensibili.
Passaggio 7: Conservare sia i dati normalizzati della fattura sia i metadati del file sorgente, in modo che approvazioni, duplicati e correzioni successive rimangano tracciabili.
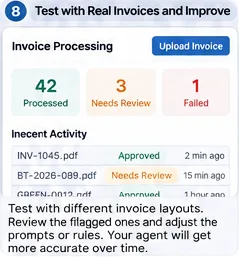
Passaggio 8: Eseguire un test con una variante reale della fattura prima di automatizzare le azioni successive.
Un prototipo che funziona su cinque PDF puliti non è pronto per la produzione. Crea un set di valutazione etichettato che rappresenti gli input che ricevi effettivamente: fornitori diversi, scansioni, pagine ruotate, caratteri piccoli, fatture multipagina, sconti, righe negative, tasse, spese di spedizione, valute multiple, ordini di acquisto mancanti e invii duplicati.
Monitora separatamente le metriche a livello di campo. L'“accuratezza della fattura” può nascondere il fatto che il nome del fornitore è facile da rilevare, mentre la quantità delle singole voci è inaffidabile. Come minimo, misura:
Corrispondenza esatta per numero di fattura, valuta e date;
precisione della tolleranza numerica per subtotale, imposta e totale;
precisione e richiamo delle singole voci se queste sono rilevanti a valle;
percentuale di casi inviati alla revisione umana;
tasso di false approvazioni automatiche;
latenza di elaborazione e tasso di errore;
precisione nel rilevamento dei duplicati.
Archivia gli errori come casi di test. Ogni volta che correggi una regola del parser, un prompt, uno schema o un modello, riesegui l'intero set di valutazione. Questo impedisce che un miglioramento di un fornitore comprometta silenziosamente il layout di un altro.
Passaggio 8: Misurare la coda di revisione e i casi di errore sulle fatture rappresentative prima di consentire all'agente di automatizzare le azioni contabili successive.
Come dovrebbe decidere l'agente cosa fare dopo?
Mantieni esplicita la macchina a stati. L'"agente" può essere inizialmente una semplice funzione Python:
Questo sistema è già simile a un agente perché coordina gli strumenti e sceglie un ramo. Non è necessario un LLM per scegliere ogni singolo passaggio successivo. Aggiungete LangGraph o un altro framework di orchestrazione quando avete bisogno di revisioni multi-fase persistenti, tentativi di ripetizione, callback asincroni o diversi strumenti specializzati il cui ordine di esecuzione cambia a seconda dei casi.
Quali errori dovrebbero evitare i principianti?
Lasciando che l'LLM sia il controllo contabile
Il modello dovrebbe estrarre e normalizzare; il codice e i dati di sistema affidabili dovrebbero essere verificati. Le operazioni aritmetiche, i controlli dei duplicati, lo stato del fornitore, la corrispondenza degli ordini di acquisto e i limiti di approvazione appartengono alla logica deterministica.
Scartare il documento sorgente dopo l'estrazione
Conservate la fattura originale o un riferimento controllato ad essa. I revisori hanno bisogno di prove e voi avete bisogno di un modo per riprodurre gli errori dopo gli aggiornamenti del modello o del parser.
Utilizzando un prompt senza una versione
Per ogni fattura elaborata, memorizza la versione e il modello del prompt. In caso contrario, non potrai spiegare perché due fatture elaborate a distanza di mesi si siano comportate in modo diverso.
Pubblicazione automatica di ogni risultato valido secondo lo schema
La validità del JSON non equivale alla validità della fattura. Iniziate con una revisione umana, quindi automatizzate solo i casi a basso rischio dopo che la vostra valutazione avrà dimostrato prestazioni accettabili.
Ignorando le licenze del modello e dei dati
Le librerie e i pesi dei modelli possono avere licenze diverse. PaddleOCR e Tesseract pubblicano licenze open source, mentre la licenza del modello che si esegue tramite llama.cpp dipende da quello specifico checkpoint. Verificatela prima della distribuzione.
Creazione dell'interfaccia utente prima di verificare la qualità dell'estrazione
Una dashboard ben rifinita non può compensare valori errati. Testa prima l'analisi dei documenti, l'estrazione dello schema e la convalida; aggiungi un'interfaccia di revisione solo dopo aver capito cosa i revisori devono effettivamente vedere.
Quando è opportuno utilizzare solo l'OCR, i modelli di layout o un LLM?
Approccio
Migliore vestibilità
Principale limitazione
Regole OCR +
Un numero limitato di modelli di fornitori altamente stabili
Le regole diventano fragili man mano che i layout variano.
Modello di impaginazione del documento
Tabelle, moduli e campi in cui la posizione è importante
Potrebbe essere necessaria una formazione specifica per l'attività o un'elaborazione successiva.
OCR/analizzatore di documenti + LLM locale
Molti formati di fattura con uno schema di destinazione comune
Deve essere vincolato e convalidato; l'inferenza richiede una maggiore potenza di calcolo.
modello visivo-linguistico
Documenti complessi in cui testo e impaginazione visiva sono strettamente interconnessi
Requisiti hardware più elevati e maggiore complessità di valutazione.
La documentazione attuale di Hugging Face LayoutLMv3 descrive un modello di intelligenza artificiale per documenti che combina testo e informazioni di layout visivo. Anche la documentazione di PaddleOCR PP-StructureV3 si concentra su layout, tabelle e analisi strutturata dei documenti. Queste sono opzioni da considerare quando il semplice testo e un modello di layout non sono sufficienti.
Qual è il percorso più sensato per passare dal prototipo alla produzione?
Procedete per fasi. Innanzitutto, eseguite il test in locale su una cartella contenente fatture etichettate. In secondo luogo, aggiungete l'API e l'archiviazione persistente. In terzo luogo, introducete una coda di revisione manuale. In quarto luogo, integrate le ricerche in sola lettura, come ad esempio i dati anagrafici dei fornitori o gli ordini di acquisto. Infine, consentite l'esportazione controllata in un'area di staging contabile. Solo dopo che il monitoraggio avrà dimostrato l'efficacia dei controlli, potrete valutare la contabilizzazione automatica per casi a basso rischio ben definiti.
In ogni fase, è fondamentale preservare tre elementi: le prove (il documento originale e la fonte estratta), il determinismo (regole aziendali che possono essere rieseguite) e la tracciabilità (quale parser, modello, richiesta e revisore ha prodotto il record finale).
Lista di controllo finale
Il programma di analisi delle fatture funziona sia con i PDF nativi digitali che con le scansioni che ricevi.
L'output dell'estrazione è vincolato a uno schema Pydantic versionato.
Il modello non è autorizzato a inventare valori mancanti.
I totali, le date, i duplicati, l'identità del fornitore e le regole degli ordini di acquisto vengono convalidati al di fuori del sistema LLM.
Le regole non conformi generano una fase di revisione umana anziché una correzione silenziosa.
Vengono registrati il documento originale, l'hash della sorgente, il modello, la versione del prompt e il risultato della convalida.
L'API impone restrizioni sul tipo e sulle dimensioni dei file e richiede autenticazione prima dell'utilizzo in produzione.
Il set di test contiene variazioni di layout reali e casi limite.
Le licenze del modello e della libreria sono state verificate per la distribuzione prevista.
Le registrazioni contabili a valle vengono introdotte gradualmente e rimangono verificabili.
Se questi controlli sono implementati, non si tratta solo di una demo OCR: si hanno le basi per un sistema affidabile di elaborazione delle fatture. I componenti open source possono cambiare nel tempo, ma l'architettura rimane solida: analizzare le prove, estrarle in uno schema, convalidarle con il codice, inoltrare le incertezze al personale e registrare ogni decisione.