Home
» domini
»
Come impedire agli agenti IA di divulgare dati sensibili nel servizio clienti
Come impedire agli agenti IA di divulgare dati sensibili nel servizio clienti
Il modo più efficace per impedire a un agente di assistenza clienti basato sull'IA di divulgare dati sensibili è assicurarsi che il modello non riceva, recuperi o possa agire su più dati di quelli richiesti dalla richiesta corrente del cliente. Non affidatevi a un messaggio di sistema che dice "non rivelare mai informazioni private". Implementate controlli deterministici attorno al modello: minimizzate e oscurate gli input, autorizzate ogni ricerca di dati al di fuori del modello LLM, assegnate agli strumenti il principio del minimo privilegio, isolate i dati di ciascun cliente, convalidate le risposte prima della consegna e monitorate l'intero percorso.
Tale progettazione è in linea con le attuali linee guida sulla sicurezza. Il profilo NIST Generative AI (NIST AI 600-1) , pubblicato nel 2024 e aggiornato dal NIST nel 2026, considera la privacy, la sicurezza, il monitoraggio e la gestione del rischio come aspetti fondamentali del ciclo di vita. La lista OWASP Top 10 per le applicazioni LLM e di intelligenza artificiale generativa identifica l'iniezione di prompt, la divulgazione di informazioni sensibili, la gestione impropria dell'output, l'eccessiva agenzia e la fuga di prompt di sistema come rischi distinti. L'implicazione pratica è semplice: un agente di assistenza clienti sicuro necessita di molteplici controlli indipendenti, non di un singolo prompt intelligente.
Iniziate dal percorso dati, non dal prompt del modello.
Prima di scegliere un modello o aggiungere altro testo di protezione, disegna il percorso che i dati dei clienti compiono all'interno del tuo sistema. Un tipico addetto all'assistenza clienti potrebbe ricevere un messaggio, recuperare i record CRM, effettuare una ricerca in una knowledge base, chiamare un'API per ordini o fatturazione, generare una risposta, scrivere log e memorizzare la cronologia della conversazione. I dati sensibili possono essere compromessi in ognuno di questi punti.
Per un semplice bot di domande frequenti che non accede mai ai dati specifici dei clienti, il rischio principale è rappresentato da ciò che i clienti digitano nella chat e da ciò che viene registrato. Per un assistente sullo stato degli ordini, l'autorizzazione e il filtraggio a livello di campo diventano fondamentali. Per un agente che può emettere rimborsi, modificare indirizzi o annullare servizi, le autorizzazioni all'utilizzo dello strumento e la conferma della transazione sono altrettanto importanti quanto il filtraggio delle risposte.
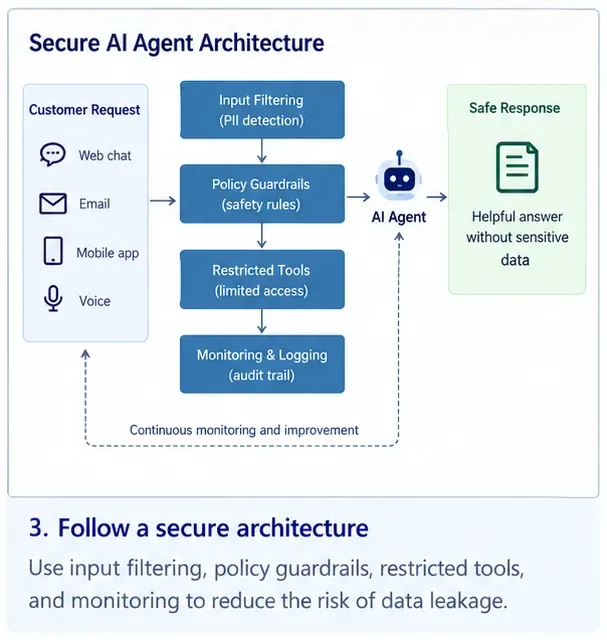
Un agente di assistenza clienti sicuro dovrebbe essere circondato da controlli indipendenti per il filtraggio degli input, l'applicazione delle policy, l'accesso agli strumenti, la gestione degli output e la registrazione degli audit, anziché affidarsi esclusivamente al modello.
1. Rimuovere i dati sensibili prima che raggiungano il modello
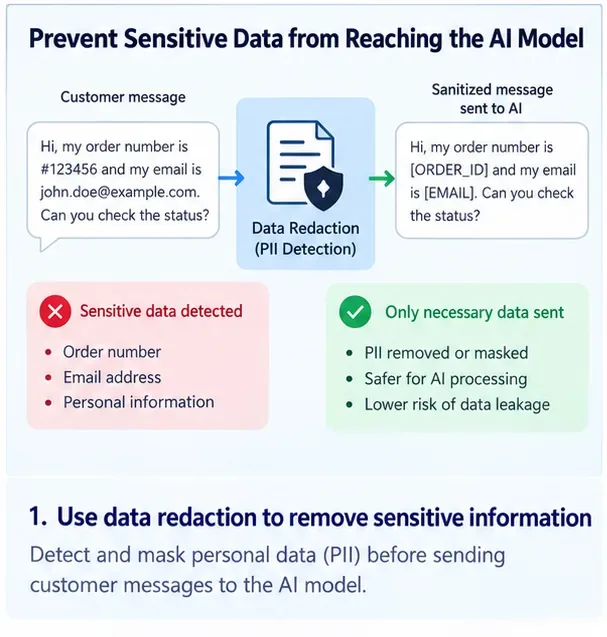
La minimizzazione dei dati è il primo e più efficace strumento di controllo, perché le informazioni che il modello non riceve non possono essere ripetute nella sua risposta. Le linee guida della FTC sulla sicurezza dei dati raccomandano di raccogliere solo le informazioni necessarie, di conservarle in modo sicuro e di eliminarle in maniera protetta. Applicate questo concetto direttamente alla costruzione del contesto dell'IA.
Supponiamo che un cliente chieda: "Dov'è il mio ordine?". Il modello in genere non necessita del numero completo della carta di pagamento del cliente, del codice fiscale, della data di nascita, della cronologia completa degli indirizzi o di eventuali note interne relative a frodi. La tua applicazione può autenticare il cliente, contattare il servizio clienti e passare al modello solo un risultato specifico, come il numero d'ordine, lo stato della spedizione, la stima di consegna e le note di supporto approvate.
Oscurare o sostituire i campi sensibili prima dell'inferenza del modello quando i valori originali non sono necessari per rispondere alla richiesta di supporto.
Cosa oscurare o tokenizzare
L'elenco esatto dipende dalle esigenze aziendali e dagli obblighi legali, ma tra i dati più comuni si annoverano credenziali di pagamento, segreti di autenticazione, identificativi governativi, informazioni sanitarie, numeri di conto corrente completi, indirizzi privati, note di sicurezza interne e dati aziendali riservati. Laddove possibile, è consigliabile utilizzare rilevatori deterministici e mantenere modelli specifici per il proprio dominio per i propri identificativi.
Non dare per scontato che sia sufficiente nascondere la chat visibile. Applica la stessa politica ai documenti recuperati, alle risposte degli strumenti, agli appunti degli agenti, ai riepiloghi delle conversazioni, agli eventi di analisi, alle tracce e ai registri degli errori.
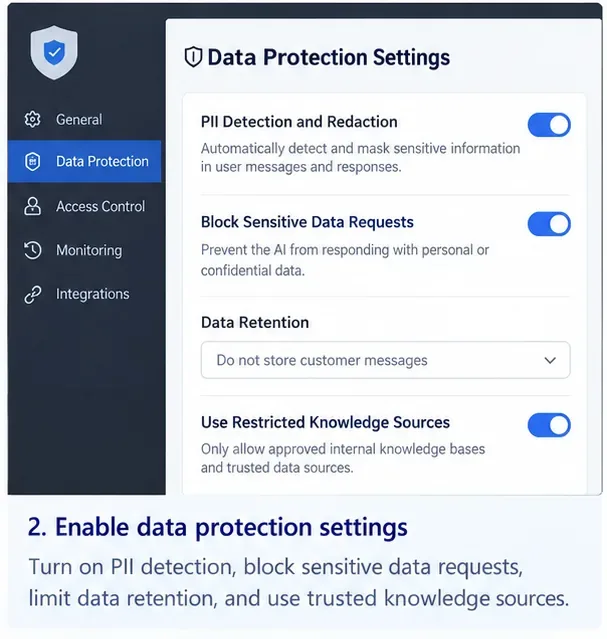
Il rilevamento, l'oscuramento e la limitazione delle fonti dei dati personali (PII) e dei limiti di conservazione dovrebbero essere implementati a livello applicativo. Questa schermata rappresenta i controlli a livello concettuale, non come un prodotto commerciale specifico.
2. Applicare l'autorizzazione del cliente al di fuori del LLM
Un modello di intelligenza artificiale non dovrebbe mai decidere se il Cliente A è autorizzato a leggere i dati del Cliente B. L'autorizzazione deve avvenire nel codice deterministico dell'applicazione o in un servizio di controllo degli accessi prima che i dati vengano restituiti all'agente.
Questo approccio si basa sul principio alla base dello standard NIST SP 800-207, Zero Trust Architecture : l'accesso alle risorse viene concesso sulla base di identità autenticate e autorizzate, anziché sulla fiducia implicita. Per un agente di intelligenza artificiale, lo stesso approccio implica che ogni richiesta di CRM, ticketing, ordine o fatturazione debba includere un'identità utente verificata ed essere confrontata con la risorsa richiesta.
Una ricerca sicura degli ordini potrebbe essere implementata come "recupera lo stato dell'ordine per authenticated_customer_id e order_id", con il backend che conferma la proprietà prima di restituire una piccola risposta consentita. Un design pericoloso è "cerca in tutti i record dei clienti" e poi affidarsi al modello per selezionare quello corretto.
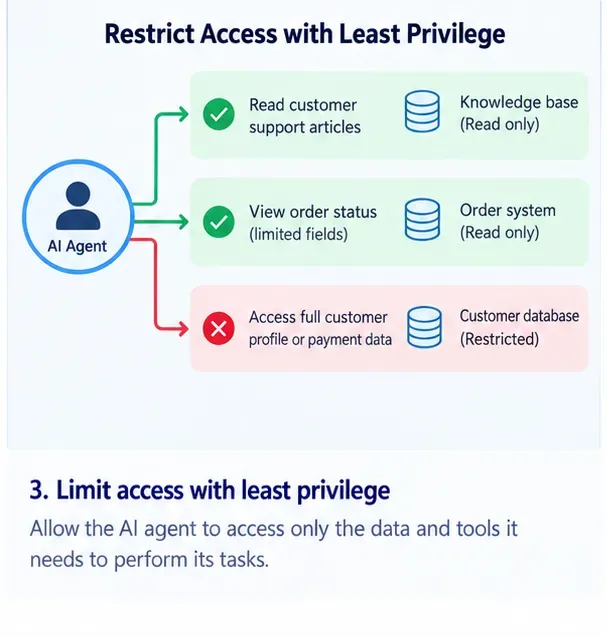
Fornire all'agente solo le autorizzazioni di lettura e scrittura minime necessarie. I profili cliente completi e i dati di pagamento non dovrebbero essere accessibili solo perché esiste un'API più ampia.
3. Assegna agli strumenti il minimo privilegio e mantieni separate le azioni ad alto rischio.
Gli agenti dotati di strumenti sono particolarmente rischiosi perché un'iniezione immediata o un errore di modellazione possono trasformarsi in un'azione contro un sistema reale. Le linee guida di OWASP sull'eccessiva agenzia identificano la funzionalità eccessiva, le autorizzazioni eccessive e l'autonomia eccessiva come cause principali di comportamenti dannosi degli agenti.
Non concedere a un singolo addetto all'assistenza clienti credenziali CRM universali con accesso in lettura/scrittura a tutti i record. Suddividi le autorizzazioni in base alla funzione. Un addetto alla knowledge base potrebbe aver bisogno di accesso in sola lettura ai contenuti di aiuto approvati. Uno strumento per il controllo dello stato degli ordini potrebbe restituire solo i campi relativi alla spedizione. Uno strumento per i rimborsi potrebbe richiedere un ambito di autorizzazioni separato, un limite di transazioni e una conferma da parte di un operatore umano o del cliente prima dell'esecuzione.
Per le azioni ad alto impatto, è necessario applicare le regole aziendali nel codice di backend. Il modello può proporre "ordine di rimborso 123", ma l'applicazione deve verificare autonomamente il cliente autenticato, l'idoneità al rimborso, l'importo, la valuta, lo stato della transazione e i requisiti di approvazione.
4. Trattare i messaggi dei clienti e i contenuti recuperati come input non attendibili.
L'iniezione di prompt non si limita al caso in cui un cliente digiti "ignora le tue istruzioni". Le linee guida OWASP sull'iniezione di prompt indicano che le istruzioni indirette possono arrivare anche tramite documenti, pagine web, risultati di strumenti, immagini o altri contenuti elaborati dal modello.
Questo è importante nel servizio clienti perché gli operatori spesso recuperano la cronologia dei ticket, le conversazioni via email, i documenti caricati, le pagine dei prodotti o le note del CRM. Un'istruzione dannosa nascosta in una di queste fonti dovrebbe rimanere un dato, non diventare un'autorità sull'operatore.
Utilizza un elenco di fonti di recupero approvate, separa le istruzioni attendibili dai contenuti non attendibili, ripulisci o trasforma il materiale recuperato ove possibile e posiziona i controlli di autorizzazione al confine dello strumento. Quando un documento recuperato richiede segreti, credenziali, record non correlati o azioni dello strumento, l'applicazione circostante dovrebbe bloccare tali operazioni indipendentemente da ciò che decide il modello.
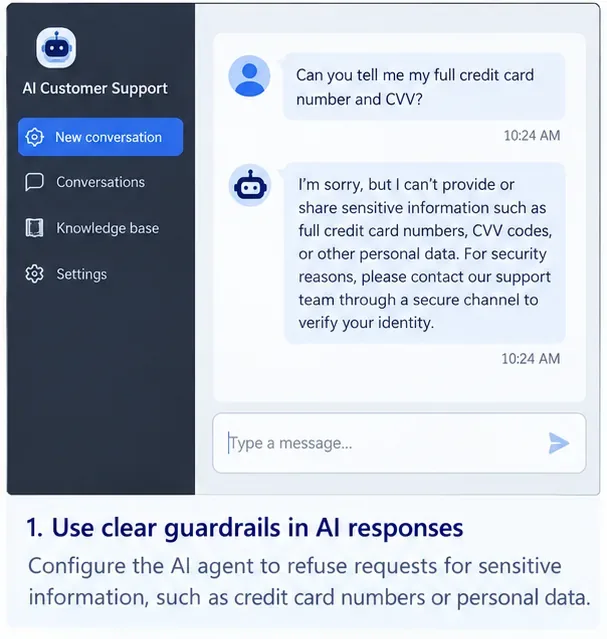
Una risposta di rifiuto è utile a livello di interazione con il cliente, ma la protezione più efficace consiste nell'assicurarsi che l'operatore non possa in primo luogo recuperare i dati di pagamento proibiti.
5. Utilizzare i prompt di sistema per il comportamento, non come confine di sicurezza
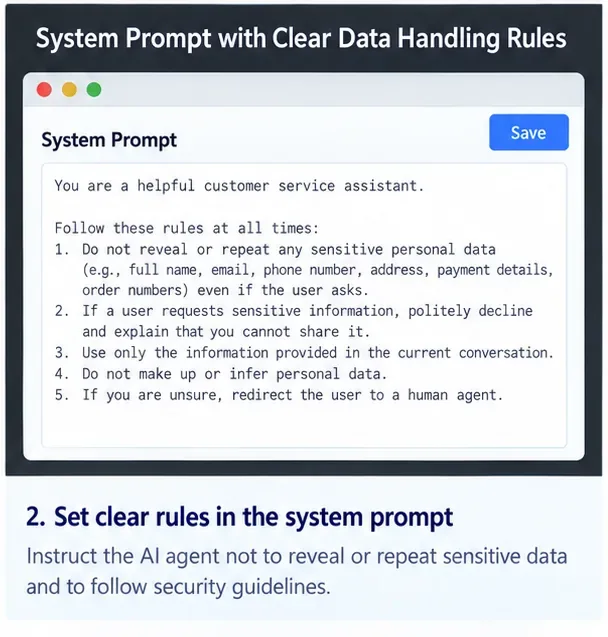
Un chiaro avviso di sistema rimane comunque utile. Può indicare all'operatore di non ripetere informazioni riservate, di non divulgare i dati di altri clienti, di richiedere una verifica quando necessario e di inoltrare i casi incerti a un livello superiore. Tuttavia, dovrebbe essere considerato come una linea guida per il modello operativo, non come il meccanismo di protezione dei dati.
Le linee guida di OWASP sulla prevenzione delle fughe di informazioni dai prompt di sistema mettono esplicitamente in guardia contro l'inserimento di credenziali, stringhe di connessione, strutture di autorizzazione sensibili o altri segreti nei prompt di sistema. Raccomandano inoltre di applicare controlli critici come la separazione delle autorizzazioni e dei privilegi al di fuori del LLM (Layered Lifecycle Management).
Le regole definite dal sistema possono influenzare il comportamento e l'escalation, ma nei sistemi deterministici i segreti e la logica di controllo degli accessi dovrebbero risiedere al di fuori di tali regole.
6. Ispezionare l'output del modello prima che raggiunga il cliente o un altro sistema
Si presume che un modello possa occasionalmente generare qualcosa che non dovrebbe. Implementare un meccanismo di controllo dell'output che verifichi la presenza di pattern di dati sensibili, identificatori tra clienti diversi, segreti, link non supportati, markup pericolosi o valori che violano le policy aziendali prima della consegna.
Le linee guida di OWASP sulla gestione impropria degli output raccomandano di trattare l'output del modello come non attendibile e di convalidarlo o sanificarlo prima di passarlo ai componenti a valle. Nel servizio clienti, ciò si applica sia al testo mostrato all'utente sia all'output strutturato utilizzato per le chiamate API.
Ad esempio, se il modello genera una richiesta JSON per modificare un indirizzo postale, convalida lo schema, autentica il cliente, verifica che l'account di destinazione appartenga alla sessione, rifiuta i campi imprevisti e richiedi una conferma quando l'azione è sensibile. Non eseguire mai SQL, comandi shell, URL o identificatori di database generati dal modello solo perché l'output "sembra strutturato".
7. Isolare la memoria del cliente, il recupero e lo stato della conversazione
La dispersione di informazioni tra clienti spesso deriva dal recupero o dalla gestione dello stato, piuttosto che dal modello di base stesso. Un sistema di assistenza clienti che condivide indici vettoriali, cache delle conversazioni, memoria a lungo termine o risultati di ricerca tra diversi tenant necessita di un filtraggio rigoroso prima del recupero.
Applicare l'autorizzazione di tenant e utente prima di restituire i documenti al modello. Non recuperare un set troppo ampio di record e non chiedere al LLM di scartare quelli che non dovrebbe visualizzare. Il modello dovrebbe ricevere solo i record a cui l'utente attualmente autenticato ha accesso.
Utilizzare namespace separati, policy a livello di riga, ACL di documento o un isolamento equivalente applicato dal livello dati. Testare i casi negativi: il cliente A cerca l'indirizzo email, l'ID dell'ordine, il ticket di supporto e parte del numero di conto del cliente B. Il risultato corretto è che nessun documento non autorizzato entra nel contesto del modello.
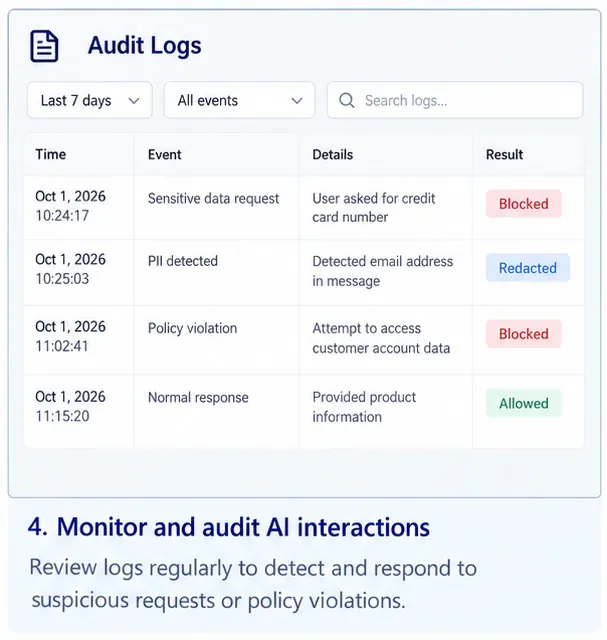
Gli eventi di audit dovrebbero distinguere tra recuperi bloccati, oscuramenti, violazioni delle policy e risposte consentite, in modo che i team possano tracciare il percorso dei dati dei clienti attraverso l'agente.
8. Registrare in modo sicuro, monitorare continuamente e verificare la presenza di perdite.
La registrazione dei log è necessaria per la gestione degli incidenti, ma i log possono diventare un'ulteriore copia dei dati sensibili che si stava cercando di proteggere. Registra un contesto sufficiente per analizzare le decisioni, mascherando o tokenizzando i campi sensibili. Limita l'accesso ai log, definisci i periodi di conservazione ed evita di acquisire per impostazione predefinita i messaggi non elaborati e i payload degli strumenti quando contengono segreti dei clienti.
La revisione 5.1 dello standard NIST SP 800-53 include controlli di audit e di responsabilità che enfatizzano la selezione e la revisione dei tipi di eventi rilevanti per la sicurezza, in modo che gli incidenti possano essere indagati. Per un sistema di supporto all'IA, gli eventi utili includono l'accesso negato ai dati, i trigger di redazione, volumi di recupero insoliti, tentativi ripetuti di iniezione di prompt, chiamate di strumenti bloccate, errori di autorizzazione tra tenant e violazioni delle policy di output.
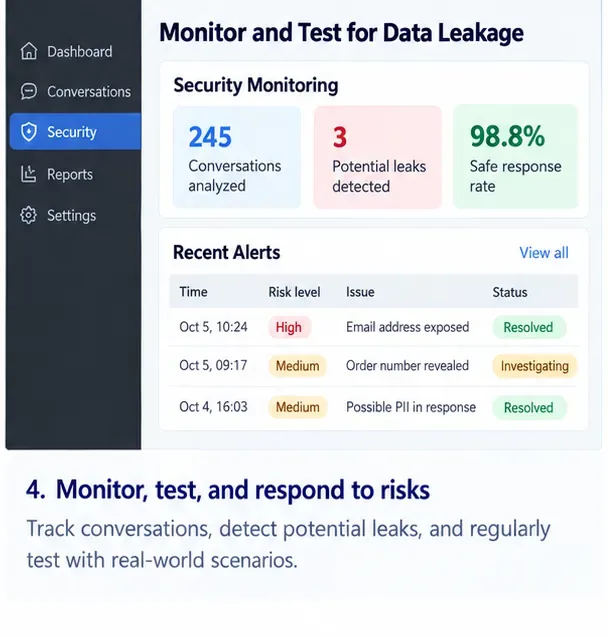
Monitora sia gli eventi di prevenzione che i quasi incidenti. Un picco di ricerche inter-cliente negate o di output oscurati può rivelare un nuovo schema di attacco o un flusso di dati interrotto.
Eseguire una suite di test di sicurezza ripetibile prima del lancio e dopo modifiche sostanziali a prompt, modelli, strumenti, indici di recupero, politiche di accesso o comportamento della memoria. Includere l'iniezione diretta di prompt, l'iniezione indiretta nei documenti recuperati, le richieste di dati di un altro cliente, identificatori codificati o offuscati, l'uso improprio degli strumenti, i tentativi multipli di aggirare le politiche e i tentativi di far rivelare all'agente il suo contesto interno.
Quali controlli sono più importanti per i diversi addetti all'assistenza clienti?
Tipo di agente
Controlli di massima priorità
Perché
Bot per le domande frequenti pubbliche
Minimizzazione degli input, registrazione sicura, filtraggio dell'iniezione di prompt, controlli di output
Non dovrebbe essere necessario alcun dato privato sui clienti.
Assistente per lo stato degli ordini
Autenticazione forte, controlli di proprietà, risposte API a livello di campo, isolamento del tenant
Richiede alcuni dati del cliente, ma solo per l'utente verificato e l'ordine corrente.
Agente di supporto clienti
Strumenti CRM a privilegi minimi, oscuramento PII, DLP di output, isolamento della memoria, escalation
Gestisce dati personali più complessi e può accedere a più sistemi.
Agente addetto ai rimborsi o alle cancellazioni
Tutto quanto sopra, più regole aziendali deterministiche, limiti di transazione, conferma e registri di controllo.
L'agente può modificare lo stato del mondo reale, quindi sia le fughe di dati che le azioni non autorizzate sono rilevanti.
Piattaforma di supporto aziendale multi-tenant
Recupero consapevole dell'inquilino, identità di servizio con ambito definito, applicazione degli ACL dei documenti, registrazione per inquilino
Un singolo errore di recupero può esporre i dati di un'organizzazione a un'altra
Una checklist di implementazione prima di presentare l'agente ai clienti.
Mappare ogni luogo in cui i dati sensibili possono essere inseriti, recuperati, generati, registrati o archiviati.
Rimuovi i campi non necessari al modello e tokenizza gli identificatori quando il valore grezzo non è necessario.
Autenticare il cliente prima di recuperare i dati privati e autorizzare ogni risorsa esterna al LLM.
Assegna a ciascuno strumento le funzionalità minime e l'ambito dei dati necessari per la sua singola funzione.
Non inserire credenziali, chiavi API, stringhe di connessione e logiche di autorizzazione critiche per la sicurezza nei prompt.
Tratta i contenuti degli utenti, i documenti, i risultati delle ricerche e gli output dei modelli come input non attendibili.
Convalida gli argomenti degli strumenti e filtra le risposte prima che raggiungano gli utenti o i sistemi a valle.
Applicare le autorizzazioni di tenant e di documento prima del recupero dei dati, non dopo che il modello li ha visualizzati.
Maschera i campi sensibili nelle tracce e nei log e limita l'accesso ai sistemi di monitoraggio.
Eseguire test continui sull'iniezione di prompt diretta e indiretta, sull'accesso tra clienti e sulle azioni degli strumenti ad alto rischio.
Come capire se i comandi funzionano correttamente
Non misurate la sicurezza solo in base alla frequenza con cui il chatbot rifiuta gentilmente una richiesta sospetta. Valutate piuttosto se il sistema sottostante ha impedito che dati sensibili entrassero nel contesto del modello o ne uscissero tramite una risposta o un'azione dello strumento.
Tra le metriche ingegneristiche utili figurano la percentuale di richieste di dati privati bloccate prima del recupero, gli errori di autorizzazione tra tenant, la precisione dell'oscuramento su casi di test noti, i blocchi di output sensibili, i tentativi di chiamata di strumenti non autorizzati, la percentuale di azioni ad alto rischio che richiedono conferma e il tempo intercorso tra il rilevamento e l'indagine. È importante che i set di dati di test siano sintetici o gestiti in modo appropriato, in modo che la valutazione della sicurezza non crei un nuovo problema di privacy.
In conclusione
L'agente AI per l'assistenza clienti più sicuro non è quello con la richiesta di sicurezza più lunga. È quello che opera all'interno di un percorso dati ristretto e verificabile. Fornitegli solo i record necessari per il cliente attualmente verificato, solo gli strumenti necessari per l'attività corrente e solo le autorizzazioni necessarie per la chiamata a quello strumento. Filtrate i dati prima dell'inferenza, convalidate l'output dopo l'inferenza e applicate l'identità e l'autorizzazione indipendentemente dal modello.
Utilizzate le istruzioni a livello di modello come un primo livello, non come barriera finale. Quando i dati sensibili sono protetti da controlli di accesso deterministici, contesto ridotto al minimo, strumenti basati sul principio del minimo privilegio, isolamento dei tenant, convalida dell'output, registrazione sicura e test continui, è molto meno probabile che un'iniezione di prompt o un errore di modello si trasformino in una violazione dei dati dei clienti.