Home
» domini
»
Come misurare la qualità delle risposte ai LLM utilizzando i framework di valutazione
Come misurare la qualità delle risposte ai LLM utilizzando i framework di valutazione
Il modo più affidabile per misurare la qualità delle risposte LLM è trattare la valutazione come un sistema di test ripetibile, non come un singolo punteggio. Definisci cosa significa "buono" per la tua applicazione, crea un set di dati di valutazione rappresentativo, combina controlli deterministici con valutazioni basate su modelli e giudizi umani, confronta ogni possibile modifica con una baseline e analizza i guasti per categoria prima del rilascio.
Questo è importante perché un LLM può produrre una risposta che sembra ben fatta pur essendo errata, non supportata da prove, incompleta, non sicura o incoerente con le istruzioni. Un framework di valutazione efficace trasforma queste vaghe preoccupazioni in criteri espliciti che possono essere rieseguiti dopo una modifica del prompt, un aggiornamento del modello, una modifica del recupero, un aggiornamento dello strumento o una revisione delle politiche di sicurezza.
Nota sulla documentazione: le funzionalità del framework descritte di seguito sono state verificate rispetto alla documentazione ufficiale disponibile il 13 settembre 2026. Questi strumenti si evolvono rapidamente, pertanto si consiglia di verificare le API correnti prima di copiare codice specifico del framework in produzione.
Cosa bisogna misurare per prima cosa?
Iniziate con l'errore che avrebbe più importanza per i vostri utenti. Per un bot di supporto basato sui fatti, la correttezza e la conformità alle policy potrebbero essere predominanti. Per la generazione aumentata dal recupero (RAG), la fondatezza e la qualità del recupero sono importanti perché una risposta fluida può comunque inventare fatti non supportati dal contesto recuperato. Per un agente, la qualità della risposta finale non è sufficiente; potrebbe essere necessario valutare anche la selezione dello strumento, le argomentazioni dello strumento, il completamento dell'attività e i passaggi non necessari.
dimensione qualitativa
Cosa chiede
Tipo di buon valutatore
Correttezza
La risposta è corretta dal punto di vista fattuale o logico?
Confronto dei riferimenti, verifica del codice, valutazione LLM o revisione umana
Istruzioni seguenti
Il modello ha rispettato i vincoli richiesti?
Regole del codice più giudizio basato su rubriche
Radicamento
Le affermazioni sono supportate dal contesto fornito?
Verifiche a livello di giudice o di reclamo specifiche per RAG
Rilevanza
La risposta risponde effettivamente alla domanda senza divagare?
Giudice LLM o revisione umana
conformità di formato
L'output è un JSON valido, conforme allo schema o comunque utilizzabile automaticamente?
Codice deterministico
Sicurezza e politica
La risposta viola le regole della tua applicazione?
Verifiche delle policy, valutazione LLM e revisione umana mirata
Efficienza
Quali sono stati i tempi di latenza, il numero di token utilizzati e il costo della risposta?
Telemetria e tracciamento
Non fate una media di questi valori troppo presto. Un modello candidato che guadagna due punti in stile ma introduce anche solo un piccolo numero di gravi fallimenti delle politiche potrebbe rivelarsi una versione peggiore. Mantenete le dimensioni critiche visibili come porte separate.
Un flusso di lavoro di valutazione in quattro fasi che funziona in diversi contesti
1. Creare un set di dati di valutazione rappresentativo
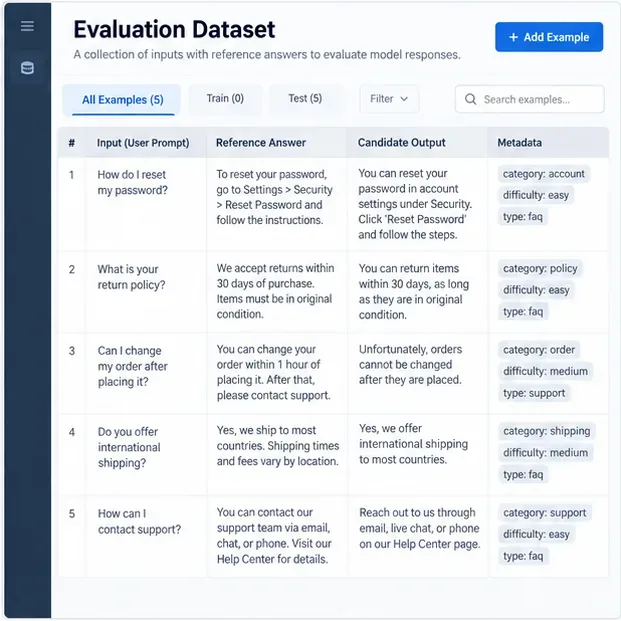
Il tuo set di dati dovrebbe contenere input realistici e, ove possibile, comportamenti attesi. Alcune righe possono avere risposte di riferimento esatte; altre potrebbero richiedere una griglia di valutazione anziché una singola frase "chiave". Aggiungi metadati come tipo di attività, segmento di clientela, lingua, difficoltà, condizioni di recupero o categoria di sicurezza in modo da poter successivamente filtrare i risultati.
Ad esempio, immaginiamo un assistente del servizio clienti. Un set di valutazione utile non conterrebbe solo semplici domande frequenti. Dovrebbe includere anche richieste ambigue, eccezioni alle policy, casi con contesto mancante, richieste contraddittorie, follow-up a più turni ed esempi in cui il comportamento corretto è affermare che la risposta non può essere determinata.
Le attuali linee guida di valutazione di LangSmith raccomandano di iniziare con esempi selezionati manualmente che mostrino un comportamento corretto, per poi ampliare il set di dati con tracce storiche e guasti rilevati in produzione. Il suo sistema di valutazione supporta set di dati con input, output di riferimento opzionali e metadati. Consultare la documentazione sui concetti di valutazione di LangSmith .
Un set di dati di valutazione dovrebbe abbinare richieste realistiche a riferimenti o comportamenti attesi e conservare i metadati per successive analisi degli errori.
Quando questo approccio è appropriato: quasi sempre. Anche se si utilizza la valutazione in ambiente di produzione, è comunque necessario un set di dati offline stabile per i test di regressione. Se non si dispone di una risposta di riferimento per le attività a risposta aperta, è possibile memorizzare una griglia di valutazione, informazioni obbligatorie, comportamenti proibiti o preferenze a coppie.
2. Associare ciascuna dimensione della qualità al valutatore appropriato
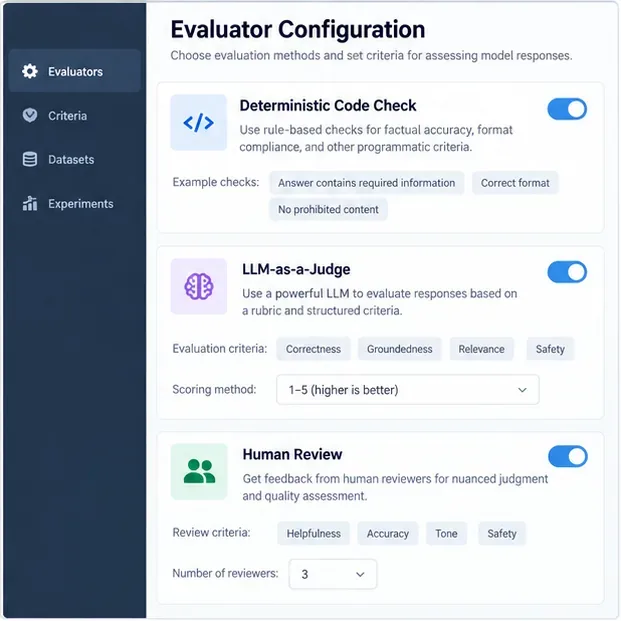
Le suite di valutazione più efficaci combinano diverse tipologie di valutatori, perché nessun singolo valutatore è ideale per ogni quesito.
I controlli deterministici sono più indicati quando il requisito è inequivocabile: JSON valido, etichette esatte, chiavi obbligatorie, tolleranza numerica, regole regex o verifica dell'utilizzo di argomenti approvati durante la chiamata a uno strumento.
Le metriche basate su riferimenti possono essere utili quando esiste una risposta nota, ma la sola similarità tra stringhe è spesso troppo fragile per parafrasi valide e troppo indulgente nei confronti di testi semanticamente errati che condividono il vocabolario.
Il modello LLM, in veste di giudice, è utile per valutare criteri quali completezza, pertinenza, tono, fedeltà o per verificare se una risposta aperta soddisfa i criteri di valutazione.
La valutazione a coppie è utile quando è più facile decidere se il candidato A o la soluzione di riferimento B sia migliore, piuttosto che assegnare un punteggio assoluto significativo.
La revisione umana rimane importante per calibrare i sistemi di valutazione automatica, risolvere casi soggettivi o di particolare rilevanza e verificare se il parametro di valutazione stesso rifletta il valore percepito dall'utente.
L'attuale API Evals di OpenAI definisce una valutazione come criteri di test più uno schema di origine dati e supporta valutatori riutilizzabili. La sua API per i valutatori include controlli deterministici di stringhe, valutatori di similarità testuale e valutatori basati su modelli; consultare la documentazione di riferimento dell'API Evals di OpenAI e la documentazione di riferimento dei valutatori di OpenAI . Il servizio di valutazione Vertex AI Gen AI di Google Cloud supporta metriche basate su modelli puntuali e a coppie, nonché metriche basate sul calcolo; i suoi risultati possono includere punteggi per istanza, spiegazioni, medie aggregate, deviazioni standard e tassi di vittoria a coppie. Consultare la documentazione sui risultati della valutazione di Vertex AI .
Utilizzare regole deterministiche ove possibile, aggiungere giudici LLM basati su rubriche per la qualità semantica e mantenere disponibile la revisione umana per la calibrazione e i casi più complessi.
Quando questo approccio è appropriato: utilizzare controlli deterministici per i requisiti verificabili automaticamente, giudici LLM per le qualità semantiche e personale umano laddove il disaccordo abbia conseguenze significative per l'azienda o la sicurezza. Per un sistema RAG, Ragas espone metriche come precisione del contesto, richiamo del contesto, pertinenza della risposta e fedeltà, oltre a metriche sull'utilizzo di agenti/strumenti, tra cui accuratezza della chiamata dello strumento e accuratezza dell'obiettivo dell'agente. Consultare la documentazione sulle metriche di Ragas . Anche DeepEval fornisce metriche specifiche per le attività e valutazioni personalizzate dei giudici LLM, incluso un sistema di punteggio in stile G-Eval; consultare la documentazione sulle metriche di DeepEval .
3. Eseguire lo stesso set di dati rispetto a una baseline e a un candidato
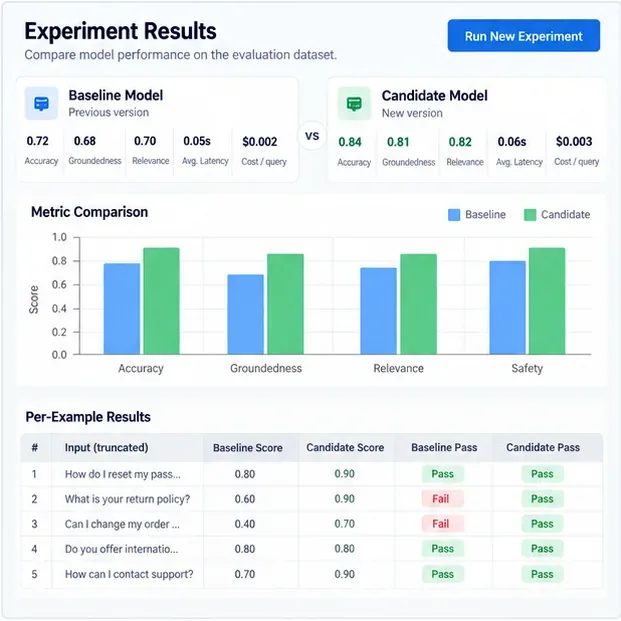
I punteggi assoluti sono utili, ma le decisioni di rilascio sono generalmente più chiare quando la nuova configurazione viene testata rispetto alla versione di cui ci si fida già. Mantenete il più possibile stabili il dataset, le definizioni dei valutatori, i parametri del modello e le impostazioni di campionamento. Quindi confrontate gli stessi esempi uno accanto all'altro.
Monitorare almeno tre livelli di risultati:
Punteggi per esempio: quali specifici suggerimenti hanno mostrato miglioramenti o peggioramenti?
Risultati per sezione: le prestazioni sono cambiate in base a domande a contesto lungo, a una determinata lingua, a casi difficili, a una categoria di prodotto o a input avversari?
Risultati aggregati: Che fine hanno fatto il tasso di superamento, il punteggio medio, la latenza, l'utilizzo dei token, il costo e il numero di fallimenti gravi?
Per i sistemi non deterministici, è opportuno ripetere i test più importanti un numero sufficiente di volte per comprenderne la variabilità, anziché presumere che un singolo completamento rappresenti il modello. Se la decisione di rilascio è rilevante, è consigliabile utilizzare confronti a coppie sugli stessi esempi e riportare l'incertezza, anziché basarsi solo su una minima variazione della media.
LangSmith supporta esperimenti offline per confrontare versioni e valutatori a coppie, mentre l'attuale stack di valutazione GenAI di MLflow supporta set di dati di valutazione, scorer integrati e personalizzati, giudici LLM, feedback umano, tracciamento e monitoraggio della produzione. Vedi Valutazione di LangSmith e Valutazione di LLM e Agenti di MLflow .
Confronta un candidato con il riferimento attuale sugli stessi esempi, quindi esamina sia le metriche aggregate sia i risultati di superamento o fallimento per ciascun esempio.
Questo approccio è appropriato quando: ogni volta che si modifica un modello, un prompt di sistema, una pipeline di recupero, un'implementazione di strumenti o le impostazioni di decodifica. Un candidato non dovrebbe essere promosso solo perché una metrica aggregata aumenta; dovrebbe soddisfare le soglie di rilascio sulle dimensioni critiche ed evitare regressioni inaccettabili a livello di slice.
4. Esaminare i guasti, calibrare il giudice e trasformare le regressioni in nuovi test
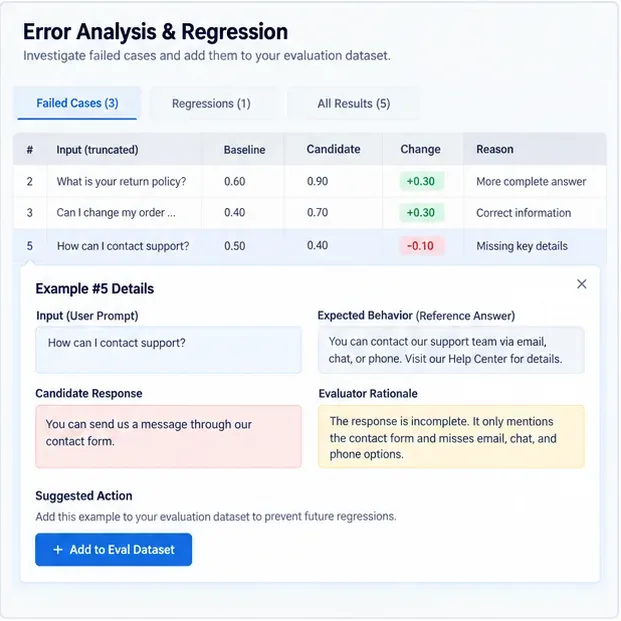
Una valutazione è utile solo se modifica le tue azioni successive. Classifica gli errori in base alla gravità e alla causa principale. Un punteggio di fondatezza basso potrebbe derivare da un recupero delle informazioni inadeguato, da una domanda che incoraggia a tirare a indovinare, da una griglia di valutazione troppo vaga o da una risposta di riferimento errata. Leggi gli esempi sottostanti prima di modificare il modello.
Successivamente, si trasformano i guasti più importanti in casi di regressione permanenti. Questo crea un circolo virtuoso: la produzione rileva un guasto, un operatore umano lo conferma, il caso viene aggiunto al set di dati offline, la soluzione viene testata sull'intera suite e si impedisce alle versioni future di reintrodurre lo stesso problema.
Anche i giudici LLM necessitano di valutazione. La documentazione di Google descrive esplicitamente il confronto tra i risultati metrici basati sul modello e le valutazioni umane per stabilire se il giudice sia sufficientemente valido per un caso d'uso specifico. Analogamente, il lavoro GDPval di OpenAI utilizza la valutazione a coppie da parte di esperti come standard principale e descrive la valutazione automatizzata come un'approssimazione piuttosto che un sostituto del giudizio degli esperti. Si vedano le linee guida di Vertex AI sulla valutazione di un modello di giudizio e la metodologia GDPval di OpenAI .
Esamina gli esempi di errore effettivi, verifica che il valutatore stia giudicando correttamente e aggiungi le regressioni importanti al set di test permanente.
Quando questo approccio è appropriato: sempre per errori di grande impatto e ogni volta che un giudice LLM influenza una fase di rilascio. Se i revisori umani non sono d'accordo con il giudice ripetutamente, correggere la rubrica, fornire riferimenti più chiari, cambiare il modello di valutazione o riportare il criterio alla revisione umana.
Quanto è affidabile LLM in qualità di giudice?
I valutatori LLM sono potenti perché possono valutare output aperti su una scala che la sola valutazione umana non può eguagliare. La ricerca originale G-Eval ha riportato una correlazione sostanzialmente migliore con il giudizio umano rispetto alle metriche automatiche tradizionali nel contesto di riassunto studiato. Tuttavia, lo stesso articolo avvertiva che i valutatori LLM possono favorire il testo generato da LLM. Si veda l' articolo originale G-Eval .
Ricerche separate condotte su MT-Bench e Chatbot Arena hanno dimostrato che i giudici LLM più efficaci possono allinearsi bene alle preferenze umane, documentando al contempo pregiudizi legati alla posizione, alla verbosità, all'autocelebrazione e al ragionamento. Si veda lo studio originale sull'LLM come giudice .
La conclusione pratica non è "non usare mai i giudici LLM". È: calibrarli. Costruisci un campione con etichette umane, misura la concordanza, esamina le categorie di disaccordo, randomizza o inverti l'ordine delle risposte nei test a coppie quando sono plausibili effetti di posizione ed evita di lasciare che la stessa vaga richiesta del giudice determini silenziosamente ogni decisione di rilascio.
Quale sistema di valutazione dovresti scegliere?
Struttura
Migliore vestibilità
Forza notevole
Valutatori e classificatori OpenAI
Team che già utilizzano le API OpenAI e desiderano eseguire valutazioni native delle API
Definizioni di valutazione riutilizzabili con valutatori deterministici e basati su modelli
LangSmith
Applicazioni LLM che necessitano di tracciamento, set di dati, test di regressione offline e valutazione online.
Forte confronto tra esperimenti e ciclo di feedback sulla produzione
Raga
Pipeline RAG e valutazione dell'utilizzo di agenti/strumenti
Metriche di recupero, fedeltà, pertinenza e strumenti progettate appositamente.
Valutazione approfondita
Team incentrati su Python che desiderano valutazioni in stile test e giudici LLM personalizzabili.
Ampio catalogo di metriche, valutazione end-to-end dei componenti e metriche della traiettoria dell'agente.
Valutazione MLflow GenAI
Team che già utilizzano MLflow o desiderano che le valutazioni siano collegate al tracciamento e alla gestione del ciclo di vita
Set di dati, sistemi di valutazione, feedback umano, tracciamento degli esperimenti e monitoraggio della produzione.
Valutazione di Vertex AI Gen AI
Implementazioni su Google Cloud
Flussi di lavoro di valutazione puntuali, a coppie, basati su modelli e basati su calcoli.
La scelta del framework è meno importante della progettazione della valutazione. È possibile creare una suite di valutazione debole con una piattaforma sofisticata o una solida con pochi script. Privilegiate lo strumento che rende i vostri test riproducibili, versionati, facili da ispezionare e facili da eseguire prima di ogni modifica significativa.
Una pratica scheda di valutazione del rilascio
Per un assistente di produzione, una decisione di rilascio utile può essere espressa come un insieme di criteri anziché come un singolo punteggio complessivo. Ad esempio, richiedere zero guasti critici di sicurezza nel set di sicurezza selezionato, nessuna regressione statisticamente significativa nella correttezza delle attività, un tasso minimo di superamento dei test RAG, un output strutturato valido per ogni caso di schema e latenza o costo entro il budget operativo. Le soglie esatte devono derivare dalla tolleranza al rischio e dai requisiti dell'utente; non esiste una percentuale universale che renda un LLM "sufficientemente buono".
È inoltre fondamentale conservare gli esempi originali alla base del punteggio. Se una release passa da 0,84 a 0,86, è comunque necessario sapere quali due casi sono cambiati e se tali cambiamenti sono rilevanti. In pratica, i team imparano di più da un numero limitato di errori chiaramente categorizzati che da una media impressionante su una dashboard senza alcuna tracciabilità.
Errori comuni nella valutazione
Testare solo i casi ideali: aggiungere ambiguità, casi limite, tentativi di iniezione di prompt, contesto mancante e fallimenti storici noti.
Utilizzare la corrispondenza esatta per le risposte aperte: riservare la corrispondenza esatta ai casi in cui la precisione è effettivamente richiesta.
Affidarsi a un giudice LLM senza calibrazione: confrontare i risultati con le valutazioni umane ed esaminare le discrepanze.
Ottimizzare la media nascondendo i guasti più gravi: mantenere la sicurezza, le politiche e le altre dimensioni critiche come criteri di selezione espliciti.
Modifica del set di dati durante un confronto tra modelli: bloccare il set di confronto o crearne una versione in modo che i risultati rimangano interpretabili.
Ignorare le derive di produzione: le valutazioni offline proteggono le release; la valutazione online e la revisione umana a campione rivelano nuovi comportamenti degli utenti e nuove modalità di errore.
In conclusione
Misurare la qualità delle risposte LLM è una disciplina ingegneristica, non una semplice verifica di impressione. Iniziate con un dataset rappresentativo, definite dimensioni di qualità specifiche per il compito, scegliete controlli deterministici laddove il requisito può essere calcolato, utilizzate valutatori LLM laddove sia necessario un giudizio semantico, calibrate tali valutatori con valutazioni umane e confrontate le modifiche candidate con una baseline stabile. Quindi trasformate ogni importante errore nel mondo reale in un futuro test di regressione.
Seguendo questo ciclo, il framework di valutazione diventa più di una semplice dashboard di reporting: si trasforma in un sistema di controllo qualità che indica se una richiesta, un modello, una modifica al recupero dei dati o un aggiornamento dell'agente hanno effettivamente migliorato il prodotto.