Home
» domini
»
Come risolvere l'errore "API Timeout Error" durante l'esecuzione di flussi di lavoro multi-agente
Come risolvere l'errore "API Timeout Error" durante l'esecuzione di flussi di lavoro multi-agente
Un "Errore di timeout API" in un flusso di lavoro multi-agente raramente si risolve modificando un singolo valore. Un pianificatore può chiamare tre agenti, ciascun agente può chiamare un LLM, un servizio di ricerca, un database o l'API di uno strumento, e ogni livello può avere il proprio timeout, la propria politica di ritentativo, il proprio pool di connessioni e il proprio limite di concorrenza. La soluzione pratica consiste nell'identificare quale livello va in timeout per primo, quindi scegliere tra tempi di attesa più lunghi, un minor numero di chiamate simultanee, ritentativi più intelligenti, un percorso critico più breve o una progettazione del job asincrona.
Il compromesso è fondamentale: aumentare il timeout è semplice ma impegna le risorse più a lungo; i tentativi aggressivi possono moltiplicare il carico e i costi; ridurre la concorrenza migliora la stabilità ma diminuisce il throughput di picco; gli agenti paralleli riducono la latenza di sistema solo quando i servizi a valle possono assorbire il fan-out. Non esiste un'unica impostazione ottimale per ogni sistema multi-agente.
Quale timeout stai effettivamente attivando?
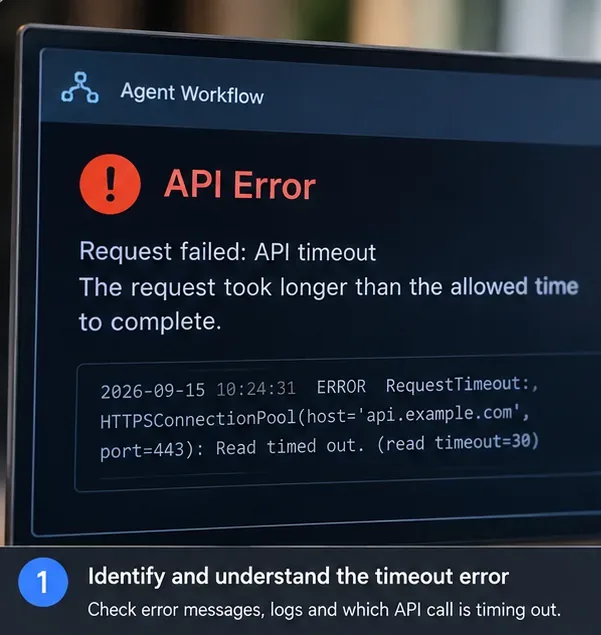
Iniziate classificando l'errore anziché trattare ogni timeout come lo stesso evento. I client HTTP possono andare in timeout durante la connessione, la lettura, la scrittura o l'attesa di una connessione da un pool. HTTPX, ad esempio, documenta quattro tipi di timeout distinti: connessione, lettura, scrittura e pool. Il suo comportamento predefinito è quello di generare un timeout dopo cinque secondi di inattività di rete, non necessariamente cinque secondi di durata totale della richiesta. Consultate la documentazione ufficiale sui timeout di HTTPX .
Se si utilizza l'SDK Python di OpenAI, il suo README ufficiale indica che le richieste hanno un timeout client predefinito di 10 minuti e che, in caso di timeout, vengono ritentate due volte per impostazione predefinita. L'SDK ritenta automaticamente anche gli errori di connessione e le risposte HTTP 408, 409, 429 e 5xx con un breve backoff esponenziale. Queste sono le impostazioni predefinite dell'SDK, non una garanzia che ogni proxy, bilanciatore di carico, gateway o orchestratore a monte della richiesta attenderà 10 minuti. Consultare il README ufficiale dell'SDK Python di OpenAI .
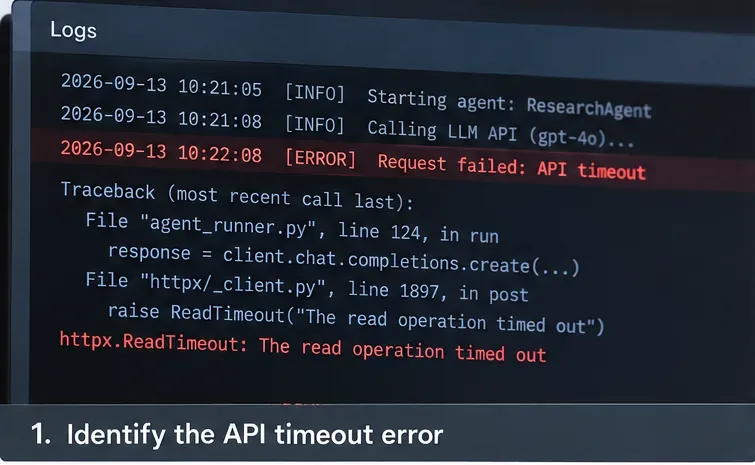
Passaggio 1: acquisire l'eccezione esatta e l'agente, l'endpoint e il livello di trasporto che hanno causato il timeout, invece di registrare solo un errore generico del flusso di lavoro.
Quale soluzione dovresti scegliere?
Opzione
Migliore vestibilità
Vantaggio principale
Compromesso principale
Aumenta il timeout della richiesta
Chiamate a modelli/strumenti sane ma legittimamente lente
Modifiche minime al codice e all'architettura.
I lavoratori e le connessioni rimangono occupati più a lungo; un gateway a monte potrebbe comunque terminare prima la richiesta
Riprova con backoff esponenziale
Errori di rete temporanei, limiti di velocità, errori 5xx selezionati
Si ripristina automaticamente in caso di guasti di breve durata.
Può moltiplicare il traffico, la latenza e i costi; non sicuro per azioni non idempotenti se non progettato con attenzione
Minore concorrenza tra agenti
429s, timeout del pool, saturazione a valle
Riduce i picchi di traffico e la contesa in coda.
Velocità di elaborazione di picco inferiore e, a volte, tempi di completamento del flusso di lavoro più lunghi.
Parallelizzare agenti indipendenti
Flussi di lavoro sequenziali con ramificazioni indipendenti
Riduce il percorso critico
Aumenta le richieste simultanee e può attivare i limiti di velocità o di connessione.
Output parziale del flusso
Esperienza utente interattiva in cui la latenza del primo byte è fondamentale
Gli utenti vedono i progressi più velocemente
Non risolve automaticamente un timeout di integrazione rigido o un servizio a valle sovraccarico
Sposta il lavoro in un'attività/coda asincrona
Flussi di lavoro che possono richiedere decine di secondi o minuti
Scollega la durata della richiesta HTTP dalla durata del flusso di lavoro.
Richiede stato del lavoro, polling/webhook, idempotenza, persistenza e monitoraggio operativo
Passaggio 1: Trova il primo livello che supera la sua scadenza
Registra un ID di correlazione per l'intero flusso di lavoro e un ID di intervallo o figlio per ogni chiamata ad agente e strumento. Registra l'ora di inizio, l'ora di fine, l'endpoint, il numero di tentativo, il tipo di eccezione, lo stato della risposta (se disponibile) e se la cancellazione è avvenuta dal chiamante o dal servizio a valle.
La domanda cruciale è: "chi ha smesso di aspettare per primo?". Se la chiamata LLM termina in 42 secondi ma un gateway API si arrende dopo 30 secondi, aumentare il timeout del client LLM da 60 a 120 secondi non cambia nulla. La documentazione attuale di Amazon per le API HTTP di API Gateway indica un timeout di integrazione massimo di 30 secondi, il che è un buon esempio del perché la scadenza più breve nella catena spesso determina il risultato. Vedi Quote delle API HTTP di Amazon API Gateway .
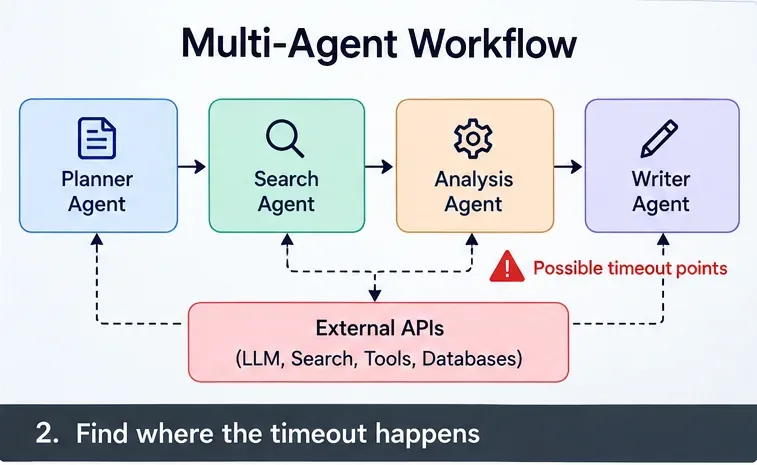
Passaggio 2: mappare il percorso della richiesta e contrassegnare ogni punto in cui è possibile terminare o ritardare una chiamata: orchestratore, agente, gateway, API del modello, API di ricerca, database e servizio dello strumento.
Fase 2: Misurare il percorso critico, non solo la latenza media
La latenza media può sembrare nella norma, mentre una piccola coda di chiamate lente è la causa della maggior parte degli errori del flusso di lavoro. Monitora almeno il tasso di successo per dipendenza, oltre alla latenza p50, p95 e p99. In una fase di fan-out, registra anche il tempo di coda e il tempo di attesa del pool di connessioni, perché un'API "lenta" potrebbe in realtà essere un client sovraccarico in attesa di una connessione libera.
Utilizza le tracce per rispondere a tre domande pratiche: quale dipendenza domina il percorso critico, se più agenti lenti vengono eseguiti in sequenza quando potrebbero essere eseguiti contemporaneamente e se i picchi di concorrenza corrispondono agli errori 429, pool-timeout o 5xx.
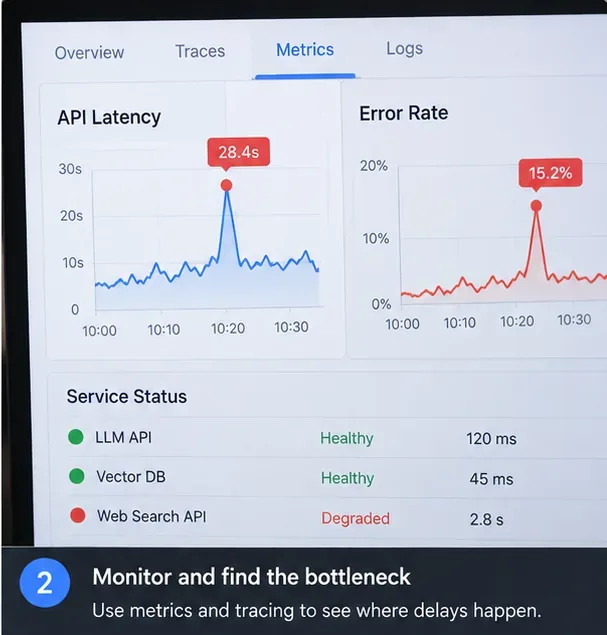
Passaggio 3: confrontare insieme latenza, errori e stato delle dipendenze; un picco di timeout che coincide con una dipendenza degradata suggerisce una soluzione diversa rispetto a un picco di concorrenza a livello di sistema.
Passaggio 3: Costruisci un budget di timeout dall'esterno verso l'interno
Innanzitutto, imposta una scadenza per l'intero flusso di lavoro, quindi accorcia le scadenze interne in modo che i livelli inferiori falliscano con sufficiente anticipo da consentire all'orchestratore di recuperare. Ad esempio, una scadenza di 120 secondi per l'utente finale potrebbe riservare 10 secondi all'orchestrazione e alla gestione delle risposte, lasciando 110 secondi per il lavoro effettivo. Una singola chiamata a uno strumento potrebbe ricevere 15 secondi, mentre una chiamata a un modello potrebbe riceverne 45 o 60, a seconda della latenza di coda osservata.
Non copiate ciecamente questi valori; si tratta di un esempio di metodo di budgeting, non di valori predefiniti universali. Scegliete i valori in base alla distribuzione della latenza misurata e all'SLO del prodotto. La scadenza esterna dovrebbe essere sufficientemente lunga da includere la chiamata interna, i tentativi consentiti, i ritardi di backoff e il tempo di pulizia.
Python 3.11 e versioni successive consentono asyncio.timeout()di impostare una scadenza per le attività asincrone. Quando la scadenza scade, l'attività viene annullata e il gestore di contesto visualizza un timeout TimeoutError. Consultare la documentazione ufficiale di Python relativa al timeout di asyncio .
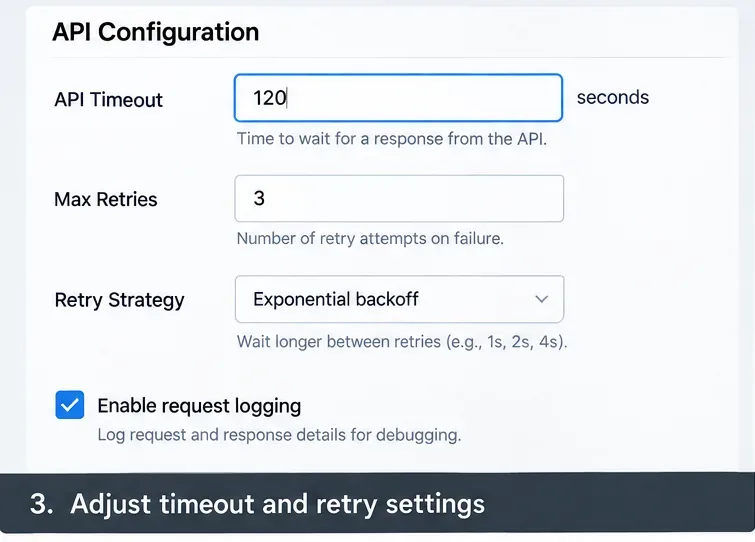
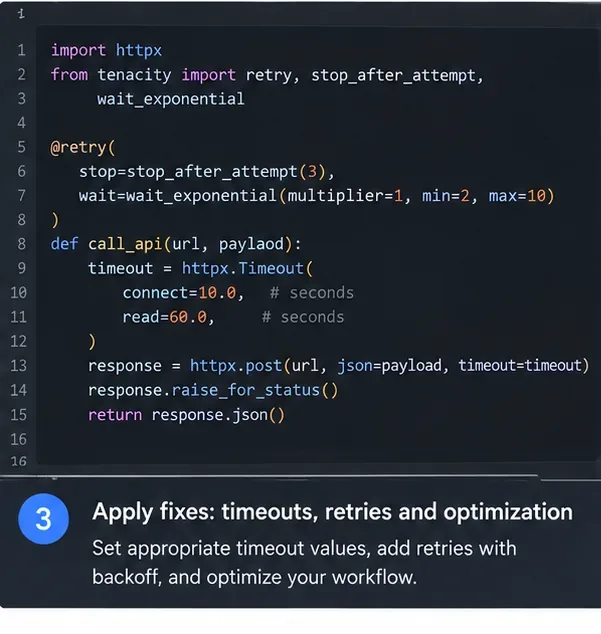
Passaggio 4: configurare i valori di timeout e di tentativi come un budget coordinato, anziché aumentare ciascun valore in modo indipendente.
Passaggio 4: Limita la concorrenza prima di aumentare i tentativi
I sistemi multi-agente spesso falliscono perché la distribuzione delle richieste cresce più velocemente del previsto. Se 20 richieste utente avviano ciascuna cinque agenti e ogni agente avvia due strumenti, il sistema può generare fino a 200 chiamate a valle prima dei tentativi di ripetizione. L'aggiunta preventiva dei tentativi di ripetizione può trasformare la congestione in una vera e propria tempesta di tentativi.
Un limitatore di concorrenza è spesso la soluzione migliore quando si verificano risposte 429, timeout del pool, tempi di attesa in coda crescenti o una dipendenza a valle satura. Python asyncio.Semaphoreoffre un metodo semplice basato su un contatore per limitare il numero di coroutine che accedono contemporaneamente a una sezione protetta. Consultare la documentazione ufficiale dei semafori di Python .
import asyncio

sem = asyncio.Semaphore(8)

async def guarded_agent_call(agent, task):
    async with sem:
        return await agent.run(task)
Il compromesso è intenzionale: un limite inferiore protegge i servizi a valle, ma può aumentare le code all'interno dell'applicazione. È preferibile calibrarlo in base alla velocità di trasmissione, alla latenza p95, ai limiti di velocità e alla capacità del pool di connessioni, piuttosto che scegliere il numero più alto che la macchina può gestire.
Passaggio 5: associare la concorrenza limitata a impostazioni di trasporto esplicite in modo che un pool di connessioni pieno non venga percepito come un modello o uno strumento lento.
Passaggio 5: riprova solo i tentativi falliti che hanno maggiori probabilità di successo in seguito
I tentativi di ripetizione sono utili in caso di errori di connessione temporanei, limiti di frequenza, errori specifici del server e timeout delle richieste, quando ripetere l'operazione è sicuro. Sono invece una soluzione predefinita inadeguata in caso di errori di validazione, errori di autenticazione, bug deterministici degli strumenti o azioni con effetti collaterali prive di protezione dell'idempotenza.
Fai attenzione alla moltiplicazione dei tentativi. Se un SDK effettua due tentativi, significa fino a tre tentativi per una singola chiamata logica. Se anche il livello agente ritenta l'intera chiamata due volte, il massimo teorico diventa nove tentativi per quella singola operazione logica: tre tentativi esterni moltiplicati per tre tentativi dell'SDK. Se l'orchestratore ritenta quindi un'intera fase con cinque agenti, il volume delle richieste può aumentare rapidamente.
Centralizzare la gestione dei tentativi ove possibile. Per le chiamate LLM che utilizzano l'SDK Python di OpenAI, ricordare che l'SDK corrente esegue già due tentativi per impostazione predefinita per determinate classi di errori. Aggiungere un tentativo esterno solo quando si ha un motivo specifico e si può limitare il budget totale dei tentativi.
Passaggio 6: classificare l'errore prima di riprovare; un timeout di lettura può giustificare un numero limitato di tentativi, mentre un errore di configurazione permanente di solito non lo giustifica.
Passaggio 6: Accorciare il percorso critico senza creare un problema di fan-out
Se gli agenti di pianificazione, ricerca, valutazione e scrittura vengono eseguiti rigorosamente uno dopo l'altro, la latenza totale è approssimativamente la somma delle loro durate. I rami indipendenti possono talvolta essere eseguiti contemporaneamente, riducendo il tempo di esecuzione effettivo verso il ramo più lento anziché verso la somma di tutti i rami.
Il metodo TaskGroup di Python asyncio.TaskGroupè un modo strutturato per eseguire attività correlate in parallelo. La documentazione ufficiale di Python indica che TaskGroup attende il completamento delle attività nel gruppo e annulla le attività rimanenti quando una di esse fallisce con un'eccezione non annullabile, offrendo un comportamento di sicurezza più robusto rispetto alla generazione non strutturata di attività. Consultare la documentazione ufficiale di TaskGroup in Python .
La parallelizzazione non è gratuita. Se lo stesso provider impone un limite restrittivo di richieste al minuto o di richieste simultanee, l'esecuzione simultanea di quattro agenti potrebbe trasformare un flusso di lavoro lento ma efficiente in un'ondata improvvisa di risposte 429. Parallelizzate solo le attività realmente indipendenti e mantenete attivo il limitatore globale di concorrenza.
Passaggio 7: Quando è opportuno interrompere l'utilizzo di una richiesta HTTP sincrona?
Se i flussi di lavoro normali superano regolarmente il timeout di richiesta più breve nel percorso di rete, il passaggio a un modello di job asincrono è solitamente più pulito rispetto al prolungamento continuo di ogni timeout. La richiesta HTTP iniziale può convalidare l'input, creare un job persistente e restituire immediatamente un ID del job. I worker eseguono quindi il grafo multi-agente al di fuori del ciclo di vita della richiesta, mentre il client riceve aggiornamenti sullo stato di avanzamento tramite polling, eventi inviati dal server, WebSocket o un webhook.
Lo streaming è utile quando il server può iniziare a inviare output significativi fin da subito. L'SDK Python di OpenAI, ad esempio, supporta lo streaming degli eventi server-sent per le chiamate API di risposta. Lo streaming migliora la reattività percepita e può mantenere una connessione attiva che produce dati, ma non risolve automaticamente il problema della durata massima delle richieste di ogni proxy. Consultare la documentazione ufficiale di OpenAI sugli eventi di streaming .
Scegliete un job asincrono quando la durabilità è più importante della semplicità immediata: attività di ricerca di lunga durata, flussi di lavoro degli agenti con approvazione umana, numerose chiamate a strumenti, operazioni costose che non si desidera ripetere o carichi di lavoro che devono sopravvivere alle disconnessioni del client. Il costo è rappresentato dalla gestione aggiuntiva dello stato: stato del job, checkpoint, chiavi di idempotenza, annullamento, archiviazione dei risultati e gestione dei tentativi.
Passaggio 7: per i flussi di lavoro lunghi, tenere traccia del completamento dell'agente come stato permanente del flusso di lavoro anziché dipendere da una singola connessione client che deve rimanere aperta fino al completamento di ogni agente.
Passaggio 8: Convalidare la correzione sotto un carico realistico
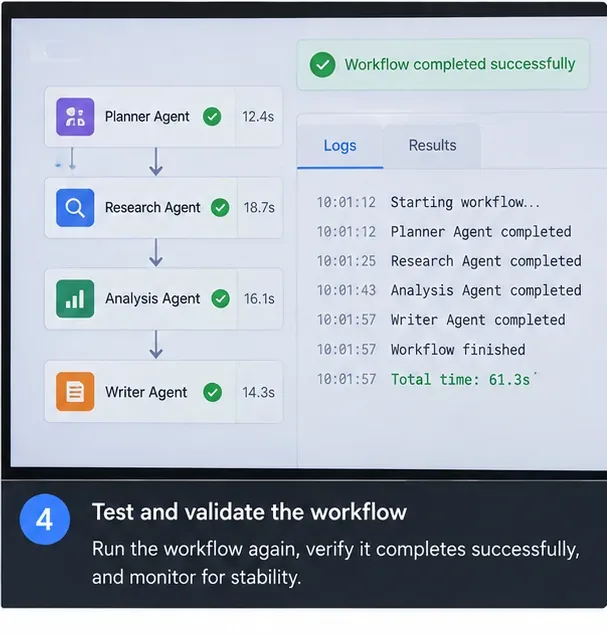
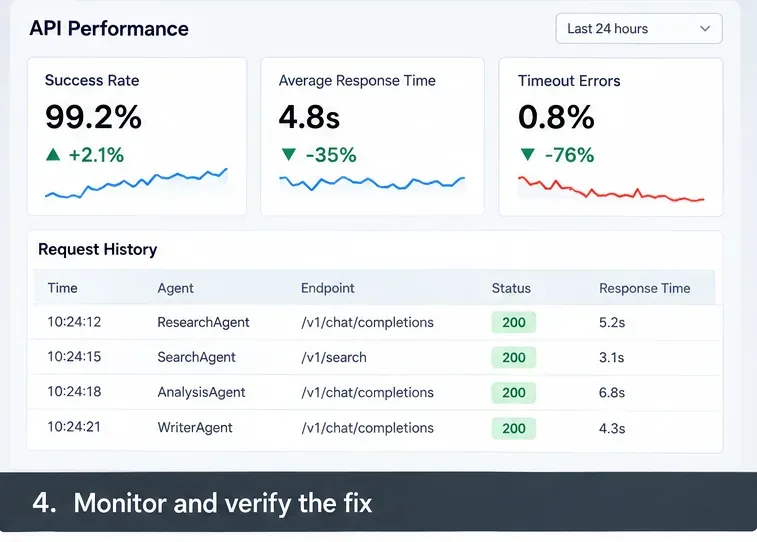
Una soluzione non è considerata valida solo perché una richiesta ha successo. Eseguite dei test con la concorrenza che prevedete in produzione e misurate il tasso di successo, il tasso di timeout, i tentativi di ripetizione per attività logica, la latenza p95 e p99, il ritardo della coda, l'attesa del pool di connessioni, le velocità 429/5xx in downstream e il costo per flusso di lavoro completato.
Se si eseguono agenti in Kubernetes, è importante utilizzare i probe di readiness e liveness per scopi diversi. Kubernetes descrive i probe di readiness come il meccanismo che determina se un Pod deve ricevere traffico, mentre i probe di liveness determinano quando un container deve essere riavviato. La documentazione avverte esplicitamente che controlli di liveness implementati in modo errato possono causare errori a cascata sotto carico. Consultare la documentazione ufficiale di Kubernetes sui probe .
In caso di sovraccarico temporaneo, essere "non pronti" è spesso più sicuro che mandare ripetutamente in tilt lavoratori sani ma occupati. Riservate i guasti di attività ai casi in cui il riavvio del processo sia effettivamente la corretta azione di recupero.
Passaggio 8: verificare la modifica con metriche di traffico e latenza simili a quelle di produzione, e non solo con una singola esecuzione di test riuscita.
Come si fa a capire quale soluzione è più adatta al proprio schema di guasto?
Modello osservato
Il primo cambio più utile
Cosa non fare per prima cosa
Le chiamate terminano subito dopo la scadenza del cliente; il flusso a valle è in buona salute
Aumenta il timeout interno specifico e riprogramma la scadenza esterna
Aumenta i tentativi
429 e timeout del pool aumentano con la concorrenza
Riduci la concorrenza e aggiungi accodamento/contropressione
Avvia più agenti in parallelo
Errori occasionali 408/5xx o problemi di rete.
Utilizzare tentativi di backoff esponenziale limitato per operazioni idempotenti
Riprovare ogni eccezione all'infinito.
Il flusso di lavoro richiede regolarmente più tempo dei limiti del gateway
Utilizzare un'architettura di job asincroni o un design di streaming supportato
Continua a incrementare solo il timeout dell'SDK
Una dipendenza lenta domina la latenza p99
Ottimizza, memorizza nella cache, sostituisci o isola tale dipendenza; valuta un piano di riserva.
Regola i timeout degli agenti non correlati
I guasti si verificano solo dopo l'aggiunta di agenti paralleli
Mantieni il parallelismo utile ma aggiungi un semaforo globale e limiti per provider.
Si presume che il parallelismo sia sempre più veloce.
Una base di produzione pratica
Per una tipica API multi-agente, una solida base di partenza consiste nell'assegnare a ogni flusso di lavoro un ID di correlazione, tracciare ogni chiamata di agente e strumento, definire una scadenza end-to-end, assegnare scadenze più brevi per ogni chiamata al suo interno, imporre un limite di concorrenza globale per ogni fornitore a valle, mantenere i tentativi limitati e idempotenti e conservare uno stato sufficiente per riprendere o segnalare il completamento parziale.
Quindi, ottimizza in base alle misurazioni. Se il sistema è stabile ma troppo lento, parallelizza selettivamente il lavoro indipendente. Se è veloce a basso carico ma fallisce al picco di carico, riduci il fan-out e aggiungi backpressure. Se i flussi di lavoro che funzionano correttamente richiedono naturalmente più tempo di quanto consentito dal percorso di richiesta sincrona, cambia architettura invece di cercare di far attendere più a lungo ogni proxy.